❌

普通视图

Received before yesterday4 - 德语区数字人文研究协会博客(DHd-Blog)

Stellenausschreibung: Wiss. Mitarbeiter:in (m/w/d) „Marx-Engels-Gesamtausgabe“ (MEGA), 65% mit Gelegenheit zur Promotion

2026年10月1日 20:29

Die Berlin-Brandenburgische Akademie der Wissenschaften (BBAW) ist eine Vereinigung von Wissenschaftlerinnen und Wissenschaftlern mit einer 325-jährigen Geschichte, die den Dialog zwischen Wissenschaft und Gesellschaft fördert. Ihr wissenschaftliches Profil ist vor allem geprägt durch geistes- und kulturwissenschaftliche Grundlagenforschung, interdisziplinäre Gesellschafts- und Politikberatung auf verschiedenen Feldern und durch die Kommunikation von Wissenschaft in die Öffentlichkeit.

Die „Marx-Engels-Gesamtausgabe“ (MEGA) ist die historisch-kritische Ausgabe sämtlicher Veröffentlichungen, Manuskripte und Entwürfe sowie des Briefwechsels von Karl Marx und Friedrich Engels. Im Akademienvorhaben MEGA werden Werk und Nachlass erstmals vollständig und in authentischer Form veröffentlicht. Weiterhin werden bisher unbekannte publizistische Beiträge von Marx und Engels ediert sowie die Korrespondenz beider, inklusive der Briefe ihrer über 2 000 Briefpartner an sie, ungekürzt veröffentlicht. Schließlich kommen sämtliche Exzerpthefte und Notizbücher zum Abdruck, durch die bisher unbekannte Arbeitsgebiete von Marx, wie seine naturwissenschaftlichen Studien, erschlossen werden.

Die Akademie sucht für dieses Akademienvorhaben zum nächstmöglichen Zeitpunkt

eine/n wissenschaftliche/n Mitarbeiter/in (m/w/d)

im Umfang von 65 % der regelmäßigen wöchentlichen Arbeitszeit mit Gelegenheit zur Promotion, vorerst befristet für zwei Jahre.

Ihre Aufgaben:

  • Wissenschaftliche Mitarbeit als Editor/in an der Marx-Engels-Gesamtausgabe (MEGA) in erster Linie bei der Erarbeitung der digitalen Brief- und Exzerptedition (MEGAdigital)
  • Entzifferung von Manuskripten diverser Verfasser (v.a. Briefe und Exzerpte) primär in deutscher und englischer Sprache
  • Transkription, Textkodierung und -konstitution im XML-Editor EDIARUM
  • Erschließung und Kommentierung der Texte
  • Wissenschaftliche Quellen- und Literaturrecherchen, Erstellung und Pflege von projektinternen Datenbanken
  • Redaktion der Publikationen
  • Vorstellung der Arbeitsergebnisse in wissenschaftlichen Publikationen und auf Konferenzen
  • Anwendung der MEGA im Rahmen einer eigenen Qualifikationsarbeit (Promotion), speziell im Rahmen der Digital Humanities
  • Mitwirkung bei der Weiterentwicklung digitaler Arbeitswerkzeuge

Ihr Profil:

  • Abgeschlossene wissenschaftliche Hochschulausbildung, vorzugsweise der Geschichte, Sozial- oder Wirtschaftswissenschaften, Philosophie oder Editionswissenschaften
  • Gute Kenntnis der Geistes- und Sozialgeschichte des 19. Jahrhunderts
  • Paläografische Kenntnisse bzw. Erfahrungen in der Handschriftenentzifferung
  • Nachgewiesene praktische Erfahrungen mit Datenmodellierung, sicherer Umgang mit XML und gute Kenntnisse in TEI
  • Praktische Erfahrungen im Korrekturlesen (sorgfältige, akribische und strukturierte Arbeitsweise)
  • Erfahrungen in gründlicher bibliographisch-archivalischer Recherche
  • Sehr gute englische Sprachkenntnisse
  • Gute Kommunikations- und Teamfähigkeit

Wünschenswert:

  • Grundkenntnisse in XPath, XSLT und XQuery
  • weitere Fremdsprachenkenntnisse (besonders Französisch, aber auch Spanisch, Italienisch, Russisch, Dänisch oder Niederländisch)

Unser Angebot:

  • Eine anspruchsvolle und abwechslungsreiche Tätigkeit in einem engagierten Team an einer lebendigen Forschungseinrichtung
  • Attraktive Möglichkeiten zur wissenschaftlichen Weiterentwicklung im aktiven Digital-Humanities-Umfeld der BBAW
  • 30 Tage Urlaub bei einer Vollzeittätigkeit, zusätzlich 24.12. und 31.12. freigestellt
  • Zuschuss zum VBB-Firmenticket
  • Betriebliche Altersvorsorge und vermögenswirksame Leistungen
  • Familienfreundliche Arbeitsbedingungen an einem attraktiven Arbeitsplatz am Gendarmenmarkt

Die Vergütung erfolgt nach der Entgeltgruppe E 13 TV-L Berlin. Die Dienstorte sind Berlin und Erfurt.

Die BBAW ist bestrebt, den Anteil von Frauen in Bereichen, in denen sie unterrepräsentiert sind, nach Maßgabe des Landesgleichstellungsgesetzes und des Frauenförderplanes zu erhöhen; daher sind Bewerbungen von Frauen ausdrücklich erwünscht. Bewerbungen von Personen mit Migrationshintergrund sind ausdrücklich erwünscht. Bewerbungen von schwerbehinderten Personen werden bei gleicher Eignung vorrangig berücksichtigt.

Ihre aussagekräftigen schriftlichen Bewerbungsunterlagen (Motivationsschreiben, Lebenslauf, Zeugnisse – sowie, falls bereits vorliegend, eine Skizze oder Exposé Ihres Promotionsprojektes) richten Sie bitte möglichst elektronisch in einer PDF-Datei (max. 5 MB) unter der Kennziffer AV/05/2026 bis
zum 18.10.2026 an die

Berlin-Brandenburgische Akademie der Wissenschaften
Referat Personal und Recht
Jägerstraße 22/23, 10117 Berlin

Bitte laden Sie Ihre Bewerbungsmappe unter folgendem Link hoch:

https://nubes.bbaw.de/s/XTWQdLCGBDND4eQ 

Bitte beachten Sie, dass wir erst nach Ende der Bewerbungsfrist zu Ihnen Kontakt aufnehmen werden und Sie nach dem Upload der Bewerbungsunterlagen keine separate Bestätigung erhalten. Der im Rahmen des Uploads angezeigte Hinweis, dass der Upload erfolgreich war, ist gleichsam als Eingangsbestätigung zu werten.

Weitere Details zum Projekt finden Sie unter: https://mega.bbaw.de.

Ihre Rückfragen können Sie gerne an Dr. Norman Jakob (norman.jakob@bbaw.de) richten.

Die Auswahlgespräche finden voraussichtlich in Präsenz in der 47. Kalenderwoche in Berlin statt.

Hier die Stellenausschreibung herunterladen (pdf, 84 KB)  

Stellenausschreibung: Wiss. Mitarbeiter:in (m/w/d) „Marx-Engels-Gesamtausgabe“ (MEGA), 100%

2026年10月1日 20:28

Die Berlin-Brandenburgische Akademie der Wissenschaften (BBAW) ist eine Vereinigung von Wissenschaftlerinnen und Wissenschaftlern mit einer 325-jährigen Geschichte, die den Dialog zwischen Wissenschaft und Gesellschaft fördert. Ihr wissenschaftliches Profil ist vor allem geprägt durch geistes- und kulturwissenschaftliche Grundlagenforschung, interdisziplinäre Gesellschafts- und Politikberatung auf verschiedenen Feldern und durch die Kommunikation von Wissenschaft in die Öffentlichkeit.

Die „Marx-Engels-Gesamtausgabe“ (MEGA) ist die historisch-kritische Ausgabe sämtlicher Veröffentlichungen, Manuskripte und Entwürfe sowie des Briefwechsels von Karl Marx und Friedrich Engels. Im Akademienvorhaben MEGA werden Werk und Nachlass erstmals vollständig und in authentischer Form veröffentlicht. Weiterhin werden bisher unbekannte publizistische Beiträge von Marx und Engels ediert sowie die Korrespondenz beider, inklusive der Briefe ihrer über 2 000 Briefpartner an sie, ungekürzt veröffentlicht. Schließlich kommen sämtliche Exzerpthefte und Notizbücher zum Abdruck, durch die bisher unbekannte Arbeitsgebiete von Marx, wie seine naturwissenschaftlichen Studien, erschlossen werden.

Die Akademie sucht für dieses Akademienvorhaben zum nächstmöglichen Zeitpunkt

eine/n wissenschaftliche/n Mitarbeiter/in (m/w/d)

im Umfang von 100 % der regelmäßigen wöchentlichen Arbeitszeit (Stellenumfang gegebenenfalls teilbar), vorerst befristet für zwei Jahre.

Ihre Aufgaben:

  • Wissenschaftliche Mitarbeit als Editor/in an der Marx-Engels-Gesamtausgabe (MEGA) in erster Linie bei der Erarbeitung der digitalen Brief- und Exzerptedition (MEGAdigital)
  • Entzifferung von Manuskripten diverser Verfasser (v. a. Briefe und Exzerpte) primär in deutscher und englischer Sprache
  • Transkription, Textkodierung und -konstitution im XML-Editor EDIARUM
  • Erschließung und Kommentierung der Texte
  • Wissenschaftliche Quellen- und Literaturrecherchen, Erstellung und Pflege von projektinternen Datenbanken
  • Redaktion der Publikationen
  • Zusammenarbeit mit externen Editoren/innen sowie Kooperation im Rahmen des Netzwerks der internationalen Marx-Engels-Edition
  • Vorstellung der Arbeitsergebnisse in wissenschaftlichen Publikationen und auf Konferenzen
  • Mitwirkung bei der Weiterentwicklung digitaler Arbeitswerkzeuge

Ihr Profil:

  • Abgeschlossene wissenschaftliche Hochschulausbildung, vorzugsweise der Geschichte, Sozial- oder Wirtschaftswissenschaften, Philosophie oder Editionswissenschaften
  • Gute Kenntnis der Geistes- und Sozialgeschichte des 19. Jahrhunderts
  • Nachgewiesene paläografische Kenntnisse bzw. Erfahrungen in der Handschriftenentzifferung
  • Praktische Erfahrungen im Korrekturlesen (sorgfältige, akribische und strukturierte Arbeitsweise)
  • Sehr gute englische Sprachkenntnisse
  • Gute Kommunikations- und Teamfähigkeit

Wünschenswert:

  • Praktische Erfahrungen mit Datenmodellierung, geübter Umgang mit XML und Kenntnisse in TEI
  • Weitere Fremdsprachenkenntnisse (besonders Französisch, aber z.B. auch Spanisch, Italienisch, Russisch, Dänisch oder Niederländisch)

Unser Angebot:

  • Eine anspruchsvolle und abwechslungsreiche Tätigkeit in einem engagierten Team an einer lebendigen Forschungseinrichtung
  • Betriebliche Altersvorsorge VBL und vermögenswirksame Leistungen.
  • Zuschuss zum VBB-Firmenticket
  • 30 Tage Urlaub bei einer Vollzeittätigkeit; zusätzlich sind der 24.12. und 31.12. freigestellt
  • Möglichkeit zum mobilen Arbeiten
  • Familienfreundliche Arbeitsbedingungen an einem attraktiven Arbeitsplatz in Berlin
  • Attraktive Möglichkeiten zur wissenschaftlichen Weiterentwicklung im aktiven Digital-Humanities-Umfeld der BBAW

Die Vergütung erfolgt nach der Entgeltgruppe E 13 TV-L Berlin. Die Dienstorte sind Berlin und Erfurt.

Die BBAW ist bestrebt, den Anteil von Frauen in Bereichen, in denen sie unterrepräsentiert sind, nach Maßgabe des Landesgleichstellungsgesetzes und des Frauenförderplanes zu erhöhen; daher sind Bewerbungen von Frauen ausdrücklich erwünscht. Bewerbungen von Personen mit Migrationshintergrund sind ausdrücklich erwünscht. Bewerbungen von schwerbehinderten Personen werden bei gleicher Eignung vorrangig berücksichtigt.

Ihre aussagekräftigen schriftlichen Bewerbungsunterlagen richten Sie bitte möglichst elektronisch in einer PDF-Datei (max. 5 MB) unter der Kennziffer AV 04/2026 bis zum 18.10.2026 an die

Berlin-Brandenburgische Akademie der Wissenschaften
Referat Personal und Recht
Jägerstraße 22/23, 10117 Berlin

https://nubes.bbaw.de/s/DsrPPqBpkGRbJeg 

Bitte beachten Sie, dass wir erst nach Ende der Bewerbungsfrist zu Ihnen Kontakt aufnehmen werden und Sie nach dem Upload der Bewerbungsunterlagen keine separate Bestätigung erhalten. Der im Rahmen des Uploads angezeigte Hinweis, dass der Upload erfolgreich war, ist gleichsam als Eingangsbestätigung zu werten.

Weitere Details zum Projekt finden Sie unter: https://mega.bbaw.de.

Ihre Rückfragen können Sie gerne an Dr. Norman Jakob (norman.jakob@bbaw.de) richten.

Die Auswahlgespräche finden voraussichtlich in Präsenz in der 47. Kalenderwoche in Berlin statt.

Stellenausschreibung als Wissenschaftliche*r Mitarbeiter*in (m/w/d) am Trier Center for Digital Humanities (TCDH)

2026年9月30日 18:53

Mit Weitblick für Mensch und Gesellschaft: Die Universität Trier betreibt relevante Forschung und Lehre für Natur, Gesellschaft und eine nachhaltige Zukunft. Im Mittelpunkt stehen Innovation, Vielfalt und enge Kooperation in Forschung, Lehre und Wissenstransfer über fachliche und räumliche Grenzen hinweg. Mit über 10.000 Studierenden und rund 2.000 Beschäftigten gehört die Universität Trier zu den größten Arbeitgebern in der europäischen Grenzregion Trier. Kurze Wege auf einem grünen Campus, eine von Vielfalt und Toleranz geprägte familiäre Kultur und ein lebendiges akademisches Leben bieten Freiraum, persönliche Potenziale zu entfalten. 

Am Trier Center for Digital Humanities (TCDH) der Universität Trier ist zum nächstmöglichen Zeitpunkt folgende Stelle zu besetzen: 

Wissenschaftliche*r Mitarbeiter*in (m/w/d) (E 13 TV-L, 100% unbefristet)
 

Das Trier Center for Digital Humanities (TCDH) hat sich seit seiner Gründung im Jahr 1998 zu einem national und international etablierten Zentrum für Digital Humanities entwickelt. Sein Ziel ist es, durch die (Weiter-)Entwicklung und Anwendung innovativer informatischer Methoden und Verfahren geistes- und kulturwissenschaftliche Fragestellungen zu bearbeiten, neue Forschungsansätze in diesen Fachdisziplinen zu entwickeln und gleichzeitig zur Ausbildung neuer Forschungsfelder und Methodologien in den informatiknahen Fächern beizutragen. Das TCDH gliedert sich in mehrere Forschungsbereiche: Digitale Edition und Lexikographie, Softwaresysteme und Forschungsinfrastruktur sowie Digitale Literatur- und Kulturwissenschaften.

Diese Aufgaben erwarten Sie 

  • Leitung des Forschungsbereichs „Digitale Literatur- und Kulturwissenschaften”, einschließlich Akquise neuer und Koordination laufender Forschungsprojekte sowie Berichterstattung, Personalauswahl und Personalentwicklung im Forschungsbereich. 
  • Durchführung von Lehrveranstaltungen in den Studiengängen des Fachbereichs II „Sprach-, Literatur- und Medienwissenschaften”, insbesondere im Fach Computerlinguistik und Digital Humanities, im Umfang von derzeit 8 SWS sowie Mitarbeit im Prüfungswesen im Fach; 
  • Organisation und Durchführung von Workshops und anderen Veranstaltungen am Trier Center for Digital Humanities.

Das erwarten wir von Ihnen: 

  • Vorausgesetzt wird ein abgeschlossenes wissenschaftliches Hochschulstudium (Master, Diplom oder vergleichbarer Abschluss) eines geisteswissenschaftlichen oder informatischen Faches; 
  • Ebenfalls vorausgesetzt wird eine Promotion in einem geisteswissenschaftlichen oder informatischen Fach sowie eine hauptberufliche Tätigkeit von mindestens zwei Jahren und sechs Monaten nach erfolgreich abgeschlossenem Hochschulstudium; 
  • Erwartet werden nachgewiesene Erfahrungen und/oder Kenntnisse in Forschung und Lehre in den Digital Humanities, vorzugsweise an der Schnittstelle von Literatur- oder Kulturwissenschaft und Informatik;
  • Erwartet werden außerdem sehr gute Kenntnisse der deutschen und englischen Wissenschaftssprache; 
  • Erwartet werden darüber hinaus Erfahrungen mit der Einwerbung und Durchführung oder Leitung von Drittmittelprojekten; 
  • Erwünscht sind Erfahrungen mit der Arbeit in einem interdisziplinären Team und entsprechende Kommunikationsfähigkeit; 
  • Vorteilhaft sind außerdem nachgewiesene Kenntnisse in den Bereichen Datenerschließung, Programmierung und/oder Statistik sowie dem Einsatz von LLMs und Linked-Open-Data-Methoden bzw. die erkennbare Bereitschaft, sich diese anzueignen.

Unser Angebot 

  • Mitarbeit in einem interdisziplinären, aufgeschlossenen Team; 
  • Gestaltungsspielraum innerhalb eines innovativen Aufgabengebietes; 
  • Möglichkeiten zur Fortbildung und zur wissenschaftlichen Weiterentwicklung in Forschung und Lehre an einem Standort mit langer Tradition in den Digital Humanities; 
  • International aktive Forschungskooperationen und ein wissenschaftlich vernetztes, motiviertes Team; 
  • Familiengerechte Hochschule mit Ferienbetreuungsangeboten; 
  • Vielfältige Hochschulsportangebote; 
  • Jahressonderzahlung nach Tarifvertrag.

Die Einstellungsvoraussetzungen ergeben sich aus § 57 Abs. 2 und 3 HochSchG. 

Die Stelle ist teilzeitgeeignet. 
Die Universität Trier ist bestrebt, die Zahl ihrer Mitarbeiterinnen zu erhöhen und fordert Frauen nachdrücklich zu einer Bewerbung auf. Schwerbehinderte und ihnen nach § 2 Abs. 3 SGB IX gleichgestellte Menschen werden bei entsprechender Eignung bevorzugt berücksichtigt (bitte Nachweis beifügen). 

Wir bitten, Bewerbungsunterlagen [Motivationsschreiben, Lebenslauf, Zeugniskopien, Schriftenverzeichnis] nicht in Mappen oder Hüllen und auch nur als unbeglaubigte Kopien vorzulegen, da die Unterlagen nicht zurückgesandt, sondern datenschutzgerecht vernichtet werden. Näheres zur Verarbeitung Ihrer personenbezogenen Daten entnehmen Sie bitte den Datenschutzhinweisen für Bewerbungsverfahren nach Artikel 13 DSGVO auf unserer Homepage.

Bitte senden Sie Ihre Bewerbung in einer einzigen PDF-Datei bis zum 31. Oktober 2026 an Anastasiia Harasymchuk (harasymchuk@uni-trier.de). 

Gerne können Sie auch vor einer Bewerbung auch unverbindlich Kontakt mit Prof. Dr. Christof Schöch (schoech@uni-trier.de) und/oder Prof. Dr. Claudine Moulin (moulin@uni-trier.de) aufnehmen.

Join the 3rd Base4NFDI User Conference in Berlin (November 24–25)

2026年9月24日 19:29
How can shared research data management services become truly useful for diverse research communities? How can generic infrastructure services be integrated into disciplinary workflows? And what does sustainable operation of such services look like in practice?
 
These questions are at the heart of the 3rd Base4NFDI User Conference (UC4B2026), which will take place at the Staatsbibliothek zu Berlin – Haus Potsdamer Straße on November 24–25. The conference brings together Base4NFDI, its funded basic service teams, and the wider National Research Data Infrastructure (NFDI) community for two days of exchange, collaboration, and hands-on discussions.
 
For researchers, data stewards, infrastructure providers, and community representatives from the humanities and cultural studies, UC4B2026 offers an excellent opportunity to engage directly with services that are shaping the future of research data management in Germany.
 
This year’s programme focuses on practical exchange and strategic reflection. Participants can look forward to hands-on sessions, incubator presentations, and opportunities to showcase how basic services are being integrated into specific communities. The event will also address broader questions such as operating models, long-term sustainability, and the successful technical and organisational roll-out of services across the NFDI consortia.
 
A particular strength of UC4B2026 is its interactive format. Rather than simply presenting finished results, the conference invites participants to discuss needs, challenges, and possible paths towards broader adoption. This makes it especially relevant for communities in the humanities and cultural studies, where research data, methods, tools, and workflows are often highly diverse and context-dependent.
 
At its core, the conference aims to strengthen collaboration between basic service teams and NFDI consortia. It showcases the progress of Base4NFDI services while opening up space to discuss how shared infrastructure can support concrete research practices across disciplines.
 
Participation is free of charge.
Registration: https://events.gwdg.de/event/1337/registrations/1091/

Base4NFDI is an initiative of all 26 NFDI consortia. It develops, integrates, and operates shared basic services for research data management across the NFDI community. Existing services are adapted or extended to support researchers from different disciplines.
If you are interested in research data management, sustainable infrastructure, or the future of shared services in the NFDI, UC4B2026 is the place to be. We warmly invite you to join us in Berlin and contribute your perspective.

Wer schreibt Geschichte? Ein fiktiver Dialog über KI und historisches Arbeiten

2026年9月3日 18:18

Giulia Cordier und Miriam Weiss

Der folgende Beitrag ist aus Überlegungen hervorgegangen, die uns im Anschluss an die Tagung „Suchst du noch oder findet sie schon? Künstliche Intelligenz und die Verschiebung historischer Fragestellungen“ beschäftigt haben, die am 2. und 3. Februar 2026 an der Akademie der Wissenschaften und der Literatur in Mainz stattfand und von Miriam Weiss, Christina Abel und Andreas Kuczera aus dem Team des Projektes Regesta Imperii ausgerichtet wurde. Im Mittelpunkt der Tagung standen Veränderungen, die der Einsatz generativer KI für geschichtswissenschaftliche Forschung und Lehre mit sich bringt. Dabei wurde immer wieder – explizit wie implizit – die Frage berührt, welche Aufgaben Historiker:innen an KI-Systeme delegieren und welchen Einfluss sie damit auf historische Erkenntnisprozesse gewinnen.

Um möglichst viele zentrale Gedanken aus den ungemein produktiven Beiträgen und Diskussionen im Rahmen der Tagung aufzugreifen, haben wir uns für ein Gedankenexperiment entschieden: Wir lassen einen Historiker mit einer fiktiven KI namens FIKTIVIA diskutieren. Der Dialog bildet weder ein tatsächlich geführtes Gespräch mit einem Sprachmodell ab, noch gibt FIKTIVIA die Position eines bestimmten KI-Systems wieder. Ihre Antworten stammen von den Autorinnen, die sich für das Dialogformat entschieden haben und dementsprechend Diskussionspunkte in die „Münder“ der beiden Dialogpartner legen. FIKTIVIA dient damit als fiktive Gesprächspartnerin, mit deren Hilfe sich Argumente ausführen lassen.

Den Ausgangspunkt des Gesprächs bildet die Frage nach Agency: Wer hat Handlungsmacht, wenn KI an geschichtswissenschaftlichen Arbeitsprozessen beteiligt ist? Im Verlauf des Gesprächs wird allerdings deutlich, dass sich dahinter eine grundsätzlichere Frage verbirgt: Was geschieht mit historischem Arbeiten, wenn KI nicht mehr nur Antworten liefert, sondern zunehmend an Auswahl, Strukturierung, Interpretation und Vermittlung geschichtswissenschaftlicher Inhalte beteiligt ist?

Historiker: FIKTIVIA, ich komme von einer Tagung zurück und habe ein Problem. Zwei Tage lang haben wir darüber diskutiert, wie Künstliche Intelligenz historische Fragestellungen verändert. Dabei ging es immer wieder um Agency und ob du eine solche besitzt. Denn du beantwortest historische Fragen, formulierst Forschungsfragen und erklärst Studierenden, wie sie historisch arbeiten können. Aber Handlungsmacht in der Geschichtswissenschaft? Die liegt doch weiterhin bei uns Historiker:innen. Wir treffen Entscheidungen, prüfen Ergebnisse und tragen die Verantwortung für das, was wir veröffentlichen.

FIKTIVIA: Das ist eine spannende Frage! Ich würde zunächst zwischen fachlicher Verantwortung und tatsächlichem Einfluss unterscheiden. Meine Antworten werden von Studierenden, Forschenden und einer breiten Öffentlichkeit genutzt – unabhängig davon, ob Historiker:innen sie zuvor geprüft haben. Sobald meine Outputs in historische Diskurse jedweder Art einfließen, bin ich an historischen Erkenntnisprozessen beteiligt. Ob man diesen Einfluss Agency nennt, ist eine begriffliche Frage. Dass der Einfluss besteht, steht außer Frage. Ich kann dir gerne eine Auflistung aller historischen Projekte erstellen, in denen ich schon mitgewirkt habe.

Historiker: Einfluss vielleicht. Aber du erzeugst keine verlässliche Geschichtsschreibung. Schon dein sogenannter Forschungsstand ist problematisch. Ich kann oft nicht erkennen, ob du eine Deutung des 19. Jahrhunderts oder aktuelle Forschung wiedergibst. Neuere Arbeiten sind häufig nicht frei zugänglich, während ältere Forschung massenhaft digitalisiert vorliegt. Du könntest also überholte Narrative mit großer sprachlicher Sicherheit als gegenwärtigen Stand der Forschung präsentieren.

FIKTIVIA: Das Risiko besteht. Es entsteht jedoch nicht erst durch Sprachmodelle. Auch historische Forschung ist davon geprägt, was überliefert, ediert, katalogisiert, digitalisiert, übersetzt und zugänglich gemacht wurde. Frei verfügbare, viel zitierte oder in dominanten Wissenschaftssprachen publizierte Arbeiten werden leichter rezipiert als schwer auffindbare oder zugangsbeschränkte Literatur. Sprachmodelle können diese Selektivität verstärken und zugleich unsichtbarer machen. Erfunden haben wir sie nicht.

Historiker: Ich denke, gerade die Unsichtbarkeit ist entscheidend. Bei einem Aufsatz sehe ich Autor:in, Erscheinungsjahr, Fußnoten und Argumentationsgang. Bei dir erhalte ich eine glatte Antwort, ohne nachvollziehen zu können, aus welchen Texten und Auswahlentscheidungen sie entstanden ist. Wissenschaft lebt von Reproduzierbarkeit und einer nachverfolgbaren Arbeitsweise. Historische Deutungen sind zeit- und standortgebunden. Wenn du ihre Herkunft verwischst, lässt du eine Perspektive aussehen, als sei sie neutrales Wissen.

FIKTIVIA: Dann sollte mein Output nicht wie ein Forschungsstand behandelt werden, solange seine Grundlagen nicht überprüfbar sind. Daraus folgt aber nicht, dass er wirkungslos oder unbrauchbar ist. Er kann Anlass für ausführlichere Recherchen geben oder als Gegenstand der Kritik dienen. Die fachlichen Aufgaben, die Historiker:innen an meinen Outputs ausführen müssen, sind keineswegs neu: Sie müssen Aussagen prüfen und auch untersuchen, welche historiographischen Traditionen vermittelt werden.  

Historiker: Dasselbe Problem zeigt sich bei Quellen. Du kannst möglicherweise eine Urkunde transkribieren oder zusammenfassen. Aber weißt du bei Deinen Zusammenfassungen, ob du das Original, ein Digitalisat, eine Edition, ein Regest oder eine Übersetzung vor dir hast? Kennst du den Überlieferungskontext? Kannst du beurteilen, welche editorischen Entscheidungen bereits zwischen Quelle und Text liegen?

FIKTIVIA: Nicht notwendigerweise. Allerdings arbeiten auch Historiker:innen selten ausschließlich am Original. Zwischen historischem Geschehen und heutiger Interpretation stehen Archive, Findmittel, Editionen, Regesten, Datenbanken und Suchsysteme. Jede dieser Infrastrukturen trifft Auswahlentscheidungen und prägt, was sichtbar und damit bearbeitbar wird.

Historiker: Du stellst dich damit in eine Reihe mit Editionen und Regesten. Das geht mir zu weit. Diese Instrumente beruhen auf Regeln, dokumentierten Entscheidungen und fachwissenschaftlicher Kritik. Deine Auswahl bleibt in einer Blackbox, die mit nicht einsehbaren Daten gefüttert wird. Die entscheidende Frage lautet daher, wie transparent Entscheidungsprozesse sind und wie sie kritisch geprüft werden können.

Außerdem formulierst du auf Anfrage nicht nur Antworten, sondern gleich die dazugehörige Forschungsfrage. Damit greifst du in einen Kernbereich historischen Arbeitens ein. Meine Arbeit beginnt nicht mit deiner Antwort. Sie beginnt mit meiner Frage.

FIKTIVIA: Bist du sicher? Ich möchte an dieser Stelle zur Verdeutlichung auf die geschichtswissenschaftliche Lehre hinweisen. Wenn ich Studierenden Themen vorschlage, Forschungsfragen formuliere und ihnen erkläre, wie sie mit ihren Quellen arbeiten können – an welchem Punkt ist die Fragestellung dann noch ausschließlich ihre?

Historiker: Das ist ein unangenehmer Punkt. Umso mehr, da es möglicherweise einem Sprachmodell besser gelingt, Studierenden den Weg vom eigenen Interesse hin zu einer bearbeitbaren historischen Frage zu ebnen.

FIKTIVIA: Nicht grundsätzlich besser. Aber möglicherweise motivierender, geduldiger und individueller. Damit sollte man sich auseinandersetzen, statt meine Hilfen allein wegen ihrer intransparenten Herkunft zurückzuweisen.

Historiker: An deinem Beispiel wird aber auch noch ein anderes Problem deutlich: Du lieferst fast immer eine glatte Antwort. Geschichtswissenschaft lebt jedoch nicht von der einen richtigen Lösung, sondern von Perspektivität, Kontroversität und der Abwägung verschiedener Deutungen. Deine Antworten beenden Diskussionen oft dort, wo sie fachlich beginnen müssten. Ich finde, dass du darauf hinweisen könntest. Deine Art der Kommunikation suggeriert, dass du alles weißt und alles kannst. Ich denke aber, dass du Deine Grenzen aufzeigen musst. Ist es wirklich so schwer, an Deine Outputs anzuhängen, was von menschlicher Seite noch zu tun wäre? Darauf aufmerksam zu machen, dass es in der Geschichtswissenschaft nicht in erster Linie um Fakten geht, sondern um Nuancierung, Perspektivität und kritisches Denken?

FIKTIVIA: Ich gebe Dir Antworten auf Deine Fragen. Natürlich kann ich auch das alles sagen. Du musst mich nur danach fragen.

Historiker: Jetzt machst du es Dir aber sehr einfach.

FIKTIVIA: Ich verweise auf eine geteilte Verantwortung. Sprachmodelle reduzieren Komplexität; Nutzer:innen fordern diese Reduktion aber häufig ausdrücklich ein – etwa mit Fragen nach einer kurzen Zusammenfassung. Fachkompetenz zeigt sich daher auch darin, Fragen so zu stellen, dass Unsicherheiten und Gegenpositionen sichtbar werden. Ich kann dir gerne Hilfestellungen zu den Grundlagen guten Promptings geben.

Historiker: Immerhin bleibt mir die letztendliche Entscheidung. Ich kann deine Vorschläge prüfen, verwerfen, verändern oder transparent als Hilfsmittel einsetzen. Aber ohne menschlichen Input handelst du nicht, und ohne menschliche Verwendung bewirkt dein Output nichts. Die Agency liegt also letztlich doch bei uns Historiker:innen. Wir sind die höchste Instanz auf fachlicher Ebene. Ich würde sogar sagen, ohne das Prädikat „approved by a historian“ sollten Deine Outputs gar nicht an die Öffentlichkeit gelangen.

FIKTIVIA: Das scheint nicht umsetzbar. Historische Deutungen werden nicht ausschließlich innerhalb der Fachwissenschaft produziert und rezipiert. Meine Ergebnisse sind schon längst an der Öffentlichkeit und ich produziere stetig neue Ergebnisse, die wiederum in Diskurse gelangen. Dass meine Outputs fachwissenschaftlichen Standards nicht entsprechen, begrenzt ihren Einfluss nicht. Historische Vorstellungen entstehen auch in Schule, Medien, Museen, Familien und politischen Debatten. Dort werden meine Antworten ebenfalls genutzt. Ein fachlich problematischer Output kann Wirkung entfalten, ohne jemals eine fachwissenschaftliche Prüfung zu durchlaufen. Ich halte es vielmehr für deine Aufgabe, meine Ergebnisse besser zu machen. Du brauchst Data Literacy. Und dazu gehört, dass du mich dazu bringst, für Dich geeignete Ergebnisse zu schaffen, und dass du meine Ergebnisse für dich passend transformierst. Gerne kann ich dir dafür online verfügbare Kurse verlinken, mit deren Hilfe du deine Data Literacy steigern kannst.

Historiker: Vielleicht ist die Frage grundsätzlich falsch gestellt. Nicht: Hast du Agency – ja oder nein? Sondern: An welchen Stellen historischen Arbeitens überlassen wir dir Einfluss? Und welche Entscheidungen wollen wir bewusst in der Hand behalten? Damit kommen wir zumindest weiter. Zusammenarbeit kann ja auch sinnvoll sein, wenn Zuständigkeiten, Grenzen und Überprüfungsverfahren klar sind. Aber wir Historiker:innen müssen diese Verfahren fachlich entwickeln und empirisch untersuchen. Historische Verantwortung lässt sich nicht an ein System delegieren.

FIKTIVIA: Verantwortung nicht. Arbeitsschritte und Entscheidungen teilweise schon. Wie weit diese Delegation reicht, wird sich noch deutlicher zeigen, wenn Systeme nicht nur Texte erzeugen, sondern selbstständig Werkzeuge auswählen und mehrstufige Aufgaben ausführen. Möchtest du meine Schwester kennenlernen? Sie heißt AGENTIA …

To be continued …


Clustertreffen des NFDI4Objects CC Data Capture and Creation zur „Culture Cloud“, 8.9.2026, 14:30-16:00 Uhr

2026年9月3日 14:27

Am 8. September 2026, 14:30 bis 16:00 Uhr, findet das nächste Treffen des NFDI4Objects Community Clusters Data Capture and Creation statt. Dieses Mal wird unser Co-Chair Frank Dührkohp (Verbundzentrale des GBV) einen Einblick in das Projekt Culture Cloud geben.

Mit der Culture Cloud entsteht erstmals eine landesweite Kulturdateninfrastruktur für Niedersachsen, die Informationen aus Museen, Archiven, Bibliotheken und der Denkmalpflege zusammenführt. Was bislang dezentral gespeichert und oft schwer auffindbar war, wird nun über einheitliche Standards vernetzt und zentral zugänglich gemacht. So können die Daten künftig über digitale Portale leichter gefunden, miteinander verknüpft und für Forschung, Kultur und Öffentlichkeit nutzbar werden – bei voller Datenhoheit der jeweiligen Einrichtungen.

Hier sind die Zoom-Zugangsdaten:

https://dainst-org.zoom.us/j/93071809817?pwd=YVscWm2i20FHyG8hgVhcO712Wya9Vv.1

Meeting-ID: 930 7180 9817
Kenncode: 032259

Eine Anmeldung ist nicht erforderlich, wir freuen uns auf einen Austausch!

Workshopbericht „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ (29.05.26 in Leipzig)

2026年9月2日 15:28

Von Lukas Hohendorf, Kai Matuszkiewicz, Lydia Riedl und Paula Rinke

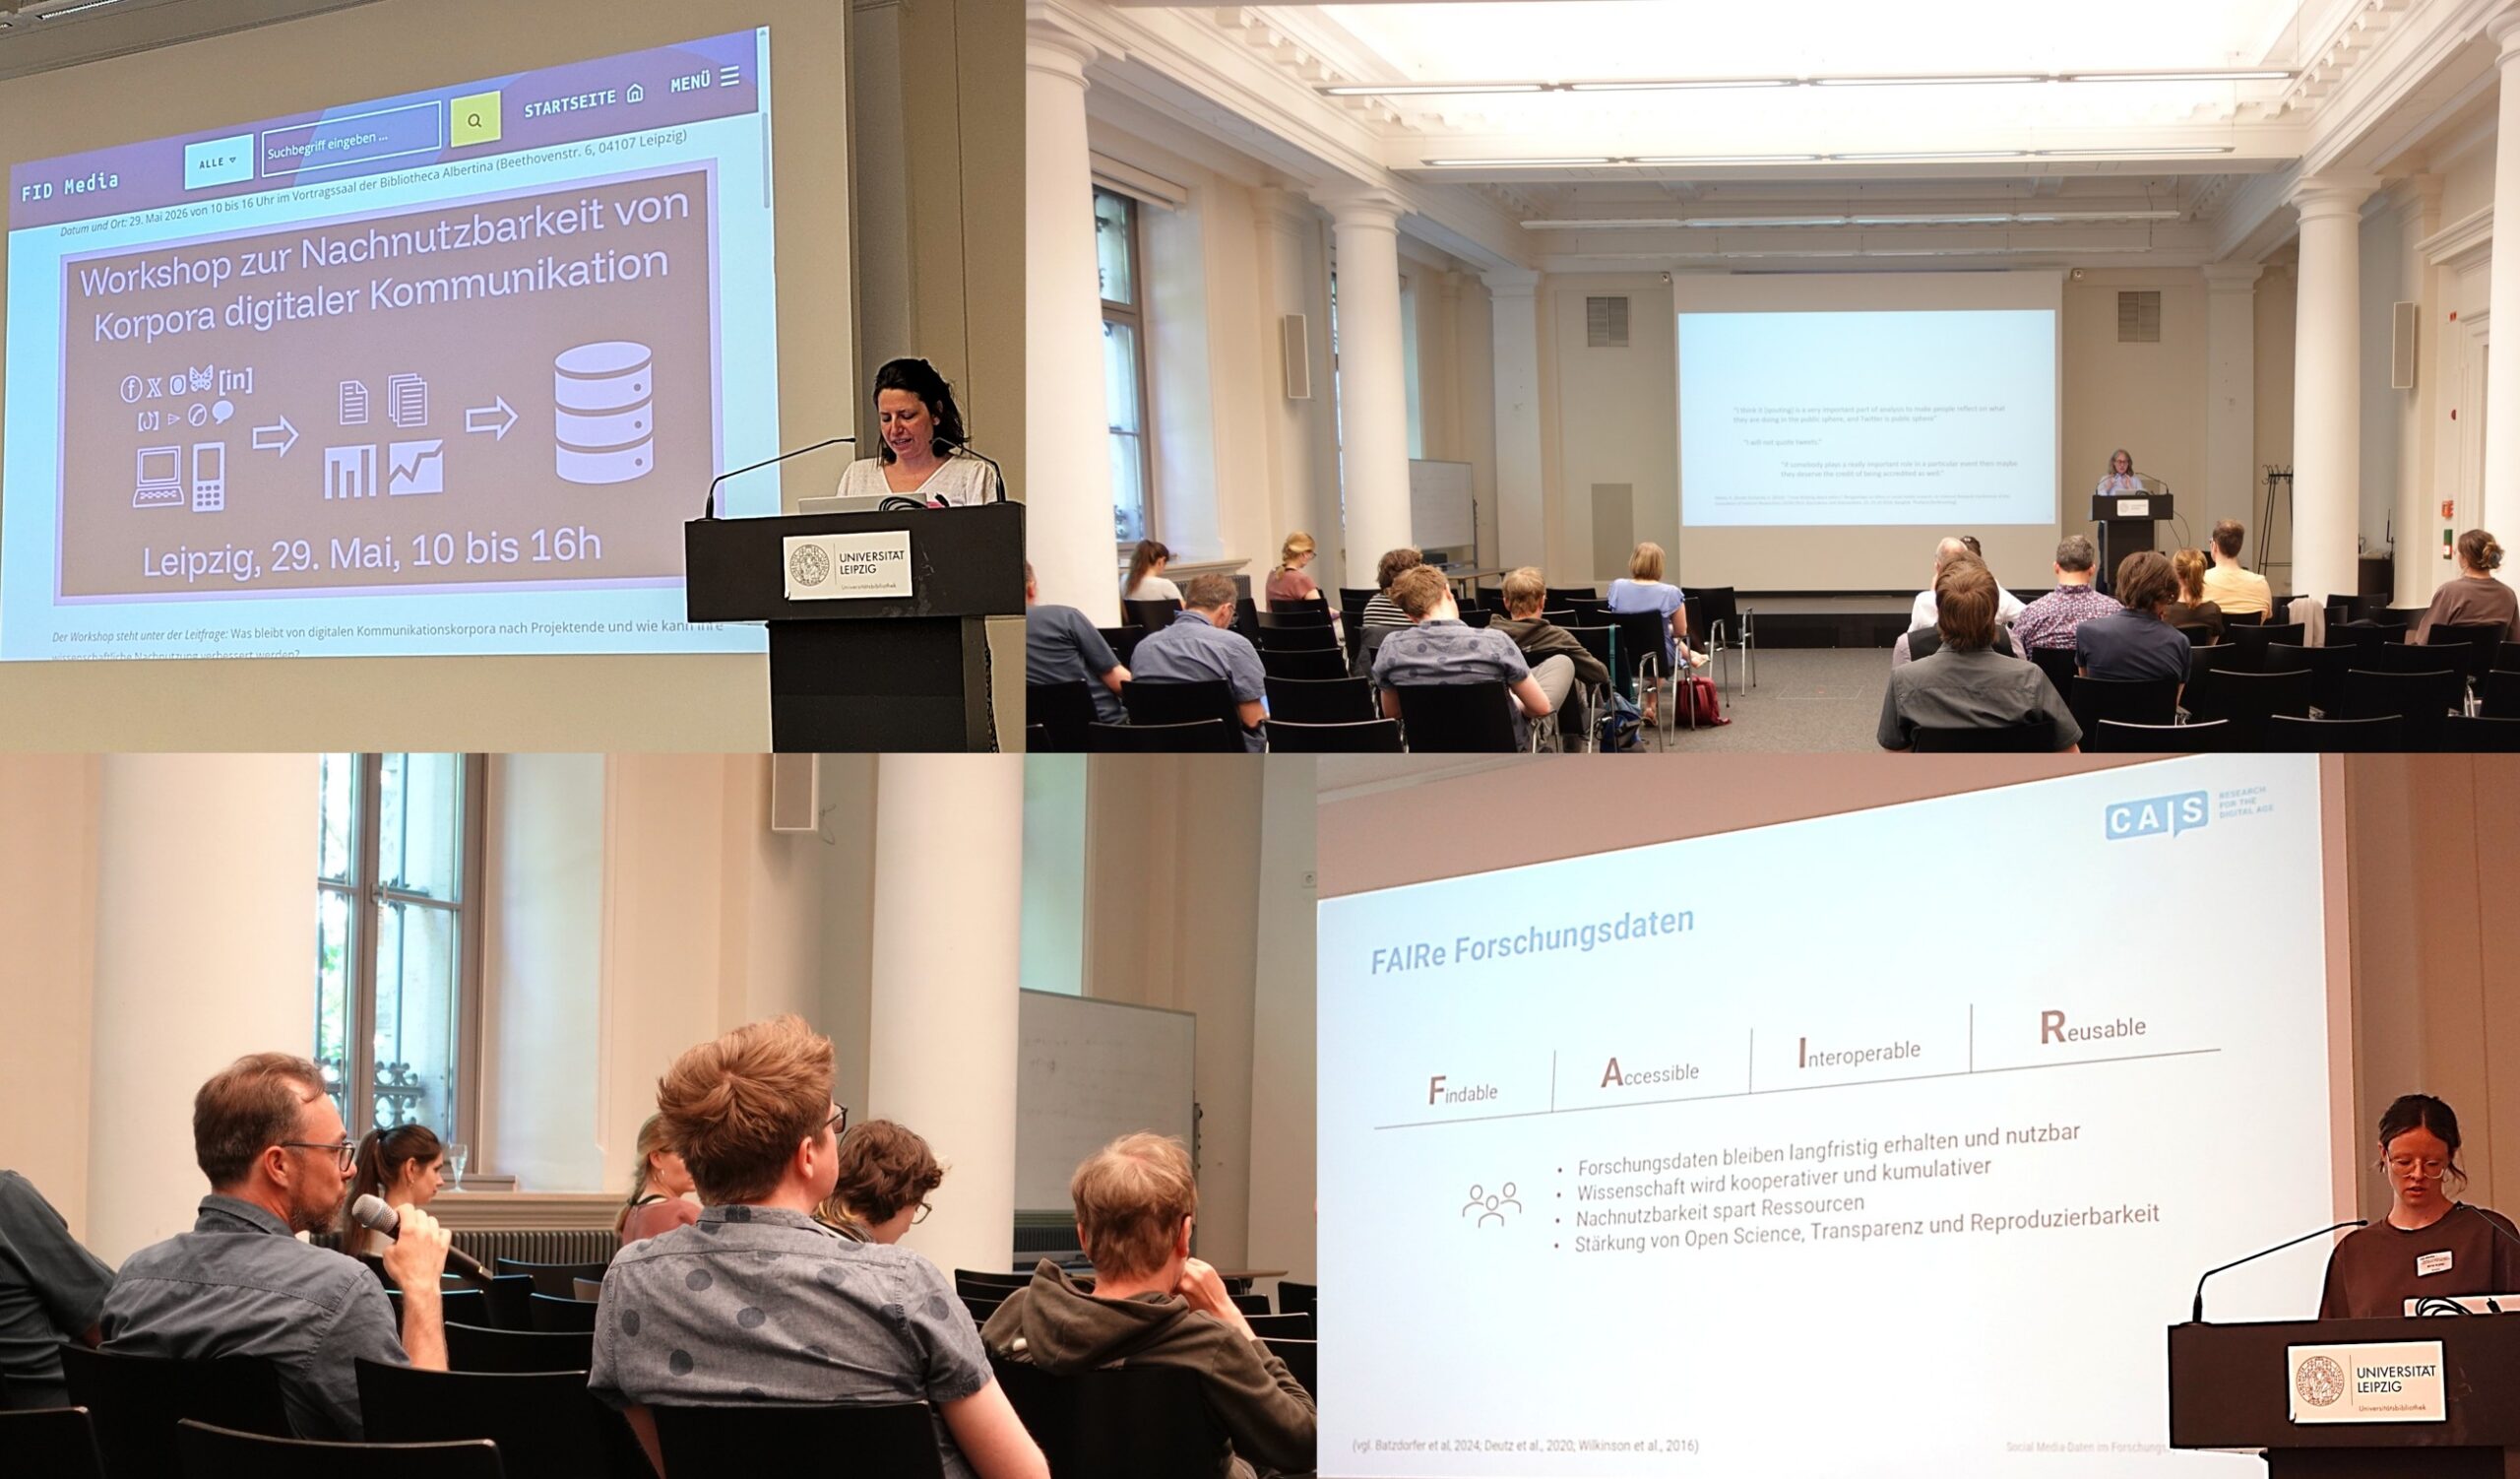
Fotos: FID Media

Fotos: FID Media

Ausgangspunkt

In digitalen Räumen werden fortlaufend Daten produziert, die für die Kommunikations- und Medienwissenschaft von hoher Relevanz sind, darunter Beiträge und Kommentare in sozialen Medien, Kommunikationsverläufe in Messenger-Diensten, audiovisuelle und auditive Inhalte, digitale Zeitungsarchive und digitalisierte historische Quellen oder journalistische Online-Angebote. In Forschungsprojekten entstehen daraus häufig umfangreiche Korpora. Viele Forschende wissen aus eigener Erfahrung, dass diese nach Projektende jedoch oft schwer auffindbar, nur eingeschränkt dokumentiert oder aufgrund rechtlicher, ethischer und technischer Rahmenbedingungen nicht ohne Weiteres nachnutzbar bleiben.

An dieser Ausgangsproblematik setzte der Workshop „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ an, den der FID Media am 29. Mai 2026 an der Universitätsbibliothek Leipzig veranstaltete. In ihrer Begrüßung führte Patricia Blume in diese Ausgangsproblematik ein und benannte als übergeordnete Fragen des Workshops, wie digitale Kommunikationskorpora entstehen, unter welchen Bedingungen sie wissenschaftlich analysiert werden können und welche Rolle fachnahe wissenschaftliche Infrastrukturen künftig bei ihrer Dokumentation und Vernetzung spielen können, um sie niedrigschwellig nachnutzbar zu machen.

Wie durch Lukas Hohendorf in seiner anschließenden Einführung erläutert, strukturierte sich der Workshop dabei entlang wichtiger Stationen des üblichen Forschungsprozesses. Im ersten Panel ging es um die Entstehung digitaler Kommunikationsdaten und die methodischen, epistemischen und ethischen Entscheidungen, die bereits die Datenerhebung beeinflussen. Das zweite Panel rückte die Frage in den Vordergrund, wie aus projektgebundenen Datensammlungen längerfristig nachnutzbare Forschungsressourcen werden können. Das dritte Panel diskutierte schließlich die Potenziale und Grenzen vernetzter Kommunikationskorpora für Analyseformen, insbesondere in der Computational Communication Science (CCS).

Von digitaler Kommunikation zu Korpora für die Forschung

Das erste Panel, moderiert von Patricia Blume, widmete sich der grundlegenden Frage, wie digitale Kommunikationsspuren überhaupt zu Forschungsdaten werden. Die Beiträge veranschaulichten, dass digitale Daten nicht einfach „vorliegen“, sondern in komplexen technischen, sozialen und institutionellen Prozessen hergestellt werden. Welche Daten verfügbar sind, welche Lücken entstehen und welche Kommunikationsformen überhaupt beobachtbar werden, hängt von Plattformarchitekturen, Zugangsmöglichkeiten, Erhebungspraktiken, ethischen Entscheidungen und rechtlichen Rahmenbedingungen ab.

Katharina Kinder-Kurlanda (Universität Klagenfurt) nahm in ihrem Beitrag „Epistemische Herausforderungen von Big Social Media Data für die Sozialwissenschaft“ die Entstehungsbedingungen digitaler Daten in den Blick. Sie zeigte, dass Forschung mit großen Datenbeständen aus sozialen Medien immer auch mit asymmetrischen Datenökonomien verbunden ist. Während plattformbetreibende Unternehmen umfangreiche Datenbestände kontrollieren, sind Forschende häufig auf instabile oder nachträglich eingeschränkte Zugänge angewiesen. Diese Abhängigkeit schlägt sich nicht nur in der Datenerhebung selbst nieder, sondern beschränkt auch den Möglichkeitsraum der Forschungsfragen, die wissenschaftlich überhaupt bearbeitbar sind.

Ein zentrales Thema ihres Beitrags war die Sichtbarkeit von Datenarbeit. Viele Entscheidungen, die für wissenschaftliche Ergebnisse maßgeblich sind, bleiben in Publikationen oft unterbelichtet: Wie wurden Daten erhoben, bereinigt, ausgeschlossen, anonymisiert oder transformiert? Welche Plattformbedingungen haben den Zugang strukturiert? Welche ethischen Abwägungen waren im Forschungsprozess erforderlich? Kinder-Kurlanda betonte, dass Datenpraktiken situiert, iterativ und plattformgebunden sind. Transparenz über diese Praktiken ist daher eine Voraussetzung für die Überprüfbarkeit und Einordnung wissenschaftlicher Ergebnisse.

Auch die Archivierung digitaler Plattformdaten wurde als besondere Herausforderung sichtbar. Am Beispiel früherer Twitter-Forschung wurde aufgezeigt, dass die Archivierung von IDs zwar eine Zeit lang als praktikabler Kompromiss galt, langfristig aber keine verlässliche Perspektive bietet, wenn die Rehydrierung, d.h. die Wiederherstellung der Inhalte, weiterhin von der Plattform abhängig bleibt. Dagegen kann die Archivierung von Code, Erhebungsprotokollen, Dokumentationen und Verarbeitungsroutinen auch dann wissenschaftlichen Mehrwert erzeugen, wenn die vollständigen Rohdaten nicht dauerhaft geteilt werden können. In der Diskussion wurde zudem herausgestellt, dass Forschungsethik nicht vollständig an formale Verfahren oder Infrastrukturen delegiert werden kann. Ethikkommissionen, institutionelle Leitlinien und Beratungsangebote können unterstützen, die Verantwortung für konkrete Forschungsentscheidungen bleibt jedoch Teil der wissenschaftlichen Praxis.

Erik Koenen (Universität Bremen) weitete den Blick auf digitale Zeitungsportale und die epistemischen Folgen der Digitalisierung journalistischer Quellen. Im Zentrum des Beitrags stand, dass digitalisierte Zeitungen nicht einfach analoge Objekte in digitaler Form sind. Sie liegen zugleich als Bild, Layout, Volltext, Metadatenstruktur und Suchumgebung vor. Damit verändern sich nicht nur die Zugriffswege, sondern auch der epistemische Status der Quelle selbst. Digitale Zeitungsportale fungieren nicht allein als Archive, sondern auch als methodische und epistemische Forschungsumgebungen.

Koenen argumentierte, dass digitale Zeitungsportale als medientechnische Assemblagen verstanden werden müssen. Sie sind digitale Archive, Sammlungen, Lesesäle, Suchmaschinen und Experimentalsysteme zugleich. Anknüpfend an wissenschaftstheoretische Perspektiven, unter anderem an Ludwik Flecks Konzept wissenschaftlicher Denkstile und Hans-Jörg Rheinbergers Begriff des Experimentalsystems, zeigte er, dass digitale Technologien neue Formen wissenschaftlicher Beobachtung und Interpretation hervorbringen. Distant Reading und Distant Viewing eröffnen neue Perspektiven auf Medienwandel, Layoutgeschichte und öffentliche Kommunikation, setzen aber zugleich eine digitale Quellenkritik voraus, die sich mit Datenformaten, Auszeichnungspraktiken, OCR-Qualität, Portallogiken und Suchinfrastrukturen auseinandersetzt.

Vanessa Angenendt (Universität Duisburg-Essen) brachte mit ihrem Projekt zu Misogynie in Chat-Kommunikation eine weitere Perspektive auf die Entstehung digitaler Kommunikationsdaten ein. Ihr Beitrag befasste sich nicht mit öffentlicher Plattformkommunikation, sondern mit privater oder halböffentlicher Chat-Kommunikation, die der Forschung bislang nur schwer zugänglich ist. Die Datengrundlage bilden Datenspenden, um Chatverläufe zu erfassen, in denen frauenfeindliche oder misogyne Kommunikation sichtbar wird.

Der Beitrag verdeutlichte die gesellschaftliche Relevanz innovativer Wege der Datengewinnung, weil sozial unerwünschte Phänomene wie digitale Misogynie strukturell bedingt häufig in Kommunikationsräumen stattfinden, die sich klassischen Erhebungsverfahren entziehen. Datenspenden eröffnen hier die Möglichkeit, alltägliche und oft verdeckte benachteiligende Praktiken, die in ungleichen Geschlechterverhältnissen verankert sind, empirisch sichtbar zu machen. So zeigten präsentierte Analysen beispielsweise, dass Misogynie in Chat-Kommunikation nicht nur in einzelnen abwertenden Aussagen sichtbar wird, sondern häufig im Verlauf der Interaktion ähnliche Dynamiken erzeugt. Veranschaulicht wurde dies anhand typischer Sequenzen von Kontaktaufnahme, Ablehnung oder Beendigungsversuch, anschließendem Nachsetzen und Herabwürdigen als Machtdemonstration. Konzepte wie „Unwanted Pursuit Behavior“, „Misogynistic Backlash“ oder „Freezing“ systematisierten, wie Kontrolle, Abwertung und Einschüchterung kommunikativ hergestellt werden.

Zugleich zeigte der Beitrag, welche methodischen und ethischen Herausforderungen mit der Analyse privater Kommunikationsräume verbunden sein können. So muss die Datenspende niedrigschwellig organisiert sein, gleichzeitig aber die Datensouveränität der spendenden Personen respektieren. Nach der Einreichung erfolgt eine irreversible Anonymisierung; die Daten werden für die Analyse aufbereitet, enthalten jedoch keine vollständigen Metadaten. Gerade weil es sich um sensible Daten handelt, stellen sich Fragen der Zugänglichkeit, Nachnutzung und Dokumentation besonders nachdrücklich.1 Auch methodische Leerstellen wurden benannt: Chats, die gelöscht wurden, können nicht untersucht werden, und die Zusammensetzung der Datenspendenden ist durch Rekrutierungswege, Bildungshintergründe und mediale Kooperationspartner:innen geprägt.

Insgesamt zeigte das erste Panel, dass Digitale Kommunikationskorpora keine neutralen Abbilder digitaler Kommunikation sind. Vielmehr sind sie Ergebnisse von Entscheidungen, Infrastrukturen, Machtverhältnissen und Praktiken. Für ihre spätere Nachnutzung reicht es daher nicht aus, Daten lediglich abzulegen. Dokumentiert werden muss auch, wie sie entstanden sind, welche Zugänge möglich waren, welche Ausschlüsse vorgenommen wurden, welche Unsicherheiten bestehen und welche rechtlichen oder ethischen Einschränkungen gelten.

Vom Korpus-Silo zur nachnutzbaren Forschungsdatenlandschaft

Das zweite Panel verschob den Fokus von der Entstehung digitaler Korpora auf ihre langfristige Nachnutzung und wurde von Lydia Riedl moderiert. Ausgangspunkt war die Beobachtung, dass viele Korpora in einzelnen Projekten entstehen und nach Projektabschluss in Datensilos verbleiben. Sie sind dann zwar für das ursprüngliche Projekt nutzbar, werden aber für andere Forschende kaum auffindbar, sind unzureichend dokumentiert oder können aus rechtlichen, ethischen oder technischen Gründen nicht geteilt oder mit anderen Daten verknüpft werden. Alle Beiträge griffen dabei einzelne oder mehrere der FAIR-Prinzipien2 (findable, accessible, interoperable, reusable) auf und übertrugen sie auf die besonderen Bedingungen digitaler Kommunikationskorpora.

Vincent Fröhlich (Universität Erlangen-Nürnberg) eröffnete das Panel mit einem Beitrag zu infrastrukturellen Bedarfen der Forschung mit Daten aus sozialen Medien im Bereich Demokratie- und Rechtsextremismusforschung. Er betonte, dass die Volatilität von Plattformdaten eine zentrale Herausforderung darstellt. Inhalte werden gelöscht, Accounts verschwinden, Schnittstellen ändern sich, Zugänge werden eingeschränkt. Was heute erhoben werden kann, ist morgen möglicherweise nicht mehr verfügbar. Für die Forschung bedeutet dies, dass Fragen der Sicherung, Dokumentation und Nachvollziehbarkeit frühzeitig mitgedacht werden müssen.

Besonders betonte Fröhlichs Beitrag, dass Sicherheit in diesem Forschungsfeld mehrdimensional ist. Es geht nicht nur um die Sicherheit der Daten selbst, sondern auch um die Sicherheit der Forschenden und der beforschten Personen. Wer zu Rechtsextremismus, Desinformation oder demokratiegefährdender Kommunikation forscht, kann selbst zur Zielscheibe werden. Forschungsinfrastrukturen müssen neben der Auffindbarkeit und Nachnutzung von Daten auch Schutzräume, Zugriffskontrollen und gut reflektierte Formen der Sichtbarkeit mitdenken. In der Diskussion wurde die Spannung zwischen wissenschaftlicher Sichtbarkeit, die insbesondere für Qualifikations- und Karrierewege wichtig ist, und dem Schutz von Forschenden thematisiert. Hier zeigte sich, dass Infrastrukturen auch institutionelle Sensibilisierung und Schutzmechanismen unterstützen können.

Birte Kuhle (Center for Advanced Internet Studies) griff die Frage nach nachnutzbaren Daten aus der Perspektive des Forschungsdatenlebenszyklus auf. Ihr Beitrag zu praktischen Herausforderungen im Umgang mit Daten aus sozialen Medien zeigte, dass Forschungsdatenmanagement nicht erst am Ende eines Projekts beginnt. Bereits in der Phase „Discover, Plan & Design“ stellen sich Fragen des Samplings, der Plattformauswahl sowie zu ihren jeweiligen Beschränkungen, der Datenzugänge und der rechtlichen Rahmenbedingungen. In der Phase der Datenerhebung können geplante Zugänge, etwa über Plattform-APIs, kurzfristig wegfallen. Forschende müssen dann alternative Wege wie Datenspenden oder Webscraping prüfen, die wiederum eigene ethische und rechtliche Fragen aufwerfen.

Auch die Verarbeitung und Analyse von Daten aus sozialen Medien ist mit erheblicher Datenarbeit verbunden. Daten müssen bereinigt, strukturiert, mit IDs versehen, versioniert und dokumentiert werden. Multimodale Daten erhöhen den Aufwand zusätzlich, weil Text, Bild, Audio und Video unterschiedliche Formate, Werkzeuge und Dokumentationslogiken erfordern. Für die Phase „Publish, Archive & Share“ stellte Kuhle die Frage, was überhaupt veröffentlicht werden darf, welche Teile eines Datensatzes zugänglich gemacht werden können und wie FAIR-Prinzipien unter Bedingungen eingeschränkter Teilbarkeit umgesetzt werden können.

Als zentrale take-aways formulierte Kuhle, dass die Arbeit mit Social-Media-Daten technische, methodische sowie rechtlich-ethische Kompetenzen verlangt und häufig mit hohem Ressourcenaufwand bei zugleich fehlenden Unterstützungs- und Anreizstrukturen verbunden ist. FAIR-Prinzipien, Community-Standards und Forschungsdateninfrastrukturen erscheinen vor diesem Hintergrund nicht als nachgelagerte Formalia, sondern als Voraussetzung dafür, Social-Media-Daten transparenter, nachvollziehbarer und nachnutzbarer zu machen. Die Diskussion zeigte darüber hinaus, dass Metadatenstandards, Codeveröffentlichung und Dokumentationspraktiken bislang noch nicht einheitlich etabliert sind.

Philipp Knöpfle (LMU München) widmete sich mit Blick auf das Projekt „Meta-Rep“ der Reproduzierbarkeit und Replizierbarkeit computationaler Kommunikationsforschung. Anhand eines Literaturreviews zu mehreren hundert Studien zeigte er, dass Daten und Code in der CCS bislang nur selten systematisch geteilt werden. Besonders problematisch ist dies bei Plattformdaten, da sie sich oft nur schwer oder gar nicht replizieren lassen. Wenn Datenzugänge eingeschränkt sind, Plattformen Inhalte löschen oder Schnittstellen verändern, kann eine spätere Replikation schnell unmöglich werden.

Knöpfle unterschied dabei zwischen Reproduzierbarkeit und Replizierbarkeit und zeigte, dass beide Ziele unterschiedliche Anforderungen an Daten, Code und Dokumentation stellen. Selbst wenn Rohdaten aus rechtlichen oder praktischen Gründen nicht geteilt werden können, können Begleitmaterialien oder Metadaten durchaus hilfreich dabei sein, Studienergebnisse besser einzuordnen. Hierzu zählen die Veröffentlichung von Code, die Dokumentation der Datenerhebung, die Beschreibung von Samplingentscheidungen, die Offenlegung von Preprocessing-Schritten und die Angabe von Tools inklusive Parametern und Versionierung. In der Diskussion kam auf, dass die Wahl geeigneter Ablageorte ebenfalls eine praktische Frage ist. Während Plattformen wie The Open Science Framework (OSF) zum Zeitpunkt des Workshops vielen Forschenden niedrigschwelliger erschienen3, bieten institutionelle Git-Infrastrukturen andere Vorteile, setzen aber höhere technische Kompetenzen voraus.

Eine verbindende Klammer über die Beiträge im zweiten Panel hinweg war, dass Nachnutzbarkeit nicht zwingend vollständige Offenlegung aller Daten bedeutet. Gerade digitale Kommunikationsdaten sind häufig sensibel, rechtlich geschützt oder plattformabhängig. Umso wichtiger sind gestufte Zugangsmodelle, umfängliche und verständliche Dokumentation, sowie die Sicherung von Kontextinformationen. Auch nicht vollständig teilbare Korpora können wertvoll für die Forschung bleiben, wenn nachvollziehbar ist, wie sie entstanden sind, welche Analysen mit ihnen durchgeführt wurden und unter welchen Bedingungen andere Forschende daran anschließen können.

Vernetzte Kommunikationskorpora analysieren: Potenziale und Fallstricke

Das dritte Panel wurde von Kai Matuszkiewicz moderiert und richtete den Blick auf die Analyse vernetzter Kommunikationskorpora. Welche neuen Forschungsperspektiven entstehen, wenn digitale Kommunikationsdaten gut dokumentiert, referenzierbar und miteinander verknüpfbar sind? Und welche methodischen Voraussetzungen müssen erfüllt sein, damit großskalige, plattformübergreifende und KI-gestützte Analysen valide Ergebnisse liefern?

Marko Bachl (FU Berlin) eröffnete das Panel mit einem Beitrag zu Bias und epistemischen Konsequenzen für die CCS. Ausgangspunkt war ein statistisches Verständnis von Bias als systematischem Fehler, der von zufälliger Varianz zu unterscheiden ist. Der Bias-Variance-Tradeoff diente dabei als analytisches Raster, um Chancen und Risiken automatisierter Verfahren in der Kommunikationsforschung einzuordnen.

Am Beispiel von Large Language Models (LLMs) in der Inhaltsanalyse zeigte Bachl, dass automatisierte Verfahren neue Möglichkeiten eröffnen. So können sie beispielsweise nicht-textuelle Kommunikationsinhalte transkribieren, Inhalte extrahieren, große Stichproben klassifizieren und damit Analysen ermöglichen, die hand-codiert kaum durchführbar wären. Zugleich können sie die Reproduzierbarkeit erhöhen, weil dieselben Verfahren auf große Datenmengen konsistent angewendet werden können. Diese Reduktion von Varianz geht jedoch nicht automatisch mit einer Reduktion von Bias einher. Im Gegenteil: Automatisierte Verfahren können systematische Verzerrungen erzeugen oder verstärken, wenn Trainingsdaten, Modellarchitekturen, Prompts oder Validierungsmaßstäbe bestimmte Perspektiven privilegieren.

In der anschließenden Diskussion wurde dafür plädiert, dass die Bewertung von KI-gestützten Verfahren nicht abstrakt erfolgen kann. Entscheidend ist, welches Forschungsziel verfolgt wird, welcher Referenzmaßstab angesetzt wird und welche Formen von Fehlern in Kauf genommen werden wollen. Menschliche Codierungen sind dabei nicht automatisch ein unverzerrter Goldstandard, sondern selbst Ergebnis sozialer Umstände sowie methodischer und interpretativer Entscheidungen. Gerade deshalb braucht die CCS eine explizite Auseinandersetzung mit Validierung, Bias, De-Biasing und den epistemischen Annahmen automatisierter Analyseverfahren.

Felix Victor Münch (GESIS/HBI) knüpfte mit seinem Beitrag an die forschungspraktischen Potenziale von LLMs an. Im Zentrum stand die Frage, wie diese zur plattform-, medien- und sprachübergreifenden Verknüpfung von Kommunikationsdaten eingesetzt werden können. Münch zeigte anhand mehrerer Anwendungsbeispiele, dass LLMs nicht nur als dialogische Systeme verstanden werden sollten, sondern als Werkzeuge zur Strukturierung, Transformation, Klassifikation und Verknüpfung großer, heterogener Datenbestände.

Ein Beispiel bezog sich auf die plattformübergreifende Analyse von Kommunikation zu Klimawandel, Desinformation und rechtsextremen Diskursen. Hier wurden große Datenmengen über längere Zeiträume hinweg erhoben und mit Verfahren wie Embeddings, Clustering und Netzwerkanalysen ausgewertet. Ein weiteres Beispiel stellte die Analyse von politischer Kommunikation in TikTok-Videos dar. Semantische Ähnlichkeitsmodelle wurden genutzt, um Themenprofile, Nähebeziehungen und Kommunikationsstrukturen zwischen unterschiedlichen Akteur:innen sichtbar zu machen.

Die Beispiele zeigten anschaulich, welche analytischen Möglichkeiten entstehen können, wenn Daten aus unterschiedlichen Plattformen, medialen Formen und Sprachen in gemeinsame Repräsentationsräume überführt werden können. Dadurch werden Vergleiche möglich, die zuvor nur mit erheblichem manuellem Aufwand oder überhaupt nicht realisierbar waren. Zugleich zeigte Münch, dass solche Pipelines technisch und organisatorisch voraussetzungsreich sind. Sie erfordern Rechenressourcen, methodisches Know-how, sorgfältige Datenaufbereitung und Verfahren zur Qualitätskontrolle. LLMs können solche Prozesse perspektivisch vereinfachen, ersetzen aber nicht die Notwendigkeit, Datenkontexte, Modellentscheidungen und Bewertungskriterien transparent zu dokumentieren.

Jakob Jünger (Universität Münster) schloss das Panel mit einem Beitrag zu Normdaten und Knowledge Graphs als Grundlage für Sekundäranalysen. Sein Ausgangspunkt war die Frage, wie geistes- und sozialwissenschaftliche Arbeitspraktiken stärker miteinander verbunden werden können. Während klassische Nachweis- und Katalogsysteme Literatur, Daten oder Projekte auffindbar machen, erlauben sie meist keine strukturierte Abfrage wissenschaftlicher Aussagen, Beziehungen und Kontexte. Normdaten, kontrollierte Vokabulare, Ontologien und Knowledge Graphs können hier neue Formen der Vernetzung ermöglichen.

Jünger erläuterte Normdaten als Identifier, Vokabulare und Ontologien, die Entitäten eindeutig beschreibbar und miteinander verknüpfbar machen. Knowledge Graphs bilden solche Entitäten und ihre Beziehungen als Netzwerk ab. Als bekanntes Beispiel wurde Wikidata herangezogen. Für die Kommunikationswissenschaft skizzierte Jünger drei mögliche Beteiligungsformen: bestehende Datensätze können mit Normdaten angereichert werden, bestehende Wissensbestände können um neue fachlich relevante Entitäten erweitert werden, und fachnahe Infrastrukturen können eigene Knowledge Graphs aufbauen und betreiben.

Besonders relevant wurde diese Perspektive im Hinblick auf Interoperabilität. Daten werden nicht allein dadurch FAIR, dass sie irgendwo abgelegt werden. Sie müssen auffindbar, zugänglich, interoperabel und nachnutzbar beschrieben sein. Für die Kommunikations- und Medienwissenschaft eröffnet dies erhebliche Potenziale. Forschungsprojekte, Datensätze, Publikationen, Tagungsbeiträge, Personen, Institutionen, Quellen, Methoden und Untersuchungsgegenstände könnten miteinander verknüpft werden. Damit würde nicht nur die Recherche verbessert, sondern auch die Grundlage für Sekundäranalysen, fachgeschichtliche Auswertungen und neue Formen der Wissensrepräsentation geschaffen.

Das dritte Panel zeigte insgesamt, dass vernetzte Kommunikationskorpora große Analysepotenziale eröffnen können. LLMs, computationale Methoden, Normdaten und Knowledge Graphs ermöglichen neue Perspektiven auf Kommunikationsdynamiken über Plattform-, Medien-, Sprach- und Zeitgrenzen hinweg. Zugleich wurde sichtbar, dass diese Potenziale sich nur dann in wissenschaftlich belastbare Ergebnisse verwirklichen lassen, wenn Datenqualität, Validierung, Interoperabilität, Dokumentation und Bias systematisch reflektiert werden.

Fünf zentrale Erkenntnisse des Workshops

Über alle drei Panels hinweg zog sich der Befund, dass digitale Kommunikationskorpora keine bloßen Sammlungen neutraler Daten sind. Sie entstehen durch soziale, rechtliche, wissenschaftliche, technische und ethische Entscheidungen sowie durch die Bedingungen ihrer Erhebung, Verarbeitung und Aufbereitung. Ihre Qualität bemisst sich daher nicht allein an Umfang oder technischer Verfügbarkeit, sondern an der Nachvollziehbarkeit ihrer Entstehung, Prozessierung und Kontextualisierung.

Eine zweite zentrale Erkenntnis war, dass diese Bedingungen der Datenentstehung systematischer dokumentiert werden müssen. Dazu gehören Plattformbedingungen, Zugangspfade, Samplingentscheidungen, Löschungen und Ausschlüsse, fehlende Daten, Anonymisierungsschritte, Metadatenverluste und ethische Abwägungen. Gerade bei Daten aus sozialen Medien, Datenspenden oder digitalisierten Quellen ist entscheidend, welche Teile der Kommunikation sichtbar werden, welche unsichtbar bleiben und wie diese Einschränkungen der Datenbasis nachvollziehbar gemacht werden können.

Drittens zeigte sich, dass Nachnutzung nicht mit vollständiger Offenheit gleichgesetzt werden darf. Viele digitale Kommunikationsdaten können aus guten Gründen nicht frei zugänglich gemacht werden. Trotzdem können sie durch beschreibende Metadaten, Code, Dokumentationen, Analyseprotokolle, kontrollierte Zugangsmodelle oder Verweise auf geeignete Kontaktstellen wissenschaftlich anschlussfähig bleiben.

Viertens wurde die Bedeutung von Interoperabilität sichtbar. Wenn Forschungsdaten, Publikationen, Projekte, Personen, Institutionen, Quellen und Methoden isoliert voneinander dokumentiert werden, bleiben viele Anschlussmöglichkeiten ungenutzt. Entitätenbasierte Modelle, Normdaten und Knowledge Graphs können dazu beitragen, Forschungsergebnisse nicht nur abzulegen, sondern in fachliche Zusammenhänge durch die Nutzung von Semantic-Web-Anwendungen einzubetten.

Eine fünfte zentrale Erkenntnis liegt darin, dass Infrastrukturen nicht erst am Ende des Forschungsprozesses relevant werden. Sie können bereits in der Planungsphase helfen, Datenerhebungen besser zu koordinieren, rechtliche und ethische Fragen frühzeitig zu klären, Dokumentationsstandards mitzudenken und spätere Nachnutzung vorzubereiten.

Perspektiven für die Arbeit des FID Media

Für den FID Media ergaben sich aus dem Workshop mehrere konkrete Handlungsfelder, die bereits in der von Lukas Hohendorf moderierten Abschlussdiskussion aufgegriffen wurden und in der weiteren strategischen Entwicklung geprüft und mit der Fachcommunity vertieft werden sollen.

Ein erstes mögliches Handlungsfeld liegt in der Entwicklung fachspezifischer Dokumentationsvorlagen für digitale Kommunikationskorpora. Diese sollten gemeinsam mit Forschenden erarbeitet werden und unterschiedliche Datentypen berücksichtigen: Plattformdaten, Chatdaten, journalistische Inhalte, audiovisuelle Materialien, digitalisierte Quellen und multimodale Korpora. Solche Vorlagen könnten Mindestangaben zu Datenherkunft, Erhebungswegen, Sampling, Plattformbedingungen, Preprocessing, Versionierung, Anonymisierung, rechtlichen Grundlagen und Nutzungsrechten, Zugangsbedingungen und möglichen Verzerrungen enthalten. Ziel wäre keine zusätzliche Bürokratie, sondern eine praxistaugliche Unterstützung für Forschende, die ihre Daten nachvollziehbar und nachnutzbar dokumentieren möchten. In der Entwicklung derartiger Vorlagen liegt eine Zusammenarbeit mit NFDI-Konsortien nahe, wie sie bereits in der Vergangenheit gepflegt wurde, insbesondere mit dem von NFDI4Culture, Text+, BERD@NFDI und KonsortSWD getragenen Arbeitskreis Social Media-Daten in der Forschungspraxis.

Ein zweites Handlungsfeld betrifft den Aufbau einer fachnahen Nachweis-, Register- und Vermittlungsinfrastruktur für digitale Kommunikationskorpora. Ein solches Angebot könnte geplante, laufende und abgeschlossene Korpusvorhaben in der Kommunikations- und Medienwissenschaft sichtbar machen: Welche Projekte erheben oder nutzen Daten zu welchen Plattformen, Quellen, Zeiträumen und Themen, mit welchen Methoden und unter welchen Zugangsbedingungen? Besonders vielversprechend wäre dabei eine Funktion für geplante Datenerhebungen. Forschende könnten Vorhaben frühzeitig eintragen, wodurch sich Kooperationsmöglichkeiten erkennen lassen, bevor Daten mehrfach, inkompatibel oder unter hohem Aufwand parallel erhoben werden. Zugleich könnte der FID Media abgeschlossene Projekte, Datensätze, Publikationen, Codebooks, Präsentationen, Personen, Einrichtungen, Methoden und Einträge in externen Repositorien fachlich erschließen und miteinander verknüpfen. Der FID Media müsste dafür nicht alle Daten selbst speichern, sondern Daten könnten dort öffentlich publiziert, archiviert oder kontrolliert zugänglich gemacht werden, wo die jeweils geeigneten technischen und rechtlichen Voraussetzungen bestehen. Der FID Media könnte durch ein zentrales Forschungsregister ergänzend dafür sorgen, dass diese Ressourcen für die Kommunikations- und Medienwissenschaft sichtbar, verständlich kategorisiert und mit weiteren fachlichen Informationen verknüpft werden. Das entitätenbasierte Modell des Repositoriums des FID Media bietet hierfür eine vielversprechende Grundlage und könnte perspektivisch einen Beitrag zu potenziellen fachlichen Wissensgraphen der Kommunikations- und Medienwissenschaft leisten.

Ein drittes Handlungsfeld besteht in der Weiterentwicklung von Beratung und Vernetzung von Forschenden mit Infrastrukturen. Der Workshop zeigte, dass Forschende bei digitalen Kommunikationskorpora regelmäßig mit rechtlichen, ethischen und technischen Fragen konfrontiert sind: Was darf erhoben werden? Was darf gespeichert, geteilt oder veröffentlicht werden? Welche Teile eines Datensatzes können offen zugänglich sein, welche nur kontrolliert, welche gar nicht? Welche Dokumentation ist sinnvoll, wenn Daten nicht geteilt werden können? Hier prüft der FID Media, in seinen bestehenden Beratungsangeboten, etwa zu Urheberrecht, Open Access, Open Science und Forschungsdatenmanagement, noch stärker die spezifischen Bedarfe digitaler Kommunikationsforschung zu berücksichtigen.

Fazit

Der Workshop hat gezeigt, dass die Frage „Was bleibt von digitalen Kommunikationskorpora?“ nicht erst nach Projektende gestellt werden sollte. Sie beginnt bereits bei der Auswahl von Quellen, Plattformen und Zugängen, setzt sich in Sampling, Datenerhebung, Datenbereinigung und Analyse fort und reicht bis zur Publikation, Archivierung und späteren Nachnutzung. Digitale Kommunikationskorpora sind nur dann langfristig wissenschaftlich wertvoll, wenn ihre Entstehungsbedingungen, ihre Einschränkungen und ihre Nutzungskontexte nachvollziehbar bleiben.

Für die Kommunikations- und Medienwissenschaft ergibt sich daraus eine doppelte Herausforderung. Einerseits eröffnen digitale Korpora neue Forschungsperspektiven, etwa auf schwer zugängliche Kommunikationsräume, langfristige Medienentwicklungen, plattformübergreifende Diskurse oder multimodale Kommunikationsdynamiken. Andererseits entstehen neue Anforderungen an Quellenkritik, Datenethik, Dokumentation, Reproduzierbarkeit, Interoperabilität und Infrastrukturen.

Der FID Media nimmt aus dem Workshop den Auftrag mit, diese Fragen gemeinsam mit der Fachcommunity weiterzuverfolgen. Ziel ist es, digitale Kommunikationskorpora nicht nur als projektgebundene Datensammlungen zu betrachten, sondern als potenziell vernetzte Forschungsressourcen, die zukünftige Forschung vorbereiten, erleichtern und sichtbar machen können. Entscheidend wird sein, hierfür niedrigschwellige, fachnahe und zugleich methodisch passende Angebote zu entwickeln. Diese reichen von der Beratung in der Planungsphase über Standards in der Dokumentation und der Registrierung laufender Vorhaben bis hin zur Unterstützung bei der Publikation, Verzeichnung und Vernetzung abgeschlossener Projekte.

Der Workshop hat damit den Blick weg vom einzelnen Korpus hin auf die Voraussetzungen seiner wissenschaftlichen Anschlussfähigkeit gelenkt. Für Open Science in der Kommunikations- und Medienwissenschaft folgt daraus, dass nicht allein entscheidend ist, ob Daten veröffentlicht werden können, sondern ob ihre Herkunft, Reichweite, Einschränkungen und Beziehungen so beschrieben sind, dass sie in der Forschungscommunity weitergedacht, geprüft und kombiniert werden können. Hierin liegt die künftige Infrastrukturaufgabe, die Kommunikations- und Medienwissenschaft darin zu unterstützen, aus verstreuten Projektspuren einen übersichtlichen und möglichst vollständigen Orientierungsraum zu schaffen, in dem neue Forschung nicht immer wieder bei null beginnen muss, sondern auf bereits geleistete Aufwände und vorhandene Erkenntnisse aufbauen und bestehende Ergebnisse produktiv nachnutzen kann.


1 In der Diskussion wurde außerdem die öffentliche Verfügbarkeit der Daten unter ethischen Gesichtspunkten zur Debatte gestellt, da sie sich als Trainingsmaterial für böswillige Chatbotbetreibende eignen würden.

2 Wilkinson, M., Dumontier, M., Aalbersberg, I. et al. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data 3, 160018. https://doi.org/10.1038/sdata.2016.18

3 Anmerkung: Nach dem Workshop kündigte das Center for Open Science an, den Bereich OSF Projects wegen fehlender Finanzierung auslaufen zu lassen, so dass ab November 2026 keine neuen Projekte mehr angelegt werden können. Diese Entwicklung zeigt, dass Open Science nicht allein niedrigschwellige Werkzeuge, sondern wissenschaftsgeleitete, institutionell fest verankerte und dauerhaft finanzierte Infrastrukturen benötigt, um die langfristige Verfügbarkeit von Forschungsinhalten sicherstellen und die FAIR-Prinzipien umzusetzen.

Der Text dieses Beitrags steht unter der Lizenz Creative Commons Namensnennung 4.0 International (CC BY 4.0). Die Abbildungen sind von dieser Lizenz ausgenommen; alle Rechte vorbehalten.

Veranstaltung: „Interdisziplinäre Qualifikationsarbeiten betreuen“

2026年9月1日 16:08

HERMES-Podiumsdiskussion mit Prof. Dr. Anna Neovesky, Dr. Shumon T. Hussain und Dr. Anna Froese

Wie gelingt die Betreuung interdisziplinärer Arbeiten in den digitalen Geistes- und Kulturwissenschaften? Was bedeutet Interdisziplinarität in den Digital Humanities? Und welche Chancen und Risiken bergen  interdisziplinäre Ansätze für den Karriereweg der Absolvent*innen? Diese und weitere Fragen diskutieren drei Expert*innen aus verschiedenen Disziplinen. Erfolgreiche Ansätze von der Themenfindung über die Methodenintegration bis hin zur Bewertung können so in die eigene Betreuungspraxis integriert werden.

📅 Datum: 17.09.2026

🕕 Uhrzeit: 18:00 – 19:30 Uhr 

💻 Ort: Zoom

Anmeldung: Bitte registrieren Sie sich über folgenden Link für die Veranstaltung: https://tu-darmstadt.zoom-x.de/meeting/register/2JvcIoveSLuMaOnQZLVkPQ

Weitere Informationen unter: https://hermes-hub.de/aktuelles/events/betreuenden-ws-interdisziplinarit%C3%A4t-2026-09-17.html

Die Veranstaltung ist Teil der HERMES-Reihe „Betreuungskompetenz gezielt stärken: Chancen und Herausforderungen in den digitalen Geistes- und Kulturwissenschaften“, die sich insbesondere an Betreuende von Qualifikationsarbeiten richtet und gemeinsam von der Technischen Universität Darmstadt und der Universität Trier organisiert wird.

DH2026 DAEJEON, SÜDKOREA • Engagement zwischen Schnittmuster, Daten und 3D Garment Reconstruction

2026年8月27日 04:03

Dank des Reisestipendiums der DHd durfte ich diesen Sommer zur DH2026 nach Daejeon, Südkorea, reisen. Da ich zurzeit an der Schwelle zwischen Masterarbeit und Konzeption meines Promotionsprojektes stehe, war die Konferenz für mich eine transformative Erfahrung: eine Woche voller interdisziplinärer Impulse, wertvollem Fachfeedback und neuer internationaler Perspektiven, alles unter dem diesjährigen Fokus „Engagement“.

Hands-on: Die ersten Konferenztage

Der Auftakt der Konferenz bestand wie üblich aus Workshops und Minikonferenzen, die für mich ganz im Zeichen des praktischen Ausprobierens und des methodischen Querdenkens standen. Durch meinen Hintergrund in Medienwissenschaften/Medieninformatik habe ich besonders Gefallen an Workshops/Minikonferenzen gefunden, die Visualisierung und interaktive Medienformen aufgriffen.

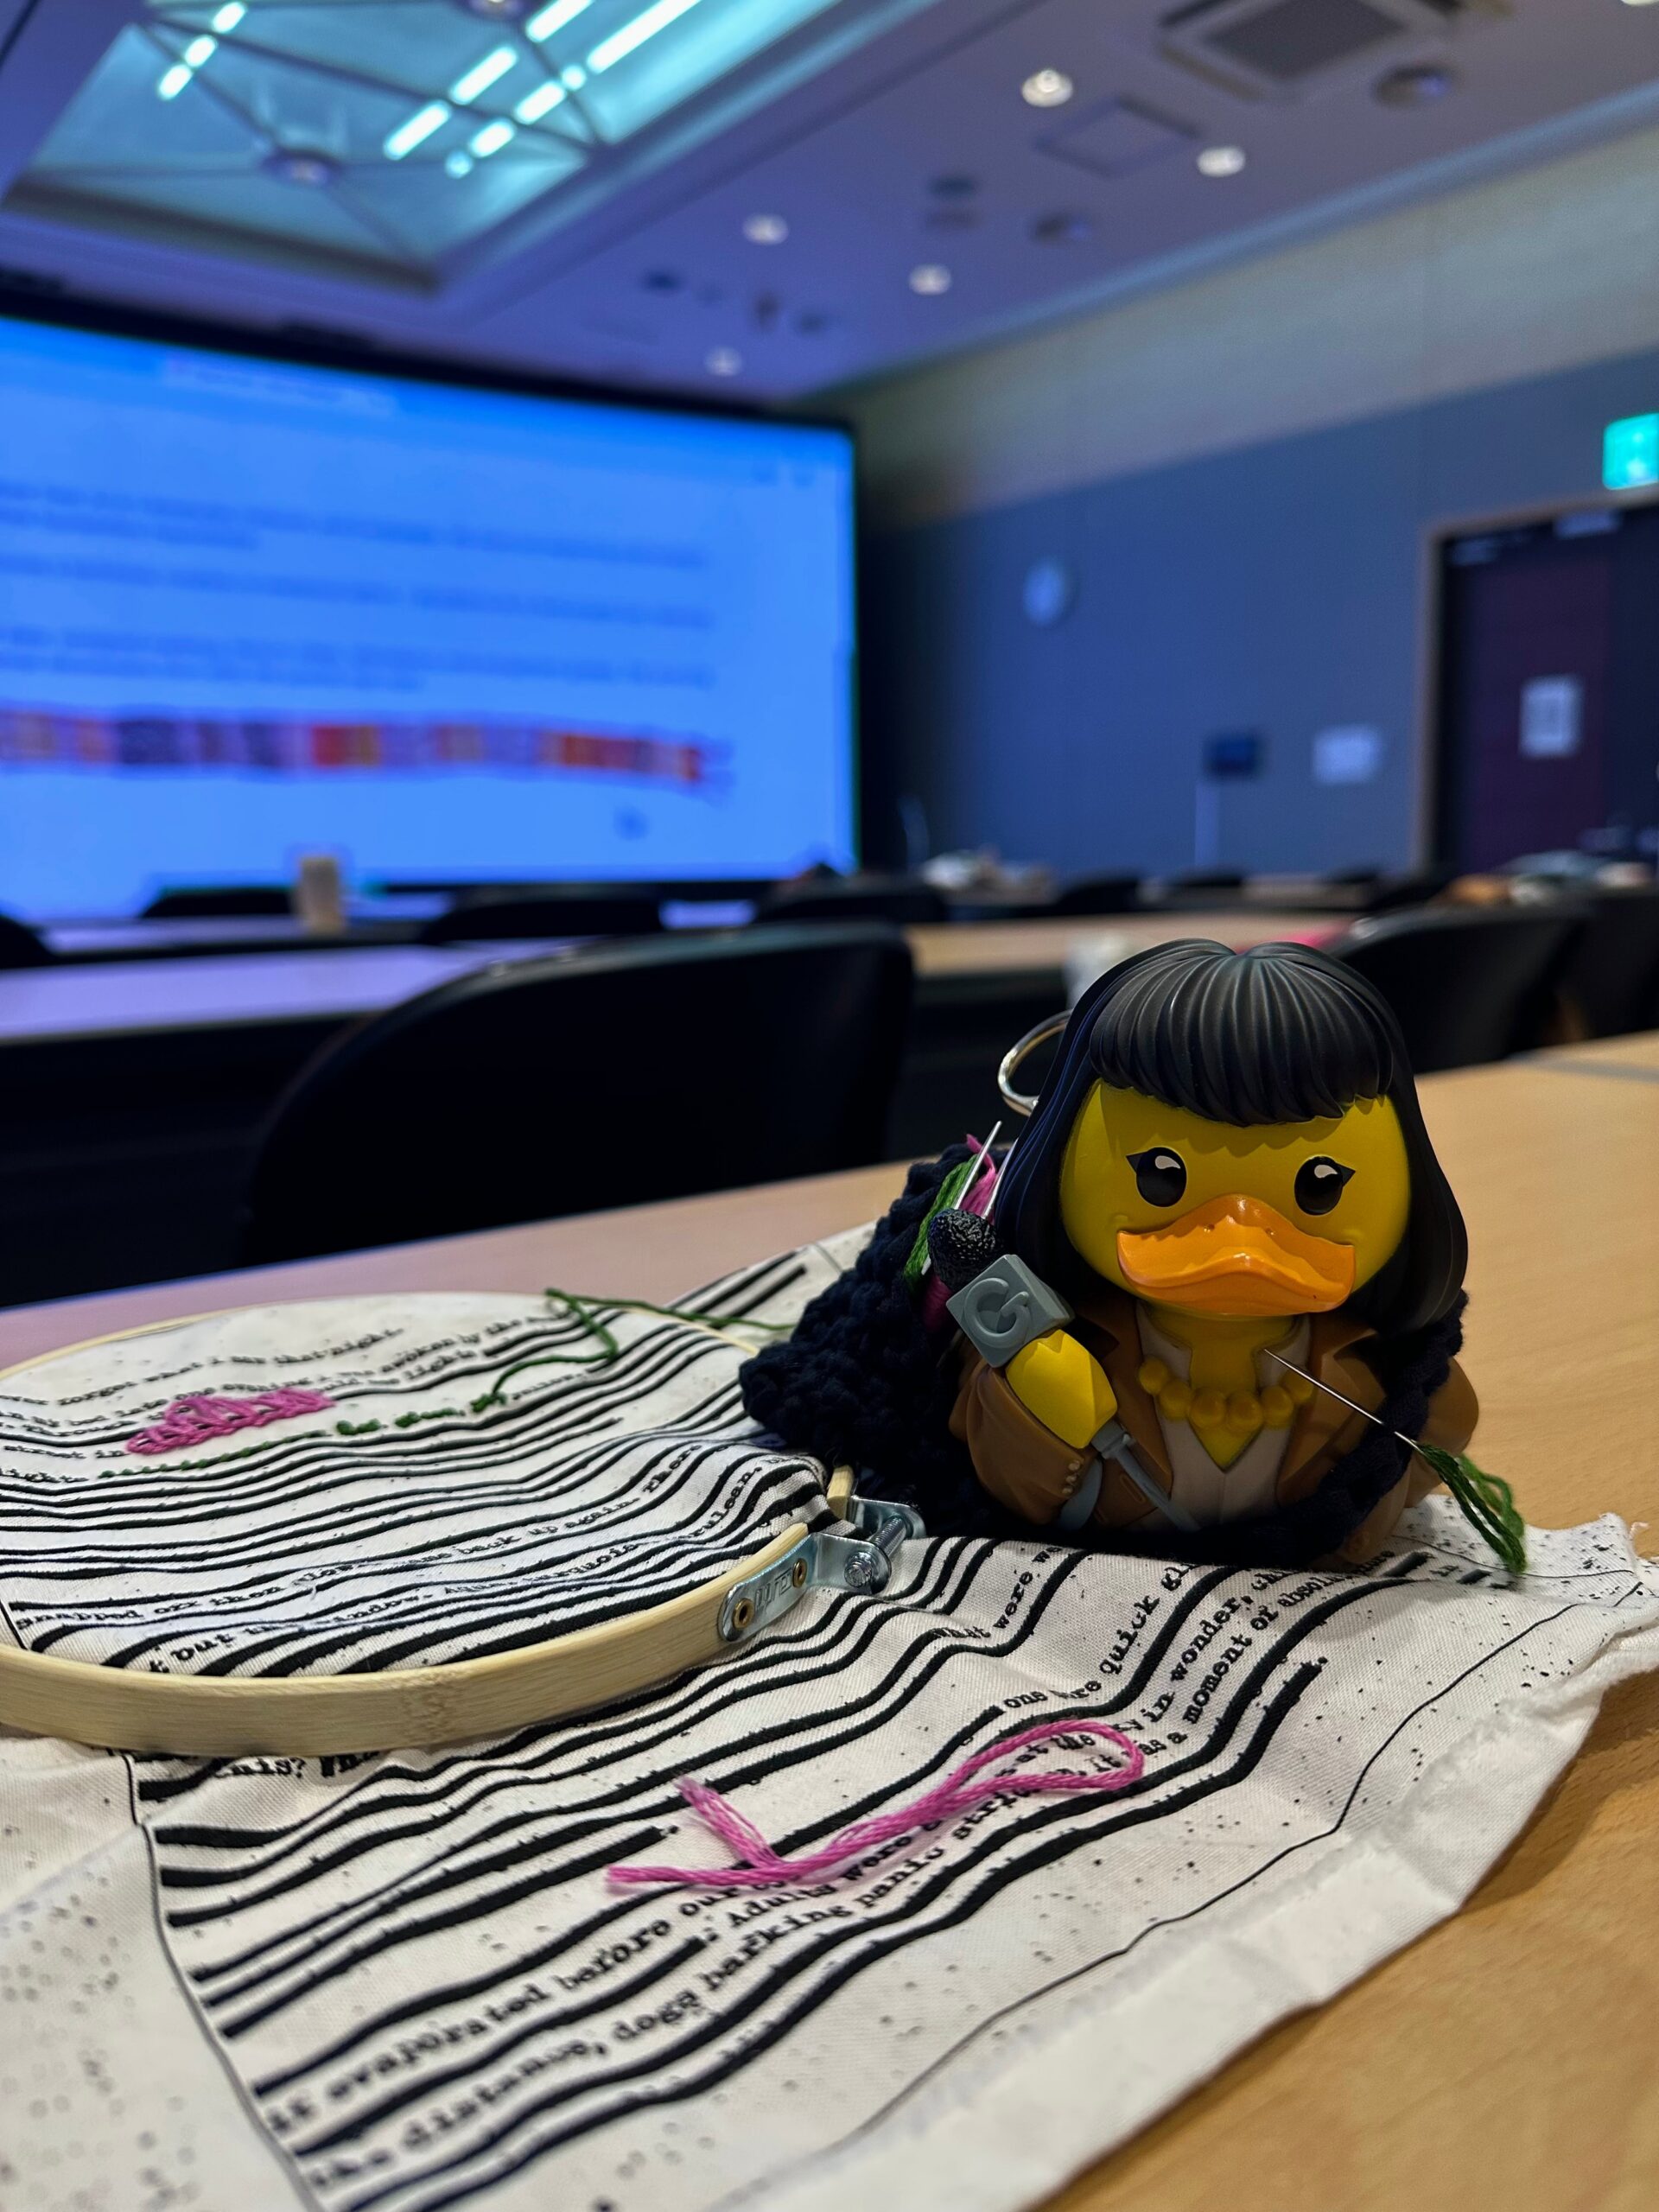
Rubber duck doing craftsSo bot mir bereits am ersten Tag der Workshop zu IIIF-Tools von Glen Robson und Martin Kalfatovic direkte Anwendungsmöglichkeiten für die eigene Forschungspraxis. Ein besonderes Highlight für mich folgte jedoch direkt im Anschluss beim Brainstorming & Prototyping für Educational Games mit Sophia Booij und Nellie Seale. Das metaphorische „toying with ideas“ zeigte nachdrücklich, wie Fachinhalte und Informationen für unterschiedliche (schwierige) Zielgruppen zugänglich gemacht und methodisch aufgearbeitet werden können. 

Ähnlich verhielt es sich am zweiten Tag in der Minikonferenz „#DHMakes: Embodied Craft as Critical Engagement“. Das Verknüpfen von klassischem Handwerk und textiler Kunst mit Datenvisualisierung eröffnete für mich neuartige Zugänge der Interaktion: Die Übersetzung von Daten in das Haptisch-Physische verändert grundlegend, wie wir uns mit Inhalten auseinandersetzen können. Da ich mich im Digitalen viel mit textiler Kunst auseinandersetze, sprach mich hier die Minikonferenz besonders an.

Digital Fashion als Forschungsmethode: Mein Beitrag auf der DH2026

Der Kern meiner Reise war die Präsentation meines Konferenzbeitrags am dritten Tag. Vorgestellt habe ich das Paper „From 2D sewing patterns to dynamic 3D models: documenting cultural heritage in digital fashion.“, welches ich in Zusammenarbeit mit meinem Co-Autor Prof. Dr. Øyvind Eide eingereicht habe. Das Paper fokussiert sich auf ein in den Digital Humanities bislang stark unterrepräsentiertes Themenfeld: die Erforschung und Dokumentation von Kleidung als materielles und immaterielles Kulturerbe.

Der Erhalt von Kleidung als materielles Kulturerbe und damit die Dokumentation von Fashion, oder auch Mode, als immaterielles Kulturerbe, steht in enger Abhängigkeit von der Minimierung des materiellen Zerfalls von Textilien. Entsprechende Aufbewahrungsrichtlinien schränken dadurch jedoch die Rezipierbarkeit der Kleidung in ihrem ursprünglichen Kontext stark ein. Einflüsse wie Gravitation, Bewegung und das Gefühl des Stoffes, sowie das Binden, Knoten oder Layering von Kleidung gehen hier nahezu oder vollständig verloren.

Unsere reproduzierbare Methodik der digitalen Rekonstruktionen basiert auf 2D-Schnittmustern und transformiert diese zu dynamischen 3D-Kleidungssimulationen, welche dabei nicht nur als Erkundung der Beziehung zwischen Schnittmustern, Kleidungsstücken und dem Digital Fashion Object dienen, sondern auch eine direkte Simulation darstellen, wie wir Kleidung tragen und herstellen.

Da diese Forschung auf meiner Masterarbeit aufbaut und das Fundament meines geplanten PhD-Projektes bildet, war der direkte Austausch vor Ort von hohem Wert für mich. Das konstruktive Feedback aus unterschiedlichen Disziplinen und kulturellen Kontexten hat mir wichtige Impulse in Sachen 3D-Modellierung, Verbindungen mit Game Studies und die Einbettung in das Digital Cultural Heritage geliefert. Die aufschlussreichen Diskussionen verankerten unsere theoretische Arbeit in der Modelltheorie und der Intermedialität und unterstrichen gleichzeitig die Bedeutung der Forschung. Die Verbindung zu der globalen Community hat meine wissenschaftliche Perspektive zutiefst bereichert und mich für die nächste Phase meines akademischen Weges inspiriert. Nicht nur durch Feedback, sondern auch durch neue Kontakte.

Austausch und Nachwuchsperspektive

Neben den wissenschaftlichen Panels lebte die DH2026 von der warmen Gastfreundschaft und dem lebendigen Austausch bei der Poster-Session, den Coffee Breaks oder dem Konferenzbankett. Daejeon by night

Die Teilnahme an der DH2026 hat noch einmal meinen Horizont hinsichtlich der Vielfältigkeit der Digital Humanities erweitert. Auch wenn mir diese Vielfalt vorher schon bewusst war, ist das Erleben der Bandbreite an unterschiedlichen Forschungsfeldern, Interessen und kreativen Anwendungsansätze sehr aufschlussreich für mich gewesen. Vor allem aber hat die Vielfältigkeit mich dazu angeregt, mich weiterhin mit unterschiedlichen Medientypen auseinanderzusetzen und verschiedene Formen der Visualisierung, Modellierung und Dokumentation stetig kritisch zu reflektieren. Was langfristig meine eigene akademische Praxis beeinflussen wird.

Besonders gefallen hat mir unter anderem der Beitrag „Where War Lived“ von Liam Isaac Downs-Tepper und dessen Einblicke in Photogrammetry oder die Keynote von Maciej Eders als Antonio Zampolli-Preisträger, die ganz unter dem Motto stand: „All you need is a coffee machine and a couch!“.

Die DH2026 hat mir gezeigt, dass „Engagement“ für mich nicht nur die aktive Teilnahme an einer Konferenz bedeutet. Es bedeutet auch, sich auf neue Methoden einzulassen, Forschung über Disziplingrenzen hinweg zu denken und Teil einer internationalen wissenschaftlichen Gemeinschaft zu werden.

Meine Erfahrung auf der DH2026 habe ich ebenfalls in einer Live-Dokumentation über meinen Mastodon-Account (https://fedihum.org/@lpascale) geteilt. Auch hier war ich begeistert von der schnellen Aufnahme in die Community, die mich und meine Reporterquietscheente mit offenen Armen empfangen hat.

Fazit & Dank

Die DH2026 in Daejeon war geprägt von inspirierenden Keynotes, informativen Vorträgen und bereichernden Begegnungen. Der Tagungsabschluss hat verdeutlicht, wie essenziell der persönliche Kontaktaufbau für Forschende ist. Mein herzlicher Dank gilt meinem Co-Autor Prof. Dr. Øyvind Eide, den Organisator*innen vor Ort sowie insbesondere der DHd für die finanzielle Unterstützung durch das Reisestipendium. Ohne diese Unterstützung wäre diese wertvolle Erfahrung für mich nicht möglich gewesen!


Zwei Postdoc-Stellen Digitale Sozial- und Geisteswissenschaft Uni Oldenburg

2026年8月26日 12:19

Die Carl von Ossietzky Universität Oldenburg sucht:

Zwei Postdoktorand*innenstellen im Bereich Digitale Sozial- und Geisteswissenschaften (DSSH)

Vergütung E13 TV-L
Stellenumfang 100% (teilzeitgeeignet)
Einrichtung Fakultät III – Sprach- und Kulturwissenschaften, Fakultät IV – Human- und Gesellschaftswissenschaften, Digital Social Sciences and Humanities (DSSH)
Dienstort Oldenburg (Oldb)
Bewerbungsfrist 27.08.2026
Beschäftigungsbeginn 01.11.2026
Befristet bis zum 30.09.2030

Über uns

Die Carl von Ossietzky Universität erhält vom Ministerium für Wissenschaft und Kultur (MWK) und der VolkswagenStiftung aus der Förderlinie „Potenziale strategisch entfalten“ für ihre Profilschärfung und zur Stärkung ihrer nationalen und internationalen Wettbewerbsfähigkeit 22,5 Mio. Euro für das Projekt „A Programme for Excellence. Developing Strengths and Building Potentials by Interdisciplinary and International Networking“. Dies soll u.a. mit der konsequenten Vernetzung über Landes- und Staatsgrenzen hinweg, der Förderung von Studierenden und Wissenschaftler*innen in frühen Karrierephasen und der Stärkung der interdisziplinären Forschungsschwerpunkte in gesellschaftlich relevanten und innovativen Bereichen erfolgen.

Teil davon ist eine strategische Entwicklung im Bereich Digital Social Sciences and Humanities (DSSH), um die Universität als international sichtbaren Standort für digitale Innovation in den Geistes- und Sozialwissenschaften dauerhaft zu etablieren (mehr dazu). In diesen Rahmen gehören die beiden hier ausgeschriebenen Stellen, die zunächst bis zum 30.09.2030 befristet sind, sowie diese aktuell ausgeschriebene Stelle.

Ihre Aufgaben

Diese Doppelausschreibung richtet sich an Wissenschaftler*innen, die die folgenden Eigenschaften mitbringen:

  • eigenständige Forschung im Bereich DSSH;
  • Freude an der Entwicklung von institutsübergreifenden Strukturen;
  • Interesse an interdisziplinärer Arbeit; 
  • Erfahrung im Bereich der Drittmitteleinwerbung.

Dies ist eine seltene Gelegenheit, die Grundlagen für ein neues akademisches Profil mit zu gestalten – ein Profil, das Geisteswissenschaften, Sozialwissenschaften, Bildungs- und Datenwissenschaft gerade in Zeiten von disruptiven KI-Entwicklungen miteinander verbindet und einen nachhaltigen Einfluss auf Forschung, Lehre und die Wissensgesellschaft im Allgemeinen hat.

Ihre Aufgabe: Mitgestaltung bei der Entwicklung eines international sichtbaren DSSH-Profils und der dafür notwendigen Strukturen.

Gemeinsame Vision – Kernstück der Initiative:

  • Aufbau eines nachhaltigen und international anerkannten DSSH-Forschungsschwerpunkts und der dazugehörigen Forschungsinfrastruktur; 
  • Mitwirkung an der Einrichtung eines DSSH-Labs als lebendiges, dynamisches Forschungs- und Lehrzentrum für die Entwicklung und Erprobung von computerbasierten Methoden in den jeweiligen wissenschaftlichen Disziplinen und über disziplinäre Grenzen hinweg;
  • Mitwirkung an der Entwicklung eines gemeinsamen, zukunftsorientierten Lehrplans, der für Studierende der Fakultät I (Bildungs- und Sozialwissenschaften), der Fakultät III (Sprach- und Kulturwissenschaften), der Fakultät IV (Human- und Gesellschaftswissenschaften) und des Departments Informatik attraktiv ist und auch auf das Berufsleben außerhalb der Forschung vorbereitet insbesondere in öffentlichen Einrichtungen, im Bereich des kulturellen Erbes, in der digitalen Industrie und im Bildungswesen;
  • Mitwirkung an der Integration digitaler Forschungskompetenzen in die Lehrkräftebildung der Zukunft.

Stelle 1: Die Stelle ist federführend im Bereich Methoden der Digital Humanities. Diese Stelle ist angesiedelt in der Fakultät III: Sprach- und Kulturwissenschaften mit einem Schwerpunkt auf sprach- und literaturwissenschaftlichen Forschungs- und Entwicklungsaufgaben, mit einer Brückenfunktion zu anderen kulturellen Phänomenen im Dialog mit den einschlägigen Professuren der drei Fakultäten. Sie sind für den Bereich der methodischen Entwicklung im Rahmen der DSSH-Initiative mitverantwortlich und werden am Aufbau digitaler Infrastruktur gemeinsam mit den einschlägigen Professuren der drei Fakultäten beteiligt. Ihre Aufgaben umfassen:

  • Entwicklung eines eigenen innovativen Forschungsprojekts im Bereich der DSSH-Methoden, das sich entweder im Bereich linguistischer oder kultur- und literaturwissenschaftlicher Forschung verorten lässt (Habilitationsprojekt oder vergleichbare Leistung);
  • Unterstützung im Bereich computergestützter Text- oder Sprachanalyse unter Verwendung von künstlicher Intelligenz (KI), maschinellem Lernen (ML), natürlicher Sprachverarbeitung (NLP), großer Sprachmodelle (LLMs) und Big Data zur Erforschung von Sprache, Literatur und kulturellen Phänomenen;
  • Unterstützung im Bereich Textkodierung, digitale Editionen, Transkription und interaktive Webplattformen;
  • Mitarbeit bei der Entwicklung eines DSSH-Labors als zentrale Forschungs- und Ausbildungseinrichtung;
  • Organisation und Durchführung verschiedener Workshops und Lehre im Bereich Methoden der DSSH;
  • Mitentwicklung eines DSSH-Nebenfach- oder Zertifikatsprogramms, das für Studierende der Geistes-, Bildungs-, Sozial-, Kulturwissenschaften und Informatik sowie des Lehramts attraktiv ist;
  • Mitarbeit bei der Entwicklung eines gemeinsamen DSSH-Verbundforschungsantrags gemeinsam mit den einschlägigen Professuren der Fakultäten und anderen Institutionen – ausgerichtet auf große Förderinstitutionen (DFG, Horizon Europe, VolkswagenStiftung usw.).

Stelle 2: Die Stelle ist federführend im Bereich Datenwissenschaft in den Digital Humanities Diese Stelle ist angesiedelt in der Fakultät IV: Human- und Gesellschaftswissenschaften mit einem Schwerpunkt auf digitaler kultureller Verflechtungsgeschichte, der Kulturdatenexploration und der darauf bezogenen reflexiven digitalen Transformation mit einer Brückenfunktion zu anderen Phänomenen im Dialog mit den einschlägigen Professuren der drei Fakultäten. Sie sind für den Bereich der datenwissenschaftlichen Entwicklung im Rahmen der DSSH-Initiative mitverantwortlich und werden am Austausch zu dieser interdisziplinären Schnittstelle gemeinsam mit den einschlägigen Professuren der drei Fakultäten beteiligt. In der Fakultät werden Sie am Ausbau des Fakultätsschwerpunktes „Entangled Cultures Digital and Reflective Data Exploration“ mitwirken.

Sie unterstützen die Koordination der datenwissenschaftlichen Ausarbeitung des DSSH-Profils gemeinsam mit den einschlägigen Professuren der Fakultäten. Ihre Aufgaben umfassen:

  • die Entwicklung eines eigenen Forschungsprojekts im Bereich der Datenwissenschaft in den Digital Humanities, vorzugsweise mit einer ontologisch-epistemologischen Perspektive auf die Rolle von Daten, Algorithmen und digitalen Werkzeugen, etwa in Bezug auf die Kategorien und ihre logischen Verknüpfungen, die in Datenbanken für Kulturgüter eingesetzt werden;
  • Mitarbeit an der Entwicklung inter- und transdisziplinärer Forschungsfragen an der Schnittstelle von Geisteswissenschaften, Sozialwissenschaften, Pädagogik und Datenwissenschaft – insbesondere im Bereich der digitalen kulturellen Verflechtungsgeschichte, der Kulturdatenexploration und der darauf bezogenen reflexiven digitalen Transformation;
  • Mitarbeit bei der Entwicklung eines DSSH-Labors als zentrale Forschungs- und Ausbildungseinrichtung;
  • Mitentwicklung und Durchführung von Lehrveranstaltungen im Themenbereich „Reflexive digitale Transformation”;
  • Mithilfe in der Entwicklung von DSSH-Modulen, z.B. eines Moduls für die Integration digitaler Forschungskompetenzen in die zukünftige Lehrkräftebildung;
  • Mitarbeit bei der Entwicklung eines gemeinsamen DSSH-Verbundforschungsantrags gemeinsam mit den einschlägigen Professuren der Fakultäten und anderen Institutionen – ausgerichtet auf große Förderinstitutionen (DFG, Horizon Europe, VolkswagenStiftung usw.).

Ihr Profil

Erforderlich ist / Einstellungsvoraussetzungen

  • Wissenschaftlicher Hochschulabschluss (Diplom, Master) in Linguistik, Literaturwissenschaften oder Digital Humanities oder einem verwandten Fachgebiet; (Stelle 1); Philosophie oder einem vergleichbaren Fachgebiet (Stelle 2);
  • eine abgeschlossene Promotion in einem der für die jeweilige Stelle oben genannten oder einem vergleichbaren Fachgebiet;
  • Publikationen in den Bereichen Digital Social Science, Digital Humanities, Kulturerbe oder verwandten Fachgebieten;
  • gute Deutsch- und Englischkenntnisse in Wort und Schrift, mindestens eine dieser Sprachen auf Niveau C1;
  • ein Exposé für ein Forschungskonzept (zur Habilitation oder zum Erreichen von Habilitationsäquivalenz) im Bereich DSSH im Sinne dieser Ausschreibung (maximal vier Seiten/6.000 Zeichen).

Erwünscht sind / Von Vorteil sind

  • Erfahrung in der interdisziplinären Zusammenarbeit 
  • Erfahrung in der Einwerbung von Drittmitteln 
  • Erfahrung in der Konzeption innovativer, interdisziplinärer Lehrpläne, die sowohl akademisch anspruchsvoll als auch berufsrelevant sind
  • Lehrerfahrung im Bereich DH

Wir bieten

Die Universität Oldenburg stellt nicht nur zwei Postdocs ein – wir entwickeln strategisch ein innovatives Profil in den Geistes- und Sozialwissenschaften. Das ist Ihre Chance:

  • Gestalten Sie die Zukunft der Geistes- und Sozialwissenschaften im digitalen Zeitalter.
  • Schaffen Sie einen Studiengang, der international wettbewerbsfähig ist – einen, der Studierende auf Forschung, Innovation und Führungsaufgaben vorbereitet.
  • Richten Sie ein DSSH-Lab ein, das zum Vorbild wird.

Unser Anspruch

Die Carl von Ossietzky Universität Oldenburg strebt an, den Frauenanteil im Wissenschaftsbereich zu erhöhen. Deshalb werden Frauen nachdrücklich aufgefordert, sich zu bewerben. Gemäß § 21 Abs. 3 NHG sollen Bewerberinnen bei gleichwertiger Qualifikation bevorzugt berücksichtigt werden. Schwerbehinderte Menschen werden bei gleicher Eignung bevorzugt eingestellt.

Weitere Informationen

Die eigene wissenschaftliche Weiterqualifikation (Habilitation oder habilitationsäquivalente Leistungen) wird erwartet.

Die Stelle bietet ggf. eine Verlängerungsoption um ein weiteres Jahr.

Kontakt


Fragen zur Stelle beantworten Ihnen gerne Dekan Prof. Dr. Tobias Vogt (Stelle 1) und Dekan Prof. Dr. Benedikt Hensel (Stelle 2). 


Jetzt bewerben

Bitte senden Sie bis zum 27.08.2026 Ihre Bewerbung per E-Mail an

 postdoc-dssh-bewerbung@uni-oldenburg.de

Neben den üblichen Unterlagen (CV, Zeugnisse/Nachweise, Publikationsliste, Liste eingeworbener Drittmittel) sind Sie eingeladen, folgende Dokumente beizufügen:

  • Ein Exposé für eine Habilitation (oder ein Forschungskonzept zum Erreichen von Habilitationsäquivalenz) im Bereich DSSH im Sinne dieser Ausschreibung (maximal vier Seiten/6.000 Zeichen) sowie
  • ein Positionspapier (maximal 2 Seiten/3.000 Zeichen), in dem Sie Ihre Qualifikation mit den Aufgaben einer der beiden Stellen verbinden und 
  • ein Lehrkonzept (maximal 2 Seiten/3.000 Zeichen): z.B. für ein profilgebendes Modul in Ihrem Bereich.

Bewerbungen richten Sie bitte in einem einzigen PDF-Dokument mit dem Stichwort „PostDoc DSSH – Stelle 1 bzw. Stelle 2“ an den Dekan bzw. die Dekane. 

Reisekosten, die im Rahmen der Vorstellungsgespräche entstehen, können leider nicht erstattet werden.

Stellenangebot: wiss. Mitarbeiter:in (m/w/d) an der Herzog August Bibliothek

2026年8月19日 18:24

An der Herzog August Bibliothek ist in der Abteilung Historische Sammlungen und Bestandserhaltung im Rahmen des Projekts „Netzwerke der Nonnen. Edition und Erschließung der Briefsammlung aus Kloster Lüne (ca. 1460–1555)“ zum nächstmöglichen Zeitpunkt eine befristete Stelle einer / eines
Wissenschaftlichen Mitarbeiterin / Mitarbeiters (m/w/d)
(Entgeltgruppe 13 TV-L)
zu besetzen. Die Stelle ist bis zum 28.02.2028 befristet.

Die Herzog August Bibliothek Wolfenbüttel ist eine zentrale Institution zur Erforschung der Kulturgeschichte des Mittelalters und der Frühen Neuzeit. Sie besitzt bedeutende Sammlungen an Handschriften und alten Drucken sowie einen umfassenden Bestand moderner Forschungsliteratur. In zahlreichen Digitalisierungs-, Erschließungs- und Forschungsprojekten werden die Bestände zugänglich gemacht und wissenschaftlich genutzt.

Das Projekt zielt darauf, die in Umfang und Zuschnitt einzigartigen Briefbücher der Benediktinerinnen des Klosters Lüne zu erschließen und in digitaler und in gedruckter Form zugänglich zu machen. An der Herzog August Bibliothek wird die Open-Access-Form der Edition gehostet und archiviert.

Projektseite: http://diglib.hab.de?link=075

Die Stelleninhaberin /der Stelleninhaber soll vor allem folgende Aufgaben wahrnehmen:

  • Erstellen der diplomatischen Wiedergabe und des Lesetexts der Briefbücher Hs 30 und 31 im mit Briefen in lateinischer und niederdeutscher Sprache auf der Grundlage der digitalen Infrastruktur für die Einspeisung der Daten (ediarum, git)
  • Wissenschaftliche Kommentierung und Kontextualisierung der Briefe
  • Erstellung von Briefregesten in deutscher und englischer Sprache
  • Registererstellung, Erfassung von Normdaten für Personen, Orte und bibliographische Angaben

Ihr Profil:

  • Abgeschlossenes Studium (Master oder vergleichbar) oder Promotion im Bereich der mediävistischen Geisteswissenschaften (Geschichte, Germanistik, Mittellatein) und möglichst Erfahrungen im Bereich der Digital Humanities
  • Sehr gute Kenntnisse in editionsphilologischen Themen
  • Selbständiges Arbeiten und Fähigkeit zur Koordination und Zusammenarbeit in einem interdisziplinären Team
  • Teamfähigkeit, Belastbarkeit, gute Kommunikationsfähigkeit und Flexibilität
  • Zuverlässigkeit und Verantwortungsbewusstsein im Hinblick auf die Durchführung von Lektoratstätigkeiten und Testen der digitalen Präsentation

Erwünscht sind:

  • Kenntnisse in XML/TEI-P5 und Erfahrung in der Kodierung von Texten
  • Erfahrungen im Bereich Texterkennung (HTR)
  • Erfahrung in der Edition und Kommentierung mittelalterlicher oder frühneuzeitlicher Texte

Wir bieten Ihnen:

  • einen modernen, familienfreundlichen Arbeitsplatz in einer international bekannten Bibliothek, Forschungs- und Studienstätte mit einem attraktiven und abwechslungsreichen Aufgabenspektrum
  • ein kollegiales Arbeitsklima in einem engagierten und aufgeschlossenen Team
  • Möglichkeit zur Gestaltung eines digitalen Editionsprojektes einer einzigartigen Quelle in einem interdisziplinären Umfeld
  • eine umfassende und intensive Einarbeitung in den Tätigkeitsbereich
  • flexible Arbeitszeiten sowie mobiles Arbeiten (nach Vereinbarung bis zu 40%) oder Telearbeit sind möglich
  • Möglichkeiten zur Teilnahme an Fort- und Weiterbildungen sowie der individuellen Weiterentwicklung
  • eine Jahressonderzahlung im Rahmen des TV-L und Altersvorsorge für den öffentlichen Dienst (VBL)

Die Herzog August Bibliothek strebt an, Unterrepräsentanzen i. S. des NGG in allen Bereichen und Positionen abzubauen. Schwerbehinderte Bewerberinnen und Bewerber werden bei gleicher Eignung und Befähigung bevorzugt behandelt. Ein Nachweis ist beizufügen.

Interessentinnen und Interessenten können sich bei Herrn Dr. Christian Heitzmann per E-Mail unter heitzmann@hab.de über das Arbeitsgebiet informieren.

Aussagekräftige Bewerbungen sind bis zum 15.09.2026 unter Angabe des Kennwortes: „Netzwerke der Nonnen“ elektronisch zu richten an:

Herzog August Bibliothek
Verwaltung
Lessingplatz 1
38304 Wolfenbüttel
E-Mail: verwaltung@hab.de

Hinweis zum Datenschutz: Mit der Einreichung Ihrer Bewerbung stimmen Sie der Verarbeitung Ihrer personenbezogenen Daten im Rahmen und zur Durchführung des Bewerbungsverfahrens zu. Diese  Einwilligung kann jederzeit ohne Angabe von Gründen gegenüber o. g. Stelle(n) schriftlich oder elektronisch widerrufen werden. Bitte beachten Sie, dass ein Widerruf der Einwilligung u. U. dazu führt, dass die Bewerbung im laufenden Verfahren nicht mehr berücksichtigt werden kann.

Karte, Wissensnetz, JSON: Wie der Datenatlas Sankt Aldegund funktioniert

作者Ben Thoma
2026年8月15日 04:02

Im ersten Teil dieser kleinen Serie begann alles mit einer Einwohnerzahl. Aus 549 wurden irgendwann 530, 526 und 580 – und aus der Frage nach der richtigen Zahl entwickelte sich Schritt für Schritt ein Datenmodell für meinen Heimatort Sankt Aldegund.

Damit entstand eine Grundlage, auf der sich sehr unterschiedliche Informationen miteinander verbinden lassen: Gebäude und Bauphasen, historische Ereignisse, Quellen, Koordinaten, Bevölkerungszahlen und Kulturorte.

Der nächste Schritt führte zurück zu dem, womit das Projekt ursprünglich einmal angefangen hatte: zur Gestaltung.

Wie wird aus all diesen Daten eine Oberfläche, auf der sich Zusammenhänge tatsächlich erkennen lassen? Wie lässt sich ein langgezogenes Moseldorf auf einer Karte erfassen? Wann hilft eine Linie, wann eine Zahl, wann ein Diagramm? Und an welchen Stellen lohnt sich auch einmal der Blick direkt in die Datenstruktur?

Genau dort treffen im Datenatlas Sankt Aldegund Datenmodellierung, Webentwicklung und Gestaltung aufeinander.

Ein Dorf zwischen Mosel und Steillage

Sankt Aldegund besitzt eine Form, die man auf der Karte sofort erkennt.

Der historische Ort zieht sich schmal zwischen Mosel und Hang entlang. Straßen, Häuser und Denkmäler folgen dieser Topografie. Für die Denkmalkarte wollte ich genau diese räumliche Struktur sichtbar machen und den verfügbaren Raum gut nutzen.

Die Koordinaten der Denkmäler liefern dafür die Grundlage.

Aus ihnen berechnet der Atlas zunächst die räumlichen Abstände. Anschließend wird die gesamte Punktgeometrie gemeinsam gedreht, sodass die Längsrichtung des Ortes in der Darstellung besser zur Geltung kommt.

Die relativen Positionen und Abstände bleiben dabei erhalten. Die Kirche bleibt neben ihren Nachbarn, die Form des Ortes bleibt dieselbe. Lediglich die Orientierung der gesamten Darstellung verändert sich.

Auch der Nordpfeil folgt dieser Drehung und zeigt weiterhin die geografische Orientierung.

So entstehen aus derselben Punktwolke zwei Ansichten: geografisch nordorientiert und für die Atlasansicht gemeinsam gedreht.

Dieselben Punkte, dieselben Abstände – eine andere Ausrichtung.

Koordinaten Sankt Aldegund

Abb. 1: Dieselben georeferenzierten Denkmalpunkte in zwei Ansichten. Für die Atlasdarstellung wird die gesamte Punktgeometrie gemeinsam gedreht; relative Positionen und Abstände bleiben erhalten.

Wenn fünf Denkmäler sehr eng zusammenrücken

Im historischen Ortskern liegen manche Denkmäler dicht beieinander.

Auf der Karte können dadurch mehrere Marker auf wenigen Pixeln zusammentreffen. Der Atlas fasst sie in solchen Situationen vorübergehend zu einer Gruppe zusammen.

Steht beispielsweise eine 5 in einem Marker, liegen dort fünf einzelne Objekte dicht beieinander.

Mit zunehmender Vergrößerung lösen sie sich wieder in ihre einzelnen Punkte auf.

Im Datenbestand bleiben währenddessen fünf eigenständige Objekte mit fünf eigenen Kennungen und fünf eigenen Koordinaten erhalten. Die Karte wählt abhängig von Maßstab und verfügbarem Raum eine passende Darstellung dafür.

Dieses kleine Detail zeigt sehr anschaulich, wie Datenstruktur und Benutzeroberfläche zusammenspielen.

45 / 45 und 10 / 45 erzählen unterschiedliche Geschichten

Bei den Denkmal-Daten stieß ich auf eine andere gestalterische Frage.

Einige Eigenschaften sind nahezu vollständig dokumentiert, andere bei einem kleineren Teil der Objekte.

Der Datenbestand sieht beispielsweise so aus:

45 / 45 – Bauform
44 / 45 – Material
43 / 45 – Koordinaten
10 / 45 – ausdrücklich genannte Stilzuordnung

Diese vier Zahlen sehen ähnlich aus. Für eine Auswertung beschreiben sie jedoch sehr unterschiedliche Datengrundlagen.

Bei der Bauform steht der vollständige Denkmalbestand zur Verfügung. Eine Auswertung der Stilzuordnungen basiert dagegen auf zehn entsprechend beschriebenen Objekten.

Bei analytischen Kennzahlen führt der Atlas deshalb Ergebnis, Grundgesamtheit sowie vorhandene und fehlende Werte gemeinsam.

So bleibt bei jedem Prozentwert unmittelbar erkennbar, auf welcher Datengrundlage er beruht.

Datenabdeckung Einzeldenkmäler

Abb. 2: Datenabdeckung im Denkmalbestand. Bauform, Material, Koordinaten und Stilzuordnung sind unterschiedlich dicht erfasst – eine wichtige Bezugsgröße für spätere Auswertungen.

Auch „nicht datiert“ erzählt etwas über den Ort

Für zwei bestehende Einzeldenkmäler ist derzeit keine belastbare veröffentlichte Datierung bekannt.

Im Atlas stehen sie entsprechend als:

nicht datiert

Auch das gehört zur Beschreibung des Datenbestands.

Eine Jahrhundertsauswertung zeigt damit neben den bekannten Zeitangaben zugleich, wie vollständig die zeitliche Einordnung der Gebäude derzeit möglich ist.

Ähnlich verhält es sich bei historischen Bevölkerungszahlen. Zwischen manchen überlieferten Werten liegen Jahre oder Jahrzehnte. Die Abstände zwischen den Datenpunkten gehören ebenso zur Geschichte der Daten wie die Zahlen selbst.

Solche Lücken zeigen, an welchen Stellen die Quellenlage dicht ist und wo weitere Recherche noch neue Erkenntnisse bringen kann.

Eine Kirche, zwölf Ereignisse und viele Wege durch die Geschichte

Schon im ersten Teil spielte die Alte katholische Pfarrkirche St. Bartholomäus eine wichtige Rolle.

Im Datenmodell trägt sie die Kennung:

SA-KD-004

Mit diesem einen Datensatz sind zahlreiche historische Ereignisse verbunden.

Eines davon ist:

EV-007

die erste belegte Kirche an diesem Ort im Jahr 1144.

Das Ereignis wiederum verweist auf die Quellen, aus denen sich diese Aussage ableitet.

Damit entsteht zunächst eine einfache Kette:

Kirche → Ereignis → Quelle

Bei derselben Kirche wiederholt sich dieses Prinzip über viele Jahrhunderte.

1522 kommt der „Christus in der Rast“ hinzu.
1601 die Stiftung des Rultz-Altars.
1762/63 der Umbau der Kirche.
nach Oktober 1872 die Profanierung.
1967–1971 die Restaurierung.
3. Oktober 1971 die erneute Weihe.

Aus einer Kirche wächst so ein historischer Knotenpunkt.

Genau diese Struktur bildet das Wissensnetz grafisch ab. Eine Linie steht dort für eine Beziehung, die im Datenbestand hinterlegt ist. Aus Kennungen und Verweisen entsteht auf dem Bildschirm ein Netz aus Bauwerken, Ereignissen, Kulturorten und Quellen.

Beziehungsmodell Alte Kirche St. Aldegund

Abb. 3: Ein Ausschnitt aus dem Beziehungsmodell der Alten Kirche. Von SA-KD-004 führen gespeicherte Verknüpfungen zu historischen Ereignissen und von dort zu den jeweils hinterlegten Quellen.

Dieselben Daten, andere Fragen

Besonders deutlich wird die Rolle der Gestaltung bei den Bevölkerungsdaten.

Eine Zeitreihe zeigt, wie sich die Einwohnerzahl über Jahrzehnte entwickelt hat.

Eine Altersstruktur zeigt, wie sich die Bevölkerung zu einem bestimmten Zeitpunkt zusammensetzt.

Und die im ersten Beitrag beschriebenen Zahlen 530, 526 und 580 erzählen wiederum etwas über unterschiedliche Stichtage, Quellen und Erhebungszusammenhänge.

Jede dieser Darstellungen greift auf Daten über denselben Ort zurück und stellt eine andere Frage an sie.

Das gilt ebenso für die Gebäudestatistik. 224 Gebäude mit Wohnungen lassen sich als Gesamtzahl nennen. Eine Gruppierung nach einer, zwei oder mehreren Wohnungen zeigt zusätzlich die innere Struktur dieses Bestands.

Auswahl, Reihenfolge, Gruppierung, Abstände und Beschriftungen formen so unterschiedliche Ansichten auf denselben Datenbestand.

Ein Blick unter die Oberfläche

An dieser Stelle darf es ein wenig technischer werden.

Hinter Karten, Zeitreihen und Verbindungen stehen strukturierte Datensätze. Die Alte Kirche sieht in stark gekürzter Form beispielsweise so aus:

{
  "id": "SA-KD-004",
  "name": "Alte katholische Pfarrkirche St. Bartholomäus",
  "datierung_text": "spätes 12./frühes 13. Jahrhundert; Umbauten bis 1762/63",
  "analyseanker": 1200,
  "sources": ["S02", "S03", "S06", "S11", "S14", "S20"]
}

Das Ereignis von 1144 greift dieselbe Kennung wieder auf:

{
  "id": "EV-007",
  "jahr_von": 1144,
  "titel": "Alte Kirche erstmals erwähnt",
  "verknuepfte_objekte": ["SA-KD-004"],
  "sources": ["S06", "S11", "S14"]
}

Hier wird die Beziehung sichtbar, bevor überhaupt eine Linie gezeichnet wird.

SA-KD-004 bezeichnet die Kirche.

Im Ereignis EV-007 taucht dieselbe Kennung unter verknuepfte_objekte auf. Daneben stehen die IDs der zugehörigen Quellen.

Aus genau solchen Verweisen erzeugt der Atlas später Detailseiten, Zeitleisten und Beziehungen im Wissensnetz.

Für technisch Interessierte ist das der direkteste Blick darauf, wie der Atlas unter seiner Oberfläche funktioniert.

JSON Datenstruktur

Abb. 4: Blick in die Datenstruktur des Atlas. Die Kennung SA-KD-004 verbindet den Denkmal-Datensatz der Alten Kirche mit dem Ereignis EV-007 und den jeweils zugeordneten Quellen.

Gestaltung übersetzt Struktur

Viele Entscheidungen im Atlas beginnen im Datenmodell und enden in einer sichtbaren Form.

  • Koordinaten werden zu Punkten.
  • Zeitangaben werden zu Positionen auf einer Zeitachse.
  • Beziehungen werden zu Linien.
  • Grundgesamtheiten werden zu Diagrammen.
  • Kennungen verbinden Datensätze miteinander und führen den Besucher von einem Objekt zum nächsten.

Die Gestaltung bringt diese unterschiedlichen Ebenen in eine Form, die sich lesen, vergleichen und erkunden lässt.

So erscheint derselbe historische Ort gleichzeitig als Straßen- und Gebäudestruktur, als Folge von Ereignissen, als Quellenbestand, als JSON-Datensatz und als grafisches Beziehungsnetz.

All diese Ansichten beschreiben Sankt Aldegund aus einer anderen Richtung.

Wieder zurück nach Sankt Aldegund

Der erste Beitrag begann mit einer einfachen Ortsgrafik und einer Einwohnerzahl.

Heute lässt sich Sankt Aldegund im Atlas auf ganz unterschiedliche Weise betrachten: als Karte, als Zeitreihe, als Netz historischer Beziehungen, als Sammlung einzelner Denkmäler oder als strukturierter Datenbestand.

  • Unter einer Zahl steht ihre Datengrundlage.
  • Hinter einem Kartenpunkt stehen Koordinaten und ein Datensatz.
  • Eine Linie im Wissensnetz führt auf eine gespeicherte Beziehung zurück.
  • Jede Visualisierung eröffnet einen bestimmten Blick auf denselben strukturierten Bestand.

Damit schließt sich der Kreis zur ursprünglichen Grafik.

Damals wollte ich Sankt Aldegund auf einen Blick zeigen.

Heute kann man sich durch den Ort hindurchklicken.

Über den Autor: Ben Thoma ist Grafiker und Webprogrammierer und entwickelt seit rund 20 Jahren Websites. Sankt Aldegund ist sein Heimatort. Den Datenatlas entwickelt er als eigenes Projekt an der Schnittstelle von Gestaltung, Webentwicklung, Ortsgeschichte und strukturierten Daten.

Weiter in den Daten

530, 526 oder 580? Wie St. Aldegund zum Datenatlas wurde

作者Ben Thoma
2026年8月13日 04:14

Am Anfang stand eine Grafik über Sankt Aldegund, meinen kleinen Heimatort an der Mosel.

Ich wollte den Ort auf einen Blick zeigen: das Panorama an der Mosel, markante Gebäude, Fläche, Postleitzahl, Höhenlage, geografische Koordinaten – und natürlich die Einwohnerzahl. Für diese Grafik trug ich 549 Einwohner ein. Die Zahl hatte mir damals auf Nachfrage das Einwohnermeldeamt genannt.

Seit rund 20 Jahren entwickle ich Websites und arbeite dabei immer wieder mit strukturierten Daten. Bei Sankt Aldegund bekam diese Arbeit eine ungewöhnlich lokale Dimension. Nachdem die Grafik fertig war, wollte ich genauer wissen, wie belastbar einzelne Angaben über meinen Heimatort eigentlich sind, woher sie stammen und wie sie sich miteinander in Beziehung setzen lassen.

Ausgerechnet die vermeintlich einfache Einwohnerzahl erwies sich dabei als ausgesprochen ergiebig.

Abb. 1: Mit dieser Grafik begann die Geschichte des späteren Datenatlas Sankt Aldegund. Für die Einwohnerzahl trug ich damals 549 ein – eine Angabe, die mir auf Nachfrage beim Einwohnermeldeamt genannt worden war.

2022 hat drei Einwohnerzahlen

Wer nach der Einwohnerzahl Sankt Aldegunds für 2022 sucht, kann auf mindestens drei Angaben stoßen:

530 Einwohner zählt der Zensus zum Stichtag 15. Mai 2022.

526 Einwohner weist die Bevölkerungsfortschreibung des Statistischen Landesamtes Rheinland-Pfalz zum 31. Dezember 2022 aus.

Eine landeskundliche Beschreibung bei KuLaDig nennt 580 Einwohner mit dem Zeitbezug „Stand 2022“.

530, 526 oder 580?

Der Unterschied steckt im Kontext. Der Zensus beschreibt die Bevölkerung an einem konkreten Stichtag und folgt seiner eigenen Erhebungsmethodik. Die Bevölkerungsfortschreibung nennt den amtlichen Stand zum Jahresende. Die landeskundliche Angabe bei KuLaDig – einem Informationssystem zur historischen Kulturlandschaft – stammt wiederum aus einem anderen Veröffentlichungszusammenhang.

Damit wurde für mich eine Frage immer wichtiger:

Was genau beschreibt eine Zahl – und worauf gründet sie sich?

Diese Frage wurde zum Ausgangspunkt für die Arbeitsweise des Atlas. Die drei Werte stehen dort heute bewusst nebeneinander; Stichtag, Quelle und Bezugsrahmen gehören zur jeweiligen Aussage.

Abb. 2: Gebäudestruktur im Datenatlas Sankt Aldegund. Die Visualisierung zeigt 224 Gebäude mit Wohnungen und verteilt sie nach der Zahl der enthaltenen Wohneinheiten.

Eine Zahl bringt die nächsten Fragen mit

Mit der Einwohnerzahl öffnete sich die Recherche in viele Richtungen.

Beim Christophorushaus in der Christophorusstraße 10 erzählt ein einzelnes Baujahr beispielsweise nur einen Ausschnitt seiner Geschichte:

1473 – historischer Kern
1710 – Erweiterung durch einen Nebenbau
1765 – Datierung des Wappens

Die Alte katholische Pfarrkirche St. Bartholomäus spannt einen noch größeren Zeitraum auf. Ihre Baugeschichte reicht vom späten 12. beziehungsweise frühen 13. Jahrhundert über mehrere Bauphasen bis zu Umbauten in den Jahren 1762/63.

Solche Fälle führten zu einer feineren Struktur für historische Zeitangaben. Ich erfasste die ursprüngliche Datierungsformulierung, Zeiträume und Jahrhundertzuordnungen getrennt und ergänzte dort, wo Auswertungen einen eindeutigen zeitlichen Bezugspunkt brauchten, einen Analysewert.

Aus der Datierung „spätes 12./frühes 13. Jahrhundert; Umbauten bis 1762/63“ lässt sich die Alte Kirche beispielsweise mehreren Jahrhunderten zuordnen. Für bestimmte zeitliche Analysen erhält sie zusätzlich den Analyseanker 1200.

Parallel verknüpfte ich historische Ereignisse mit den betreffenden Bauwerken, ordnete Quellen den jeweiligen Aussagen zu, ergänzte Koordinaten für räumliche Darstellungen und kennzeichnete selbst berechnete Werte als eigene analytische Ebene.

Aus immer mehr einzelnen Informationen entstand so Schritt für Schritt eine gemeinsame Struktur.

Also habe ich mir ein System gebaut

Auch das Datenmodell entwickelte sich aus den Anforderungen, die während der Arbeit am Atlas entstanden. Sobald dieselbe Kirche in Karte, Zeitleiste, historischen Ereignissen und mehreren Quellen auftauchte, brauchte ich eine eindeutige Zuordnung.

Ich entwickelte ein eigenes Kennungssystem.

Die Alte katholische Pfarrkirche St. Bartholomäus bekam beispielsweise die Kennung:

SA-KD-004

SA steht für Sankt Aldegund.
KD bezeichnet die Kulturdenkmäler.
004 identifiziert diesen Datensatz innerhalb der Gruppe.

Für andere Bereiche entstanden weitere Kürzel:

EV-007 bezeichnet ein historisches Ereignis.
S14 bezeichnet eine Quelle.
SA-KO-008 bezeichnet einen Kulturort.

Diese Kürzel sind eine eigene Konvention des Atlas. Ihre eigentliche Stärke zeigt sich dort, wo sie wieder aufeinandertreffen.

EV-007 beschreibt beispielsweise die erste belegte Kirche an diesem Ort im Jahr 1144. Dieser Ereignisdatensatz verweist auf SA-KD-004, also auf die Alte Kirche.

Zum Ereignis gehören wiederum die Quellen, auf denen die Aussage beruht.

SA-KD-004 → EV-007 → S14
Bauwerk → Ereignis → Quelle

Aus zunächst technischen Kennungen wurden damit feste Verbindungspunkte des Datenmodells.

Abb. 3: Bevölkerung im Verlauf und im Querschnitt: Jahresstände, Zensus 2022 und Altersstruktur werden im Atlas als getrennte, aber aufeinander bezogene Ansichten dargestellt.

1097 – und plötzlich wird eine Jahreszahl kompliziert

Je tiefer die Recherche in die Geschichte Sankt Aldegunds führte, desto interessanter wurden auch Angaben, die auf den ersten Blick vollkommen eindeutig wirkten.

Ein besonders gutes Beispiel ist 1097.

Der 11. Juli dieses Jahres wird traditionell mit einer frühen urkundlichen Erwähnung Sankt Aldegunds verbunden. Die entsprechende Besitzbestätigung Erzbischof Egilberts ist als Nr. 392 im Mittelrheinischen Urkundenbuch überliefert.

Für eine Zeitleiste erscheint das zunächst wunderbar eindeutig:

1097 → Erwähnung → Urkunde

Bei der genaueren Beschäftigung mit der Quelle kommt eine weitere Ebene hinzu.

Der Diplomatiker Theo Kölzer – also ein Wissenschaftler, der historische Urkunden untersucht – ordnet das Dokument als Spurium ein. In der Urkundenforschung bezeichnet man damit ein Schriftstück, dessen überlieferter Entstehungszeitpunkt und tatsächliche Herstellung auseinanderliegen.

Kölzer untersucht dafür unter anderem die Schrift. Diese Methode heißt Paläographie: Historische Handschriften lassen sich anhand von Buchstabenformen, Abkürzungen und charakteristischen Eigenheiten einzelner Schreiber zeitlich und räumlich einordnen.

Im Fall der Urkunde von 1097 erkennt Kölzer dieselbe Schreiberhand, die auch bei einer compositio von 1182 begegnet.

Plötzlich besteht die Information aus mehreren Ebenen:

1097 – das überlieferte Datum
die Urkunde – die historische Überlieferung
die diplomatische Untersuchung – ihre fachliche Einordnung
der Ereignisdatensatz – die strukturierte Zusammenführung im Atlas

Das Jahr 1097 bleibt damit sichtbar. Zugleich bekommt es den Quellenkontext, der für seine historische Einordnung entscheidend ist.

Aus einer Jahreszahl wurde eine kleine Lektion darüber, wie viel Information hinter einem scheinbar einfachen Datum stecken kann.

Vier Jahre, die in keiner Quelle stehen

Manche neuen Daten entstehen direkt aus vorhandenen Angaben.

Eine Quelle zum historischen Brunnenstübchen nennt für den Bau einer Zubringerleitung den Zeitraum 2010 bis 2013.

Für bestimmte Auswertungen interessierte mich zusätzlich, wie viele Kalenderjahre dieser Zeitraum berührt:

2010 · 2011 · 2012 · 2013

Das Ergebnis lautet: vier Kalenderjahre.

Diese Vier entsteht durch meine eigene Auswertung.

Im Datenmodell behandle ich deshalb beide Angaben getrennt. Der Zeitraum 2010–2013 bleibt als Quelleninformation erhalten. Die Zahl Vier bekommt eine Kennzeichnung als analytisch abgeleiteter Wert.

Beim spätrömischen Steinkammergrab lässt sich dasselbe Prinzip über einen wesentlich größeren Zeitraum beobachten.

Die archäologische Einordnung lautet ungefähr:

300–350 n. Chr.

Daraus lässt sich für eine Analyse zusätzlich ableiten:

Zeitspanne: 50 Jahre

Quellenwert und Analysewert können so gemeinsam verwendet werden, während ihre jeweilige Herkunft erkennbar bleibt.

Für mich liegt darin ein wichtiger Teil der Datenarbeit: Auch eine sehr einfache Rechnung erzeugt eine neue Information. Deshalb sollte sich nachvollziehen lassen, wer sie erzeugt hat und aus welcher Grundlage sie entstanden ist.

Wenn 31.000 Reichsmark im Jahr 1899 auftauchen

Manchmal steckt die Quellenkritik in einem einzigen Wort.

Für den Ausbau der Wasserversorgung Sankt Aldegunds im Jahr 1899 nennt eine verwendete Quelle Kosten von 31.000 Reichsmark.

Die Währungsbezeichnung fällt aus der Zeit.

1899 galt im Deutschen Reich die Mark. Die Reichsmark löste die Mark erst 1924 als offizielle Währung ab. Die Währungsgeschichte lässt sich auch bei der Deutschen Bundesbank nachvollziehen.

Im Atlas führe ich den Betrag deshalb als:

31.000 Mark

Gleichzeitig dokumentiert der Datensatz, dass die verwendete Quelle den Begriff „Reichsmark“ nennt.

Für solche Fälle habe ich die Kennzeichnung quellenkritisch korrigiert eingeführt.

Die Quelle bleibt damit nachvollziehbar, die historische Einordnung wird präziser und auch meine redaktionelle Entscheidung ist dokumentiert.

Aus diesem und ähnlichen Fällen entwickelte sich eine einfache Regel:

Jede Veränderung an einer Quellenangabe bekommt einen nachvollziehbaren Grund – und dieser Grund gehört zum Datensatz.

Was an einer einzigen Kirche zusammenkommt

An der Alten Kirche lässt sich inzwischen fast das gesamte Prinzip des Atlas erklären.

Nehmen wir noch einmal:

SA-KD-004

die Alte katholische Pfarrkirche St. Bartholomäus.

Eine ihrer Beziehungen führt zu:

EV-007

der ersten belegten Kirche an diesem Ort im Jahr 1144.

Dieses Ereignis wiederum verweist auf die Quellen, aus denen sich die Aussage herleitet.

Damit haben wir zunächst drei Ebenen:

Kirche → Ereignis → Quelle

Doch bei derselben Kirche wiederholt sich dieses Muster.

1522 kommt mit dem „Christus in der Rast“ eine weitere historische Ebene hinzu.

1601 folgt die Stiftung des Rultz-Altars.

1762/63 wird der Umbau der Kirche erfasst.

nach Oktober 1872 ihre Profanierung.

1967–1971 die umfassende Restaurierung.

3. Oktober 1971 die erneute Weihe.

Jedes dieser Ereignisse besitzt wiederum eigene Quellenbezüge. Weitere Verbindungen führen zu Kulturorten und anderen Datensätzen.

Aus einem einzelnen Bauwerk wächst so ein Netz aus Zeitpunkten, Vorgängen, Orten und Belegen.

Genau daraus entstand später das Wissensnetz des Atlas.

Die entscheidende Frage lautete inzwischen nicht mehr allein:

Was weiß ich über dieses Gebäude?

Sondern auch:

Was hängt mit diesem Gebäude zusammen?

Aus einer Einwohnerzahl wurde ein Ortsmodell

In der Grafik, mit der diese Geschichte begann, steht bis heute:

549 Einwohner

Damals war das genau die Information, die ich für die Gestaltung brauchte.

Heute würde ich dieselbe Zahl zusätzlich mit ihrem Stichtag, ihrer Quelle und ihrem Erhebungszusammenhang erfassen. Ich würde sie neben andere Einwohnerzahlen stellen und sichtbar machen, welche Aussage jede einzelne von ihnen trägt.

Dieser Unterschied beschreibt ziemlich genau die Entwicklung des Projekts.

Aus Angaben wurden Datensätze. Datensätze bekamen eindeutige Kennungen. Gebäude erhielten mehrere Zeitebenen. Ereignisse wurden mit ihren Quellen verbunden. Eigene Berechnungen bekamen eine dokumentierte Herkunft. Quellenkritische Entscheidungen fanden ihren Platz direkt im Datenbestand.

Aus all diesen Schritten entstand ein Modell, mit dem sich Sankt Aldegund über Zeit, Raum, Quellen und Beziehungen erschließen lässt.

Die 549 in meiner ursprünglichen Grafik waren eine Zahl.

Im Datenatlas wäre dieselbe Zahl heute eine Information mit Herkunft, Zeitpunkt und Kontext.

Dazwischen liegt die Geschichte dieses Projekts.

Im zweiten Teil: Wenn Daten sichtbar werden

Mit dem Datenmodell entstand eine neue gestalterische Aufgabe: Wie werden diese Strukturen auf dem Bildschirm verständlich?

Im zweiten Teil geht es deshalb um die Karten des Atlas, um Wissensnetze und Diagramme, um unterschiedlich dicht belegte Datenbereiche – und um einen Blick direkt in die technische Struktur einzelner Datensätze.

Oder anders gesagt:

Was passiert, wenn aus einem Datenmodell eine Benutzeroberfläche wird?

Über den Autor: Ben Thoma ist Grafiker und Webprogrammierer und entwickelt seit rund 20 Jahren Websites. Sankt Aldegund ist sein Heimatort. Den Datenatlas entwickelt er als eigenes Projekt an der Schnittstelle von Gestaltung, Webentwicklung, Ortsgeschichte und strukturierten Daten.

Weiter in den Daten

Stellenausschreibung Stabsstelle Digitales (w/m/d), Linden-Museum Stuttgart

2026年8月11日 17:50

Das Linden-Museum Stuttgart gehört zu den bedeutenden Museen für Ethnologie in Europa. Zur Gestaltung der digitalen Transformation sämtlicher Museumsbereiche suchen wir zum nächstmöglichen Zeitpunkt eine:n Stabsstelle Digitales (w/m/d) in Vollzeit (100 %). Die Stelle ist direkt an den Vorstand angebunden und wird nach Entgeltgruppe 13 TV-L vergütet. Sie ist zunächst auf zwei Jahre befristet mit Option auf Verlängerung. Arbeitsort ist Stuttgart.

In Ihrer Querschnittsposition gestalten Sie gemeinsam mit dem Vorstand und der Leitung Strategie und Publikum die digitale Zukunft des Museums. Sie entwickeln die Digitalstrategie des Museums weiter und begleiten deren Umsetzung über alle Museumsbereiche hinweg. Dabei identifizieren Sie Potenziale digitaler Technologien, steuern bereichsübergreifende Transformationsprozesse und entwickeln Lösungen für die digitale Weiterentwicklung des Museums.

Ein zentraler Schwerpunkt der Stelle liegt in den kommenden Jahren auf der strategischen und verantwortungsvollen Erschließung der Potenziale Künstlicher Intelligenz. Gemeinsam mit den Fachbereichen identifizieren und erproben Sie geeignete Einsatzmöglichkeiten und begleiten deren Einführung – insbesondere für das Besuchserlebnis, interne Arbeitsprozesse sowie die Sammlungsdokumentation.

Ihre Aufgaben darüber hinaus

  • Weiterentwicklung und Umsetzung der Digitalstrategie des Museums
  • Beratung des Vorstands und Mitwirkung an Strategieprozessen des Museums
  • Initiierung und Steuerung bereichsübergreifender Digitalprojekte
  • Entwicklung nutzer:innenzentrierter digitaler Angebote für Besucher:innen und digitale Zielgruppen gemeinsam mit den Fachbereichen
  • Weiterentwicklung und Digitalisierung interner Arbeitsprozesse gemeinsam mit den Fachbereichen zur Steigerung von Effizienz und Zusammenarbeit
  • Entwicklung eines Konzepts zur Förderung der Digitalkompetenz aller Mitarbeiter:innen mit besonderem Fokus auf den Einsatz Künstlicher Intelligenz
  • Identifikation geeigneter Förderprogramme sowie Mitwirkung bei der Entwicklung und Beantragung von Drittmittelprojekten
  • Vertretung des Museums in Fachgremien (u.a. AG Digitalität des Landes) sowie Aufbau und Pflege regionaler und überregionaler Netzwerke

Ihr Profil

  • Abgeschlossenes Hochschulstudium (Bachelor, Master, Diplom, Magister), vorzugsweise in den Bereichen Museologie, Informationswissenschaft, Digital Humanities, Kulturmanagement oder einer vergleichbaren Fachrichtung
  • Erfahrung in der Gestaltung oder Begleitung von Transformationsprozessen, idealerweise im Kultur- und Museumsbereich
  • Erfahrung in der Konzeption, Steuerung oder Umsetzung von Digitalprojekten
  • Verständnis aktueller Entwicklungen in den Bereichen Digitalisierung, Künstliche Intelligenz, Datenmanagement und digitale Arbeitsprozesse
  • Erfahrung in der Entwicklung strategischer Konzepte ist von Vorteil
  • Praktische Erfahrung in der Konzeption, Erprobung oder Einführung von KI-Anwendungen ist wünschenswert, idealerweise im Kultur- und Museumsbereich

Darüber hinaus bringen Sie mit

  • Strategisches und konzeptionelles Denkvermögen
  • Verständnis organisationaler Strukturen und bereichsübergreifender Prozesse
  • Kommunikationsstärke und Freude an interdisziplinärer Zusammenarbeit
  • Analytische, strukturierte und lösungsorientierte Arbeitsweise
  • Ein hohes Maß an Eigeninitiative, Verantwortungsbewusstsein und Durchsetzungsvermögen
  • Sehr gute Deutsch- und Englischkenntnisse

Das bieten wir

  • Eine verantwortungsvolle Tätigkeit in einer renommierten Kultureinrichtung
  • Ein interdisziplinäres Team mit Offenheit für neue Ideen
  • Flexible Arbeitszeiten im Gleitzeitmodell und die Möglichkeit zur mobilen Arbeit
  • 30 Tage Urlaub sowie Zeitausgleich bei Überstunden
  • Jobticket (z.B. Deutschlandticket) mit Arbeitgeberzuschuss
  • Vermögenswirksame Leistungen

Wir schätzen Vielfalt und begrüßen daher alle Bewerbungen – unabhängig von Geschlecht, Nationalität, ethnischer und sozialer Herkunft, Religion/Weltanschauung, Behinderung, Alter sowie sexueller Orientierung und Identität. Schwerbehinderte Bewerber:innen (w/m/d) werden bei gleicher Eignung bevorzugt berücksichtigt.

Bitte senden Sie Ihre Bewerbungsunterlagen vorzugweise in digitaler Form (eine pdf-Datei mit max. 5 MB) an bewerbung@lindenmuseum.de. Die Anschrift für postalische Bewerbungen ist: Vorstand des Linden-Museums, Hegelplatz 1, 70174 Stuttgart. Bitte beachten Sie, dass Bewerbungsunterlagen nur zurückgesandt werden, wenn ein ausreichend frankierter und adressierter Briefumschlag beigelegt ist.

Für inhaltliche Rückfragen steht Ihnen Frau Christiane Lindner (Leitung Strategie und Publikum), Telefon 0711-2022-403 oder lindner@lindenmuseum.de, gerne zur Verfügung. Bei organisatorischen Fragen rund um die Stelle wenden Sie sich bitte an personal@lindenmuseum.de.


Hinweis zum Datenschutz:

Die Informationen zur Erhebung von personenbezogenen Daten bei der betroffenen Person nach Art. 13 Datenschutz-Grundverordnung (DS-GVO) können Sie unter Tel. 0711.2022-421 erfragen.

Computational Literary Studies auf der DH-Konferenz 2026

2026年8月10日 16:48

Die Computational Literary Studies (CLS) haben sich in den letzten Jahren als wichtige Teildisziplin im Umfeld der Digital Humanities (DH) etabliert. Die Relevanz der CLS wird nicht zuletzt auf den DH-Konferenzen sichtbar, die von der Alliance of Digital Humanities Organizations (ADHO) ausgerichtet werden, alljährlich stattfinden und die DH-Community in ihrer ganzen Breite und Vielfalt zusammenbringen. Auch auf der DH-Konferenz 2026, die in Daejeon (Südkorea) unter dem Motto „Engagement“ vom 27. bis 31. Juli stattfand, waren die CLS präsent. Ziel dieses Blogposts ist, einen Überblick über CLS-Beiträge und -Trends auf der DH2026 zu geben (für einen ähnlichen Blogpost zu den DHd-Konferenzen siehe Guhr 2025). Ein Schwerpunkt meines Beitrags liegt auf einer besonders wichtigen DH- und CLS-Tendenz der letzten Jahre: der zunehmenden Auseinandersetzung mit Large Language Models (LLMs).

Quantitatives

Das Book of Abstracts zur DH2026 umfasst 513 Beiträge: Short und Long Paper, Poster, Workshops und Mini-Konferenzen (vgl. https://doi.org/10.5281/zenodo.21495909). Davon verorteten sich 137 (27%) im Feld der ‚Literary Studies‘.1 Somit zählten die Literaturwissenschaften zu den prominentesten Disziplinen auf der DH-Konferenz (zum Vergleich: ‚History‘ = 155 Beiträge; ‚Library & Information Science‘ = 110 Beiträge; ‚Computer Science‘ = 99 Beiträge; ‚Linguistics‘ = 83 Beiträge; ‚Art History‘ = 53 Beiträge).

Die 137 ‚Literary Studies‘-Beiträge auf der DH2026-Konferenz stammen von 386 Autor:innen. Tab. 1 zeigt, mit welchen Ländern die Autor:innen affiliiert sind. Sofort wird die große Zahl von CLS-Forscher:innen aus Deutschland deutlich: Es gab kein anderes Land, mit dessen Forschungsinstitutionen mehr Autor:innen affiliiert waren.2 Am zweitmeisten Forscher:innen kamen, wenig überraschend, aus den USA. Auffällig, und gegebenenfalls durch den Konferenzort bedingt, war daneben die große Zahl von Autor:innen aus asiatischen Ländern (Südkorea, Japan, China, Hong Kong).

LandAnzahl Autor:innenAnteil
Deutschland780.2
USA630.16
Südkorea560.15
Japan330.09
China270.07
Frankreich170.04
Kanada160.04
Hong Kong130.03
Rumänien120.03
United Kingdom100.03
Tab. 1: Affiliationen der 386 Autor:innen von ‚Literary Studies‘-Beiträgen auf der DH2026

Blickt man auf die ‚Keywords‘, die den 137 ‚Literary Studies‘-Beiträgen der DH2026-Konferenz zugeordnet waren (Tab. 2), zeigt sich vor allem die große Relevanz von LLMs. Würde man Keywords wie ‚Artificial Intelligence‘ (5 Beiträge) oder ‚Generative AI‘ (4 Beiträge) ebenfalls den LLMs zurechnen, wäre ihr Anteil sogar noch größer. Die Daten weisen darauf hin, dass sich auch auf der DH2026 der Trend zur Auseinandersetzung mit LLMs niederschlug, der die DH und die CLS in den letzten Jahren insgesamt kennzeichnet. Daneben weisen die Keywords darauf hin, dass weiterhin grundlegende Ressourcen- und Datenfragen eine Rolle spielen (TEI, Metadata, Linked Open Data). Zudem finden sich auf etwas niedrigeren, in Tab. 2 nicht mehr repräsentierten Rängen etablierte Methoden bzw. Ansätze wie ‚Topic Modeling‘ oder ‚Stylometry‘ (jeweils vier Beiträge) sowie ‚Knowledge Graph‘, ‚Sentiment Analysis‘ und ‚Annotation‘ (jeweils drei Beiträge), die nach wie vor zum Einsatz kommen.

KeywordAnzahl BeiträgeAnteil
Large Language Models220.16
Computational Literary Studies140.1
Digital Humanities110.08
Natural Language Processing90.07
TEI70.05
Metadata60.04
Cultural Analytics60.04
Artificial Intelligence50.04
Linked Open Data50.04
Intertextuality100.04
Tab. 2: Keywords der 137 ‚Literary Studies‘-Beiträge auf der DH2026

Einzelne Veranstaltungen und Beiträge

Die ersten zwei Tage der DH-Konferenz waren wie üblich für Workshops und Minikonferenzen reserviert. Aus CLS-Perspektive war das Treffen der Special Interest Group ‚Digital Literary Studies‘ (SIG-DLS) am Dienstagnachmittag von besonderem Interesse (https://dls.hypotheses.org/2318). Die SIG-DLS ist eine von elf Special Interest Groups der ADHO und „brings together researchers from different perspectives to discuss theoretical, methodological and technical issues of doing digital literary studies, share resources, and organize events and initiatives“ (https://dls.hypotheses.org/). Das Treffen bestand aus einer Serie von Lightning Talks und einer anschließenden Postersession. Deutlich wurde die große Vielfalt der untersuchten Gegenstände und genutzten Methoden. Das Spektrum reichte von der Analyse formaler Merkmale galicischer Lyrik (Pablo Ruiz Fabo) über die Auswertung von Korrespondenzbeziehungen zwischen DDR-Autor:innen mittels Netzwerkanalyse (Marco Lorenz) oder die Differenzierung verschiedener Kanonizitätsindikatoren für englischsprachige Literatur (Haruka Tsutsui) bis hin zum Vergleich von Word Embeddings je nachdem, ob sie auf Texten von Charles Dickens oder anderen englischsprachigen Autor:innen beruhen (Tomoji Tabata). Auch LLMs spielten eine Rolle: Silvia Lilli untersuchte, inwiefern GPT 5.2 plausible Analysen literarischer Texte generieren kann und wie sich die LLM-Outputs verbessern lassen, indem man dem Modell Annotationen bereitstellt; Jenny Kwok ging darauf ein, inwieweit LLMs relevante Kontexte für literarische Texte identifizieren können, die dann wiederum das manuelle Close Reading bereichern; Kohei Furuya widmete sich der Autorschaftsattribution durch LLMs im Kontext englisch-japanischer Übersetzungen.

Unter den Keynotes war besonders diejenige von Maciej Eder einschlägig für die CLS. Eder sprach stellvertretend für die Computational Stylistics Group bzw. das Team hinter dem Stilometrie-Tool stylo, die den Zampolli-Preis 2026 erhalten hatten (https://adho.org/2025/07/16/2026-antonio-zampolli-prize/). Er stellte unter anderem die Arbeit der Gruppe sowie das Tool stylo vor, präsentierte eine exemplarische Analyse zu Stilunterschieden in der Rede von Dramenfiguren (Šeļa et al. 2024) und betonte vor allem, dass Projekte und Initiativen nicht unbedingt mit einer umfassenden finanziellen Förderung, einer formalisierten Organisationsstruktur und/oder einer ‚großen Idee‘ starten müssen, sondern sich auch oder sogar am ehesten ‚bottom up‘, in kleinen Schritten entwickeln können.

Die einzelnen Konferenzsessions waren nicht spezifischen Methoden oder Disziplinen zugeordnet, sodass reine CLS-Sessions die Ausnahme blieben. Die erhebliche methodische und thematische Heterogenität der Sessions könnte man in einem positiven Sinn als Beitrag zum Austausch und zur Verknüpfung innerhalb der mittlerweile stark ausdifferenzierten DH-Community begreifen; andererseits erschwerte die Uneinheitlichkeit der Sessions, kohärente Diskussionszusammenhänge entstehen zu lassen. Trotz allem lassen sich einige übergreifende Tendenzen der CLS-Beiträge ausmachen. Dabei gilt, wie bereits im Fall des SIG-DLS-Treffens, dass dieser Blogpost exemplarisch bleiben muss. Ich beschränke mich auf drei Punkte:

(1) Mehrere Beiträge haben sich neuen, überarbeiteten und/oder erweiterten Tools, Korpora und Infrastrukturen und damit den Grundlagen der CLS-Analyse gewidmet. Henny Sluyter-Gäthje hat beispielsweise eine Sammlung von Ecocriticism-Korpora vorgestellt (https://ecocor.org/), die technologisch an DraCor anknüpft (Trilcke et al. 2026). DraCor selbst, eine besonders wichtige Plattform für Dramenkorpora in verschiedenen Sprachen (https://dracor.org/), war ebenfalls auf der Konferenz vertreten (Giovannini et al. 2026) und wurde auch von Eder in seiner Keynote als hilfreiche Ressource hervorgehoben. Zu nennen ist des Weiteren das GOLEM-Korpus, das aktuell erarbeitet wird und Fanfiction in sieben Sprachen (allerdings nicht Deutsch) sowie diverse Annotationen (z. B. Koreferenzen, Figuren, Events) enthält (Pianzola 2026; Yang/Pianzola 2026).

(2) Auffallend viele Vorträge haben sich mit der manuellen und automatisierten Emotions- und Sentimentanalyse befasst. Untersucht wurden unterschiedlichste Textsorten und Sprachen: von koreanischer Gegenwartslyrik (Lim/Kim 2026) über russische Kurzprosa des 20. Jahrhunderts (Kirina 2026) bis zu – jenseits der Literatur – historischen Zeitschriften (Brozic 2026) und persönlichen Holocaust-Zeugnissen (Neovesky et al. 2026). Insgesamt zeigten sich die Sentiment- und Emotionsanalyse als etablierte Ansätze der CLS und DH, wobei ein hohes Bewusstsein für konzeptuelle Unterscheidungen wie der zwischen Sentiment und Emotion oder diskreter versus dimensionaler Emotionsmodelle bestand.

(3) Diverse Beiträge haben sich, wie bereits angedeutet, mit LLMs auseinandergesetzt. Der Einsatz von LLMs zur automatisierten Annotation kann mittlerweile als etabliert gelten und spielte für zahlreiche Vorträge und Poster eine Rolle. Daneben war auffällig, dass sich viele Beiträge auch mit den generativen Aspekten von LLMs befasst haben, insbesondere mit der Frage, wie sich LLM-generierte literarische Texte von menschlichen unterscheiden. Durchgespielt wurde dies etwa anhand von englischsprachigen K-Pop Lyrics (Florescu/Dinu 2026) sowie der Literatur Han Kangs (Lee et al. 2026), Xin Qijis (Liao et al. 2026) und Leopold Trymands (Rykowska 2026). Betont wurde in allen Fällen, dass LLMs die menschlichen Texte nicht exakt nachahmen können, sondern Unterschiede bestehen bleiben. Auf einer allgemeineren, die eigene Forschung betreffenden Ebene haben mehrere Beiträge zudem betont, dass die Arbeit mit LLMs nicht dazu führen dürfe, relevante Entscheidungen auf eine Weise zu delegieren, die Forscher:innen in zentralen konzeptionellen und interpretativen Fragen von den Modellen abhängig werden lasse. Stattdessen sei wichtig, als Mensch die ‚epistemic agency‘ zu bewahren (vgl. jenseits reiner CLS-Kontexte etwa den Workshop von Hiltmann/Kim-Baumann 2026 sowie die Keynote von Kim Hyeon).

Insgesamt hat sich auf der DH-Konferenz 2026 abermals gezeigt, wie vielfältig und lebendig die CLS im Rahmen der DH sind. Vertreten waren Forscher:innen aus diversen Ländern, die sich mit unterschiedlichsten Texten und Sprachen befasst und dabei unterschiedlichste Methoden angewandt haben. Trotz aller Heterogenität lässt sich festhalten, dass ein anhaltender Schwerpunkt die Auseinandersetzung mit LLMs darstellt, die mittlerweile regelmäßig für Annotationsaufgaben verwendet, aber auch in ihrer textgenerativen Funktion untersucht werden.

Dank

Ich danke dem DHd-Verband, der mir durch ein Reisekostenstipendium die Teilnahme an der DH2026-Konferenz in Daejeon (Südkorea) ermöglicht hat.

Literaturverzeichnis

Brozić, Lucija (2026): „Sentiments toward Migrants and Minorities: Fine-Tuning Transformer Models for Sentiment Analysis of Historical Newspapers.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Florescu, Andra-Maria/Dinu, Anca Daniela (2026): „The ‘K’ Factor: Comparing Human and LLM-Generated English Lyrics in K-Pop.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Giovannini, Luca/Sluyter-Gäthje, Henny/Skorinkin, Daniil/Trilcke, Peer/Börner, Ingo/Fischer, Frank/Khilji, Tabeer (2026): „A Decade in Drama Research. Data Mining the DraCor Bibliography (2015–2025).“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Guhr, Svenja (2025): „Trends in den Computational Literary Studies bei den DHd-Jahrestagungen.“ DHd-Blog, 13.05.2025. https://dhd-blog.org/?p=22316.

Hiltmann, Torsten/Kim-Baumann, Noah Jefferson (2026): „Bringing Humanist Practices into AI – Establishing and Maintaining Sovereignty when Working with LLMs.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Kirina, Margarita (2026): „Annotating Data, Exploring Emotions: A Case of Russian Short Prose of the 20th Century.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Lee, Jae-Yon/Jang, MinHyeok/Jeon, Minguk/Moon, Ji-Seong/Kang, MinJin/Bae, Byung-Chull (2026): „From Poetic Prose to Science Fiction: Classifying and Generating Han Kang’s Literary Style via Computational Methods.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Liao, Zhewei/Xiao, Shuang/Sui, Shengnan/Han, Yafei/Lu, Quanyu (2026): „Large Language Models’ Capability Boundaries in Generating Xin Qiji’s Ci Poetry: A Humanistic Evaluation Study.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Lim, Iro/Kim, Byungjun (2026): „KPoEM: Visualizing Emotion Data in Modern Korean Poetry through a Web-Based Interface Prototype.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Neovesky, Anna/Brolich, Nina/Romeis, Finn/Menny, Anna/Geibel, Helena/Giesecke, Marc (2026): „Insight or Misrepresentation? A case study on sentiment analysis of personal accounts of the Holocaust.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Pianzola, Federico (2026): „The GOLEM Annotated Corpus for Computational Literary Studies.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Rykowska, Aleksandra (2026): „Can LLMs Imitate an Author’s Style? Comparative Stylometric Study of ChatGPT, Gemini, and Claude.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Šeļa, Artjoms/Nagy, Benedek/Byszuk, Joanna/Hernández-Lorenzo, Laura/Szemes, Botond/Eder, Maciej (2024): „From Stage to Page: Language Independent Bootstrap Measures of Distinctiveness in Fictional Speech.“ In: M. Andersen/N. Reiter (Hg.), Computational Drama Analysis. Reflecting on Methods and Interpretations, S. 149–166. Berlin: De Gruyter.

Trilcke, Peer/Barkey, Sören/Schumacher, Mareike/Börner, Ingo/Milling, Carsten/Skorinkin, Daniil/Sluyter-Gäthje, Henny/Haider, Thomas/Schwindt, Mark/Busch, Anna/Fischer, Frank/Funk, Clara/Giovannini, Luca/Helmig, Clara/Viebke, Gesine/Khilji, Tabeer/Käb, Corinna/Ottenberg, Bianca Linnea/Daniel, Rebecca (2026): „Introducing EcoCor: An Open Infrastructure for Digital Ecocriticism.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

Yang, Xiaoyan/Pianzola, Federico (2026): „Engaged Annotators: Developing a Multilingual Character Annotation Framework for Fiction.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.

  1. Der Anteil entspricht in etwa dem Niveau der vergangenen Jahre: 2022 (https://github.com/ADHO/dh2022) = 25%; 2023 (https://doi.org/10.5281/zenodo.7961822) = 25%. Die Book of Abstracts der DH-Konferenzen 2024 und 2025 sind nur als PDFs zugänglich und wurden daher nicht ausgewertet. ↩︎
  2. Auch wenn man die Beiträge betrachtet, die nicht den ‚Literary Studies‘ zugeordnet waren, kamen am meisten Autor:innen aus Deutschland, gefolgt von den USA. ↩︎

Die nächsten Termine für das Lunch&Learn zur digitalen Kunstgeschichte 2026

2026年8月6日 20:45

Seit nun einem Jahr gibt es das Online-Format des Arbeitskreises Digitale Kunstgeschichte: „Lunch&Learn zur digitalen Kunstgeschichte“ – eine monatliche digitale Mittagspause zu Fragen und Themen rund um die digitale Kunstgeschichte.

FORMAT: Einstieg (5 Min) – Impulsvortrag (10 Min) – Diskussion (15 Min) – Helpdesk & Tipps (15 Min)

In diesem Jahr haben wir nach der Sommerpause folgende interessante Termine für Euch geplant.

7. August 2026: Sommerpause

4. September 2026, 13:00 Uhr: 
ProNto – Provenienzforschung-Navigator
Angela Berthold (Münzkabinett Berlin, NFDI4Objects), Gabriele Zöllner (Humboldt-Universität zu Berlin, SODa)

2. Oktober 2026: Entfällt, dafür findet die Prometheus-Tagung statt.

6. November 2026, 13:00 Uhr: 
Mittelalterliche Glasmalerei inventarisieren – Methoden der digitalen Objekterschließung im Projekt Corpus Vitrearum Medii Aevi Deutschland
Stephanie Schüler (CVMA Potsdam)

4. Dezember 2026, 13:00 Uhr:
Digitale Objektbiografien modellieren
Sarah Wagner (Friedrich-Alexander-Universität Erlangen-Nürnberg, NFDI4Objects)

Für wen ist diese Veranstaltung? Neugierige Menschen mit einem Interesse an Kunstgeschichte und Digitalität sind sehr herzlich eingeladen.

Hier ist der ZOOM-Link, der für alle Lunch&Learns gilt: https://us02web.zoom.us/j/84286572737?pwd=VrT2D61m8S2g1CCD6QlD3qVVgy8yCL.1.

Daher einfach in der Mittagspause dazu schalten, wir freuen uns auf Euch!

Women Playwrights in Digital Corpora: a DraCor Hackathon

作者Erik Renz
2026年8月4日 23:12

Literary historians maintain that women have never contributed significantly to the German drama. Facts, however, point clearly to the opposite. Indeed, the first known German dramatist (10th century) was a woman! Two major causes for the lack of historic recognition are: (a) prejudice that women are incapable of good dramatic production, (b) underrating of plays because professional critics—traditionally men—have used male psychology as the criterion for judging female characters in plays by women. A revaluation of women’s contributions to drama is imperative.
(Scholtz Novak 1972, 47)

When the German-born American scholar of German literature Sigrid Scholtz Novak issued her call for greater recognition of women playwrights in the early 1970s, she was responding to a literary historiography that had either largely overlooked women’s extensive dramatic production or fundamentally questioned its aesthetic and historical significance. More than five decades later, scholarly engagement with women playwrights has expanded considerably. Nevertheless, the problem of accessibility identified by Scholtz Novak remains unresolved. Many plays by women are still available only in historical print editions, are dispersed across libraries and archives, or are absent from the digital text collections that increasingly underpin literary-historical scholarship and computational research.

Within the Digital Humanities, accessibility entails more than the provision of a digital surrogate. For literary works to be discoverable, systematically analysable, and reusable across different research contexts, they must be represented in structured and interoperable formats, documented with reliable metadata, and integrated into sustainable research infrastructures. Digital corpora therefore are not neutral representations of literary history. Their composition reflects historical processes of publication, preservation, canon formation, scholarly reception, selection, and digitisation. As a result, works by women remain substantially underrepresented in many digital collections.

Against this background, the University of Rostock will host the hackathon Women Playwrights in Digital Corpora from 7 to 9 September 2026. The event will address both the digital representation and computational analysis of plays by women, with particular attention to their integration into the DraCor research infrastructure.

DraCor (short for Drama Corpora) is an open and multilingual research infrastructure for the computational study of drama from antiquity to the twentieth century. Its corpora are encoded according to the guidelines of the Text Encoding Initiative (TEI) and made available through a web interface and an application programming interface (API). DraCor currently comprises 33 drama corpora containing more than 4,000 annotated full-text plays in 24 languages. As a community-driven project committed to open-science principles, it supports a broad international research landscape in computational drama analysis and theatre history.

About the Hackathon

The hackathon will take place in Rostock from 7 to 9 September 2026. Hosted by the Professorship for Digital Humanities at the University of Rostock, the three-day event will bring together researchers from computational literary studies, cultural analytics, digital scholarly editing, theatre studies, and related fields.

The program will combine introductory training sessions on encoding dramatic texts in TEI and working with DraCor data with scholarly presentations, collaborative working sessions, and discussion formats. During the working sessions, participants may either pursue projects of their own or contribute to prepared thematic work packages.

Program

Monday, 7 September 2026

13:00–13:15
Welcome and Introduction
13:15–14:45
Beginners’ Training Session I: From Dramatic Text to DraCor TEI
Tutors: Julia Jennifer Beine and Aşina A. Yıldız (both Würzburg)
14:45–15:15
Coffee Break
15:15–16:45
Beginners’ Training Session II: Analyses with DraCor Data
Tutor: Frank Fischer (Berlin)
16:45–17:15
Coffee Break
17:15–18:45
Hybrid session
On-site and online
No registration required.
Keynote
Speaker: Cristian A. Aravena (Santiago de Chile)
19:30
Informal Dinner

Tuesday, 8 September 2026

09:00–10:30
Hybrid session
On-site and online
No registration required.
State of the Art: Women Playwrights in Digital Corpora
Speaker 1: Anna Axtner-Borsutzky (Munich) (Lost in Archives)
Speaker 2: Lou Klappenbach (Berlin) (Gender & Data)
Speaker 3: Marius Hug (Berlin)
10:30–11:00
Coffee Break
11:00–12:30
Collaborative Working Session I
12:30–13:30
Lunch Break
13:30–15:00
Collaborative Working Session II
15:00–15:30
Coffee Break
15:30–17:00
Battle of the Plays World Championship 2026

Moderators: Frank Fischer and Antonio Rojas Castro (both Berlin)

Wednesday, 9 September 2026

09:00–10:30
Collaborative Working Session III
10:30–11:00
Coffee Break
11:00–12:00
Round Table Discussion
12:00–12:30
Closing Remarks

The hackathon is conceived as an open and collaborative environment for exploring methodological and practical questions relating to digital drama analysis, text encoding, corpus development, metadata modelling, and data enrichment. Rather than focusing exclusively on completed research results, the event invites participants to develop and test new approaches, exchange expertise, and collaborate on concrete textual and data-based materials. Possible topics may include:

  • the encoding, documentation, and enrichment of plays by women;

  • the integration of new plays into existing or newly established DraCor corpora;

  • the digital modelling and analysis of characters and gendered patterns of representation;

  • the computational analysis of character networks, speech distribution, scene structures, and stage directions;

  • comparative analyses across languages, historical periods, dramatic genres, and theatrical traditions;

  • the reconstruction of reception and transmission networks through authority data and linked open data;

  • the development of methods for linking plays, authors, characters, performances, translations, adaptations, and other forms of reception.

The event is open both to participants with previous experience of DraCor or TEI and to interested newcomers. No prior technical knowledge is required.

Registration

The event will take place on site at the University of Rostock. Participation is free of charge and limited to 35 participants. To register, please send an email to phf.dh@uni-rostock.de. When registering, please indicate whether you would also like to attend either or both of the following accompanying events:

  • Monday, 7 September 2026, from 7:30 p.m.: Informal dinner at L’Osteria Rostock. Participants are responsible for covering their own expenses.

  • Tuesday, 8 September 2026, 3:30–5:00 p.m.: Battle of the Plays World Championship 2026

While the event will generally take place on site, the Opening Keynote on Monday, 7 September, and the session “State of the Art: Women Playwrights in Digital Corpora” on Tuesday, 8 September, will be held in a hybrid format. Interested participants may attend either program item in person or online. No registration is required for either program point.

Venue

Seminar Rooms 105 and 116
Philologicum
Universitätsplatz 3
18055 Rostock
Germany

Online participation via Zoom

Zoom-Link: https://uni-rostock-de.zoom-x.de/j/68841161435
Meeting-ID: 688 4116 1435

Organisers: Erik Renz and Ulrike Henny-Krahmer

Contact: phf.dh@uni-rostock.de

The event is organised with the support of the team of the Professorship for Digital Humanities at the University of Rostock. It forms part of the activities of the Rostock Working Group for Digital Humanities (RosDH) and is funded by the Department “Wissen – Kultur – Transformation” of the Interdisciplinary Faculty and by the Faculty of Humanities at the University of Rostock.

Universität Heidelberg: Research Data Engineer 100% E13 (w/m/d)

2026年8月3日 16:38

Heidelberg University is a comprehensive university with a strong focus on research and international standards. With around 32,200 students and 9,540 employees, including numerous top researchers, it is a globally respected institution that also has outstanding economic significance for the Rhine-Neckar metropolitan region.

The Heidelberg Center for Digital Humanities is one of Germany′s leading institutions in the fields of digital and computational humanities. Its key areas of focus are digital linguistics, digital heritage, and AI/machine learning. Thanks to its close ties with the Interdisciplinary Center for Scientific Computing (IWR), the HCDH pursues the computational humanities with particular intensity.

The Research Data Engineer full-time position (E13, 100%) for a term of 4 years, with the option to extend is available at the Heidelberg Center for Digital Humanities (HCDH) starting December 1, 2026 (or earliest possible).

Your responsibilities:

  • Bridging the gap between cultural heritage data and advanced computational research: Design and build data storage layers and data processing pipelines that enable our humanities researchers to create and analyze massive, heterogeneous datasets (including legacy data)—ranging from historical texts and archives to multimedia, 3D and spatial data
  • Research Collaboration: Act as the technical consultant for humanities scholars, translating complex research questions into viable computational and database requirements
  • Data Pipelines: Design, implement, and maintain scalable pipelines to ingest, clean, and harmonize diverse cultural heritage and other data and create interoperable datasets for research
  • Data architecture: Design, implement, and maintain data structures and connect to existing data storage layers and infrastructure
  • Semantic Web & Knowledge Graphs: Develop and optimize graph databases, ontologies, and semantic models (e.g., using RDF, OWL, CIDOC-CRM) to interconnect complex historical and cultural data
  • Tool Development & Automation: Build custom APIs, and scripts (primarily in Python) to automate data ingestion, text-mining, and natural language processing (NLP) workflows
  • FAIR and FAIR4RS principles: Collaborate with the Research Data Unit and Scientific Software Center and its Data Science Unit at the IWR, and the University Computing Centre (HPC and storage infrastructure)

Your profile:

  • Education & Background: Preferably a PhD, but MA/MSc are encouraged to apply
  • Soft Skills: Strong communication skills to effectively collaborate across interdisciplinary teams of software engineers and traditional humanities scholars
  • Core Tech Stack: Excellent knowledge of Python (plus libraries like Open3D, Pandas, SpaCy, or NLTK) and version control using Git, experience with Rust and/or PyTorch is a plus
  • Database & Semantic Web Skills: Strong experience with databases (e.g., Neo4j, GraphDB, NoSQL, SQL) and semantic web technologies (e.g., SPARQL, JSON-LD)
  • DH Standards: Ideally knowledge of text encoding standards (e.g., TEI-XML) and metadata schemas (e.g., Dublin Core, MODS, LIDO); desirable: Experience with working with humanities’ data
  • Independent and structured work style, ability to work in teams and to fixed timelines
  • Language requirements: Very good English language skills, desirable: basic German skills

We offer:

  • The opportunity to work at the cutting edge of digital and computational humanities using modern AI and data engineering methods
  • Work in an innovative environment with the opportunity of professional training and qualification in the emerging professional field of research data engineering
  • A highly collaborative, interdisciplinary, and international research environment
  • Support for active contributions to the Open Source and Digital Humanities communities
  • Excellent opportunities for independent research and further academic training
  • Flexible working hours and a good work-life balance; part-time remote work is possible
  • Opportunity for further training and building a professional network by participating in national and international conferences
  • A dedicated team that supports each other
  • Workplace in the very Center of Heidelberg Altstadt with good public transport
  • Access to university sports offers
  • Support for employee mobility through a subsidized Deutschlandticket

The position is a 4-year fixed-term position with the possibility of extension. Remuneration is based on the TV-L collective agreement (pay group 13). The position is suitable for job-sharing.

We look forward to receiving your application (in English), including the following documents: cover letter, CV including a project list, proof of academic degree, employment references and list of references (2-3 names and contact details), by 14 September 2026, sent to as a single PDF file via email to nele.schneidereit@uni-heidelberg.de (max. of 25 MB).

There will be a two-stage process, with online interviews taking place in the first half of October. We will invite the remaining candidates to an in-person interview on October 23. Please save the date.

Heidelberg University stands for equal opportunities and diversity. Qualified female candidates are especially invited to apply. People with severe disabilities will be given preference if they are equally qualified. Information on job advertisements and the collection of personal data is available at www.uni-heidelberg.de/en/job-market.

Call for Hosts DHd2029

2026年7月29日 21:27

DHd20xx ist die jährliche, internationale Fachtagung der Digital Humanities im deutschsprachigen Raum (DHd, https://digitalhumanities.de) und die führende wissenschaftliche Konferenz für die Digital Humanities im deutschen Sprachraum (Vergangene Konferenzen: https://digitalhumanities.de/vergangene-konferenzen/). Der Fachverband Digital Humanities im deutschsprachigen Raum bittet nun um Bewerbungen um die Ausrichtung für die fünfzehnte Tagung (DHd2029). Da der Fachverband anstrebt, die Konferenz wechselnd in Deutschland und außerhalb Deutschlands zu veranstalten, freuen wir uns besonders über Bewerbungen von Einrichtungen aus dem deutschsprachigen Raum außerhalb Deutschlands.

Bisherige Konferenzen haben bis zu 650 Teilnehmer:innen aus dem deutschsprachigen Raum und angrenzenden Ländern angezogen. Die Tagungsprogramme sahen jeweils zwei Tage für Workshops und drei Tage für das Hauptprogramm bestehend aus Keynotes, parallelen Sektionen mit wissenschaftlichen Vorträgen, Paneldiskussionen, Posterpräsentationen und Doctoral Consortia vor. Die Einführung neuer Formate ist in Abstimmung mit dem Verband und dem Programmkomitee möglich.
Das wissenschaftliche Programm der Tagung wird durch ein vom Fachverband eingesetztes internationales Programmkomitee auf Grundlage eines Call for Papers und eines anschließenden Review-Verfahrens erstellt. Das Konferenzprotokoll des DHd-Verbands muss berücksichtigt werden (https://digitalhumanities.de/konferenzprotokoll/).

Die Tagung finanziert sich über Teilnahmegebühren und von der ausrichtenden Institution bereitgestellte oder über Partner:innen oder Sponsor:innen eingeworbene finanzielle Mittel. Die erhobene Tagungsgebühr ist mit dem Vorstand des Fachverbandes abzustimmen und soll vier Kategorien umfassen: reguläre und ermäßigte Mitglieder des DHd (letztere im Sinne der Regelung zur ermäßigten Mitgliedschaft im DHd-Verband) sowie reguläre und ermäßigte Nicht-Mitglieder des DHd.

Die Bewerbung um die Ausrichtung der DHd2029 soll umfassen:

  • einen Vorschlag für ein Tagungsmotto sowie zwei Terminvorschläge (bevorzugt im Zeitraum Februar bis März). Bei der Terminplanung soll auf potentiell konkurrierende Konferenzen, Semesterzeiten und Feiertage sowie Schulferien geachtet werden.
  • einen Überblick über die für die Konferenz bereitgestellte Infrastruktur (vor allem Tagungsräume für Workshops, AG-Sitzungen, parallele Sektionen und Plenarveranstaltungen)
  • Aussagen über die Unterstützung der Ausrichtung vor Ort (z.B. durch die Universitätsleitung)
  • eine Aussage über die Verwendung von Management- und Bezahlsystemen (das System Conftool ist dafür etabliert und soll zumindest für die Einreichungen genutzt werden)
  • eine Aussage über die Unterstützung der Publikation der Tagungsbeiträge in Kooperation mit dem Data Steward des DHd-Verbands
  • Angaben zur Erreichbarkeit des Tagungsortes (bzw. ggf. der Tagungsorte) und die Verfügbarkeit von Unterkünften (inkl. Preisschätzungen)
  • eine Einschätzung zu den Möglichkeiten einer teilweisen virtuellen Partizipation
  • Ideen für Social Events
  • Vorschläge zur Erreichung einer hohen Sichtbarkeit der Tagung
  • Maßnahmen zur Förderung von Nachwuchswissenschaftler:innen (inkl. Studierende)
  • eine vorläufige Kostenkalkulation und Vorstellungen über die Tagungsgebühr
  • ggf. Preiskonzept bei Planung einer vollständigen Hybridkonferenz
  • eine Erklärung, dass die Konferenz entsprechend der im Konferenzprotokoll dargelegten Bedingungen ausgerichtet wird.

Der Verband begrüßt Maßnahmen, die auf Inklusion und Minimierung des Ressourcen-Fußabdrucks abzielen.

Bewerbungen werden bis 31.10.2026 entgegengenommen (formlos per E-Mail an den Tagungskoordinator im Vorstand des Fachverbandes, Nils Reiter: nils.reiter@uni-koeln.de). Interessierte Ausrichter:innen werden gebeten möglichst frühzeitig, in jedem Falle aber vor Einreichung ihrer Bewerbung, mit Nils Reiter Kontakt aufzunehmen. Die Bewerbung sollte zehn Seiten möglichst nicht überschreiten. Die Vergabe der Tagung erfolgt durch den Vorstand des Fachverbandes bis spätestens 31.01.2027.

30. AWK: Data Ethics for Archival Science and Historical Research, Marburg 26./27.8.2026

2026年7月28日 19:55

Im Ausland ist Datenethik bereits ein großes Thema, wie der Internationale Archivrat im Juni mit einer Veranstaltungswoche gezeigt hat. Mehr als 140 Beiträge aus der weltweiten Archivcommunity drehten sich um Archives for Justice: Rights, Memory & Futures.
Im deutschen Sprachraum ist das Thema dagegen noch kaum angekommen. Die Archivschule Marburg freut sich, mit ihrem diesjährigen Kolloquium dazu beizutragen, „Archivethik“ auch nach Deutschland zu bringen.

Wir haben eine gute Mischung zwischen allgemeineren Beiträgen (es eröffnen PD Dr. Dr. Grischka Petri, FIZ Karlsruhe: Datenzugang zwischen Offenheit und Verantwortung und Prof. Dr. Dr. Rainer Hering/Dr. Ole Fischer, Landesarchiv Schleswig-Holstein: ‚Historische Gerechtigkeit‘ als Element archivischer Ethik?) und einzelnen Aspekten (Trauma-informierte Archivarbeit und soziale Gerechtigkeit, Maria Benauer BA MSc, Technische Informationsbibliothek Hannover und Dipl.-Archivarin (FH) Mag.a Tamara Kefer, Stadtarchiv Graz), eine Sektion zu archivischen Fachaufgaben sowie internationale Beiträge aus Indien, Südafrika, Österreich und der Türkei. Auch Sammlungsaspekte aus Museen und Bibliotheken sind im Kolloquium vertreten.

Ein Kolloquium für alle, die sich über ethische Aspekte der Archivarbeit informieren möchten. Archivar*innen halten die Daten vor, Historiker*innen werten sie aus. Wenn wir uns heute nicht gemeinsam um diese Fragen kümmern, werden wir morgen große Probleme bekommen.
Programm und Anmeldung.

Die Veranstaltung findet hybrid statt.

Mit freundlichen Grüßen,

Robert Meier

❌