普通视图
Datenbank-Launch „Beginen in Köln“, 5. Oktober 2026, 15:00 Uhr
Das Cologne Center of eHumanities (CCeH) und die Forschungsstelle Geschichte Kölns am Historischen Institut der Universität zu Köln laden nach Abschluss des DFG-Projekts Beginen in Köln: Sozialgeschichte urbaner…
The post Datenbank-Launch „Beginen in Köln“, 5. Oktober 2026, 15:00 Uhr appeared first on CCeH.
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Clustertreffen des NFDI4Objects CC Data Capture and Creation zur „Culture Cloud“, 8.9.2026, 14:30-16:00 Uhr
Clustertreffen des NFDI4Objects CC Data Capture and Creation zur „Culture Cloud“, 8.9.2026, 14:30-16:00 Uhr
Am 8. September 2026, 14:30 bis 16:00 Uhr, findet das nächste Treffen des NFDI4Objects Community Clusters Data Capture and Creation statt. Dieses Mal wird unser Co-Chair Frank Dührkohp (Verbundzentrale des GBV) einen Einblick in das Projekt Culture Cloud geben.
Mit der Culture Cloud entsteht erstmals eine landesweite Kulturdateninfrastruktur für Niedersachsen, die Informationen aus Museen, Archiven, Bibliotheken und der Denkmalpflege zusammenführt. Was bislang dezentral gespeichert und oft schwer auffindbar war, wird nun über einheitliche Standards vernetzt und zentral zugänglich gemacht. So können die Daten künftig über digitale Portale leichter gefunden, miteinander verknüpft und für Forschung, Kultur und Öffentlichkeit nutzbar werden – bei voller Datenhoheit der jeweiligen Einrichtungen.
Hier sind die Zoom-Zugangsdaten:
https://dainst-org.zoom.us/j/93071809817?pwd=YVscWm2i20FHyG8hgVhcO712Wya9Vv.1
Meeting-ID: 930 7180 9817
Kenncode: 032259
Eine Anmeldung ist nicht erforderlich, wir freuen uns auf einen Austausch!
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Workshopbericht „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ (29.05.26 in Leipzig)
Workshopbericht „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ (29.05.26 in Leipzig)
Von Lukas Hohendorf, Kai Matuszkiewicz, Lydia Riedl und Paula Rinke
Ausgangspunkt
In digitalen Räumen werden fortlaufend Daten produziert, die für die Kommunikations- und Medienwissenschaft von hoher Relevanz sind, darunter Beiträge und Kommentare in sozialen Medien, Kommunikationsverläufe in Messenger-Diensten, audiovisuelle und auditive Inhalte, digitale Zeitungsarchive und digitalisierte historische Quellen oder journalistische Online-Angebote. In Forschungsprojekten entstehen daraus häufig umfangreiche Korpora. Viele Forschende wissen aus eigener Erfahrung, dass diese nach Projektende jedoch oft schwer auffindbar, nur eingeschränkt dokumentiert oder aufgrund rechtlicher, ethischer und technischer Rahmenbedingungen nicht ohne Weiteres nachnutzbar bleiben.
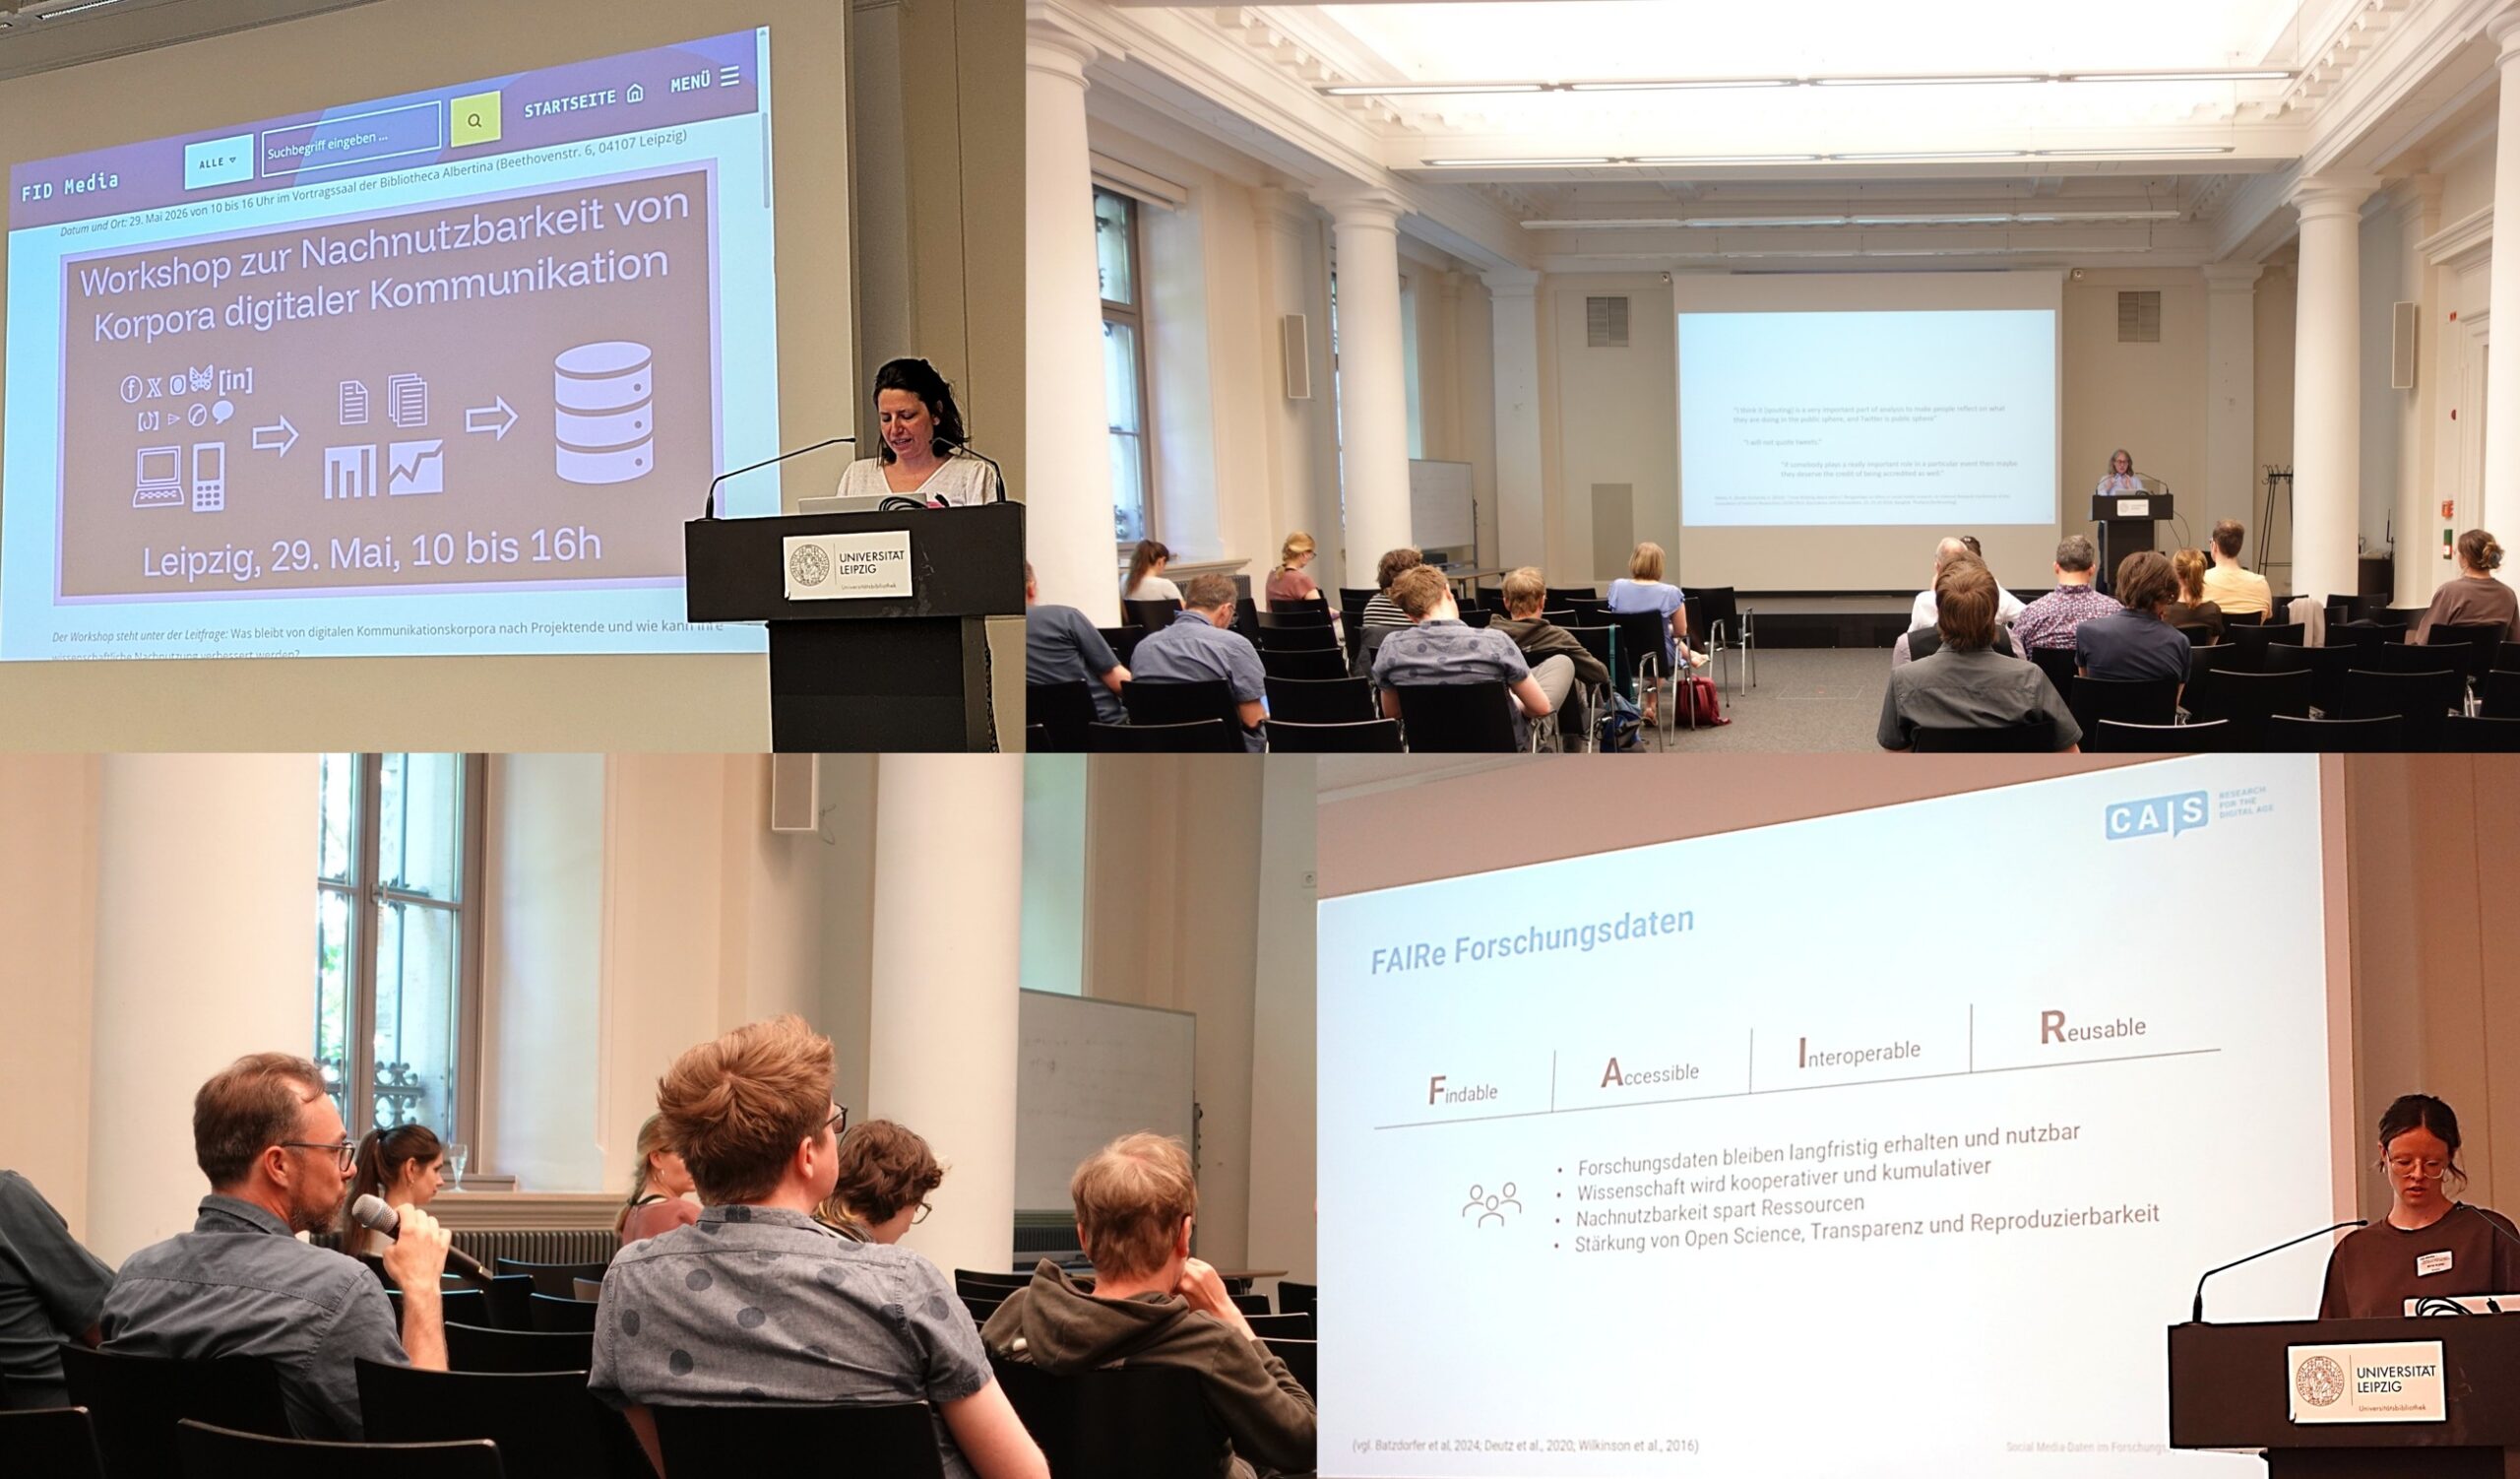
An dieser Ausgangsproblematik setzte der Workshop „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ an, den der FID Media am 29. Mai 2026 an der Universitätsbibliothek Leipzig veranstaltete. In ihrer Begrüßung führte Patricia Blume in diese Ausgangsproblematik ein und benannte als übergeordnete Fragen des Workshops, wie digitale Kommunikationskorpora entstehen, unter welchen Bedingungen sie wissenschaftlich analysiert werden können und welche Rolle fachnahe wissenschaftliche Infrastrukturen künftig bei ihrer Dokumentation und Vernetzung spielen können, um sie niedrigschwellig nachnutzbar zu machen.
Wie durch Lukas Hohendorf in seiner anschließenden Einführung erläutert, strukturierte sich der Workshop dabei entlang wichtiger Stationen des üblichen Forschungsprozesses. Im ersten Panel ging es um die Entstehung digitaler Kommunikationsdaten und die methodischen, epistemischen und ethischen Entscheidungen, die bereits die Datenerhebung beeinflussen. Das zweite Panel rückte die Frage in den Vordergrund, wie aus projektgebundenen Datensammlungen längerfristig nachnutzbare Forschungsressourcen werden können. Das dritte Panel diskutierte schließlich die Potenziale und Grenzen vernetzter Kommunikationskorpora für Analyseformen, insbesondere in der Computational Communication Science (CCS).
Von digitaler Kommunikation zu Korpora für die Forschung
Das erste Panel, moderiert von Patricia Blume, widmete sich der grundlegenden Frage, wie digitale Kommunikationsspuren überhaupt zu Forschungsdaten werden. Die Beiträge veranschaulichten, dass digitale Daten nicht einfach „vorliegen“, sondern in komplexen technischen, sozialen und institutionellen Prozessen hergestellt werden. Welche Daten verfügbar sind, welche Lücken entstehen und welche Kommunikationsformen überhaupt beobachtbar werden, hängt von Plattformarchitekturen, Zugangsmöglichkeiten, Erhebungspraktiken, ethischen Entscheidungen und rechtlichen Rahmenbedingungen ab.
Katharina Kinder-Kurlanda (Universität Klagenfurt) nahm in ihrem Beitrag „Epistemische Herausforderungen von Big Social Media Data für die Sozialwissenschaft“ die Entstehungsbedingungen digitaler Daten in den Blick. Sie zeigte, dass Forschung mit großen Datenbeständen aus sozialen Medien immer auch mit asymmetrischen Datenökonomien verbunden ist. Während plattformbetreibende Unternehmen umfangreiche Datenbestände kontrollieren, sind Forschende häufig auf instabile oder nachträglich eingeschränkte Zugänge angewiesen. Diese Abhängigkeit schlägt sich nicht nur in der Datenerhebung selbst nieder, sondern beschränkt auch den Möglichkeitsraum der Forschungsfragen, die wissenschaftlich überhaupt bearbeitbar sind.
Ein zentrales Thema ihres Beitrags war die Sichtbarkeit von Datenarbeit. Viele Entscheidungen, die für wissenschaftliche Ergebnisse maßgeblich sind, bleiben in Publikationen oft unterbelichtet: Wie wurden Daten erhoben, bereinigt, ausgeschlossen, anonymisiert oder transformiert? Welche Plattformbedingungen haben den Zugang strukturiert? Welche ethischen Abwägungen waren im Forschungsprozess erforderlich? Kinder-Kurlanda betonte, dass Datenpraktiken situiert, iterativ und plattformgebunden sind. Transparenz über diese Praktiken ist daher eine Voraussetzung für die Überprüfbarkeit und Einordnung wissenschaftlicher Ergebnisse.
Auch die Archivierung digitaler Plattformdaten wurde als besondere Herausforderung sichtbar. Am Beispiel früherer Twitter-Forschung wurde aufgezeigt, dass die Archivierung von IDs zwar eine Zeit lang als praktikabler Kompromiss galt, langfristig aber keine verlässliche Perspektive bietet, wenn die Rehydrierung, d.h. die Wiederherstellung der Inhalte, weiterhin von der Plattform abhängig bleibt. Dagegen kann die Archivierung von Code, Erhebungsprotokollen, Dokumentationen und Verarbeitungsroutinen auch dann wissenschaftlichen Mehrwert erzeugen, wenn die vollständigen Rohdaten nicht dauerhaft geteilt werden können. In der Diskussion wurde zudem herausgestellt, dass Forschungsethik nicht vollständig an formale Verfahren oder Infrastrukturen delegiert werden kann. Ethikkommissionen, institutionelle Leitlinien und Beratungsangebote können unterstützen, die Verantwortung für konkrete Forschungsentscheidungen bleibt jedoch Teil der wissenschaftlichen Praxis.
Erik Koenen (Universität Bremen) weitete den Blick auf digitale Zeitungsportale und die epistemischen Folgen der Digitalisierung journalistischer Quellen. Im Zentrum des Beitrags stand, dass digitalisierte Zeitungen nicht einfach analoge Objekte in digitaler Form sind. Sie liegen zugleich als Bild, Layout, Volltext, Metadatenstruktur und Suchumgebung vor. Damit verändern sich nicht nur die Zugriffswege, sondern auch der epistemische Status der Quelle selbst. Digitale Zeitungsportale fungieren nicht allein als Archive, sondern auch als methodische und epistemische Forschungsumgebungen.
Koenen argumentierte, dass digitale Zeitungsportale als medientechnische Assemblagen verstanden werden müssen. Sie sind digitale Archive, Sammlungen, Lesesäle, Suchmaschinen und Experimentalsysteme zugleich. Anknüpfend an wissenschaftstheoretische Perspektiven, unter anderem an Ludwik Flecks Konzept wissenschaftlicher Denkstile und Hans-Jörg Rheinbergers Begriff des Experimentalsystems, zeigte er, dass digitale Technologien neue Formen wissenschaftlicher Beobachtung und Interpretation hervorbringen. Distant Reading und Distant Viewing eröffnen neue Perspektiven auf Medienwandel, Layoutgeschichte und öffentliche Kommunikation, setzen aber zugleich eine digitale Quellenkritik voraus, die sich mit Datenformaten, Auszeichnungspraktiken, OCR-Qualität, Portallogiken und Suchinfrastrukturen auseinandersetzt.
Vanessa Angenendt (Universität Duisburg-Essen) brachte mit ihrem Projekt zu Misogynie in Chat-Kommunikation eine weitere Perspektive auf die Entstehung digitaler Kommunikationsdaten ein. Ihr Beitrag befasste sich nicht mit öffentlicher Plattformkommunikation, sondern mit privater oder halböffentlicher Chat-Kommunikation, die der Forschung bislang nur schwer zugänglich ist. Die Datengrundlage bilden Datenspenden, um Chatverläufe zu erfassen, in denen frauenfeindliche oder misogyne Kommunikation sichtbar wird.
Der Beitrag verdeutlichte die gesellschaftliche Relevanz innovativer Wege der Datengewinnung, weil sozial unerwünschte Phänomene wie digitale Misogynie strukturell bedingt häufig in Kommunikationsräumen stattfinden, die sich klassischen Erhebungsverfahren entziehen. Datenspenden eröffnen hier die Möglichkeit, alltägliche und oft verdeckte benachteiligende Praktiken, die in ungleichen Geschlechterverhältnissen verankert sind, empirisch sichtbar zu machen. So zeigten präsentierte Analysen beispielsweise, dass Misogynie in Chat-Kommunikation nicht nur in einzelnen abwertenden Aussagen sichtbar wird, sondern häufig im Verlauf der Interaktion ähnliche Dynamiken erzeugt. Veranschaulicht wurde dies anhand typischer Sequenzen von Kontaktaufnahme, Ablehnung oder Beendigungsversuch, anschließendem Nachsetzen und Herabwürdigen als Machtdemonstration. Konzepte wie „Unwanted Pursuit Behavior“, „Misogynistic Backlash“ oder „Freezing“ systematisierten, wie Kontrolle, Abwertung und Einschüchterung kommunikativ hergestellt werden.
Zugleich zeigte der Beitrag, welche methodischen und ethischen Herausforderungen mit der Analyse privater Kommunikationsräume verbunden sein können. So muss die Datenspende niedrigschwellig organisiert sein, gleichzeitig aber die Datensouveränität der spendenden Personen respektieren. Nach der Einreichung erfolgt eine irreversible Anonymisierung; die Daten werden für die Analyse aufbereitet, enthalten jedoch keine vollständigen Metadaten. Gerade weil es sich um sensible Daten handelt, stellen sich Fragen der Zugänglichkeit, Nachnutzung und Dokumentation besonders nachdrücklich.1 Auch methodische Leerstellen wurden benannt: Chats, die gelöscht wurden, können nicht untersucht werden, und die Zusammensetzung der Datenspendenden ist durch Rekrutierungswege, Bildungshintergründe und mediale Kooperationspartner:innen geprägt.
Insgesamt zeigte das erste Panel, dass Digitale Kommunikationskorpora keine neutralen Abbilder digitaler Kommunikation sind. Vielmehr sind sie Ergebnisse von Entscheidungen, Infrastrukturen, Machtverhältnissen und Praktiken. Für ihre spätere Nachnutzung reicht es daher nicht aus, Daten lediglich abzulegen. Dokumentiert werden muss auch, wie sie entstanden sind, welche Zugänge möglich waren, welche Ausschlüsse vorgenommen wurden, welche Unsicherheiten bestehen und welche rechtlichen oder ethischen Einschränkungen gelten.
Vom Korpus-Silo zur nachnutzbaren Forschungsdatenlandschaft
Das zweite Panel verschob den Fokus von der Entstehung digitaler Korpora auf ihre langfristige Nachnutzung und wurde von Lydia Riedl moderiert. Ausgangspunkt war die Beobachtung, dass viele Korpora in einzelnen Projekten entstehen und nach Projektabschluss in Datensilos verbleiben. Sie sind dann zwar für das ursprüngliche Projekt nutzbar, werden aber für andere Forschende kaum auffindbar, sind unzureichend dokumentiert oder können aus rechtlichen, ethischen oder technischen Gründen nicht geteilt oder mit anderen Daten verknüpft werden. Alle Beiträge griffen dabei einzelne oder mehrere der FAIR-Prinzipien2 (findable, accessible, interoperable, reusable) auf und übertrugen sie auf die besonderen Bedingungen digitaler Kommunikationskorpora.
Vincent Fröhlich (Universität Erlangen-Nürnberg) eröffnete das Panel mit einem Beitrag zu infrastrukturellen Bedarfen der Forschung mit Daten aus sozialen Medien im Bereich Demokratie- und Rechtsextremismusforschung. Er betonte, dass die Volatilität von Plattformdaten eine zentrale Herausforderung darstellt. Inhalte werden gelöscht, Accounts verschwinden, Schnittstellen ändern sich, Zugänge werden eingeschränkt. Was heute erhoben werden kann, ist morgen möglicherweise nicht mehr verfügbar. Für die Forschung bedeutet dies, dass Fragen der Sicherung, Dokumentation und Nachvollziehbarkeit frühzeitig mitgedacht werden müssen.
Besonders betonte Fröhlichs Beitrag, dass Sicherheit in diesem Forschungsfeld mehrdimensional ist. Es geht nicht nur um die Sicherheit der Daten selbst, sondern auch um die Sicherheit der Forschenden und der beforschten Personen. Wer zu Rechtsextremismus, Desinformation oder demokratiegefährdender Kommunikation forscht, kann selbst zur Zielscheibe werden. Forschungsinfrastrukturen müssen neben der Auffindbarkeit und Nachnutzung von Daten auch Schutzräume, Zugriffskontrollen und gut reflektierte Formen der Sichtbarkeit mitdenken. In der Diskussion wurde die Spannung zwischen wissenschaftlicher Sichtbarkeit, die insbesondere für Qualifikations- und Karrierewege wichtig ist, und dem Schutz von Forschenden thematisiert. Hier zeigte sich, dass Infrastrukturen auch institutionelle Sensibilisierung und Schutzmechanismen unterstützen können.
Birte Kuhle (Center for Advanced Internet Studies) griff die Frage nach nachnutzbaren Daten aus der Perspektive des Forschungsdatenlebenszyklus auf. Ihr Beitrag zu praktischen Herausforderungen im Umgang mit Daten aus sozialen Medien zeigte, dass Forschungsdatenmanagement nicht erst am Ende eines Projekts beginnt. Bereits in der Phase „Discover, Plan & Design“ stellen sich Fragen des Samplings, der Plattformauswahl sowie zu ihren jeweiligen Beschränkungen, der Datenzugänge und der rechtlichen Rahmenbedingungen. In der Phase der Datenerhebung können geplante Zugänge, etwa über Plattform-APIs, kurzfristig wegfallen. Forschende müssen dann alternative Wege wie Datenspenden oder Webscraping prüfen, die wiederum eigene ethische und rechtliche Fragen aufwerfen.
Auch die Verarbeitung und Analyse von Daten aus sozialen Medien ist mit erheblicher Datenarbeit verbunden. Daten müssen bereinigt, strukturiert, mit IDs versehen, versioniert und dokumentiert werden. Multimodale Daten erhöhen den Aufwand zusätzlich, weil Text, Bild, Audio und Video unterschiedliche Formate, Werkzeuge und Dokumentationslogiken erfordern. Für die Phase „Publish, Archive & Share“ stellte Kuhle die Frage, was überhaupt veröffentlicht werden darf, welche Teile eines Datensatzes zugänglich gemacht werden können und wie FAIR-Prinzipien unter Bedingungen eingeschränkter Teilbarkeit umgesetzt werden können.
Als zentrale take-aways formulierte Kuhle, dass die Arbeit mit Social-Media-Daten technische, methodische sowie rechtlich-ethische Kompetenzen verlangt und häufig mit hohem Ressourcenaufwand bei zugleich fehlenden Unterstützungs- und Anreizstrukturen verbunden ist. FAIR-Prinzipien, Community-Standards und Forschungsdateninfrastrukturen erscheinen vor diesem Hintergrund nicht als nachgelagerte Formalia, sondern als Voraussetzung dafür, Social-Media-Daten transparenter, nachvollziehbarer und nachnutzbarer zu machen. Die Diskussion zeigte darüber hinaus, dass Metadatenstandards, Codeveröffentlichung und Dokumentationspraktiken bislang noch nicht einheitlich etabliert sind.
Philipp Knöpfle (LMU München) widmete sich mit Blick auf das Projekt „Meta-Rep“ der Reproduzierbarkeit und Replizierbarkeit computationaler Kommunikationsforschung. Anhand eines Literaturreviews zu mehreren hundert Studien zeigte er, dass Daten und Code in der CCS bislang nur selten systematisch geteilt werden. Besonders problematisch ist dies bei Plattformdaten, da sie sich oft nur schwer oder gar nicht replizieren lassen. Wenn Datenzugänge eingeschränkt sind, Plattformen Inhalte löschen oder Schnittstellen verändern, kann eine spätere Replikation schnell unmöglich werden.
Knöpfle unterschied dabei zwischen Reproduzierbarkeit und Replizierbarkeit und zeigte, dass beide Ziele unterschiedliche Anforderungen an Daten, Code und Dokumentation stellen. Selbst wenn Rohdaten aus rechtlichen oder praktischen Gründen nicht geteilt werden können, können Begleitmaterialien oder Metadaten durchaus hilfreich dabei sein, Studienergebnisse besser einzuordnen. Hierzu zählen die Veröffentlichung von Code, die Dokumentation der Datenerhebung, die Beschreibung von Samplingentscheidungen, die Offenlegung von Preprocessing-Schritten und die Angabe von Tools inklusive Parametern und Versionierung. In der Diskussion kam auf, dass die Wahl geeigneter Ablageorte ebenfalls eine praktische Frage ist. Während Plattformen wie The Open Science Framework (OSF) zum Zeitpunkt des Workshops vielen Forschenden niedrigschwelliger erschienen3, bieten institutionelle Git-Infrastrukturen andere Vorteile, setzen aber höhere technische Kompetenzen voraus.
Eine verbindende Klammer über die Beiträge im zweiten Panel hinweg war, dass Nachnutzbarkeit nicht zwingend vollständige Offenlegung aller Daten bedeutet. Gerade digitale Kommunikationsdaten sind häufig sensibel, rechtlich geschützt oder plattformabhängig. Umso wichtiger sind gestufte Zugangsmodelle, umfängliche und verständliche Dokumentation, sowie die Sicherung von Kontextinformationen. Auch nicht vollständig teilbare Korpora können wertvoll für die Forschung bleiben, wenn nachvollziehbar ist, wie sie entstanden sind, welche Analysen mit ihnen durchgeführt wurden und unter welchen Bedingungen andere Forschende daran anschließen können.
Vernetzte Kommunikationskorpora analysieren: Potenziale und Fallstricke
Das dritte Panel wurde von Kai Matuszkiewicz moderiert und richtete den Blick auf die Analyse vernetzter Kommunikationskorpora. Welche neuen Forschungsperspektiven entstehen, wenn digitale Kommunikationsdaten gut dokumentiert, referenzierbar und miteinander verknüpfbar sind? Und welche methodischen Voraussetzungen müssen erfüllt sein, damit großskalige, plattformübergreifende und KI-gestützte Analysen valide Ergebnisse liefern?
Marko Bachl (FU Berlin) eröffnete das Panel mit einem Beitrag zu Bias und epistemischen Konsequenzen für die CCS. Ausgangspunkt war ein statistisches Verständnis von Bias als systematischem Fehler, der von zufälliger Varianz zu unterscheiden ist. Der Bias-Variance-Tradeoff diente dabei als analytisches Raster, um Chancen und Risiken automatisierter Verfahren in der Kommunikationsforschung einzuordnen.
Am Beispiel von Large Language Models (LLMs) in der Inhaltsanalyse zeigte Bachl, dass automatisierte Verfahren neue Möglichkeiten eröffnen. So können sie beispielsweise nicht-textuelle Kommunikationsinhalte transkribieren, Inhalte extrahieren, große Stichproben klassifizieren und damit Analysen ermöglichen, die hand-codiert kaum durchführbar wären. Zugleich können sie die Reproduzierbarkeit erhöhen, weil dieselben Verfahren auf große Datenmengen konsistent angewendet werden können. Diese Reduktion von Varianz geht jedoch nicht automatisch mit einer Reduktion von Bias einher. Im Gegenteil: Automatisierte Verfahren können systematische Verzerrungen erzeugen oder verstärken, wenn Trainingsdaten, Modellarchitekturen, Prompts oder Validierungsmaßstäbe bestimmte Perspektiven privilegieren.
In der anschließenden Diskussion wurde dafür plädiert, dass die Bewertung von KI-gestützten Verfahren nicht abstrakt erfolgen kann. Entscheidend ist, welches Forschungsziel verfolgt wird, welcher Referenzmaßstab angesetzt wird und welche Formen von Fehlern in Kauf genommen werden wollen. Menschliche Codierungen sind dabei nicht automatisch ein unverzerrter Goldstandard, sondern selbst Ergebnis sozialer Umstände sowie methodischer und interpretativer Entscheidungen. Gerade deshalb braucht die CCS eine explizite Auseinandersetzung mit Validierung, Bias, De-Biasing und den epistemischen Annahmen automatisierter Analyseverfahren.
Felix Victor Münch (GESIS/HBI) knüpfte mit seinem Beitrag an die forschungspraktischen Potenziale von LLMs an. Im Zentrum stand die Frage, wie diese zur plattform-, medien- und sprachübergreifenden Verknüpfung von Kommunikationsdaten eingesetzt werden können. Münch zeigte anhand mehrerer Anwendungsbeispiele, dass LLMs nicht nur als dialogische Systeme verstanden werden sollten, sondern als Werkzeuge zur Strukturierung, Transformation, Klassifikation und Verknüpfung großer, heterogener Datenbestände.
Ein Beispiel bezog sich auf die plattformübergreifende Analyse von Kommunikation zu Klimawandel, Desinformation und rechtsextremen Diskursen. Hier wurden große Datenmengen über längere Zeiträume hinweg erhoben und mit Verfahren wie Embeddings, Clustering und Netzwerkanalysen ausgewertet. Ein weiteres Beispiel stellte die Analyse von politischer Kommunikation in TikTok-Videos dar. Semantische Ähnlichkeitsmodelle wurden genutzt, um Themenprofile, Nähebeziehungen und Kommunikationsstrukturen zwischen unterschiedlichen Akteur:innen sichtbar zu machen.
Die Beispiele zeigten anschaulich, welche analytischen Möglichkeiten entstehen können, wenn Daten aus unterschiedlichen Plattformen, medialen Formen und Sprachen in gemeinsame Repräsentationsräume überführt werden können. Dadurch werden Vergleiche möglich, die zuvor nur mit erheblichem manuellem Aufwand oder überhaupt nicht realisierbar waren. Zugleich zeigte Münch, dass solche Pipelines technisch und organisatorisch voraussetzungsreich sind. Sie erfordern Rechenressourcen, methodisches Know-how, sorgfältige Datenaufbereitung und Verfahren zur Qualitätskontrolle. LLMs können solche Prozesse perspektivisch vereinfachen, ersetzen aber nicht die Notwendigkeit, Datenkontexte, Modellentscheidungen und Bewertungskriterien transparent zu dokumentieren.
Jakob Jünger (Universität Münster) schloss das Panel mit einem Beitrag zu Normdaten und Knowledge Graphs als Grundlage für Sekundäranalysen. Sein Ausgangspunkt war die Frage, wie geistes- und sozialwissenschaftliche Arbeitspraktiken stärker miteinander verbunden werden können. Während klassische Nachweis- und Katalogsysteme Literatur, Daten oder Projekte auffindbar machen, erlauben sie meist keine strukturierte Abfrage wissenschaftlicher Aussagen, Beziehungen und Kontexte. Normdaten, kontrollierte Vokabulare, Ontologien und Knowledge Graphs können hier neue Formen der Vernetzung ermöglichen.
Jünger erläuterte Normdaten als Identifier, Vokabulare und Ontologien, die Entitäten eindeutig beschreibbar und miteinander verknüpfbar machen. Knowledge Graphs bilden solche Entitäten und ihre Beziehungen als Netzwerk ab. Als bekanntes Beispiel wurde Wikidata herangezogen. Für die Kommunikationswissenschaft skizzierte Jünger drei mögliche Beteiligungsformen: bestehende Datensätze können mit Normdaten angereichert werden, bestehende Wissensbestände können um neue fachlich relevante Entitäten erweitert werden, und fachnahe Infrastrukturen können eigene Knowledge Graphs aufbauen und betreiben.
Besonders relevant wurde diese Perspektive im Hinblick auf Interoperabilität. Daten werden nicht allein dadurch FAIR, dass sie irgendwo abgelegt werden. Sie müssen auffindbar, zugänglich, interoperabel und nachnutzbar beschrieben sein. Für die Kommunikations- und Medienwissenschaft eröffnet dies erhebliche Potenziale. Forschungsprojekte, Datensätze, Publikationen, Tagungsbeiträge, Personen, Institutionen, Quellen, Methoden und Untersuchungsgegenstände könnten miteinander verknüpft werden. Damit würde nicht nur die Recherche verbessert, sondern auch die Grundlage für Sekundäranalysen, fachgeschichtliche Auswertungen und neue Formen der Wissensrepräsentation geschaffen.
Das dritte Panel zeigte insgesamt, dass vernetzte Kommunikationskorpora große Analysepotenziale eröffnen können. LLMs, computationale Methoden, Normdaten und Knowledge Graphs ermöglichen neue Perspektiven auf Kommunikationsdynamiken über Plattform-, Medien-, Sprach- und Zeitgrenzen hinweg. Zugleich wurde sichtbar, dass diese Potenziale sich nur dann in wissenschaftlich belastbare Ergebnisse verwirklichen lassen, wenn Datenqualität, Validierung, Interoperabilität, Dokumentation und Bias systematisch reflektiert werden.
Fünf zentrale Erkenntnisse des Workshops
Über alle drei Panels hinweg zog sich der Befund, dass digitale Kommunikationskorpora keine bloßen Sammlungen neutraler Daten sind. Sie entstehen durch soziale, rechtliche, wissenschaftliche, technische und ethische Entscheidungen sowie durch die Bedingungen ihrer Erhebung, Verarbeitung und Aufbereitung. Ihre Qualität bemisst sich daher nicht allein an Umfang oder technischer Verfügbarkeit, sondern an der Nachvollziehbarkeit ihrer Entstehung, Prozessierung und Kontextualisierung.
Eine zweite zentrale Erkenntnis war, dass diese Bedingungen der Datenentstehung systematischer dokumentiert werden müssen. Dazu gehören Plattformbedingungen, Zugangspfade, Samplingentscheidungen, Löschungen und Ausschlüsse, fehlende Daten, Anonymisierungsschritte, Metadatenverluste und ethische Abwägungen. Gerade bei Daten aus sozialen Medien, Datenspenden oder digitalisierten Quellen ist entscheidend, welche Teile der Kommunikation sichtbar werden, welche unsichtbar bleiben und wie diese Einschränkungen der Datenbasis nachvollziehbar gemacht werden können.
Drittens zeigte sich, dass Nachnutzung nicht mit vollständiger Offenheit gleichgesetzt werden darf. Viele digitale Kommunikationsdaten können aus guten Gründen nicht frei zugänglich gemacht werden. Trotzdem können sie durch beschreibende Metadaten, Code, Dokumentationen, Analyseprotokolle, kontrollierte Zugangsmodelle oder Verweise auf geeignete Kontaktstellen wissenschaftlich anschlussfähig bleiben.
Viertens wurde die Bedeutung von Interoperabilität sichtbar. Wenn Forschungsdaten, Publikationen, Projekte, Personen, Institutionen, Quellen und Methoden isoliert voneinander dokumentiert werden, bleiben viele Anschlussmöglichkeiten ungenutzt. Entitätenbasierte Modelle, Normdaten und Knowledge Graphs können dazu beitragen, Forschungsergebnisse nicht nur abzulegen, sondern in fachliche Zusammenhänge durch die Nutzung von Semantic-Web-Anwendungen einzubetten.
Eine fünfte zentrale Erkenntnis liegt darin, dass Infrastrukturen nicht erst am Ende des Forschungsprozesses relevant werden. Sie können bereits in der Planungsphase helfen, Datenerhebungen besser zu koordinieren, rechtliche und ethische Fragen frühzeitig zu klären, Dokumentationsstandards mitzudenken und spätere Nachnutzung vorzubereiten.
Perspektiven für die Arbeit des FID Media
Für den FID Media ergaben sich aus dem Workshop mehrere konkrete Handlungsfelder, die bereits in der von Lukas Hohendorf moderierten Abschlussdiskussion aufgegriffen wurden und in der weiteren strategischen Entwicklung geprüft und mit der Fachcommunity vertieft werden sollen.
Ein erstes mögliches Handlungsfeld liegt in der Entwicklung fachspezifischer Dokumentationsvorlagen für digitale Kommunikationskorpora. Diese sollten gemeinsam mit Forschenden erarbeitet werden und unterschiedliche Datentypen berücksichtigen: Plattformdaten, Chatdaten, journalistische Inhalte, audiovisuelle Materialien, digitalisierte Quellen und multimodale Korpora. Solche Vorlagen könnten Mindestangaben zu Datenherkunft, Erhebungswegen, Sampling, Plattformbedingungen, Preprocessing, Versionierung, Anonymisierung, rechtlichen Grundlagen und Nutzungsrechten, Zugangsbedingungen und möglichen Verzerrungen enthalten. Ziel wäre keine zusätzliche Bürokratie, sondern eine praxistaugliche Unterstützung für Forschende, die ihre Daten nachvollziehbar und nachnutzbar dokumentieren möchten. In der Entwicklung derartiger Vorlagen liegt eine Zusammenarbeit mit NFDI-Konsortien nahe, wie sie bereits in der Vergangenheit gepflegt wurde, insbesondere mit dem von NFDI4Culture, Text+, BERD@NFDI und KonsortSWD getragenen Arbeitskreis Social Media-Daten in der Forschungspraxis.
Ein zweites Handlungsfeld betrifft den Aufbau einer fachnahen Nachweis-, Register- und Vermittlungsinfrastruktur für digitale Kommunikationskorpora. Ein solches Angebot könnte geplante, laufende und abgeschlossene Korpusvorhaben in der Kommunikations- und Medienwissenschaft sichtbar machen: Welche Projekte erheben oder nutzen Daten zu welchen Plattformen, Quellen, Zeiträumen und Themen, mit welchen Methoden und unter welchen Zugangsbedingungen? Besonders vielversprechend wäre dabei eine Funktion für geplante Datenerhebungen. Forschende könnten Vorhaben frühzeitig eintragen, wodurch sich Kooperationsmöglichkeiten erkennen lassen, bevor Daten mehrfach, inkompatibel oder unter hohem Aufwand parallel erhoben werden. Zugleich könnte der FID Media abgeschlossene Projekte, Datensätze, Publikationen, Codebooks, Präsentationen, Personen, Einrichtungen, Methoden und Einträge in externen Repositorien fachlich erschließen und miteinander verknüpfen. Der FID Media müsste dafür nicht alle Daten selbst speichern, sondern Daten könnten dort öffentlich publiziert, archiviert oder kontrolliert zugänglich gemacht werden, wo die jeweils geeigneten technischen und rechtlichen Voraussetzungen bestehen. Der FID Media könnte durch ein zentrales Forschungsregister ergänzend dafür sorgen, dass diese Ressourcen für die Kommunikations- und Medienwissenschaft sichtbar, verständlich kategorisiert und mit weiteren fachlichen Informationen verknüpft werden. Das entitätenbasierte Modell des Repositoriums des FID Media bietet hierfür eine vielversprechende Grundlage und könnte perspektivisch einen Beitrag zu potenziellen fachlichen Wissensgraphen der Kommunikations- und Medienwissenschaft leisten.
Ein drittes Handlungsfeld besteht in der Weiterentwicklung von Beratung und Vernetzung von Forschenden mit Infrastrukturen. Der Workshop zeigte, dass Forschende bei digitalen Kommunikationskorpora regelmäßig mit rechtlichen, ethischen und technischen Fragen konfrontiert sind: Was darf erhoben werden? Was darf gespeichert, geteilt oder veröffentlicht werden? Welche Teile eines Datensatzes können offen zugänglich sein, welche nur kontrolliert, welche gar nicht? Welche Dokumentation ist sinnvoll, wenn Daten nicht geteilt werden können? Hier prüft der FID Media, in seinen bestehenden Beratungsangeboten, etwa zu Urheberrecht, Open Access, Open Science und Forschungsdatenmanagement, noch stärker die spezifischen Bedarfe digitaler Kommunikationsforschung zu berücksichtigen.
Fazit
Der Workshop hat gezeigt, dass die Frage „Was bleibt von digitalen Kommunikationskorpora?“ nicht erst nach Projektende gestellt werden sollte. Sie beginnt bereits bei der Auswahl von Quellen, Plattformen und Zugängen, setzt sich in Sampling, Datenerhebung, Datenbereinigung und Analyse fort und reicht bis zur Publikation, Archivierung und späteren Nachnutzung. Digitale Kommunikationskorpora sind nur dann langfristig wissenschaftlich wertvoll, wenn ihre Entstehungsbedingungen, ihre Einschränkungen und ihre Nutzungskontexte nachvollziehbar bleiben.
Für die Kommunikations- und Medienwissenschaft ergibt sich daraus eine doppelte Herausforderung. Einerseits eröffnen digitale Korpora neue Forschungsperspektiven, etwa auf schwer zugängliche Kommunikationsräume, langfristige Medienentwicklungen, plattformübergreifende Diskurse oder multimodale Kommunikationsdynamiken. Andererseits entstehen neue Anforderungen an Quellenkritik, Datenethik, Dokumentation, Reproduzierbarkeit, Interoperabilität und Infrastrukturen.
Der FID Media nimmt aus dem Workshop den Auftrag mit, diese Fragen gemeinsam mit der Fachcommunity weiterzuverfolgen. Ziel ist es, digitale Kommunikationskorpora nicht nur als projektgebundene Datensammlungen zu betrachten, sondern als potenziell vernetzte Forschungsressourcen, die zukünftige Forschung vorbereiten, erleichtern und sichtbar machen können. Entscheidend wird sein, hierfür niedrigschwellige, fachnahe und zugleich methodisch passende Angebote zu entwickeln. Diese reichen von der Beratung in der Planungsphase über Standards in der Dokumentation und der Registrierung laufender Vorhaben bis hin zur Unterstützung bei der Publikation, Verzeichnung und Vernetzung abgeschlossener Projekte.
Der Workshop hat damit den Blick weg vom einzelnen Korpus hin auf die Voraussetzungen seiner wissenschaftlichen Anschlussfähigkeit gelenkt. Für Open Science in der Kommunikations- und Medienwissenschaft folgt daraus, dass nicht allein entscheidend ist, ob Daten veröffentlicht werden können, sondern ob ihre Herkunft, Reichweite, Einschränkungen und Beziehungen so beschrieben sind, dass sie in der Forschungscommunity weitergedacht, geprüft und kombiniert werden können. Hierin liegt die künftige Infrastrukturaufgabe, die Kommunikations- und Medienwissenschaft darin zu unterstützen, aus verstreuten Projektspuren einen übersichtlichen und möglichst vollständigen Orientierungsraum zu schaffen, in dem neue Forschung nicht immer wieder bei null beginnen muss, sondern auf bereits geleistete Aufwände und vorhandene Erkenntnisse aufbauen und bestehende Ergebnisse produktiv nachnutzen kann.
1 In der Diskussion wurde außerdem die öffentliche Verfügbarkeit der Daten unter ethischen Gesichtspunkten zur Debatte gestellt, da sie sich als Trainingsmaterial für böswillige Chatbotbetreibende eignen würden.
2 Wilkinson, M., Dumontier, M., Aalbersberg, I. et al. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data 3, 160018. https://doi.org/10.1038/sdata.2016.18
3 Anmerkung: Nach dem Workshop kündigte das Center for Open Science an, den Bereich OSF Projects wegen fehlender Finanzierung auslaufen zu lassen, so dass ab November 2026 keine neuen Projekte mehr angelegt werden können. Diese Entwicklung zeigt, dass Open Science nicht allein niedrigschwellige Werkzeuge, sondern wissenschaftsgeleitete, institutionell fest verankerte und dauerhaft finanzierte Infrastrukturen benötigt, um die langfristige Verfügbarkeit von Forschungsinhalten sicherstellen und die FAIR-Prinzipien umzusetzen.
Der Text dieses Beitrags steht unter der Lizenz Creative Commons Namensnennung 4.0 International (CC BY 4.0). Die Abbildungen sind von dieser Lizenz ausgenommen; alle Rechte vorbehalten.
Veranstaltung: „Interdisziplinäre Qualifikationsarbeiten betreuen“
HERMES-Podiumsdiskussion mit Prof. Dr. Anna Neovesky, Dr. Shumon T. Hussain und Dr. Anna Froese
Wie gelingt die Betreuung interdisziplinärer Arbeiten in den digitalen Geistes- und Kulturwissenschaften? Was bedeutet Interdisziplinarität in den Digital Humanities? Und welche Chancen und Risiken bergen interdisziplinäre Ansätze für den Karriereweg der Absolvent*innen? Diese und weitere Fragen diskutieren drei Expert*innen aus verschiedenen Disziplinen. Erfolgreiche Ansätze von der Themenfindung über die Methodenintegration bis hin zur Bewertung können so in die eigene Betreuungspraxis integriert werden.
Datum: 17.09.2026
Uhrzeit: 18:00 – 19:30 Uhr
Ort: Zoom
Anmeldung: Bitte registrieren Sie sich über folgenden Link für die Veranstaltung: https://tu-darmstadt.zoom-x.de/meeting/register/2JvcIoveSLuMaOnQZLVkPQ
Weitere Informationen unter: https://hermes-hub.de/aktuelles/events/betreuenden-ws-interdisziplinarit%C3%A4t-2026-09-17.html
Die Veranstaltung ist Teil der HERMES-Reihe „Betreuungskompetenz gezielt stärken: Chancen und Herausforderungen in den digitalen Geistes- und Kulturwissenschaften“, die sich insbesondere an Betreuende von Qualifikationsarbeiten richtet und gemeinsam von der Technischen Universität Darmstadt und der Universität Trier organisiert wird.
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- DH2026 DAEJEON, SÜDKOREA • Engagement zwischen Schnittmuster, Daten und 3D Garment Reconstruction
DH2026 DAEJEON, SÜDKOREA • Engagement zwischen Schnittmuster, Daten und 3D Garment Reconstruction
Dank des Reisestipendiums der DHd durfte ich diesen Sommer zur DH2026 nach Daejeon, Südkorea, reisen. Da ich zurzeit an der Schwelle zwischen Masterarbeit und Konzeption meines Promotionsprojektes stehe, war die Konferenz für mich eine transformative Erfahrung: eine Woche voller interdisziplinärer Impulse, wertvollem Fachfeedback und neuer internationaler Perspektiven, alles unter dem diesjährigen Fokus „Engagement“.
Hands-on: Die ersten Konferenztage
Der Auftakt der Konferenz bestand wie üblich aus Workshops und Minikonferenzen, die für mich ganz im Zeichen des praktischen Ausprobierens und des methodischen Querdenkens standen. Durch meinen Hintergrund in Medienwissenschaften/Medieninformatik habe ich besonders Gefallen an Workshops/Minikonferenzen gefunden, die Visualisierung und interaktive Medienformen aufgriffen.
So bot mir bereits am ersten Tag der Workshop zu IIIF-Tools von Glen Robson und Martin Kalfatovic direkte Anwendungsmöglichkeiten für die eigene Forschungspraxis. Ein besonderes Highlight für mich folgte jedoch direkt im Anschluss beim Brainstorming & Prototyping für Educational Games mit Sophia Booij und Nellie Seale. Das metaphorische „toying with ideas“ zeigte nachdrücklich, wie Fachinhalte und Informationen für unterschiedliche (schwierige) Zielgruppen zugänglich gemacht und methodisch aufgearbeitet werden können.
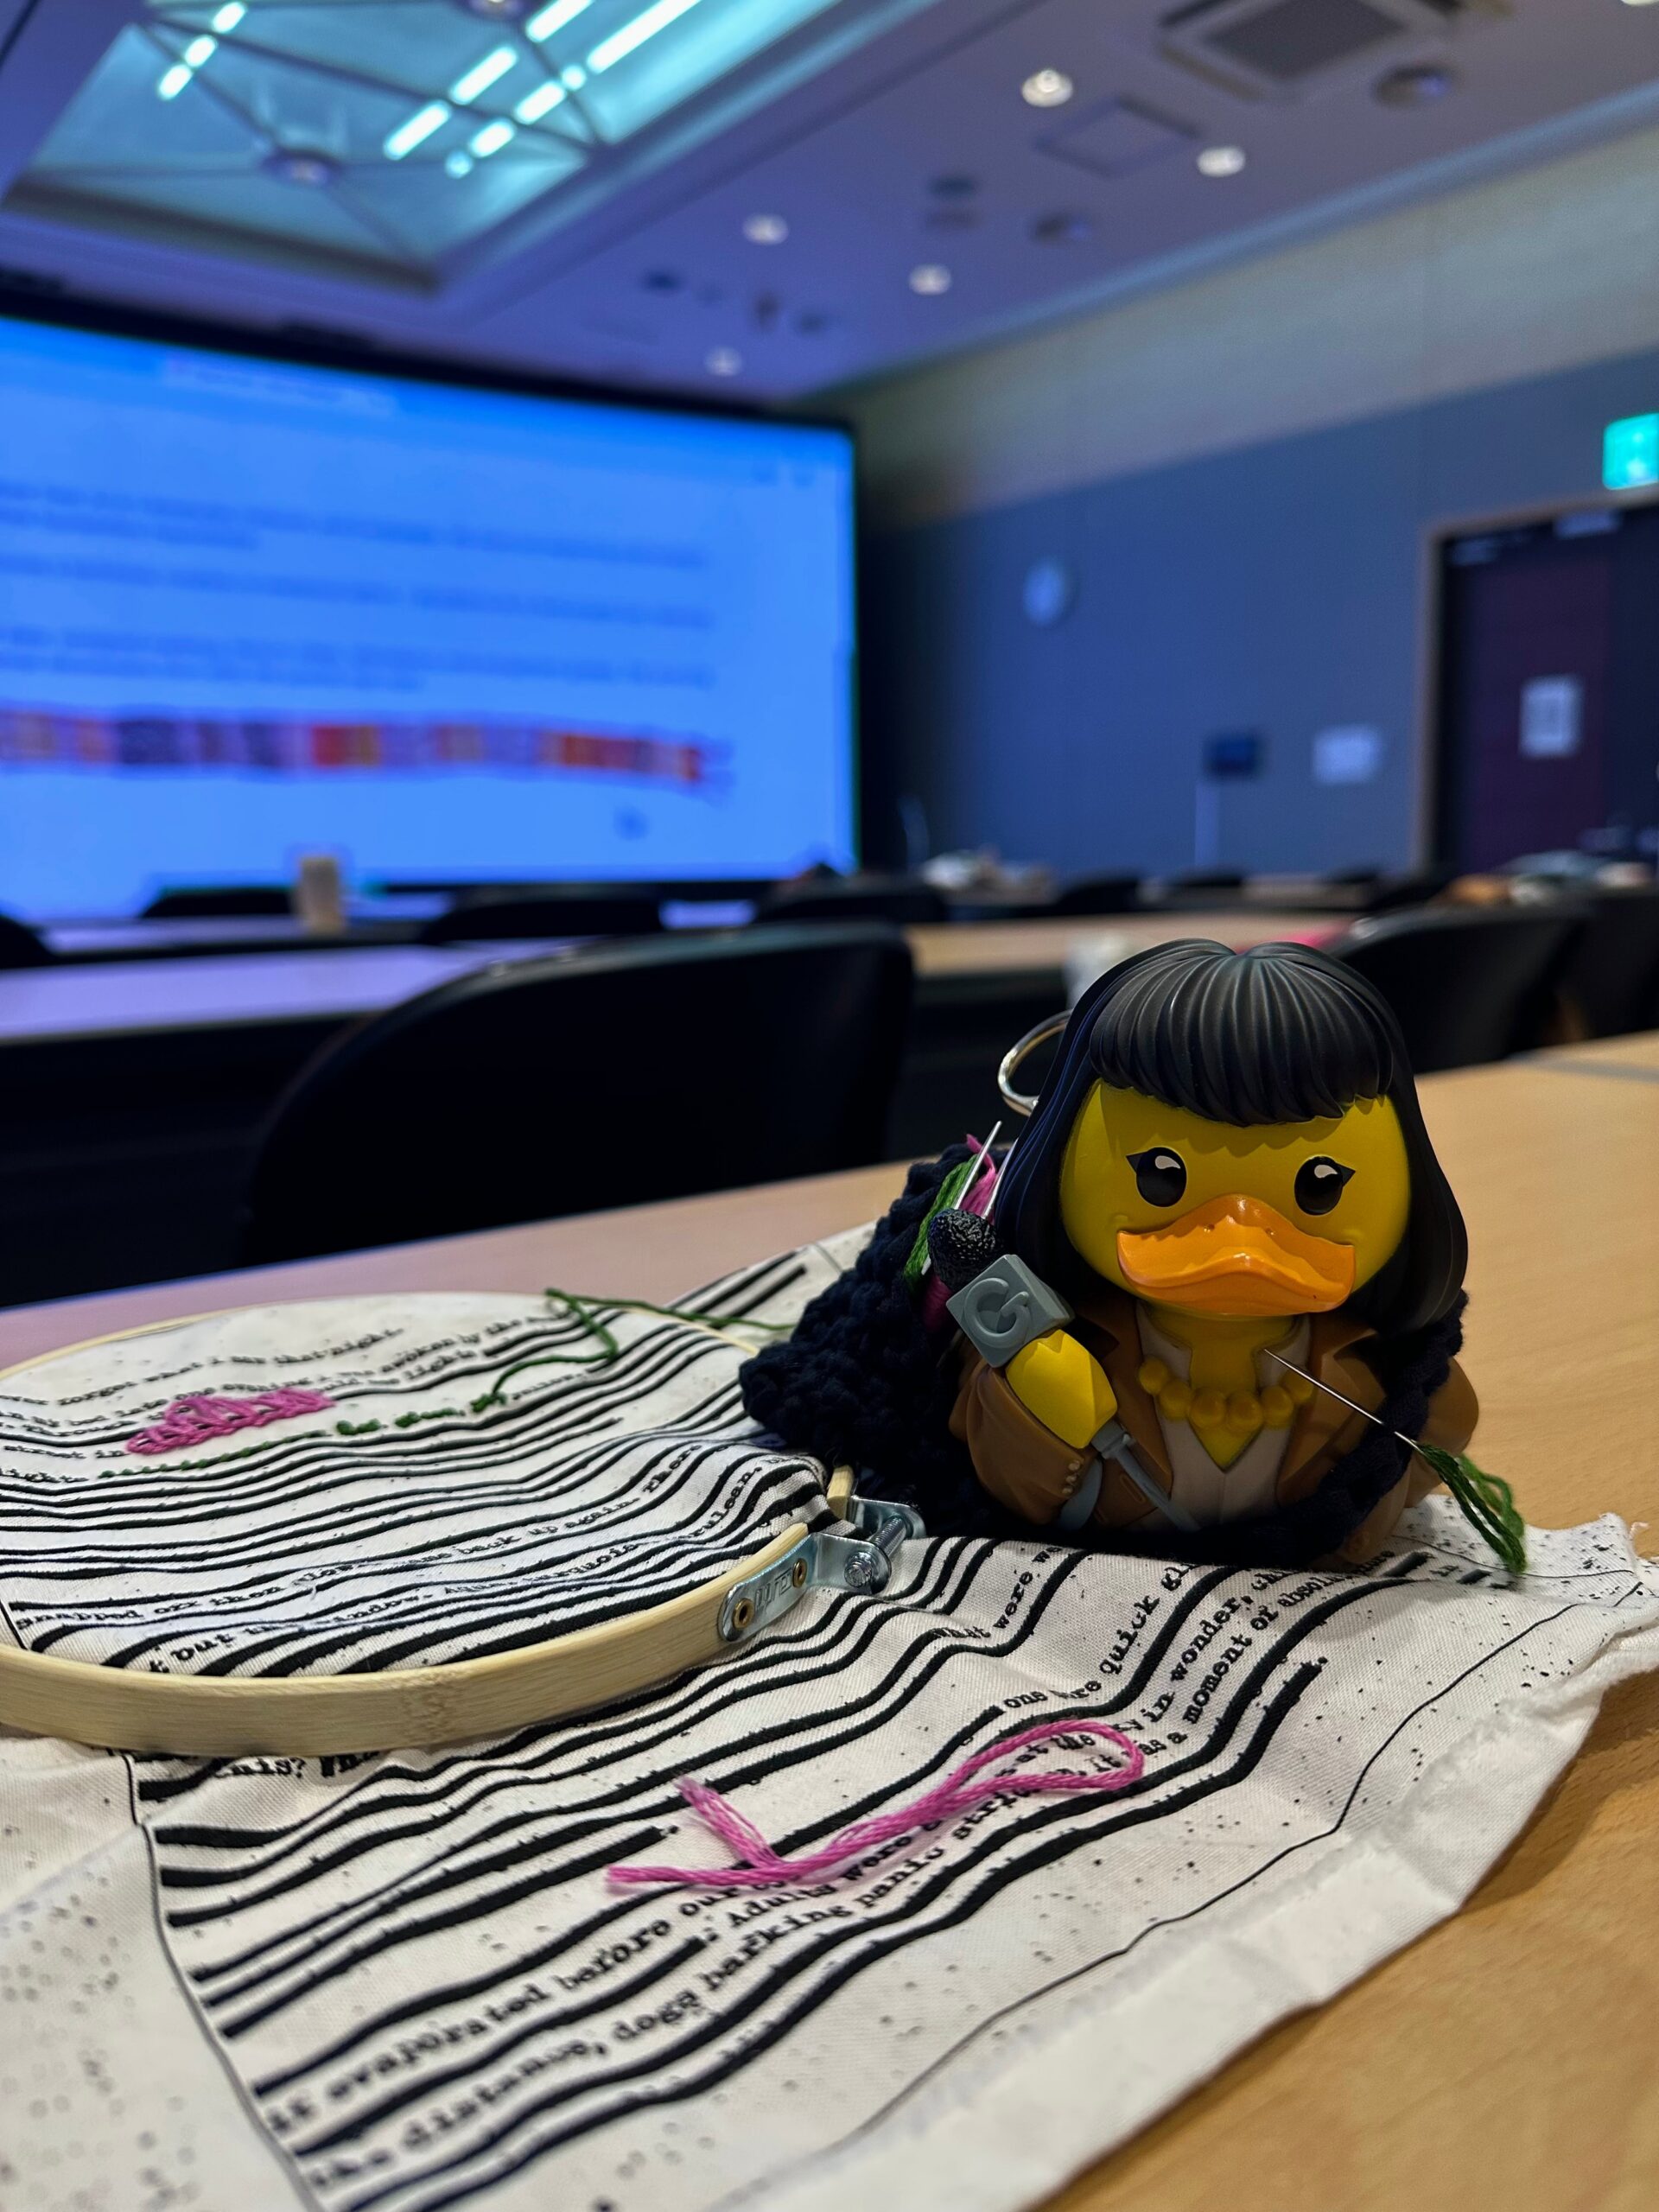
Ähnlich verhielt es sich am zweiten Tag in der Minikonferenz „#DHMakes: Embodied Craft as Critical Engagement“. Das Verknüpfen von klassischem Handwerk und textiler Kunst mit Datenvisualisierung eröffnete für mich neuartige Zugänge der Interaktion: Die Übersetzung von Daten in das Haptisch-Physische verändert grundlegend, wie wir uns mit Inhalten auseinandersetzen können. Da ich mich im Digitalen viel mit textiler Kunst auseinandersetze, sprach mich hier die Minikonferenz besonders an.
Digital Fashion als Forschungsmethode: Mein Beitrag auf der DH2026
Der Kern meiner Reise war die Präsentation meines Konferenzbeitrags am dritten Tag. Vorgestellt habe ich das Paper „From 2D sewing patterns to dynamic 3D models: documenting cultural heritage in digital fashion.“, welches ich in Zusammenarbeit mit meinem Co-Autor Prof. Dr. Øyvind Eide eingereicht habe. Das Paper fokussiert sich auf ein in den Digital Humanities bislang stark unterrepräsentiertes Themenfeld: die Erforschung und Dokumentation von Kleidung als materielles und immaterielles Kulturerbe.
Der Erhalt von Kleidung als materielles Kulturerbe und damit die Dokumentation von Fashion, oder auch Mode, als immaterielles Kulturerbe, steht in enger Abhängigkeit von der Minimierung des materiellen Zerfalls von Textilien. Entsprechende Aufbewahrungsrichtlinien schränken dadurch jedoch die Rezipierbarkeit der Kleidung in ihrem ursprünglichen Kontext stark ein. Einflüsse wie Gravitation, Bewegung und das Gefühl des Stoffes, sowie das Binden, Knoten oder Layering von Kleidung gehen hier nahezu oder vollständig verloren.
Unsere reproduzierbare Methodik der digitalen Rekonstruktionen basiert auf 2D-Schnittmustern und transformiert diese zu dynamischen 3D-Kleidungssimulationen, welche dabei nicht nur als Erkundung der Beziehung zwischen Schnittmustern, Kleidungsstücken und dem Digital Fashion Object dienen, sondern auch eine direkte Simulation darstellen, wie wir Kleidung tragen und herstellen.
Da diese Forschung auf meiner Masterarbeit aufbaut und das Fundament meines geplanten PhD-Projektes bildet, war der direkte Austausch vor Ort von hohem Wert für mich. Das konstruktive Feedback aus unterschiedlichen Disziplinen und kulturellen Kontexten hat mir wichtige Impulse in Sachen 3D-Modellierung, Verbindungen mit Game Studies und die Einbettung in das Digital Cultural Heritage geliefert. Die aufschlussreichen Diskussionen verankerten unsere theoretische Arbeit in der Modelltheorie und der Intermedialität und unterstrichen gleichzeitig die Bedeutung der Forschung. Die Verbindung zu der globalen Community hat meine wissenschaftliche Perspektive zutiefst bereichert und mich für die nächste Phase meines akademischen Weges inspiriert. Nicht nur durch Feedback, sondern auch durch neue Kontakte.
Austausch und Nachwuchsperspektive
Neben den wissenschaftlichen Panels lebte die DH2026 von der warmen Gastfreundschaft und dem lebendigen Austausch bei der Poster-Session, den Coffee Breaks oder dem Konferenzbankett. ![]()
Die Teilnahme an der DH2026 hat noch einmal meinen Horizont hinsichtlich der Vielfältigkeit der Digital Humanities erweitert. Auch wenn mir diese Vielfalt vorher schon bewusst war, ist das Erleben der Bandbreite an unterschiedlichen Forschungsfeldern, Interessen und kreativen Anwendungsansätze sehr aufschlussreich für mich gewesen. Vor allem aber hat die Vielfältigkeit mich dazu angeregt, mich weiterhin mit unterschiedlichen Medientypen auseinanderzusetzen und verschiedene Formen der Visualisierung, Modellierung und Dokumentation stetig kritisch zu reflektieren. Was langfristig meine eigene akademische Praxis beeinflussen wird.
Besonders gefallen hat mir unter anderem der Beitrag „Where War Lived“ von Liam Isaac Downs-Tepper und dessen Einblicke in Photogrammetry oder die Keynote von Maciej Eders als Antonio Zampolli-Preisträger, die ganz unter dem Motto stand: „All you need is a coffee machine and a couch!“.
Die DH2026 hat mir gezeigt, dass „Engagement“ für mich nicht nur die aktive Teilnahme an einer Konferenz bedeutet. Es bedeutet auch, sich auf neue Methoden einzulassen, Forschung über Disziplingrenzen hinweg zu denken und Teil einer internationalen wissenschaftlichen Gemeinschaft zu werden.
Meine Erfahrung auf der DH2026 habe ich ebenfalls in einer Live-Dokumentation über meinen Mastodon-Account (https://fedihum.org/@lpascale) geteilt. Auch hier war ich begeistert von der schnellen Aufnahme in die Community, die mich und meine Reporterquietscheente mit offenen Armen empfangen hat.
Fazit & Dank
Die DH2026 in Daejeon war geprägt von inspirierenden Keynotes, informativen Vorträgen und bereichernden Begegnungen. Der Tagungsabschluss hat verdeutlicht, wie essenziell der persönliche Kontaktaufbau für Forschende ist. Mein herzlicher Dank gilt meinem Co-Autor Prof. Dr. Øyvind Eide, den Organisator*innen vor Ort sowie insbesondere der DHd für die finanzielle Unterstützung durch das Reisestipendium. Ohne diese Unterstützung wäre diese wertvolle Erfahrung für mich nicht möglich gewesen!
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Die nächsten Termine für das Lunch&Learn zur digitalen Kunstgeschichte 2026
Die nächsten Termine für das Lunch&Learn zur digitalen Kunstgeschichte 2026
Seit nun einem Jahr gibt es das Online-Format des Arbeitskreises Digitale Kunstgeschichte: „Lunch&Learn zur digitalen Kunstgeschichte“ – eine monatliche digitale Mittagspause zu Fragen und Themen rund um die digitale Kunstgeschichte.
FORMAT: Einstieg (5 Min) – Impulsvortrag (10 Min) – Diskussion (15 Min) – Helpdesk & Tipps (15 Min)
In diesem Jahr haben wir nach der Sommerpause folgende interessante Termine für Euch geplant.
7. August 2026: Sommerpause
4. September 2026, 13:00 Uhr:
ProNto – Provenienzforschung-Navigator
Angela Berthold (Münzkabinett Berlin, NFDI4Objects), Gabriele Zöllner (Humboldt-Universität zu Berlin, SODa)
2. Oktober 2026: Entfällt, dafür findet die Prometheus-Tagung statt.
6. November 2026, 13:00 Uhr:
Mittelalterliche Glasmalerei inventarisieren – Methoden der digitalen Objekterschließung im Projekt Corpus Vitrearum Medii Aevi Deutschland
Stephanie Schüler (CVMA Potsdam)
4. Dezember 2026, 13:00 Uhr:
Digitale Objektbiografien modellieren
Sarah Wagner (Friedrich-Alexander-Universität Erlangen-Nürnberg, NFDI4Objects)
Für wen ist diese Veranstaltung? Neugierige Menschen mit einem Interesse an Kunstgeschichte und Digitalität sind sehr herzlich eingeladen.
Hier ist der ZOOM-Link, der für alle Lunch&Learns gilt: https://us02web.zoom.us/j/84286572737?pwd=VrT2D61m8S2g1CCD6QlD3qVVgy8yCL.1.
Daher einfach in der Mittagspause dazu schalten, wir freuen uns auf Euch!
Women Playwrights in Digital Corpora: a DraCor Hackathon
Literary historians maintain that women have never contributed significantly to the German drama. Facts, however, point clearly to the opposite. Indeed, the first known German dramatist (10th century) was a woman! Two major causes for the lack of historic recognition are: (a) prejudice that women are incapable of good dramatic production, (b) underrating of plays because professional critics—traditionally men—have used male psychology as the criterion for judging female characters in plays by women. A revaluation of women’s contributions to drama is imperative.
(Scholtz Novak 1972, 47)
When the German-born American scholar of German literature Sigrid Scholtz Novak issued her call for greater recognition of women playwrights in the early 1970s, she was responding to a literary historiography that had either largely overlooked women’s extensive dramatic production or fundamentally questioned its aesthetic and historical significance. More than five decades later, scholarly engagement with women playwrights has expanded considerably. Nevertheless, the problem of accessibility identified by Scholtz Novak remains unresolved. Many plays by women are still available only in historical print editions, are dispersed across libraries and archives, or are absent from the digital text collections that increasingly underpin literary-historical scholarship and computational research.
Within the Digital Humanities, accessibility entails more than the provision of a digital surrogate. For literary works to be discoverable, systematically analysable, and reusable across different research contexts, they must be represented in structured and interoperable formats, documented with reliable metadata, and integrated into sustainable research infrastructures. Digital corpora therefore are not neutral representations of literary history. Their composition reflects historical processes of publication, preservation, canon formation, scholarly reception, selection, and digitisation. As a result, works by women remain substantially underrepresented in many digital collections.
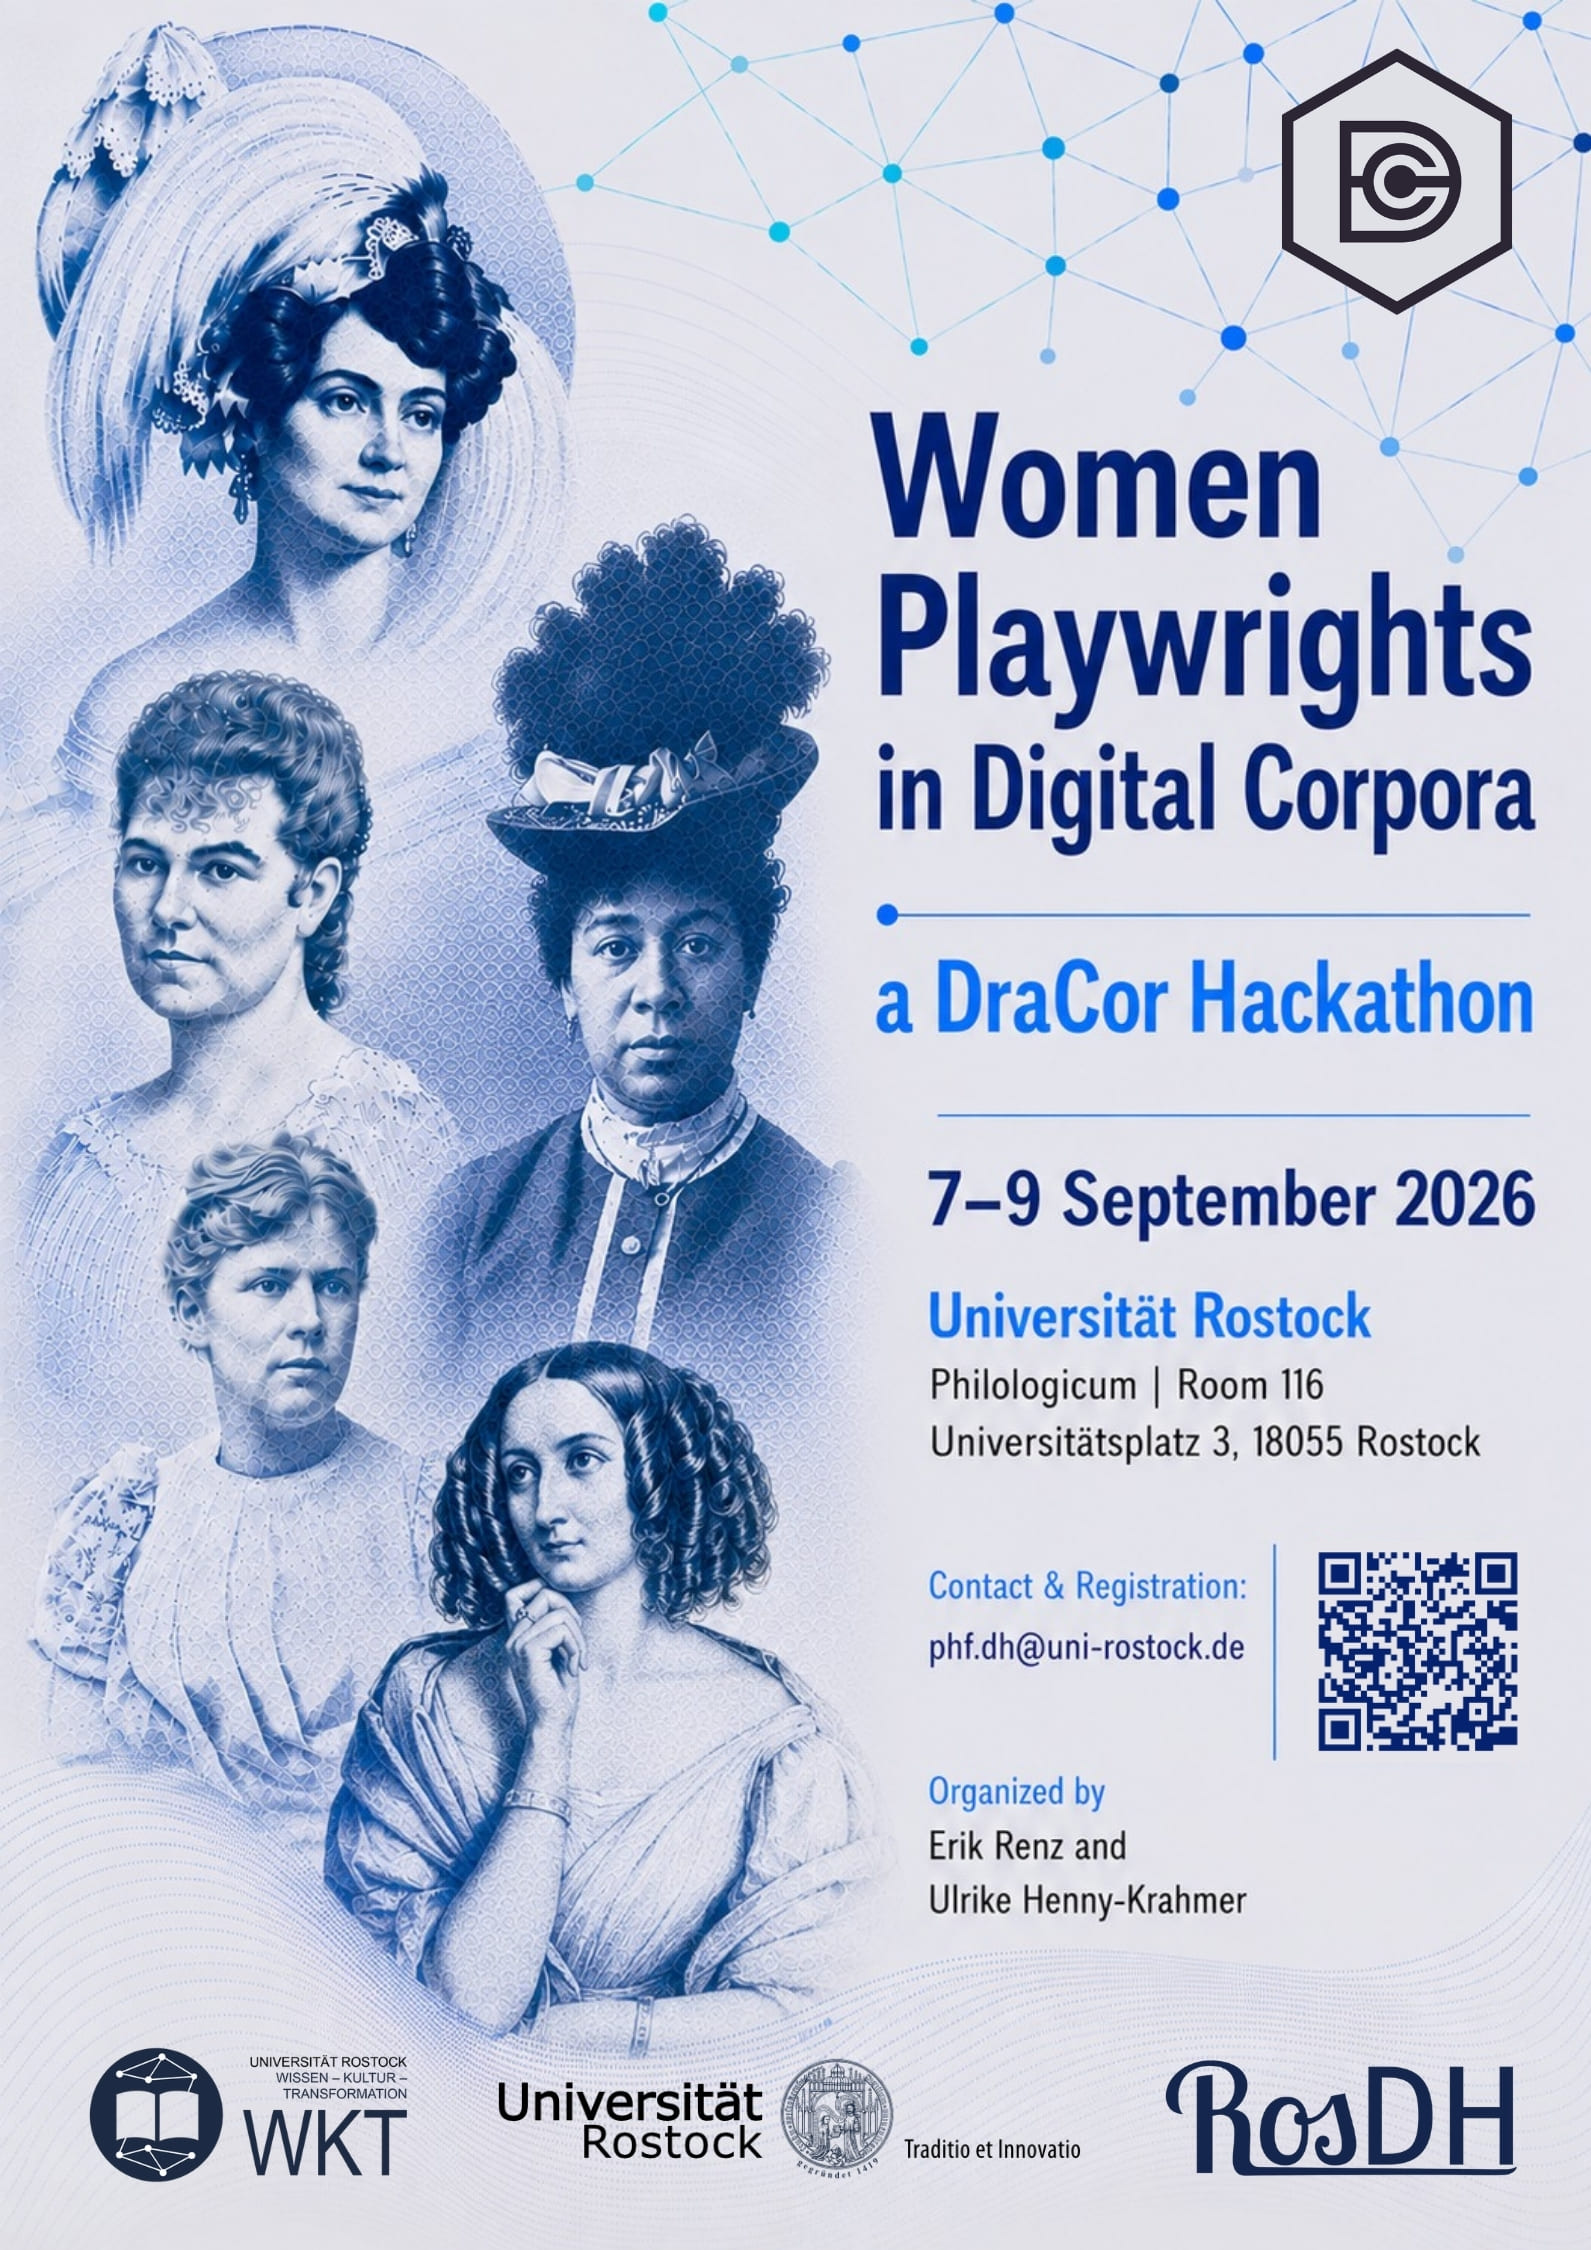
Against this background, the University of Rostock will host the hackathon Women Playwrights in Digital Corpora from 7 to 9 September 2026. The event will address both the digital representation and computational analysis of plays by women, with particular attention to their integration into the DraCor research infrastructure.
DraCor (short for Drama Corpora) is an open and multilingual research infrastructure for the computational study of drama from antiquity to the twentieth century. Its corpora are encoded according to the guidelines of the Text Encoding Initiative (TEI) and made available through a web interface and an application programming interface (API). DraCor currently comprises 33 drama corpora containing more than 4,000 annotated full-text plays in 24 languages. As a community-driven project committed to open-science principles, it supports a broad international research landscape in computational drama analysis and theatre history.
About the Hackathon
The hackathon will take place in Rostock from 7 to 9 September 2026. Hosted by the Professorship for Digital Humanities at the University of Rostock, the three-day event will bring together researchers from computational literary studies, cultural analytics, digital scholarly editing, theatre studies, and related fields.
The program will combine introductory training sessions on encoding dramatic texts in TEI and working with DraCor data with scholarly presentations, collaborative working sessions, and discussion formats. During the working sessions, participants may either pursue projects of their own or contribute to prepared thematic work packages.
Program
Monday, 7 September 2026
13:00–13:15 |
Welcome and Introduction |
13:15–14:45 |
Beginners’ Training Session I: From Dramatic Text to DraCor TEI Tutors: Julia Jennifer Beine and Aşina A. Yıldız (both Würzburg) |
14:45–15:15 |
Coffee Break |
15:15–16:45 |
Beginners’ Training Session II: Analyses with DraCor Data Tutor: Frank Fischer (Berlin) |
16:45–17:15 |
Coffee Break |
17:15–18:45 Hybrid session On-site and online No registration required. |
Keynote Speaker: Cristian A. Aravena (Santiago de Chile) |
19:30 |
Informal Dinner |
Tuesday, 8 September 2026
09:00–10:30 Hybrid session No registration required. |
State of the Art: Women Playwrights in Digital Corpora Speaker 1: Anna Axtner-Borsutzky (Munich) (Lost in Archives) Speaker 2: Lou Klappenbach (Berlin) (Gender & Data) Speaker 3: Marius Hug (Berlin) |
10:30–11:00 |
Coffee Break |
11:00–12:30 |
Collaborative Working Session I |
12:30–13:30 |
Lunch Break |
13:30–15:00 |
Collaborative Working Session II |
15:00–15:30 |
Coffee Break |
15:30–17:00 |
Battle of the Plays World Championship 2026 |
Wednesday, 9 September 2026
09:00–10:30 |
Collaborative Working Session III |
10:30–11:00 |
Coffee Break |
11:00–12:00 |
Round Table Discussion |
12:00–12:30 |
Closing Remarks |
The hackathon is conceived as an open and collaborative environment for exploring methodological and practical questions relating to digital drama analysis, text encoding, corpus development, metadata modelling, and data enrichment. Rather than focusing exclusively on completed research results, the event invites participants to develop and test new approaches, exchange expertise, and collaborate on concrete textual and data-based materials. Possible topics may include:
- the encoding, documentation, and enrichment of plays by women;
- the integration of new plays into existing or newly established DraCor corpora;
- the digital modelling and analysis of characters and gendered patterns of representation;
- the computational analysis of character networks, speech distribution, scene structures, and stage directions;
- comparative analyses across languages, historical periods, dramatic genres, and theatrical traditions;
- the reconstruction of reception and transmission networks through authority data and linked open data;
- the development of methods for linking plays, authors, characters, performances, translations, adaptations, and other forms of reception.
The event is open both to participants with previous experience of DraCor or TEI and to interested newcomers. No prior technical knowledge is required.
Registration
The event will take place on site at the University of Rostock. Participation is free of charge and limited to 35 participants. To register, please send an email to phf.dh@uni-rostock.de. When registering, please indicate whether you would also like to attend either or both of the following accompanying events:
- Monday, 7 September 2026, from 7:30 p.m.: Informal dinner at L’Osteria Rostock. Participants are responsible for covering their own expenses.
- Tuesday, 8 September 2026, 3:30–5:00 p.m.: Battle of the Plays World Championship 2026
While the event will generally take place on site, the Opening Keynote on Monday, 7 September, and the session “State of the Art: Women Playwrights in Digital Corpora” on Tuesday, 8 September, will be held in a hybrid format. Interested participants may attend either program item in person or online. No registration is required for either program point.
Venue
Seminar Rooms 105 and 116
Philologicum
Universitätsplatz 3
18055 Rostock
Germany
Online participation via Zoom
Zoom-Link: https://uni-rostock-de.zoom-x.de/j/68841161435
Meeting-ID: 688 4116 1435
Organisers: Erik Renz and Ulrike Henny-Krahmer
Contact: phf.dh@uni-rostock.de
The event is organised with the support of the team of the Professorship for Digital Humanities at the University of Rostock. It forms part of the activities of the Rostock Working Group for Digital Humanities (RosDH) and is funded by the Department “Wissen – Kultur – Transformation” of the Interdisciplinary Faculty and by the Faculty of Humanities at the University of Rostock.
Lecture: Tackling Data Gaps in Digital Humanities, 09.09.26, online
We invite you to the online lecture by Dr. Sarah Lang (Max Planck Institute for the History of Science) on 09.09.2026 from 10:00 to 11:30, organised as a part of the seminar series ‘Legal History Meets Digital Humanities’ at the Max Planck Institute for Legal History and Legal Theory.
Digital humanities (DH) has long presented itself as a field committed to openness, collaboration, and innovation. Yet, alongside its many achievements, it also exhibits a number of persistent „dark sides“, ranging from infrastructural inequalities and invisible forms of labour to exclusionary data practices and the reproduction of historical and contemporary biases through digital methods. This chapter argues that one of the most pressing challenges currently facing the field is the persistence of data gaps, understood not merely as missing information but as the result of social, historical, and technical processes that systematically privilege some forms of knowledge while marginalising others. Building on work in critical digital humanities, critical archival studies, critical data studies, critical code studies, and feminist scholarship (including feminist AI ethics), the chapter examines how these traditions have conceptualised and addressed such absences, and considers how their insights can be mobilised more systematically within DH research and practice. It further situates these discussions within the recent shift towards data-centric approaches in artificial intelligence (DCAI), where the quality, documentation, and representativeness of datasets have become central ethical and technical concerns. By bringing these conversations into dialogue, the chapter argues that DH can benefit from engaging more directly with emerging debates on datasets while simultaneously contributing its own long-standing expertise in historical sources, documentation, and critical interpretation.
Please register here: https://plan.events.mpg.de/event/802
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Clustertreffen des N4O CC Data Capture and Creation zum Thema Culture Cloud am 8. September 2026
Clustertreffen des N4O CC Data Capture and Creation zum Thema Culture Cloud am 8. September 2026
Am 8. September 2026, 14:30 bis 16:00 Uhr, findet das nächste Clustertreffen des CC Data Capture and Creation statt.
Dieses Mal wird unser Co-Chair Frank Dührkohp (Verbundzentrale des GBV) einen Einblick in das Projekt Culture Cloud geben.
Mit der Culture Cloud entsteht erstmals eine landesweite Kulturdateninfrastruktur für Niedersachsen, die Informationen aus Museen, Archiven, Bibliotheken und der Denkmalpflege zusammenführt. Was bislang dezentral gespeichert und oft schwer auffindbar war, wird nun über einheitliche Standards vernetzt und zentral zugänglich gemacht. So können die Daten künftig über digitale Portale leichter gefunden, miteinander verknüpft und für Forschung, Kultur und Öffentlichkeit nutzbar werden – bei voller Datenhoheit der jeweiligen Einrichtungen.
Hier sind die Zoom-Zugangsdaten:
https://dainst-org.zoom.us/j/93071809817?pwd=YVscWm2i20FHyG8hgVhcO712Wya9Vv.1
Meeting-ID: 930 7180 9817
Kenncode: 032259
Eine Anmeldung ist nicht erforderlich, wir freuen uns auf einen Austausch!
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Bericht vom Hands-On Lab “Digital Footprint – Choose your own adventure” – Datentracking in der Wissenschaft spielerisch verstehen” bei der 114. BiblioCon in Berlin
Bericht vom Hands-On Lab “Digital Footprint – Choose your own adventure” – Datentracking in der Wissenschaft spielerisch verstehen” bei der 114. BiblioCon in Berlin
Autor*innen: Ulrike Wuttke (Fachhochschule Potsdam), Timo Steyer (UB Braunschweig), Yuliya Fadeeva (Helmholtz Open Science Office)
Raschelnde Karten, laut angeregte Gespräche, sind wir hier während der BiblioCon in einer Skatrunde gelandet? Nein, im Workshop “Digital Footprint – Choose your own adventure” – Datentracking in der Wissenschaft spielerisch verstehen”!
Dieser wurde von Yuliya Fadeeva, Timo Steyer und Ulrike Wuttke als Hands-on Lab bei der 114. BiblioCon “Analog trifft Algorithmus” 2026 in Berlin angeboten. Zu dieser fanden zwischen 19. – 22.05.2026 im ESTREL Berlin wieder Bibliotheksmenschen aus dem DACH-Raum und darüber hinaus zusammen, um die neuesten Entwicklungen und Erkenntnisse aus Praxis, Forschung und Transfer zu diskutieren.
Nach zwei Hands-On Labs zum Datentracking bei der BiblioCon 2023 und der BiblioCon 2024 gab es nun wieder auf vielfachen Wunsch der Community eine weitere Auflage. Diese stand ganz im Zeichen eines analogen Spiels dessen Prototyp von Studierenden der FH Potsdam unter der Leitung von Prof. Dr. Ulrike Wuttke entwickelt und dann zusammen mit einem Graphikdesigner und einer Comiczeichnerin sowie Ulrike Wuttke weiterentwickelt wurde.
Im Fokus des Spiels steht als tierischer Protagonist ein ‘Wissensschaf’ auf dem Weg zum PhD, dem ein ‘Forensiker-Flamingo’ im Kampf gegen den fiesen ‘Datentracker-Vampir’ zur Seite steht. Das Spiel wurde für die Zielgruppe internationale Early Career Researcher (ECR) als Teil eines Workshops entwickelt. Es ist deswegen auf Englisch gehalten. Es lädt zur Diskussion zum Hinterlassen und der kommerziellen Verwendung von Datenspuren beim Erstellen einer wissenschaftlichen Publikation ein. Es beleuchtet dieses Phänomen vor dem Hintergrund des radikalen Wandels der globalen Verlagshäuser zum Geschäftsmodell Data Analytics (siehe DFG 2021 https://doi.org/10.5281/zenodo.5900759). Einige dieser Global Player bieten inzwischen alle Phasen des wissenschaftlichen Forschungsprozesses umfassende Workbenches an, tracken aktiv das Verhalten der User auf diesen Plattformen und verwerten die Daten kommerziell weiter (engl. data tracking, science tracking).
Nach Impulsen zu den Hintergründen des Datentrackings in der Wissenschaft von Yuliya Fadeeva und der Motivation zur Spielentwicklung von Ulrike Wuttke und Timo Steyer wurde das Spiel in mehreren Gruppen gespielt und der Workshop mit einer Feedbackrunde abgeschlossen.
Positiv wurde das Potenzial des Spiels hervorgehoben, verschiedene Zielgruppen auf das Thema aufmerksam zu machen sowie seine visuelle Gestaltung und dass es sich um ein kollektives Spiel handelt (es gibt keinen Einzelgewinner). Verbesserungspotenzial wurde bezüglich der didaktischen Aufgleisung des begleitenden Workshops diskutiert und der präziseren Kommunikation des Spielziels. Auch wurde angeregt, über eine digitale Umsetzung nachzudenken.
Die Workshop-Folien stehen auf dem BIB-OPUS Volltextserver zur Verfügung: urn:nbn:de:0290-opus4-200683
Der Austausch war für die Hands-On-Gebenden sehr wertvoll und wir danken den Teilnehmenden sehr. Leider konnten die Studierenden selbst nicht an dem Hands-On teilnehmen, sie bekamen aber von Ulrike Wuttke persönlich die fertigen Spieleboxen überreicht.
Neugierig geworden? Das Spiel steht unter einer freien Lizenz als Open Education Resource (OER) zum Download zur Verfügung:
- Ioanna Danai Katsougiannopoulou, Nadja Hartwich, Ha Thao Suong Vu, Ulrike Wuttke, Katja Diederichs, Niko Ripka (2026): “Digital Footprint – Choose Your Own Adventure“: Data Tracking in Scientific Journals – Game and Workshop. CC BY-NC 4.0. DOI https://doi.org/10.5281/zenodo.17912053
Zusätzlich gibt es gleich zwei Episoden des Podcasts Die Wissensarchitekt*innen zum Spiel, eine Kurzepisode direkt vom Workshop auf der BiblioCon mit Manuel Bärwald und eine lange Episode zum Spieletest mit Claudia Frick.
Das Spiel wurde von Ulrike Wuttke im Rahmen ihrer Transferprofessur mit dem Projekt T.R.A.C.K.S. – Training on Analytics, Compliance, Knowledge, and Security, dem Movetia-Projekt „Datenkompetenzen vermitteln an Hochschulen im D-A-CH Raum“ (Fördernummer 2024-1-CH01-IP-0018) und im Kontext der Task Force der Allianz der Wissenschaftsorganisationen “Datentracking und Digitale Nutzungsspuren: Schritte zur Transparenzschaffung” entwickelt und soll kontinuierlich mit der Praxis Community weiterentwickelt werden.
Last but not least, ein großer Dank an Movetia und den Fachbereich Informationswissenschaften der Fachhochschule Potsdam für die Unterstützung der Spielentwicklung.
Weitere Ressourcen:
- Ulrike Wuttke: Movetia-Workshop zum Datentracking im Vorfeld der ISI 2025
- Ulrike Wuttke — Das ist ja nur die Spitze des Eisbergs! Bericht vom Workshop zum Datentracking in der Wissenschaft im Vorfeld der ISI 2025, 17.03.2025 (TU Chemnitz)
- Ioanna Danai Katsougiannopoulou, Nadja Hartwich, Ha Thao Suong Vu — Digital Footprint – Choose your own adventure : Konzeption eines Spiels zum Thema Data Tracking in der Wissenschaft, speziell von wissenschaftlichen Verlagen für naturwissenschaftliche Early Career Researcher an Institutionen
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Cross-NFDI-Event Bauwerksnormdaten, 26. bis 27. August 2026, in Hannover
Cross-NFDI-Event Bauwerksnormdaten, 26. bis 27. August 2026, in Hannover
Am 26. und 27. August 2026 findet an der Technischen Informationsbibliothek Hannover (TIB) ein konsortienübergreifender Workshop zu Bauwerksreferenz- und Normdaten statt. Zu diesem Thema haben sich NFDI4Culture, NFDI4Objects, NFDI4ING mit weiteren Partnern in einer Special Interest Group zusammengefunden.
Das Lunch-to-Lunch-Event versteht sich als Auftaktveranstaltung, um einen fächerübergreifenden Austausch zu initiieren. Wir möchten das Thema aus unterschiedlichen Perspektiven, etwa bei der Erschließung in Sammlungen und Archiven, bei der Erfassung in Ämtern der Denkmalpflege sowie im Rahmen archäologischer und ingenieurwissenschaftlicher Forschungsprojekte in den Blick nehmen, um anhand praxisnaher Beispiele die Bedarfe, den individuellen Umgang und die aktuell tatsächlich praktizierten Modalitäten der Ansetzung zusammenzutragen. Initiativen zur automatisierten Realisierung mit Wikidata und Wikibase, Anbindung an die GND und Prozessierung per RDM-Pipeline bringen technische Perspektiven ein. Ein anschließendes Barcamp ermöglicht die Vertiefungen und Weiterentwicklung der in den Talks adressierten Aspekte. Ausgehend vom gemeinsamen Ziel, qualitativ hochwertige Referenzdaten bereitzustellen und zu nutzen, ist der Frage nachzugehen, welche Strukturen zur Verfügung stehen, welche neu geschaffen werden müssen und wie Effizienz ohne Qualitätsverlust gelingen kann. Am zweiten Tag sind alle TeilnehmerInnen eingeladen, an einer Roadmap mitzuarbeiten. Die Kleingruppen des Vortags diskutieren Strategien und Maßnahmen, die perspektivisch umgesetzt werden könnten und stellen die Ergebnisse im abschließenden Plenum vor.
Wir möchten die Veranstaltung offen gestalten und freuen uns über weitere Vorschläge für Kurzvorträge und Projektvorstellungen für den ersten Tag und auch über Themen für die Barcamp-Sessions.
NB: Die Veranstaltung ist dem Jahrestreffen der Föderation deutschsprachiger Architektursammlungen (27.–29. August 2026) vorgeschaltet, die Anmeldung gilt nur für den Cross-NFDI-Workshop.
Das vorläufige Programm und ein Link zur Anmeldung finden sich hier: https://reg.nfdi4objects.net/N4O/Bau-Norm.
Der Veranstaltungsort ist die Technische Informationsbibliothek, Hauptgebäude TechNat, Vortragssaal (Zugang über Haupteingang), Welfengarten 1 B, 30167 Hannover.
Wir freuen uns auf einen intensiven Austausch rund um das Thema Normdaten für Bauwerke.
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Workshop „Tabellarische Quellen zwischen Geschichtswissenschaften und Digital Humanities – ein Transkribathon“ (Berlin, Do. 10.09.2026)
Workshop „Tabellarische Quellen zwischen Geschichtswissenschaften und Digital Humanities – ein Transkribathon“ (Berlin, Do. 10.09.2026)
Was? – Workshop „Tabellarische Quellen zwischen Geschichtswissenschaften und Digital Humanities – ein Transkribathon“ (Berlin, Do. 10.09.2026)
Wann? – Donnerstag, 10. September 2026
Wo? – Staatsbibliothek Berlin
Wer? – Stabi Berlin in Kooperation mit NFDI4Memory und der Professur für Digitale Geschichtswissenschaften der Otto-Friedrich-Universität Bamberg
Die tabellarische Strukturierung bzw. Visualisierung von Informationen zählt seit jeher zu den Standardmodi der Wissensvermittlung und -speicherung. Ungeachtet aller Dynamik auf den Forschungsfeldern von Computer Vision und Pattern Recognition stellen jedoch die automatische Erkennung und Extraktion der Inhalte historischer Tabellen in ihrer schieren Vielfalt nach wie vor die verfügbaren proprietären wie quelloffenen Softwareangebote für Optical Character bzw. Handwritten Text Recognition (OCR/HTR) vor beträchtliche Herausforderungen.
Diesem Defizit steht insbesondere von Seiten der historisch orientierten Wirtschafts- und Sozialwissenschaften der Wunsch nach niedrigschwelligen Angeboten zur automatischen Tabellenextraktion gegenüber – ein Spannungsverhältnis, das angesichts des anhaltenden Aufschwungs der Kliometrie wie auch der zahlreichen aktuellen Projektaktivitäten zur Generierung und Analyse langer Zeitreihen zusehends schmerzhafter wird. Unter den angesprochenen Vorhaben ist beispielsweise das auf 18 Jahre angelegte Frankfurter Akademieprojekt Finanz- und Unternehmensforschung aus der Langfristperspektive: Erschließung historischer Bestände deutscher Finanzmarkt- und Unternehmensdaten (1871–2025) zu nennen und nicht zuletzt das von der Deutschen Forschungsgemeinschaft geförderte Vorhaben der Staatsbibliothek zu Berlin Regionale Wirtschaftsentwicklung in qualitativ-quantitativer Doppelperspektive zur Digitalisierung ihrer herausragenden Sammlung an Jahresberichten deutscher Handelskammern des ‚langen‘ 19. Jahrhunderts.
Um das Fundament zur Einlösung des vielfach angemahnten Desiderats eines generischen maschinellen Datenextraktionsinstruments (historischer) tabellarischer Quellen zu legen, entsteht gegenwärtig an der Professur für Digitale Geschichtswissenschaften der Universität Bamberg ein Benchmarking-Datenset gedruckter Tabellen aus der Zeit zwischen 1750 und 1990. Dieses aus Mitteln der NFDI4Memory geförderte Vorhaben möchte die kaum überschaubare Vielfalt der historischen Erscheinungsformen von Tabellen in ca. 10.000 Objekten abbilden und deren Strukturmerkmale mit Annotationen erfassen. Denn frei verfügbare qualitätsgesicherte Referenzdaten (Ground Truth) zum Training von Tabellenextraktionsmodellen sind bislang rar und zudem überwiegend aus modernen Vorlagen geschöpft.
Vor diesem Hintergrund zielt die in Kooperation mit der Professur für Digitale Geschichtswissenschaften der Otto-Friedrich-Universität Bamberg und NFDI4Memory organisierte hybride Veranstaltung, zu der wir herzlich ins Stabi Lab der Staatsbibliothek zu Berlin einladen, darauf, den Teilnehmenden zunächst in mehreren Impulsvorträgen einen Überblick der aktuellen Entwicklungen auf dem Feld der automatischen Extraktion historischer Tabelleninhalte zu geben. Anschließend sollen ausgewählte Tabellen gemeinsam intellektuell annotiert und so wertvolle Ground Truth-Daten für das Training künftiger Softwarelösungen gewonnen werden. Bring your own table: Die Teilnehmenden sind ausdrücklich eingeladen, eigene tabellarische Quellen mitzubringen, um diese gemeinsam zu transkribieren und zu annotieren.
Weitere Informationen und die Anmeldung finden Sie / findet Ihr hier.
Über Einzelheiten der Teilnahme am Workshop, insbesondere was die „Bring Your Own Table“-Sektion am Nachmittag betrifft, werden wir Sie / Euch rechtzeitig informieren.
Wir freuen uns auf zahlreiche Anmeldungen!
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Reminder: Einladung zum DHd Community Forum am 10.07.2026 zum Thema “Nachlese der DHd2026 und Ausblick DHd 2027”
Reminder: Einladung zum DHd Community Forum am 10.07.2026 zum Thema “Nachlese der DHd2026 und Ausblick DHd 2027”
Liebe Mitglieder des DHd-Verbandes und Interessierte,
für unsere interdisziplinäre Community ist ein offener Austausch von großer Bedeutung. Während die jährliche Mitgliederversammlung bereits eine wichtige Rolle für unsere communityinterne Verständigung übernimmt, unterstützen wir als Vorstand weitere partizipative Angebote. Alle Mitglieder und Interessierte sind herzlich eingeladen, sich an den Diskussionen zu beteiligen sowie Themenvorschläge (info@digitalhumanities.de) einzureichen.
Das nächste virtuelle Community Forum findet am Freitag, den 10. Juli 2026 von 11–12 Uhr statt. Das von uns vorgeschlagene Thema lautet “Nachlese der DHd2026 und Ausblick DHd2027”. Dazu begrüßen wir als Gäste die Organisationsteams der beiden Konferenzen. Weitere Themen können wie immer zu Beginn des Community Forums vorgeschlagen werden.
Für das Community Forum werden wir das Videokonferenztool Zoom nutzen. Wir möchten Sie bitten, sich mit vollständigem Namen anzumelden.
https://lmu-munich.zoom-x.de/j/69203567293?pwd=rWT3ZQja2LdYiXW8EUgojtMBwAmI7W.1
Meeting-ID: 692 0356 7293
Kenncode: 270211
Wir freuen uns auf den Austausch mit Ihnen!
Mit freundlichen Grüßen
Rabea Kleymann (als Koordinatorin des Community Forums)
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Einladung zum Workshop: Forschungsdaten publizieren in der Filmwissenschaft | 16. Juli 2026, Potsdam
Einladung zum Workshop: Forschungsdaten publizieren in der Filmwissenschaft | 16. Juli 2026, Potsdam
Liebe Interessierte,
das Datenkompetenzzentrum QUADRIGA lädt zu einem eintägigen Workshop rund um die Publikation film- und medienwissenschaftlicher Forschungsdaten ein. Der Workshop steht allen interessierten Wissenschaftler:innen offen. Er richtet sich insbesondere an Film- und Medienwissenschaftler:innen sowie Forschende aus angrenzenden geisteswissenschaftlichen Disziplinen.
Praxisnah und ohne spezielles Vorwissen lernen Sie, wie Forschungsdaten für eine offene, FAIR-konforme Publikation aufbereitet, angereichert und veröffentlicht werden können: von der Dokumentation und Strukturierung über Metadatenstandards bis hin zur Evaluation von Publikationswegen. Der Workshop verbindet Impulsvorträge, Diskussionen und praktische Übungen, dabei kommen Module einer von QUADRIGA entwickelten OER (Open Educational Resource) zum Einsatz. Mehr Informationen gibt es auf der Website:
https://www.quadriga-dk.de/de/ws2026datenpublikation.
Stattfinden wird der Workshop am Donnerstag, dem 16. Juli 2026, von 10:00 bis 18:00 Uhr im Potsdam Lab im Bildungsforum Potsdam (fußläufig vom Potsdamer Hauptbahnhof erreichbar).
Anmeldungen sind bis zum 9. Juli möglich. Zur Anmeldung gelangen Sie hier.
Für Teilnehmende, die außerhalb der Region Berlin-Brandenburg anreisen, steht eine begrenzte Anzahl an Reisekostenunterstützungen zur Verfügung.
Bei Fragen stehen wir Ihnen gerne zur Verfügung.
Beste Grüße,
Melanie Seltmann für
Ihr QUADRIGA-Team
—
Berlin-Brandenburgisches Datenkompetenzzentrum für
Digital Humanities, Verwaltungswissenschaft, Informatik und Informationswissenschaft
————————————————————
quadriga-management@listserv.dfn.de
https://github.com/quadriga-dk
————————————————————
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
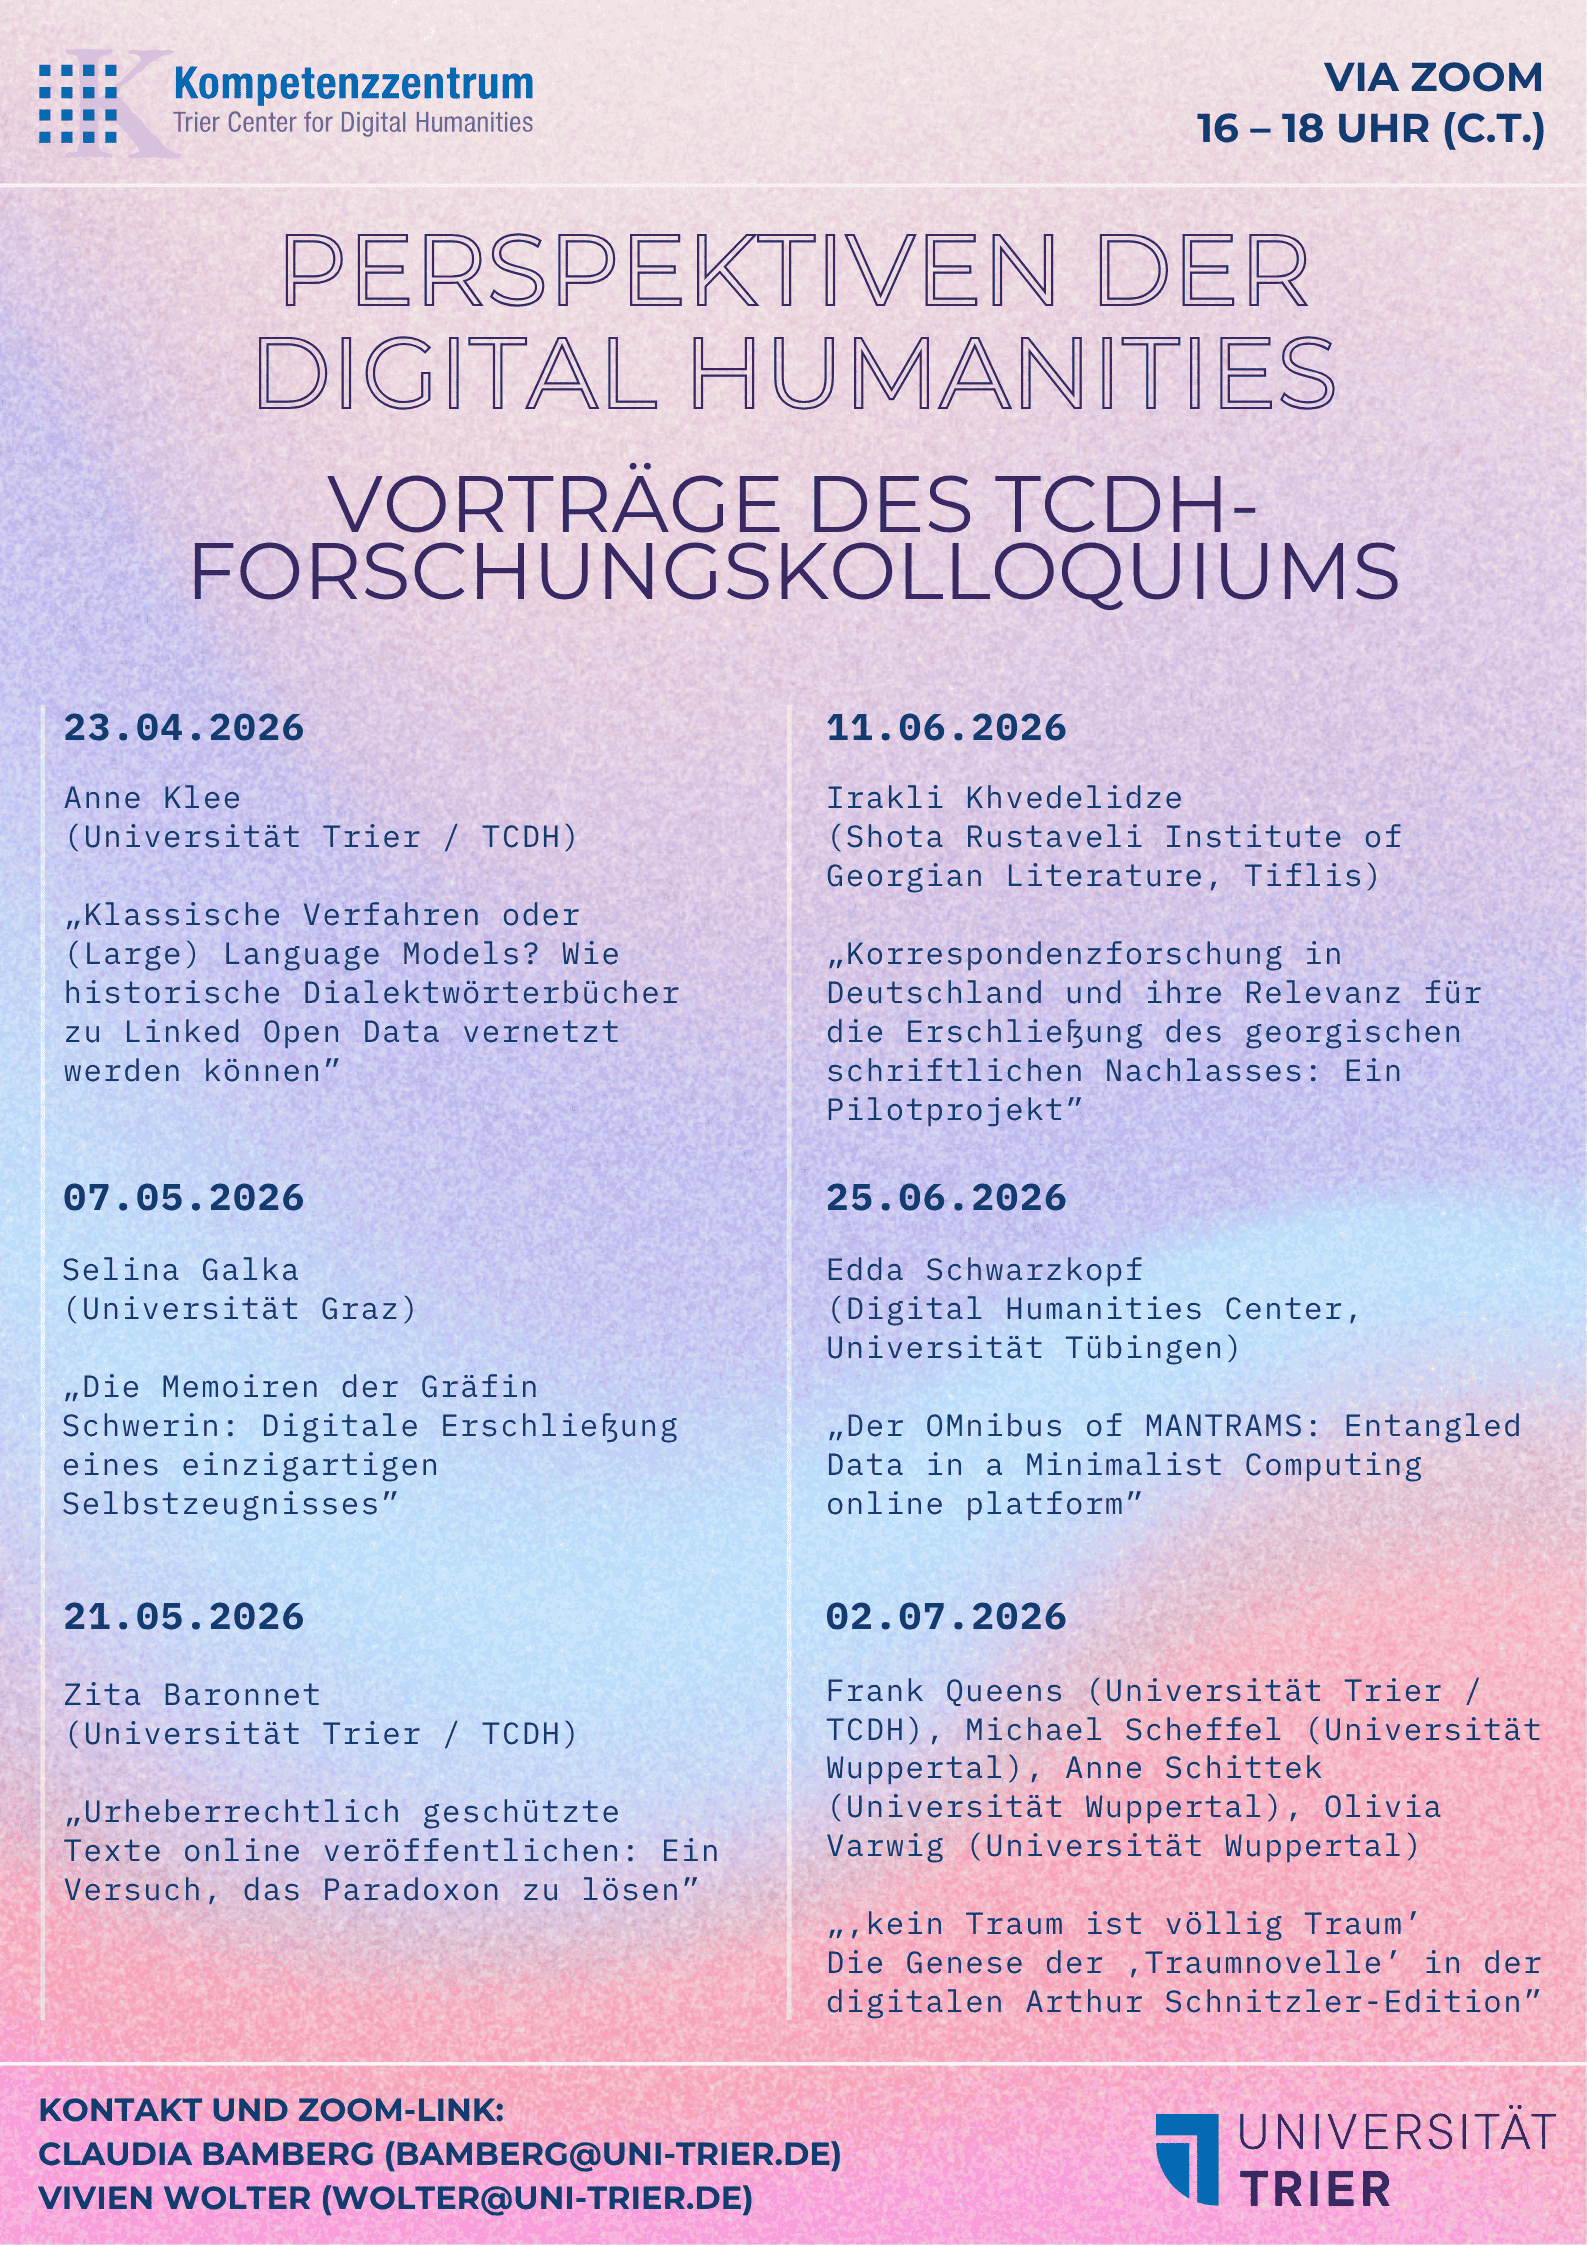
- Einladung zum Online-Vortrag von Edda Schwarzkopf am 25.06. im Rahmen des TCDH-Forschungskolloquiums
Einladung zum Online-Vortrag von Edda Schwarzkopf am 25.06. im Rahmen des TCDH-Forschungskolloquiums
Gerne möchten wir Sie zu folgendem Online-Vortrag am 25.06.2026 (16–18 Uhr (c.t.)) im Rahmen des TCDH-Forschungskolloquiums einladen:
Edda Schwarzkopf (Digital Humanities Center, Universität Tübingen): „Der OMnibus of MANTRAMS: Entangled Data in a Minimalist Computing online platform”
Das Forschungsprojekt „MANTRAMS – Mantras in Religion, Media, and Society in Global Southern Asia“ (ERC Syngery Grant, Laufzeit 2024-2030) wird zwischen den Universitäten Tübingen, Wien, EPEH Paris und Oxford gehostet und beschäftigt rund 50 Forschende aus einer großen Bandbreite von Geistes- und Sozialwissenschaften für umfassende historische und ethnografische Studien zu Mantras. Als Digital Humanities and Data Management Officer (DHDMO) entwickelt und verwaltet Edda Schwarzkopf eine lokale Nextcloud Instanz, Verarbeitungs- und Analysepipelines für multimediale qualitative Daten, sowie ethische und rechtliche Compliance Prozesse (Datenschutz, Urheberrecht und CARE Prinzipien for Indigenous Data Governance). Diese digitale Infrastruktur mündet im OMnibus of MANTRAMS (https://omnibus.mantrams.eu), einem immersiven, multimedialen, narrativen Onlinearchiv ausgewählter Forschungsmaterialien, der im Mai 2026 in einer ersten Version online geschaltet wird. MANTRAMS arbeitet mit einer großen Vielfalt von Sprachen, Zeichensystemen, technischen Ressourcen und (Data) Literacy Niveaus aus Communities mit unterschiedlichen Graden an Marginalisierung, denen wir iterativ und in enger Zusammenarbeit mit Forschungsteilnehmenden begegnen. Im Vortrag wird der OMnibus konzeptuell und technisch vorgestellt, in größere Abläufe der Datenerhebung und -erschließung eingebettet sowie in seiner organisatorischen Rolle im Projekt reflektiert.
Im Sommersemester 2026 setzen wir unsere Vortragsreihe im Rahmen des TCDH-Forschungskolloquiums fort. Das Spektrum reicht in diesem Semester von Fragen der digitalen Erschließung und Vernetzung historischer Texte und Wörterbücher über rechtliche und ethische Herausforderungen im Umgang mit Forschungsdaten bis hin zu digitalen Editionen und Plattformlösungen für die geisteswissenschaftliche Forschung.
Sie sind herzlich eingeladen, teilzunehmen und mitzudiskutieren!
Alle Informationen und Zoom-Link gibt es unter:
Methodenmesse auf der IDS-Jahrestagung 2027: „Sprache und Literatur“
Call for Papers:
Die 63. Jahrestagung des Leibniz-Instituts für Deutsche Sprache (IDS) in Mannheim steht unter dem Motto „Sprache und Literatur“ und zielt darauf ab, Phänomene literarischer Sprache aus der Perspektive linguistischer Fragestellungen und Methoden zu beleuchten. Wir rufen zur Einreichung von Beiträgen für die Methodenmesse auf, die am Mittwoch, 10. März 2027, im Rahmen der Tagung stattfindet.
Der Fokus der Methodenmesse ist praxisnah und liegt auf Ressourcen, Methoden und Werkzeugen, die idealerweise anhand kurzer Anwendungsstudien demonstriert werden. Die Vorstellung von spezifischen Studien ist ebenfalls möglich, wobei transparente Methodik, Dokumentation und möglichst reproduzierbare Forschungsprozesse im Vordergrund stehen sollten. Wir begrüßen insbesondere Beiträge, die sich mit der deutschen Sprache beschäftigen bzw. auf das Deutsche anwendbare Methoden oder Tools vorstellen.
Geplante Themenbereiche sind:
• Korpora oder andere Ressourcen für die empirische Arbeit mit literarischen Texten
• Tools, Strategien und Workflows für die empirische Untersuchung literarischer Texte mit Bezug auf deren sprachliche Struktur, hierbei auch besonders:
o Untersuchungen und kritische Reflexion zum Einsatz von KI-Methoden
o Untersuchungen zu multimodalen und neuartigen Literaturformen (z.B. Songs, Graphic Novels, Social-Media-Formate, interaktive Formate, KI-generierte Literatur)
• Didaktisch-methodische Konzepte für die Verknüpfung von Sprach- und Literaturwissenschaft in Lehre und Unterricht
Weitere Themenbereiche können berücksichtigt werden, sofern der Bezug zum Tagungsthema in der Einreichung klar herausgearbeitet ist.
Die Beiträge werden in Form eines Posters und ggf. einer Softwaredemonstration präsentiert. Auf der Tagung wird jeder Beitrag in einem einminütigen Schlaglicht dem Publikum vorgestellt. Anschließend gibt es die Gelegenheit, die Inhalte im Rahmen einer ca. eineinhalbstündigen Poster-Session zu demonstrieren und Fragen zu beantworten. Ausgearbeitete Beiträge sollen im Anschluss an die Tagung bei IDSopen ( https://idsopen.de ) digital nach dem Open-Access-Prinzip publiziert werden.
Wenn Sie einen Beitrag zur Methodenmesse beisteuern möchten, bitten wir um ein nicht anonymisiertes Abstract auf Deutsch (ca. 500 Wörter exkl. Literaturangaben; in einem editierbaren Format) bis zum 15.09.2026 an folgende Adresse:
methodenmesse2027@ids-mannheim.de
Über die Annahme der Beiträge wird bis zum 15.11.2026 entschieden.
Konferenz-Webseite: https://www.ids-mannheim.de/aktuell/veranstaltungen/tagungen/jahrestagung-2027/
Organisationsteam: Annelen Brunner, Katharina Gloning, Peter Meyer, Roman Schneider
ediarum.MEETUP – nächste virtuelle Veranstaltung am 13.7.2026
Liebe ediarum-Community, liebe ediarum-Interessierte, liebe Kolleg:innen!
im Namen des Konsortiums Text+ der Nationalen Forschungsdateninfrastruktur (NFDI) und des ediarum-Teams an der Berlin-Brandenburgischen Akademie der Wissenschaften (BBAW) laden wir Sie herzlich zum nächsten virtuellen ediarum.MEETUP ein:
am Montag, den 13. Juli 2026, 11:00 Uhr s.t.
Martina Gödel und Johannes Ioannu aus der TELOTA-Abteilung der BBAW stellen das noch junge ediarum-Modul ediarum.ANTIQUITY vor. Das Datenmodell und das passende Oxygen-Framework sind speziell an die Bedarfe von Editionen von Texten aus der Antike und Spätantike abgestimmt. Es wird von mehreren Vorhaben eingesetzt und bietet zahlreiche Funktionalitäten von der Erstellung von Volltext-Transkriptionen bis hin zu textkritischen Kommentaren. Ein Grundsatz von ediarum.ANTIQUITY besteht in der Trennung von Transkription und Annotation jeder einzelnen Handschrift und der Edition von Texten inklusive Variantenapparat. Hierdurch werden unterschiedliche Zugänge auf das Material möglich und die Transparenz bei der Erstellung der Edition wird erhöht.
Die Veranstaltung findet virtuell statt; eine Anmeldung ist nicht notwendig. Zum Termin ist der virtuelle Konferenzraum über den Link https://meet.academiccloud.de/gl/rooms/nad-mge-0rq-ufp/join erreichbar.
***
Weitere Informationen zum Meetup finden Sie auf der ediarum-Website (https://www.ediarum.org/meetups.html).
Das ediarum.MEETUP ist primär für DH-Entwickler:innen gedacht, die sich zu spezifischen ediarum-Entwicklungsfragen austauschen wollen, jedoch sind auch ediarum-Nutzer:innen und Interessierte herzlich willkommen.
Wir freuen uns auf zahlreiches Erscheinen!
Viele Grüße
Martin Fechner
im Namen von Text+ und der ediarum-Koordination
Einladung zum DHd Community Forum am 10.07.2026
Einladung zum DHd Community Forum am 10.07.2026 zum Thema “Nachlese der DHd2026 und Ausblick DHd 2027”
Liebe Mitglieder des DHd-Verbandes und Interessierte,
für unsere interdisziplinäre Community ist ein offener Austausch von großer Bedeutung. Während die jährliche Mitgliederversammlung bereits eine wichtige Rolle für unsere communityinterne Verständigung übernimmt, unterstützen wir als Vorstand weitere partizipative Angebote. Alle Mitglieder und Interessierte sind herzlich eingeladen, sich an den Diskussionen zu beteiligen sowie Themenvorschläge (info@digitalhumanities.de) einzureichen.
Das nächste virtuelle Community Forum findet am Freitag, den 10. Juli 2026 von 11–12 Uhr statt. Das von uns vorgeschlagene Thema lautet “Nachlese der DHd2026 und Ausblick DHd2027”. Dazu begrüßen wir als Gäste die Organisationsteams der beiden Konferenzen. Weitere Themen können wie immer zu Beginn des Community Forums vorgeschlagen werden.
Für das Community Forum werden wir das Videokonferenztool Zoom nutzen. Wir möchten Sie bitten, sich mit vollständigem Namen anzumelden.
https://lmu-munich.zoom-x.de/j/69203567293?pwd=rWT3ZQja2LdYiXW8EUgojtMBwAmI7W.1
Meeting-ID: 692 0356 7293
Kenncode: 270211
Wir freuen uns auf den Austausch mit Ihnen!
Mit freundlichen Grüßen
Rabea Kleymann (als Koordinatorin des Community Forums)
-
4 - 德语区数字人文研究协会博客(DHd-Blog)
- Nicht nur Text, nicht nur Daten … aber was dann? – ‚Theoretisieren‘ durch Praktiken in der digitalen Editorik, der Digital History und den Computational Literary Studies. Ein Bericht.
Nicht nur Text, nicht nur Daten … aber was dann? – ‚Theoretisieren‘ durch Praktiken in der digitalen Editorik, der Digital History und den Computational Literary Studies. Ein Bericht.
Autor*innen (alph.)
- Jonathan D. Geiger, Akademie der Wissenschaften und der Literatur Mainz, jonathan.geiger@adwmainz.de, https://orcid.org/0000-0002-0452-7075
- Jessica Hainke, Christian-Albrechts-Universität zu Kiel, jhainke@ndl-medien.uni-kiel.de
- Philipp Hegel, Akademie der Wissenschaften und der Literatur Mainz, Philipp.Hegel@adwmainz.de, https://orcid.org/0000-0001-6867-1511
- Alexa Lucke, Universität Siegen, alexa.lucke@uni-siegen.de, https://orcid.org/0009-0006-2738-2864
- Laura Untner, Freie Universität Berlin, laura.untner@fu-berlin.de, https://orcid.org/0000-0002-9649-0870
Originalblogpost: https://dhtheorien.hypotheses.org/2442
Einleitung
Am 25. Februar 2026 fand im Rahmen der jährlichen Digital-Humanities-Konferenz (DHd) ein Panel der AG Digital Humanities Theorie statt, das eine zentrale Frage in den Mittelpunkt stellte: Wie werden digitale Forschungspraktiken selbst zum Ausgangspunkt theoretischer Reflexion? Die Diskussion, an der sich Laura Untner (Freie Universität Berlin) und Alexa Lucke (Universität Siegen) aus den Computational Literary Studies (CLS), Silke Schwandt (Universität Bielefeld) und Christian Wachter (Universität Münster) aus der Digital History und Philipp Hegel (Akademie der Wissenschaften und der Literatur Mainz) aus der Digitalen Editorik beteiligten, zeigte, dass Theoriearbeit in den Digital Humanities (DH) nicht nur als externes Gerüst verstanden werden kann, sondern vielmehr auch aus der Praxis selbst erwächst. Im Folgenden werden einige Aspekte der Debatte zusammengefasst und es wird dazu eingeladen, über die Verflechtung von Theorie und Praxis sowie Theorie und Empirie in den DH wieder nachzudenken.
Was ist Theorie in den Digital Humanities?
In den Geisteswissenschaften war Theorie lange Zeit eng mit textbasierter Argumentation verbunden – dem Lesen, Interpretieren und Schreiben. In den DH verschiebt sich dieser Fokus: Hier entsteht Wissen nicht nur in klassischen Publikationen, sondern auch in Datenmodellen, Code-Zeilen oder Visualisierungen. Theorie und Theoriebildung hängen zunehmend von technischen Bedingungen ab, wodurch ihre impliziten Annahmen und Voraussetzungen nicht immer sichtbar werden. Zugleich wurde betont, dass Theoriearbeit in den DH drei zentrale Dimensionen umfasst: die methodologische (Wie operationalisieren wir Begriffe wie ‚Genre‘ oder ‚Autor*innenschaft‘?), die epistemologische (Welche Erkenntnisbedingungen liegen unseren Datenmodellen zugrunde?) und die technische (Wie prägen Infrastrukturen wie APIs oder Datenbanken unser Verständnis von Forschungsobjekten?). Theorie muss in diesem Zusammenhang nicht als Hindernis, sondern kann als Produktivitäts- und Transparenzwerkzeug verstanden werden – gerade dann, wenn sie explizit gemacht wird.
Praktiken des Theoretisierens in den Teilfeldern
Für die Computational Literary Studies (CLS) lag der epistemologische Schwerpunkt des Panels auf der Frage, wie Modellierungsprozesse theoretische Annahmen sichtbar machen (können). So wurden Text- und (Meta-)Datenmodelle wie Genre-Taxonomien oder Autorschaftskonzepte nicht als neutrale Perspektiven auf literaturgeschichtliche Kategorien wahrgenommen, sondern vielmehr hinsichtlich ihres Status zwischen (häufig normativen) theoretischen Konstrukten und empirischen Befunden diskutiert. Die digitale Hermeneutik (Möbus et al. 2025) etwa versuche, (latente) Vorannahmen in Daten und Datensätzen zu entschlüsseln und auf diese Weise den Mythos der ‚rohen Daten‘ (Gitelman 2013) zu entkräften. Ein Extrembeispiel für theoretische Reflexion stellt das WEMI-Modell (Work-Expression-Manifestation-Item) dar, das durch seine relationale Struktur zeigt, wie stark unser Verständnis von ‚Text‘ von theoretischen Vorannahmen geprägt ist. Besonders hervorgehoben wurde die Rolle der Formalisierung: Dabei wurde kritisch gefragt, warum bestimmte Literaturtheorien (wie Strukturalismus und Formalismus) formalisierbarer seien als andere und ob der Fokus in den CLS nicht stärker auf der Prozesshaftigkeit von Theoriebildung liegen sollte.
Im Hinblick auf die Digital History zeigte sich, dass das Digitale nicht einfach nur neue Methoden, sondern einen reflexiven turn (König 2021) auslöste. Traditionelle Praktiken wie Quellenkritik oder narrative Darstellungen erhalten durch digitale Werkzeuge eine neue Dimension: Erstere muss etwa Unsicherheiten in Datenmodellen reflektieren, während Visualisierungen wie Netzwerkanalysen zu ‚produktiven Irritationen‘ führen, die etablierte Erzählungen herausfordern. Ein Schlüsselmoment ist die Erkenntnis, dass Digital History nicht ‚Geschichte in Bits‘ ist, sondern eine Auseinandersetzung mit den Bedingungen, unter denen historisches Wissen heute entsteht. Besonders kontrovers diskutiert wurde, ob der Übergang von analogen zu digitalen Medien lediglich ein Medientransfer oder eine tiefgreifende Transformation darstelle.
Für die Digitale Editorik wurde besonders deutlich, wie technische Entwicklungen theoretische Fragen erst ermöglichen. Digitale Editionen entstanden etwa durch die Verschmelzung heterogener Bausteine, deren Zweck nicht primär die Erstellung digitaler Editionen war: von der Mikroelektronik (integrierter Schaltkreis, 1958) über Codierungsstandards auf der Grundlage von SGML (ab etwa 1987) bis hin zu webbasierten Präsentationsformen (HTTP, 1991) und vermutlich Transformermodellen (2017). Jede dieser Technologien brachte implizite Modell-Entscheidungen mit sich – etwa die Frage, wo die Grenze zwischen ‚Text‘ und ‚Apparat‘ verläuft oder wie Faksimiles die Entstehungsgeschichte eines Dokuments sichtbar machen. Eine zentrale These war, dass digitale Editionen nicht länger nur als ‚Ergebnisse‘, sondern als dynamische Forschungsumgebungen verstanden werden können, in denen Theorie und Praxis untrennbar miteinander verbunden sind.
Diskursive Synthesen
Über alle beteiligten Felder hinweg zeigte sich in der Diskussion, dass ‚Theorie‘ in den DH oft implizit in Infrastrukturen, Datenmodellen/Schemata oder Code/Algorithmen u. v. m. eingebettet ist, wodurch sie erst in Test- und Grenzsituationen sichtbar wird. So entstehen theoretische Reflexionen etwa dann, wenn Historiker*innen mit Informatiker*innen über Datenmodelle diskutieren oder wenn Literaturwissenschaftler*innen feststellen, dass ihre Operationalisierungen rechnerisch nicht nutz- oder ausführbar sind.
Ein weiterer Schwerpunkt war die Pluralität theoretischer Ansätze in Verbindung mit der Frage nach Formalisierbarkeit: Trotz (Quasi-)Standards wie den Richtlinien der TEI zeigt sich, dass fast jedes Projekt eigene Modellanpassungen vornimmt und dadurch die Standardisierungsidee aufspreizt. Einig waren sich die Panelist*innen vor allem darin, dass Kollaboration, gerade in interdisziplinären Teams, einen Raum für theoretische Reflexion schaffe, der in traditionellen Einzeldisziplinen oft fehle – was auch einem gewissen Zwang geschuldet sein könnte, in der Sache zusammenzukommen (Stichwort ‚Interoperabilität‘).
Besonders hervorgehoben wurde auch die Rolle von Visualisierungen: Tabellen, Netzwerke oder interaktive Karten machen nicht nur Daten sichtbar, sondern auch die Modell-Entscheidungen, die hinter ihnen stecken. So wird etwa durch die Darstellung von Textvarianten in digitalen Editionen deutlich, wie stark unser Verständnis von ‚Varianten‘ von technischen Repräsentationsmöglichkeiten abhängt. Gleichzeitig sei angemerkt, dass Visualisierungen auch mit Verdeckungseffekten einhergehen.
Ausblick: Theorie als Aufgabe der Community
Die Diskussion mündete in den Appell, Theoriearbeit in den DH systematischer zu verankern. Dazu gehören konkrete Schritte wie die noch stärkere Einbindung theoretischer Reflexionen in Projektbeschreibungen, die Förderung von Methodenpluralismus in Drittmittelanträgen oder die Entwicklung von Schulungsformaten, die Historiker*innen und Literaturwissenschaftler*innen in theorie- und datengetriebene Denkweisen einführen. Ein vielversprechender Ansatz ist die Idee, kritische Datenpraxis als Standard zu etablieren, also die kontinuierliche Reflexion darüber, wie Algorithmen, Interfaces und Infrastrukturen unser Wissen formen und dabei selbst Ausdruck unseres Wissens sind.
Wenn Theorie als integraler Bestandteil von Forschungspraxen verstanden wird, können die DH eine noch tragfähigere Brücke zwischen geisteswissenschaftlicher ‚Tiefe‘ und technischer Innovation schlagen. Der Schlüssel liegt darin, die unsichtbare Arbeit des Theoretisierens – im Labor, im Code, in den Datenmodellen – bewusster zu machen. Denn erst dann wird klar: Theorie ist nicht das Gegenteil von Praxis, sondern ihre treibende Kraft (wie auch Praxis die treibende Kraft von Theorie ist).
Die AG Digital Humanities Theorie bedankt sich beim Organisationsteam der DHd-Konferenz sowie bei allen Diskutant*innen im Plenum für Fragen, Anregungen und Kommentare. Die AG wird das Thema weiter bearbeiten und lädt daher alle Interessierten, vor allem auch aus weiteren Bereichen der DH, um die Debatte über CLS, Digitale Editorik und Digital History hinaus zu erweitern, zur Mitarbeit ein. Schreiben Sie dazu sehr gerne eine Mail an die Convenor der AG Jonathan D. Geiger (jonathan.geiger@adwmainz.de), Rabea Kleymann (rabea.kleymann@phil.tu-chemnitz.de) und Alexa Lucke (Alexa.Lucke@uni-siegen.de).
Referenzen
Gitelman, Lisa (Hrsg.) (2013). „Raw Data“ is an Oxymoron. Cambridge, MA: The MIT Press. DOI: https://doi.org/10.7551/mitpress/9302.001.0001.
König, Mareike (2021). „Die digitale Transformation als reflexiver turn: Einführende Literatur zur digitalen Geschichte im Überblick“. Neue Politische Literatur 66, Nr. 1: 37–60. DOI: https://doi.org/10.1007/s42520-020-00322-2.
Möbus, Dennis et al. (Hrsg.) (2025). Digital Hermeneutics II: Sources, Analysis, Interpretation, Annotation, and Curation. (Special Issue, Lecture Notes in Computer Science, LNCS, vol. 14566), Heidelberg u.a.: Springer. DOI: https://doi.org/10.1007/978-3-032-08697-6.