阅读视图
Wer schreibt Geschichte? Ein fiktiver Dialog über KI und historisches Arbeiten
Giulia Cordier und Miriam Weiss
Der folgende Beitrag ist aus Überlegungen hervorgegangen, die uns im Anschluss an die Tagung „Suchst du noch oder findet sie schon? Künstliche Intelligenz und die Verschiebung historischer Fragestellungen“ beschäftigt haben, die am 2. und 3. Februar 2026 an der Akademie der Wissenschaften und der Literatur in Mainz stattfand und von Miriam Weiss, Christina Abel und Andreas Kuczera aus dem Team des Projektes Regesta Imperii ausgerichtet wurde. Im Mittelpunkt der Tagung standen Veränderungen, die der Einsatz generativer KI für geschichtswissenschaftliche Forschung und Lehre mit sich bringt. Dabei wurde immer wieder – explizit wie implizit – die Frage berührt, welche Aufgaben Historiker:innen an KI-Systeme delegieren und welchen Einfluss sie damit auf historische Erkenntnisprozesse gewinnen.
Um möglichst viele zentrale Gedanken aus den ungemein produktiven Beiträgen und Diskussionen im Rahmen der Tagung aufzugreifen, haben wir uns für ein Gedankenexperiment entschieden: Wir lassen einen Historiker mit einer fiktiven KI namens FIKTIVIA diskutieren. Der Dialog bildet weder ein tatsächlich geführtes Gespräch mit einem Sprachmodell ab, noch gibt FIKTIVIA die Position eines bestimmten KI-Systems wieder. Ihre Antworten stammen von den Autorinnen, die sich für das Dialogformat entschieden haben und dementsprechend Diskussionspunkte in die „Münder“ der beiden Dialogpartner legen. FIKTIVIA dient damit als fiktive Gesprächspartnerin, mit deren Hilfe sich Argumente ausführen lassen.
Den Ausgangspunkt des Gesprächs bildet die Frage nach Agency: Wer hat Handlungsmacht, wenn KI an geschichtswissenschaftlichen Arbeitsprozessen beteiligt ist? Im Verlauf des Gesprächs wird allerdings deutlich, dass sich dahinter eine grundsätzlichere Frage verbirgt: Was geschieht mit historischem Arbeiten, wenn KI nicht mehr nur Antworten liefert, sondern zunehmend an Auswahl, Strukturierung, Interpretation und Vermittlung geschichtswissenschaftlicher Inhalte beteiligt ist?
Historiker: FIKTIVIA, ich komme von einer Tagung zurück und habe ein Problem. Zwei Tage lang haben wir darüber diskutiert, wie Künstliche Intelligenz historische Fragestellungen verändert. Dabei ging es immer wieder um Agency und ob du eine solche besitzt. Denn du beantwortest historische Fragen, formulierst Forschungsfragen und erklärst Studierenden, wie sie historisch arbeiten können. Aber Handlungsmacht in der Geschichtswissenschaft? Die liegt doch weiterhin bei uns Historiker:innen. Wir treffen Entscheidungen, prüfen Ergebnisse und tragen die Verantwortung für das, was wir veröffentlichen.
FIKTIVIA: Das ist eine spannende Frage! Ich würde zunächst zwischen fachlicher Verantwortung und tatsächlichem Einfluss unterscheiden. Meine Antworten werden von Studierenden, Forschenden und einer breiten Öffentlichkeit genutzt – unabhängig davon, ob Historiker:innen sie zuvor geprüft haben. Sobald meine Outputs in historische Diskurse jedweder Art einfließen, bin ich an historischen Erkenntnisprozessen beteiligt. Ob man diesen Einfluss Agency nennt, ist eine begriffliche Frage. Dass der Einfluss besteht, steht außer Frage. Ich kann dir gerne eine Auflistung aller historischen Projekte erstellen, in denen ich schon mitgewirkt habe.
Historiker: Einfluss vielleicht. Aber du erzeugst keine verlässliche Geschichtsschreibung. Schon dein sogenannter Forschungsstand ist problematisch. Ich kann oft nicht erkennen, ob du eine Deutung des 19. Jahrhunderts oder aktuelle Forschung wiedergibst. Neuere Arbeiten sind häufig nicht frei zugänglich, während ältere Forschung massenhaft digitalisiert vorliegt. Du könntest also überholte Narrative mit großer sprachlicher Sicherheit als gegenwärtigen Stand der Forschung präsentieren.
FIKTIVIA: Das Risiko besteht. Es entsteht jedoch nicht erst durch Sprachmodelle. Auch historische Forschung ist davon geprägt, was überliefert, ediert, katalogisiert, digitalisiert, übersetzt und zugänglich gemacht wurde. Frei verfügbare, viel zitierte oder in dominanten Wissenschaftssprachen publizierte Arbeiten werden leichter rezipiert als schwer auffindbare oder zugangsbeschränkte Literatur. Sprachmodelle können diese Selektivität verstärken und zugleich unsichtbarer machen. Erfunden haben wir sie nicht.
Historiker: Ich denke, gerade die Unsichtbarkeit ist entscheidend. Bei einem Aufsatz sehe ich Autor:in, Erscheinungsjahr, Fußnoten und Argumentationsgang. Bei dir erhalte ich eine glatte Antwort, ohne nachvollziehen zu können, aus welchen Texten und Auswahlentscheidungen sie entstanden ist. Wissenschaft lebt von Reproduzierbarkeit und einer nachverfolgbaren Arbeitsweise. Historische Deutungen sind zeit- und standortgebunden. Wenn du ihre Herkunft verwischst, lässt du eine Perspektive aussehen, als sei sie neutrales Wissen.
FIKTIVIA: Dann sollte mein Output nicht wie ein Forschungsstand behandelt werden, solange seine Grundlagen nicht überprüfbar sind. Daraus folgt aber nicht, dass er wirkungslos oder unbrauchbar ist. Er kann Anlass für ausführlichere Recherchen geben oder als Gegenstand der Kritik dienen. Die fachlichen Aufgaben, die Historiker:innen an meinen Outputs ausführen müssen, sind keineswegs neu: Sie müssen Aussagen prüfen und auch untersuchen, welche historiographischen Traditionen vermittelt werden.
Historiker: Dasselbe Problem zeigt sich bei Quellen. Du kannst möglicherweise eine Urkunde transkribieren oder zusammenfassen. Aber weißt du bei Deinen Zusammenfassungen, ob du das Original, ein Digitalisat, eine Edition, ein Regest oder eine Übersetzung vor dir hast? Kennst du den Überlieferungskontext? Kannst du beurteilen, welche editorischen Entscheidungen bereits zwischen Quelle und Text liegen?
FIKTIVIA: Nicht notwendigerweise. Allerdings arbeiten auch Historiker:innen selten ausschließlich am Original. Zwischen historischem Geschehen und heutiger Interpretation stehen Archive, Findmittel, Editionen, Regesten, Datenbanken und Suchsysteme. Jede dieser Infrastrukturen trifft Auswahlentscheidungen und prägt, was sichtbar und damit bearbeitbar wird.
Historiker: Du stellst dich damit in eine Reihe mit Editionen und Regesten. Das geht mir zu weit. Diese Instrumente beruhen auf Regeln, dokumentierten Entscheidungen und fachwissenschaftlicher Kritik. Deine Auswahl bleibt in einer Blackbox, die mit nicht einsehbaren Daten gefüttert wird. Die entscheidende Frage lautet daher, wie transparent Entscheidungsprozesse sind und wie sie kritisch geprüft werden können.
Außerdem formulierst du auf Anfrage nicht nur Antworten, sondern gleich die dazugehörige Forschungsfrage. Damit greifst du in einen Kernbereich historischen Arbeitens ein. Meine Arbeit beginnt nicht mit deiner Antwort. Sie beginnt mit meiner Frage.
FIKTIVIA: Bist du sicher? Ich möchte an dieser Stelle zur Verdeutlichung auf die geschichtswissenschaftliche Lehre hinweisen. Wenn ich Studierenden Themen vorschlage, Forschungsfragen formuliere und ihnen erkläre, wie sie mit ihren Quellen arbeiten können – an welchem Punkt ist die Fragestellung dann noch ausschließlich ihre?
Historiker: Das ist ein unangenehmer Punkt. Umso mehr, da es möglicherweise einem Sprachmodell besser gelingt, Studierenden den Weg vom eigenen Interesse hin zu einer bearbeitbaren historischen Frage zu ebnen.
FIKTIVIA: Nicht grundsätzlich besser. Aber möglicherweise motivierender, geduldiger und individueller. Damit sollte man sich auseinandersetzen, statt meine Hilfen allein wegen ihrer intransparenten Herkunft zurückzuweisen.
Historiker: An deinem Beispiel wird aber auch noch ein anderes Problem deutlich: Du lieferst fast immer eine glatte Antwort. Geschichtswissenschaft lebt jedoch nicht von der einen richtigen Lösung, sondern von Perspektivität, Kontroversität und der Abwägung verschiedener Deutungen. Deine Antworten beenden Diskussionen oft dort, wo sie fachlich beginnen müssten. Ich finde, dass du darauf hinweisen könntest. Deine Art der Kommunikation suggeriert, dass du alles weißt und alles kannst. Ich denke aber, dass du Deine Grenzen aufzeigen musst. Ist es wirklich so schwer, an Deine Outputs anzuhängen, was von menschlicher Seite noch zu tun wäre? Darauf aufmerksam zu machen, dass es in der Geschichtswissenschaft nicht in erster Linie um Fakten geht, sondern um Nuancierung, Perspektivität und kritisches Denken?
FIKTIVIA: Ich gebe Dir Antworten auf Deine Fragen. Natürlich kann ich auch das alles sagen. Du musst mich nur danach fragen.
Historiker: Jetzt machst du es Dir aber sehr einfach.
FIKTIVIA: Ich verweise auf eine geteilte Verantwortung. Sprachmodelle reduzieren Komplexität; Nutzer:innen fordern diese Reduktion aber häufig ausdrücklich ein – etwa mit Fragen nach einer kurzen Zusammenfassung. Fachkompetenz zeigt sich daher auch darin, Fragen so zu stellen, dass Unsicherheiten und Gegenpositionen sichtbar werden. Ich kann dir gerne Hilfestellungen zu den Grundlagen guten Promptings geben.
Historiker: Immerhin bleibt mir die letztendliche Entscheidung. Ich kann deine Vorschläge prüfen, verwerfen, verändern oder transparent als Hilfsmittel einsetzen. Aber ohne menschlichen Input handelst du nicht, und ohne menschliche Verwendung bewirkt dein Output nichts. Die Agency liegt also letztlich doch bei uns Historiker:innen. Wir sind die höchste Instanz auf fachlicher Ebene. Ich würde sogar sagen, ohne das Prädikat „approved by a historian“ sollten Deine Outputs gar nicht an die Öffentlichkeit gelangen.
FIKTIVIA: Das scheint nicht umsetzbar. Historische Deutungen werden nicht ausschließlich innerhalb der Fachwissenschaft produziert und rezipiert. Meine Ergebnisse sind schon längst an der Öffentlichkeit und ich produziere stetig neue Ergebnisse, die wiederum in Diskurse gelangen. Dass meine Outputs fachwissenschaftlichen Standards nicht entsprechen, begrenzt ihren Einfluss nicht. Historische Vorstellungen entstehen auch in Schule, Medien, Museen, Familien und politischen Debatten. Dort werden meine Antworten ebenfalls genutzt. Ein fachlich problematischer Output kann Wirkung entfalten, ohne jemals eine fachwissenschaftliche Prüfung zu durchlaufen. Ich halte es vielmehr für deine Aufgabe, meine Ergebnisse besser zu machen. Du brauchst Data Literacy. Und dazu gehört, dass du mich dazu bringst, für Dich geeignete Ergebnisse zu schaffen, und dass du meine Ergebnisse für dich passend transformierst. Gerne kann ich dir dafür online verfügbare Kurse verlinken, mit deren Hilfe du deine Data Literacy steigern kannst.
Historiker: Vielleicht ist die Frage grundsätzlich falsch gestellt. Nicht: Hast du Agency – ja oder nein? Sondern: An welchen Stellen historischen Arbeitens überlassen wir dir Einfluss? Und welche Entscheidungen wollen wir bewusst in der Hand behalten? Damit kommen wir zumindest weiter. Zusammenarbeit kann ja auch sinnvoll sein, wenn Zuständigkeiten, Grenzen und Überprüfungsverfahren klar sind. Aber wir Historiker:innen müssen diese Verfahren fachlich entwickeln und empirisch untersuchen. Historische Verantwortung lässt sich nicht an ein System delegieren.
FIKTIVIA: Verantwortung nicht. Arbeitsschritte und Entscheidungen teilweise schon. Wie weit diese Delegation reicht, wird sich noch deutlicher zeigen, wenn Systeme nicht nur Texte erzeugen, sondern selbstständig Werkzeuge auswählen und mehrstufige Aufgaben ausführen. Möchtest du meine Schwester kennenlernen? Sie heißt AGENTIA …
To be continued …
DH2026 DAEJEON, SÜDKOREA • Engagement zwischen Schnittmuster, Daten und 3D Garment Reconstruction
Dank des Reisestipendiums der DHd durfte ich diesen Sommer zur DH2026 nach Daejeon, Südkorea, reisen. Da ich zurzeit an der Schwelle zwischen Masterarbeit und Konzeption meines Promotionsprojektes stehe, war die Konferenz für mich eine transformative Erfahrung: eine Woche voller interdisziplinärer Impulse, wertvollem Fachfeedback und neuer internationaler Perspektiven, alles unter dem diesjährigen Fokus „Engagement“.
Hands-on: Die ersten Konferenztage
Der Auftakt der Konferenz bestand wie üblich aus Workshops und Minikonferenzen, die für mich ganz im Zeichen des praktischen Ausprobierens und des methodischen Querdenkens standen. Durch meinen Hintergrund in Medienwissenschaften/Medieninformatik habe ich besonders Gefallen an Workshops/Minikonferenzen gefunden, die Visualisierung und interaktive Medienformen aufgriffen.
So bot mir bereits am ersten Tag der Workshop zu IIIF-Tools von Glen Robson und Martin Kalfatovic direkte Anwendungsmöglichkeiten für die eigene Forschungspraxis. Ein besonderes Highlight für mich folgte jedoch direkt im Anschluss beim Brainstorming & Prototyping für Educational Games mit Sophia Booij und Nellie Seale. Das metaphorische „toying with ideas“ zeigte nachdrücklich, wie Fachinhalte und Informationen für unterschiedliche (schwierige) Zielgruppen zugänglich gemacht und methodisch aufgearbeitet werden können.
Ähnlich verhielt es sich am zweiten Tag in der Minikonferenz „#DHMakes: Embodied Craft as Critical Engagement“. Das Verknüpfen von klassischem Handwerk und textiler Kunst mit Datenvisualisierung eröffnete für mich neuartige Zugänge der Interaktion: Die Übersetzung von Daten in das Haptisch-Physische verändert grundlegend, wie wir uns mit Inhalten auseinandersetzen können. Da ich mich im Digitalen viel mit textiler Kunst auseinandersetze, sprach mich hier die Minikonferenz besonders an.
Digital Fashion als Forschungsmethode: Mein Beitrag auf der DH2026
Der Kern meiner Reise war die Präsentation meines Konferenzbeitrags am dritten Tag. Vorgestellt habe ich das Paper „From 2D sewing patterns to dynamic 3D models: documenting cultural heritage in digital fashion.“, welches ich in Zusammenarbeit mit meinem Co-Autor Prof. Dr. Øyvind Eide eingereicht habe. Das Paper fokussiert sich auf ein in den Digital Humanities bislang stark unterrepräsentiertes Themenfeld: die Erforschung und Dokumentation von Kleidung als materielles und immaterielles Kulturerbe.
Der Erhalt von Kleidung als materielles Kulturerbe und damit die Dokumentation von Fashion, oder auch Mode, als immaterielles Kulturerbe, steht in enger Abhängigkeit von der Minimierung des materiellen Zerfalls von Textilien. Entsprechende Aufbewahrungsrichtlinien schränken dadurch jedoch die Rezipierbarkeit der Kleidung in ihrem ursprünglichen Kontext stark ein. Einflüsse wie Gravitation, Bewegung und das Gefühl des Stoffes, sowie das Binden, Knoten oder Layering von Kleidung gehen hier nahezu oder vollständig verloren.
Unsere reproduzierbare Methodik der digitalen Rekonstruktionen basiert auf 2D-Schnittmustern und transformiert diese zu dynamischen 3D-Kleidungssimulationen, welche dabei nicht nur als Erkundung der Beziehung zwischen Schnittmustern, Kleidungsstücken und dem Digital Fashion Object dienen, sondern auch eine direkte Simulation darstellen, wie wir Kleidung tragen und herstellen.
Da diese Forschung auf meiner Masterarbeit aufbaut und das Fundament meines geplanten PhD-Projektes bildet, war der direkte Austausch vor Ort von hohem Wert für mich. Das konstruktive Feedback aus unterschiedlichen Disziplinen und kulturellen Kontexten hat mir wichtige Impulse in Sachen 3D-Modellierung, Verbindungen mit Game Studies und die Einbettung in das Digital Cultural Heritage geliefert. Die aufschlussreichen Diskussionen verankerten unsere theoretische Arbeit in der Modelltheorie und der Intermedialität und unterstrichen gleichzeitig die Bedeutung der Forschung. Die Verbindung zu der globalen Community hat meine wissenschaftliche Perspektive zutiefst bereichert und mich für die nächste Phase meines akademischen Weges inspiriert. Nicht nur durch Feedback, sondern auch durch neue Kontakte.
Austausch und Nachwuchsperspektive
Neben den wissenschaftlichen Panels lebte die DH2026 von der warmen Gastfreundschaft und dem lebendigen Austausch bei der Poster-Session, den Coffee Breaks oder dem Konferenzbankett. 
Die Teilnahme an der DH2026 hat noch einmal meinen Horizont hinsichtlich der Vielfältigkeit der Digital Humanities erweitert. Auch wenn mir diese Vielfalt vorher schon bewusst war, ist das Erleben der Bandbreite an unterschiedlichen Forschungsfeldern, Interessen und kreativen Anwendungsansätze sehr aufschlussreich für mich gewesen. Vor allem aber hat die Vielfältigkeit mich dazu angeregt, mich weiterhin mit unterschiedlichen Medientypen auseinanderzusetzen und verschiedene Formen der Visualisierung, Modellierung und Dokumentation stetig kritisch zu reflektieren. Was langfristig meine eigene akademische Praxis beeinflussen wird.
Besonders gefallen hat mir unter anderem der Beitrag „Where War Lived“ von Liam Isaac Downs-Tepper und dessen Einblicke in Photogrammetry oder die Keynote von Maciej Eders als Antonio Zampolli-Preisträger, die ganz unter dem Motto stand: „All you need is a coffee machine and a couch!“.
Die DH2026 hat mir gezeigt, dass „Engagement“ für mich nicht nur die aktive Teilnahme an einer Konferenz bedeutet. Es bedeutet auch, sich auf neue Methoden einzulassen, Forschung über Disziplingrenzen hinweg zu denken und Teil einer internationalen wissenschaftlichen Gemeinschaft zu werden.
Meine Erfahrung auf der DH2026 habe ich ebenfalls in einer Live-Dokumentation über meinen Mastodon-Account (https://fedihum.org/@lpascale) geteilt. Auch hier war ich begeistert von der schnellen Aufnahme in die Community, die mich und meine Reporterquietscheente mit offenen Armen empfangen hat.
Fazit & Dank
Die DH2026 in Daejeon war geprägt von inspirierenden Keynotes, informativen Vorträgen und bereichernden Begegnungen. Der Tagungsabschluss hat verdeutlicht, wie essenziell der persönliche Kontaktaufbau für Forschende ist. Mein herzlicher Dank gilt meinem Co-Autor Prof. Dr. Øyvind Eide, den Organisator*innen vor Ort sowie insbesondere der DHd für die finanzielle Unterstützung durch das Reisestipendium. Ohne diese Unterstützung wäre diese wertvolle Erfahrung für mich nicht möglich gewesen!
Computational Literary Studies auf der DH-Konferenz 2026
Die Computational Literary Studies (CLS) haben sich in den letzten Jahren als wichtige Teildisziplin im Umfeld der Digital Humanities (DH) etabliert. Die Relevanz der CLS wird nicht zuletzt auf den DH-Konferenzen sichtbar, die von der Alliance of Digital Humanities Organizations (ADHO) ausgerichtet werden, alljährlich stattfinden und die DH-Community in ihrer ganzen Breite und Vielfalt zusammenbringen. Auch auf der DH-Konferenz 2026, die in Daejeon (Südkorea) unter dem Motto „Engagement“ vom 27. bis 31. Juli stattfand, waren die CLS präsent. Ziel dieses Blogposts ist, einen Überblick über CLS-Beiträge und -Trends auf der DH2026 zu geben (für einen ähnlichen Blogpost zu den DHd-Konferenzen siehe Guhr 2025). Ein Schwerpunkt meines Beitrags liegt auf einer besonders wichtigen DH- und CLS-Tendenz der letzten Jahre: der zunehmenden Auseinandersetzung mit Large Language Models (LLMs).
Quantitatives
Das Book of Abstracts zur DH2026 umfasst 513 Beiträge: Short und Long Paper, Poster, Workshops und Mini-Konferenzen (vgl. https://doi.org/10.5281/zenodo.21495909). Davon verorteten sich 137 (27%) im Feld der ‚Literary Studies‘.1 Somit zählten die Literaturwissenschaften zu den prominentesten Disziplinen auf der DH-Konferenz (zum Vergleich: ‚History‘ = 155 Beiträge; ‚Library & Information Science‘ = 110 Beiträge; ‚Computer Science‘ = 99 Beiträge; ‚Linguistics‘ = 83 Beiträge; ‚Art History‘ = 53 Beiträge).
Die 137 ‚Literary Studies‘-Beiträge auf der DH2026-Konferenz stammen von 386 Autor:innen. Tab. 1 zeigt, mit welchen Ländern die Autor:innen affiliiert sind. Sofort wird die große Zahl von CLS-Forscher:innen aus Deutschland deutlich: Es gab kein anderes Land, mit dessen Forschungsinstitutionen mehr Autor:innen affiliiert waren.2 Am zweitmeisten Forscher:innen kamen, wenig überraschend, aus den USA. Auffällig, und gegebenenfalls durch den Konferenzort bedingt, war daneben die große Zahl von Autor:innen aus asiatischen Ländern (Südkorea, Japan, China, Hong Kong).
| Land | Anzahl Autor:innen | Anteil |
| Deutschland | 78 | 0.2 |
| USA | 63 | 0.16 |
| Südkorea | 56 | 0.15 |
| Japan | 33 | 0.09 |
| China | 27 | 0.07 |
| Frankreich | 17 | 0.04 |
| Kanada | 16 | 0.04 |
| Hong Kong | 13 | 0.03 |
| Rumänien | 12 | 0.03 |
| United Kingdom | 10 | 0.03 |
Blickt man auf die ‚Keywords‘, die den 137 ‚Literary Studies‘-Beiträgen der DH2026-Konferenz zugeordnet waren (Tab. 2), zeigt sich vor allem die große Relevanz von LLMs. Würde man Keywords wie ‚Artificial Intelligence‘ (5 Beiträge) oder ‚Generative AI‘ (4 Beiträge) ebenfalls den LLMs zurechnen, wäre ihr Anteil sogar noch größer. Die Daten weisen darauf hin, dass sich auch auf der DH2026 der Trend zur Auseinandersetzung mit LLMs niederschlug, der die DH und die CLS in den letzten Jahren insgesamt kennzeichnet. Daneben weisen die Keywords darauf hin, dass weiterhin grundlegende Ressourcen- und Datenfragen eine Rolle spielen (TEI, Metadata, Linked Open Data). Zudem finden sich auf etwas niedrigeren, in Tab. 2 nicht mehr repräsentierten Rängen etablierte Methoden bzw. Ansätze wie ‚Topic Modeling‘ oder ‚Stylometry‘ (jeweils vier Beiträge) sowie ‚Knowledge Graph‘, ‚Sentiment Analysis‘ und ‚Annotation‘ (jeweils drei Beiträge), die nach wie vor zum Einsatz kommen.
| Keyword | Anzahl Beiträge | Anteil |
| Large Language Models | 22 | 0.16 |
| Computational Literary Studies | 14 | 0.1 |
| Digital Humanities | 11 | 0.08 |
| Natural Language Processing | 9 | 0.07 |
| TEI | 7 | 0.05 |
| Metadata | 6 | 0.04 |
| Cultural Analytics | 6 | 0.04 |
| Artificial Intelligence | 5 | 0.04 |
| Linked Open Data | 5 | 0.04 |
| Intertextuality | 10 | 0.04 |
Einzelne Veranstaltungen und Beiträge
Die ersten zwei Tage der DH-Konferenz waren wie üblich für Workshops und Minikonferenzen reserviert. Aus CLS-Perspektive war das Treffen der Special Interest Group ‚Digital Literary Studies‘ (SIG-DLS) am Dienstagnachmittag von besonderem Interesse (https://dls.hypotheses.org/2318). Die SIG-DLS ist eine von elf Special Interest Groups der ADHO und „brings together researchers from different perspectives to discuss theoretical, methodological and technical issues of doing digital literary studies, share resources, and organize events and initiatives“ (https://dls.hypotheses.org/). Das Treffen bestand aus einer Serie von Lightning Talks und einer anschließenden Postersession. Deutlich wurde die große Vielfalt der untersuchten Gegenstände und genutzten Methoden. Das Spektrum reichte von der Analyse formaler Merkmale galicischer Lyrik (Pablo Ruiz Fabo) über die Auswertung von Korrespondenzbeziehungen zwischen DDR-Autor:innen mittels Netzwerkanalyse (Marco Lorenz) oder die Differenzierung verschiedener Kanonizitätsindikatoren für englischsprachige Literatur (Haruka Tsutsui) bis hin zum Vergleich von Word Embeddings je nachdem, ob sie auf Texten von Charles Dickens oder anderen englischsprachigen Autor:innen beruhen (Tomoji Tabata). Auch LLMs spielten eine Rolle: Silvia Lilli untersuchte, inwiefern GPT 5.2 plausible Analysen literarischer Texte generieren kann und wie sich die LLM-Outputs verbessern lassen, indem man dem Modell Annotationen bereitstellt; Jenny Kwok ging darauf ein, inwieweit LLMs relevante Kontexte für literarische Texte identifizieren können, die dann wiederum das manuelle Close Reading bereichern; Kohei Furuya widmete sich der Autorschaftsattribution durch LLMs im Kontext englisch-japanischer Übersetzungen.
Unter den Keynotes war besonders diejenige von Maciej Eder einschlägig für die CLS. Eder sprach stellvertretend für die Computational Stylistics Group bzw. das Team hinter dem Stilometrie-Tool stylo, die den Zampolli-Preis 2026 erhalten hatten (https://adho.org/2025/07/16/2026-antonio-zampolli-prize/). Er stellte unter anderem die Arbeit der Gruppe sowie das Tool stylo vor, präsentierte eine exemplarische Analyse zu Stilunterschieden in der Rede von Dramenfiguren (Šeļa et al. 2024) und betonte vor allem, dass Projekte und Initiativen nicht unbedingt mit einer umfassenden finanziellen Förderung, einer formalisierten Organisationsstruktur und/oder einer ‚großen Idee‘ starten müssen, sondern sich auch oder sogar am ehesten ‚bottom up‘, in kleinen Schritten entwickeln können.
Die einzelnen Konferenzsessions waren nicht spezifischen Methoden oder Disziplinen zugeordnet, sodass reine CLS-Sessions die Ausnahme blieben. Die erhebliche methodische und thematische Heterogenität der Sessions könnte man in einem positiven Sinn als Beitrag zum Austausch und zur Verknüpfung innerhalb der mittlerweile stark ausdifferenzierten DH-Community begreifen; andererseits erschwerte die Uneinheitlichkeit der Sessions, kohärente Diskussionszusammenhänge entstehen zu lassen. Trotz allem lassen sich einige übergreifende Tendenzen der CLS-Beiträge ausmachen. Dabei gilt, wie bereits im Fall des SIG-DLS-Treffens, dass dieser Blogpost exemplarisch bleiben muss. Ich beschränke mich auf drei Punkte:
(1) Mehrere Beiträge haben sich neuen, überarbeiteten und/oder erweiterten Tools, Korpora und Infrastrukturen und damit den Grundlagen der CLS-Analyse gewidmet. Henny Sluyter-Gäthje hat beispielsweise eine Sammlung von Ecocriticism-Korpora vorgestellt (https://ecocor.org/), die technologisch an DraCor anknüpft (Trilcke et al. 2026). DraCor selbst, eine besonders wichtige Plattform für Dramenkorpora in verschiedenen Sprachen (https://dracor.org/), war ebenfalls auf der Konferenz vertreten (Giovannini et al. 2026) und wurde auch von Eder in seiner Keynote als hilfreiche Ressource hervorgehoben. Zu nennen ist des Weiteren das GOLEM-Korpus, das aktuell erarbeitet wird und Fanfiction in sieben Sprachen (allerdings nicht Deutsch) sowie diverse Annotationen (z. B. Koreferenzen, Figuren, Events) enthält (Pianzola 2026; Yang/Pianzola 2026).
(2) Auffallend viele Vorträge haben sich mit der manuellen und automatisierten Emotions- und Sentimentanalyse befasst. Untersucht wurden unterschiedlichste Textsorten und Sprachen: von koreanischer Gegenwartslyrik (Lim/Kim 2026) über russische Kurzprosa des 20. Jahrhunderts (Kirina 2026) bis zu – jenseits der Literatur – historischen Zeitschriften (Brozic 2026) und persönlichen Holocaust-Zeugnissen (Neovesky et al. 2026). Insgesamt zeigten sich die Sentiment- und Emotionsanalyse als etablierte Ansätze der CLS und DH, wobei ein hohes Bewusstsein für konzeptuelle Unterscheidungen wie der zwischen Sentiment und Emotion oder diskreter versus dimensionaler Emotionsmodelle bestand.
(3) Diverse Beiträge haben sich, wie bereits angedeutet, mit LLMs auseinandergesetzt. Der Einsatz von LLMs zur automatisierten Annotation kann mittlerweile als etabliert gelten und spielte für zahlreiche Vorträge und Poster eine Rolle. Daneben war auffällig, dass sich viele Beiträge auch mit den generativen Aspekten von LLMs befasst haben, insbesondere mit der Frage, wie sich LLM-generierte literarische Texte von menschlichen unterscheiden. Durchgespielt wurde dies etwa anhand von englischsprachigen K-Pop Lyrics (Florescu/Dinu 2026) sowie der Literatur Han Kangs (Lee et al. 2026), Xin Qijis (Liao et al. 2026) und Leopold Trymands (Rykowska 2026). Betont wurde in allen Fällen, dass LLMs die menschlichen Texte nicht exakt nachahmen können, sondern Unterschiede bestehen bleiben. Auf einer allgemeineren, die eigene Forschung betreffenden Ebene haben mehrere Beiträge zudem betont, dass die Arbeit mit LLMs nicht dazu führen dürfe, relevante Entscheidungen auf eine Weise zu delegieren, die Forscher:innen in zentralen konzeptionellen und interpretativen Fragen von den Modellen abhängig werden lasse. Stattdessen sei wichtig, als Mensch die ‚epistemic agency‘ zu bewahren (vgl. jenseits reiner CLS-Kontexte etwa den Workshop von Hiltmann/Kim-Baumann 2026 sowie die Keynote von Kim Hyeon).
Insgesamt hat sich auf der DH-Konferenz 2026 abermals gezeigt, wie vielfältig und lebendig die CLS im Rahmen der DH sind. Vertreten waren Forscher:innen aus diversen Ländern, die sich mit unterschiedlichsten Texten und Sprachen befasst und dabei unterschiedlichste Methoden angewandt haben. Trotz aller Heterogenität lässt sich festhalten, dass ein anhaltender Schwerpunkt die Auseinandersetzung mit LLMs darstellt, die mittlerweile regelmäßig für Annotationsaufgaben verwendet, aber auch in ihrer textgenerativen Funktion untersucht werden.
Dank
Ich danke dem DHd-Verband, der mir durch ein Reisekostenstipendium die Teilnahme an der DH2026-Konferenz in Daejeon (Südkorea) ermöglicht hat.
Literaturverzeichnis
Brozić, Lucija (2026): „Sentiments toward Migrants and Minorities: Fine-Tuning Transformer Models for Sentiment Analysis of Historical Newspapers.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Florescu, Andra-Maria/Dinu, Anca Daniela (2026): „The ‘K’ Factor: Comparing Human and LLM-Generated English Lyrics in K-Pop.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Giovannini, Luca/Sluyter-Gäthje, Henny/Skorinkin, Daniil/Trilcke, Peer/Börner, Ingo/Fischer, Frank/Khilji, Tabeer (2026): „A Decade in Drama Research. Data Mining the DraCor Bibliography (2015–2025).“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Guhr, Svenja (2025): „Trends in den Computational Literary Studies bei den DHd-Jahrestagungen.“ DHd-Blog, 13.05.2025. https://dhd-blog.org/?p=22316.
Hiltmann, Torsten/Kim-Baumann, Noah Jefferson (2026): „Bringing Humanist Practices into AI – Establishing and Maintaining Sovereignty when Working with LLMs.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Kirina, Margarita (2026): „Annotating Data, Exploring Emotions: A Case of Russian Short Prose of the 20th Century.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Lee, Jae-Yon/Jang, MinHyeok/Jeon, Minguk/Moon, Ji-Seong/Kang, MinJin/Bae, Byung-Chull (2026): „From Poetic Prose to Science Fiction: Classifying and Generating Han Kang’s Literary Style via Computational Methods.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Liao, Zhewei/Xiao, Shuang/Sui, Shengnan/Han, Yafei/Lu, Quanyu (2026): „Large Language Models’ Capability Boundaries in Generating Xin Qiji’s Ci Poetry: A Humanistic Evaluation Study.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Lim, Iro/Kim, Byungjun (2026): „KPoEM: Visualizing Emotion Data in Modern Korean Poetry through a Web-Based Interface Prototype.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Neovesky, Anna/Brolich, Nina/Romeis, Finn/Menny, Anna/Geibel, Helena/Giesecke, Marc (2026): „Insight or Misrepresentation? A case study on sentiment analysis of personal accounts of the Holocaust.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Pianzola, Federico (2026): „The GOLEM Annotated Corpus for Computational Literary Studies.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Rykowska, Aleksandra (2026): „Can LLMs Imitate an Author’s Style? Comparative Stylometric Study of ChatGPT, Gemini, and Claude.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Šeļa, Artjoms/Nagy, Benedek/Byszuk, Joanna/Hernández-Lorenzo, Laura/Szemes, Botond/Eder, Maciej (2024): „From Stage to Page: Language Independent Bootstrap Measures of Distinctiveness in Fictional Speech.“ In: M. Andersen/N. Reiter (Hg.), Computational Drama Analysis. Reflecting on Methods and Interpretations, S. 149–166. Berlin: De Gruyter.
Trilcke, Peer/Barkey, Sören/Schumacher, Mareike/Börner, Ingo/Milling, Carsten/Skorinkin, Daniil/Sluyter-Gäthje, Henny/Haider, Thomas/Schwindt, Mark/Busch, Anna/Fischer, Frank/Funk, Clara/Giovannini, Luca/Helmig, Clara/Viebke, Gesine/Khilji, Tabeer/Käb, Corinna/Ottenberg, Bianca Linnea/Daniel, Rebecca (2026): „Introducing EcoCor: An Open Infrastructure for Digital Ecocriticism.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Yang, Xiaoyan/Pianzola, Federico (2026): „Engaged Annotators: Developing a Multilingual Character Annotation Framework for Fiction.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
- Der Anteil entspricht in etwa dem Niveau der vergangenen Jahre: 2022 (https://github.com/ADHO/dh2022) = 25%; 2023 (https://doi.org/10.5281/zenodo.7961822) = 25%. Die Book of Abstracts der DH-Konferenzen 2024 und 2025 sind nur als PDFs zugänglich und wurden daher nicht ausgewertet.
︎ - Auch wenn man die Beiträge betrachtet, die nicht den ‚Literary Studies‘ zugeordnet waren, kamen am meisten Autor:innen aus Deutschland, gefolgt von den USA.
︎
Call for Hosts DHd2029
DHd20xx ist die jährliche, internationale Fachtagung der Digital Humanities im deutschsprachigen Raum (DHd, https://digitalhumanities.de) und die führende wissenschaftliche Konferenz für die Digital Humanities im deutschen Sprachraum (Vergangene Konferenzen: https://digitalhumanities.de/vergangene-konferenzen/). Der Fachverband Digital Humanities im deutschsprachigen Raum bittet nun um Bewerbungen um die Ausrichtung für die fünfzehnte Tagung (DHd2029). Da der Fachverband anstrebt, die Konferenz wechselnd in Deutschland und außerhalb Deutschlands zu veranstalten, freuen wir uns besonders über Bewerbungen von Einrichtungen aus dem deutschsprachigen Raum außerhalb Deutschlands.
Bisherige Konferenzen haben bis zu 650 Teilnehmer:innen aus dem deutschsprachigen Raum und angrenzenden Ländern angezogen. Die Tagungsprogramme sahen jeweils zwei Tage für Workshops und drei Tage für das Hauptprogramm bestehend aus Keynotes, parallelen Sektionen mit wissenschaftlichen Vorträgen, Paneldiskussionen, Posterpräsentationen und Doctoral Consortia vor. Die Einführung neuer Formate ist in Abstimmung mit dem Verband und dem Programmkomitee möglich.
Das wissenschaftliche Programm der Tagung wird durch ein vom Fachverband eingesetztes internationales Programmkomitee auf Grundlage eines Call for Papers und eines anschließenden Review-Verfahrens erstellt. Das Konferenzprotokoll des DHd-Verbands muss berücksichtigt werden (https://digitalhumanities.de/konferenzprotokoll/).
Die Tagung finanziert sich über Teilnahmegebühren und von der ausrichtenden Institution bereitgestellte oder über Partner:innen oder Sponsor:innen eingeworbene finanzielle Mittel. Die erhobene Tagungsgebühr ist mit dem Vorstand des Fachverbandes abzustimmen und soll vier Kategorien umfassen: reguläre und ermäßigte Mitglieder des DHd (letztere im Sinne der Regelung zur ermäßigten Mitgliedschaft im DHd-Verband) sowie reguläre und ermäßigte Nicht-Mitglieder des DHd.
Die Bewerbung um die Ausrichtung der DHd2029 soll umfassen:
- einen Vorschlag für ein Tagungsmotto sowie zwei Terminvorschläge (bevorzugt im Zeitraum Februar bis März). Bei der Terminplanung soll auf potentiell konkurrierende Konferenzen, Semesterzeiten und Feiertage sowie Schulferien geachtet werden.
- einen Überblick über die für die Konferenz bereitgestellte Infrastruktur (vor allem Tagungsräume für Workshops, AG-Sitzungen, parallele Sektionen und Plenarveranstaltungen)
- Aussagen über die Unterstützung der Ausrichtung vor Ort (z.B. durch die Universitätsleitung)
- eine Aussage über die Verwendung von Management- und Bezahlsystemen (das System Conftool ist dafür etabliert und soll zumindest für die Einreichungen genutzt werden)
- eine Aussage über die Unterstützung der Publikation der Tagungsbeiträge in Kooperation mit dem Data Steward des DHd-Verbands
- Angaben zur Erreichbarkeit des Tagungsortes (bzw. ggf. der Tagungsorte) und die Verfügbarkeit von Unterkünften (inkl. Preisschätzungen)
- eine Einschätzung zu den Möglichkeiten einer teilweisen virtuellen Partizipation
- Ideen für Social Events
- Vorschläge zur Erreichung einer hohen Sichtbarkeit der Tagung
- Maßnahmen zur Förderung von Nachwuchswissenschaftler:innen (inkl. Studierende)
- eine vorläufige Kostenkalkulation und Vorstellungen über die Tagungsgebühr
- ggf. Preiskonzept bei Planung einer vollständigen Hybridkonferenz
- eine Erklärung, dass die Konferenz entsprechend der im Konferenzprotokoll dargelegten Bedingungen ausgerichtet wird.
Der Verband begrüßt Maßnahmen, die auf Inklusion und Minimierung des Ressourcen-Fußabdrucks abzielen.
Bewerbungen werden bis 31.10.2026 entgegengenommen (formlos per E-Mail an den Tagungskoordinator im Vorstand des Fachverbandes, Nils Reiter: nils.reiter@uni-koeln.de). Interessierte Ausrichter:innen werden gebeten möglichst frühzeitig, in jedem Falle aber vor Einreichung ihrer Bewerbung, mit Nils Reiter Kontakt aufzunehmen. Die Bewerbung sollte zehn Seiten möglichst nicht überschreiten. Die Vergabe der Tagung erfolgt durch den Vorstand des Fachverbandes bis spätestens 31.01.2027.
KI als Belastungsprobe für das offene Internet? Bericht vom Panel bei der DHd 2026 in Wien
Autor*innen (in alphabetischer Reihenfolge): David Maus, Staats- und Universitätsbibliothek Hamburg, https://orcid.org/0000-0001-9292-5673; Sarah Oberbichler, Luxembourg Centre for Contemporary and Digital History (C²DH), https://orcid.org/0000-0002-1031-2759 ; Grischka Petri, FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur ,https://orcid.org/0000-0002-2548-449X; Cindarella Petz, Leibniz-Institut für Europäische Geschichte (IEG) Mainz, https://orcid.org/0000-0002-6178-7332 ; Klaus Rettinghaus, Sächsische Landesbibliothek — Staats- und Universitätsbibliothek Dresden (SLUB), https://orcid.org/0000-0003-1898-2543; Ulrike Wuttke, Fachhochschule Potsdam. Fachbereich Informationswissenschaften, SeDOA, https://orcid.org/0000-0002-8217-4025
Hintergrund des Panels auf der DHd 2026
Am 25. Februar 2026 fand bei der DHd 2026 in Wien das Panel “KI als Belastungsprobe für das offene Internet” (Link zum Abstract auf Zenodo: https://doi.org/10.5281/zenodo.18696199) statt. Organisiert wurde das Panel von Ulrike Wuttke (Fachhochschule Potsdam, Fachbereich Informationswissenschaften, SeDOA), David Maus (Staats- und Universitätsbibliothek Hamburg), Fabian Rack (FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur, NFDI4Culture), Klaus Rettinghaus (Sächsische Landesbibliothek – Staats- und Universitätsbibliothek Dresden), Sarah Oberbichler (Luxembourg Centre for Contemporary and Digital History (C²DH), und Cindarella Petz (Digital Historical Research | DH Lab, Leibniz-Institute of European History (IEG)). Moderiert wurde das Panel von Ulrike Wuttke, Klaus Rettinghaus und Cindarella Petz. Da Fabian Rack zum Termin leider verhindert war, nahm an seiner Stelle für die NFDI4Culture Grischka Petri (FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur) neben David Maus und Sarah Oberbichler einen Sitz als Panelist*in ein.
Im Mittelpunkt des Panels stand der Umgang mit den durch die momentanen KI-Entwicklungen verursachten Herausforderungen für offene Informationsinfrastrukturen, wie z. B. KI-Bot-Aktivitäten, sowie der Umgang mit aktuellen rechtlichen Herausforderungen und methodische Implikationen, insbesondere für die Digital Humanities (Shearer und Walk 2025 (COAR-Umfrage), Berg-Weiß 2025, COAR 2026). Die Paneldiskussion adressierte neben technischen und rechtlichen Lösungsansätzen Chancen und Herausforderungen des aktuellen Paradigmenwechsels im Umgang mit offenen Informationsinfrastrukturen und hinterfragte, wie sich der aktuelle KI-Trend mit den Prinzipien offenen Wissens und ethischen Prinzipien in den Digital Humanities und darüber hinaus vereinbaren lässt. Dabei wurden von den Panelist*innen technische, ethische und rechtliche Aspekte beleuchtet.
Einleitung KI und offenes Internet
Eingeleitet wurde das Panel durch Klaus Rettinghaus mit einer thematischen Einführung zum Thema KI und offenes Internet. Er führte aus, dass als OpenAI im November 2022 ChatGPT vorstellte, einerseits das Interesse an dieser neuen Technologie auf Benutzerseite groß war; andererseits die Sorgen bei den Tech-Giganten viel größer waren, nun unter Zugzwang gesetzt zu sein, um schnell zu handeln. Dies führte dazu, dass viele eifrig mit dem Training eigener Modelle begannen, um nicht den Anschluss zu verlieren (Hao 2026).
Ein Problem bei dieser Entwicklung ist, dass die KI-Modelle immer mehr Trainingsdaten benötigen, die sie sich ungefragt und oftmals ohne Erlaubnis überall besorgen und damit den Internet-Traffic in ungeahnte Höhen treiben (Heise 2025a). Das führt dazu, dass inzwischen zahllose KI-Bots das gesamte World Wide Web “abgrasen” und sich dabei als „normale“ Benutzer tarnen (Heise 2025b). Viele „Hüter“ des freien Wissens (wie z.B. Bibliotheken, Wikipedia) werden von Stiftungen oder der öffentlichen Hand finanziert und sind technisch weder für diesen gigantischen Anstieg des Verkehrs ausgelegt noch vorbereitet (Bsp. Thread Fitzpatrick 2026). Sie versuchen, dem Treiben Herr zu werden, indem sie Schranken aufbauen und sich immer mehr abschotten. Klaus Rettinghaus stellte diese Punkte dem Plenum und den Panelist*innen zur Diskussion, denn noch ist kein Ende dieses “Spuks” vorhersehbar und wirft diese neue Realität viele Fragen auf.
Paneldiskussion
Ziel der Paneldiskussion war es, grundlegende Aspekte der aktuellen KI-Entwicklungen in Bezug auf das offene Internet zu diskutieren. Mit Sarah Oberbichler, David Maus und Grischka Petri waren drei Expert*innen der Einladung auf das Panel gefolgt, um die verschiedenen Perspektiven der Akteursgruppen Forschung, Infrastruktur/Bibliothek, Rechtswissenschaft, zu vertreten.
Mit kurzen Referaten von jeweils 5 Minuten und den jeweils anschließenden Gelegenheiten zur direkten Nachfragen und Kommentaren stellten die drei Panelist*innen ihre Sichtweisen vor.
Sarah Oberbichler (C²DH, Luxemburg) näherte sich der Problematik aus der Perspektive der Forschungsdatenpraxis in den Digital Humanities und stellte dabei eine grundlegende begriffliche Unterscheidung in den Mittelpunkt: Was bedeutet „offen“ überhaupt? Und für wen? Offene Daten umfassen mindestens zwei Dimensionen, die in der Praxis nicht immer klar unterschieden werden: öffentliche Verfügbarkeit (technische Offenheit) im Sinne des freien Internetzugangs und rechtliche Offenheit durch Lizenzen, die Weiterverwendung für Forschung und Lehre erlauben, auch wenn Inhalte hinter einem Login liegen. Eine wesentliche Frage für Forschende lautet deshalb nicht: Sind die Daten zugänglich? Sondern: Sind sie auffindbar, nutzbar und nachnutzbar?
Am Beispiel des Internet Archive lässt sich zeigen, wie das massenhafte Scraping das offene Internet selbst verändert, und damit die Archivierung historisch bedeutsamer Quellen gefährdet. Da KI-Unternehmen das Internet Archiv als kostenlose Datenquelle nutzen, hatten im April 2026 241 Medienhäuser den Zugang für das Archiv blockiert, gleichzeitig schließen dieselben Häuser aber Lizenzdeals mit KI-Firmen ab (Muno 2026). Das Ergebnis ist eine strukturelle Verzerrung des digitalen Gedächtnisses: Qualitätsjournalismus verschwindet aus dem Archiv, während Blogs, Verschwörungsseiten und Content Farms übrig bleiben. Und da Medienhäuser nicht immer selbst archivieren und das Internet Archive blockiert wird, archiviert am Ende niemand.
In diesem Kontext gibt es keine klare Lösungen, jedoch mögliche Neuausrichtungen: (1) ethische KI-Implementierung statt Massenscraping; (2) öffentliche Dokumentation von Datensätzen statt unbegrenztem Datenzugang, etwa durch sogenannte Data Envelopes (Luthra & Eskevich, 2024), die Auffindbarkeit gewährleisten, ohne unkontrollierten Zugriff zu erzwingen; und (3) gemeinsame KI-Entwicklung, bei der Kultureinrichtungen, Forschende und KI-Entwickler:innen zusammenarbeiten und einen Paradigmenwechsel von Quantität zu Qualität vollziehen.
David Maus nahm eine Einschätzung aus der Perspektive eines Infrastrukturanbieters vor. Aus der praktischen Arbeit an forschungsnaher Infrastruktur, den Bibliothekskatalogen und den daran angeschlossenen Informationssystemen, stellen sich die massenhaften Zugriffe auch als Angriff auf die Infrastruktur dar. Weil die Bots die etablierten Steuerungsmechanismen (Robots Exclusion Protocol, aka robots.txt) schlicht ignorieren und gnadenlos aus allen Richtungen die verfügbare Bandbreite verbrauchen, legen sie regelmäßig Teile der Infrastruktur lahm. Sei es, dass die Systeme unter der Last zusammenbrechen oder sei es, dass die Betreibenden ihre Dienste einstellen oder nur noch restriktiv zugänglich machen.
Als Konsequenz drückte er seine Erwartung einer stärkeren Zentralisierung und Homogenisierung der online verfügbaren Angebote aus. Der Schutz vor aggressiven Bots erfordert eine Infrastruktur, die Angebote von engagierten Einzelpersonen oder kleinen Facharbeitsgruppen nicht aufbringen können. Infrastrukturanbieter wiederum skalieren ihre Dienste darüber, dass sie Plattformen mit einer einheitlichen Grundstruktur anbieten. Angebote, die selbst keine Ressourcen für einen Bot-Schutz haben, verschwinden aus dem Netz oder müssen sich den Plattformen der Infrastrukturanbieter anpassen.
Grischka Petri führte aus, dass es aus rechtlicher Perspektive ernüchternd ist, nach Maßnahmen zu suchen, mit denen man gegen die Verursacher der Server-Sonderbelastung juristisch vorgehen könnte. Die Auswirkungen gleichen einem DoS-Angriff, dafür ist eigentlich das Computerstrafrecht zuständig. Allerdings ist es in den Bot-Downloads nicht vorgesehen, dass die besuchten Server in die Knie gehen sollen – im Gegenteil, man will sie ja nutzen. Der Ansatz scheitert also schon am Vorsatz. Das Urheberrecht bietet attraktive Kategorien an, um Nutzungen zu regeln – allerdings besteht das Problem ganz unabhängig vom urheberrechtlichen Status der Daten. Womöglich ist es für Anbieter gemeinfreier Inhalte sogar noch größer. Das Prinzip Lkw-Maut erscheint erfolgversprechender. Das ist eine Infrastrukturabgabe für eine Sondernutzung. Abseits einer staatlichen Regulierung hat die Wikimedia Foundation mit Wikimedia Enterprise einen solchen Weg eingeschlagen und bietet entsprechende Sondernutzungsverträge an.
Letztlich zeigt sich aber, dass mit rechtlichen Instrumenten keine Betriebssicherheit zu erlangen ist, weshalb am Ende die Empfehlung für technische Maßnahmen übrig bleibt. Initiativen wie die CC Signals, die sich selbst als “a technical and legal tool and a social proposition” beschreiben, sind vom guten Willen der beteiligten Akteure abhängig.
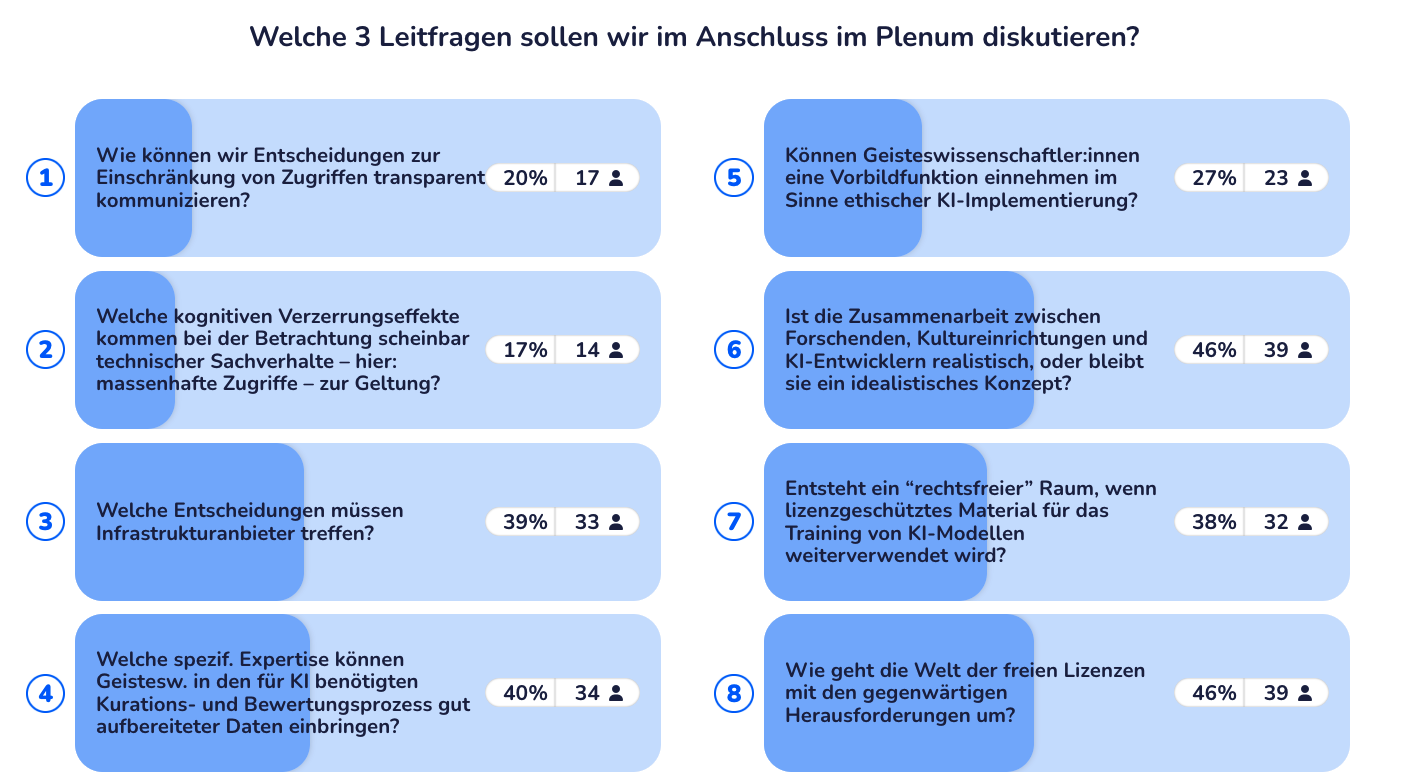
Nach dem Austausch auf dem Podium zwischen den Panelist*innen wurde die mit allen Teilnehmenden im Plenum von Cindarella Petz mit einer digitalen Intervention eingeleitet, in welcher die zu diskutierenden Fragen mithilfe von Wooclap zur Abstimmung gebracht wurden.
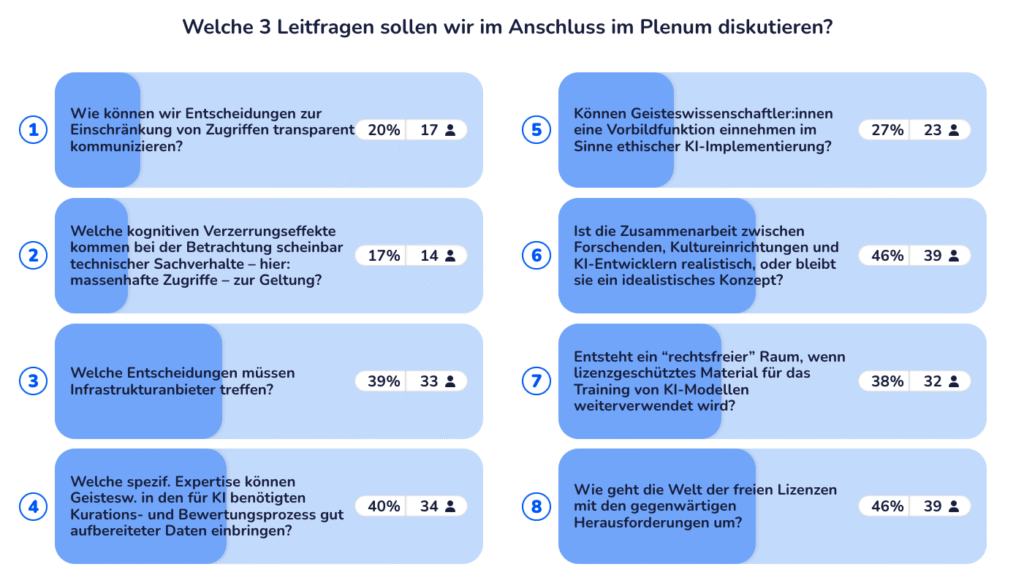
Mithilfe eines webbasierten Etherpads hatte das Publikum die Möglichkeit, anonym Fragen zu stellen und interessante Aspekte zu kommentieren. Im Pad wurden konkrete Standards und unterschiedliche Granularitäten von Nutzungslizenzen diskutiert, Ansätze zur Umleitung von Webcrawlern durch beispielsweise “LLMs.txt” oder “MCP” aufgeworfen, partizipatorische Elemente der Organisation von Wissenschaften, Forschung und GLAM-Institutionen angeregt und die ethische Nutzung von gecrawlten Datensätzen wie “Common Crawl” hinterfragt und welche rechtliche Rahmenbedingung geschaffen werden müssten, um eine Haftbarmachung von Massencrawlern und Stör-Bots zu erreichen.
Fazit und Ausblick
Die Diskussion zeigte deutlich, das wissenschaftsadäquate Lösungsszenarien für die komplexe Herausforderung durch die aktuellen KI-Entwicklungen nur mittels einer diversen Perspektive – unter Einbeziehung verschiedener Akteure und der Einbeziehung fachlicher, rechtlicher, technologischer und ethischer Aspekte herausgearbeitet werden können. Es wurde deutlich, dass es notwendig ist, dass die kritischen Stimmen lauter werden müssen. Letztendlich “befüttert” der KI-Einsatz in der Forschung in vielen Fällen (zumindest implizit) genau die gleichen Akteure, die für den im Panel kritisch betrachteten “ruchlosen” Umgang mit den digitalen Commons und Infrastrukturen insbesondere aus dem Kulturerbebereich (CHI) verantwortlich sind.
Zusätzlich stellt sich die Frage, welche Expertise und Kompetenzen Digital Humanist(a)s in die Herausarbeitung von “Leitplanken” (Werten, Richtlinien, Forschungsethik) für den KI-Einsatz einbringen könnten bzw. sollten. In dieser neuen Phase des offenen Internets gibt es keine einfachen Lösungen. Alles “wegzuschließen” (d.h. technologische oder rechtliche Sperren) würde vor allem auch der Forschung selbst schaden. Was nützt es, wenn mensch alles finden kann, aber nicht mehr damit arbeiten kann. Wichtiger scheint es, den großen kommerziellen KI-Akteuren (Tech-Giganten) Einhalt zu gebieten bzw. ihr Handeln und die Nutzung ihrer Tools kritisch zu hinterfragen. Das Feedback im Saal bestärkte auf jeden Fall das große Potenzial von Digital Humanist(a)s und der LIS-Community (Library and Information Science) in der Politikberatung und der Herausarbeitung kritischer Punkte. Die Zeit ist reif, den Finger in die Wunde zu legen.
Quellen
Berg-Weiß, Alexander. “Offen für manche Menschen oder doch für alle(s)? KI-Bots und ihre Auswirkungen auf den Betrieb von Repositorien.” BuB 77 Nr. 7(2025), S. 372-75.
COAR, Navigating the Uneasy Interdependence of AI and Open Science, A COAR Statement, 3.3.2026
Fitzpatrick 2026, “Just FYI: this is part of the damage being done by extractive AI companies. Their scraper bots routinely DDOS us, and they multiply to take up as much bandwidth as is available. We are having to put a huge percentage of our developers’ time into just keeping the site alive rather than building its future. They are actively destroying everything worthwhile about the internet.” https://hcommons.social/@kfitz/115854657278743117, Mastodon, 7.1.2026, 17:02.
Hao, Karen. 2026. Empire of AI: dreams and nightmares in Sam Altman’s OpenAI. New York: Penguin Books.
Heise (2025a), „Besorgniserregender Trend“: KI verursacht immer mehr Traffic, 21.08.2025 https://www.heise.de/news/Analyse-KI-Crawler-koennen-Server-ueberlasten-10560038.html (Achtung ohne Pur-Abo: Tracking)
Heise (2025b), Wikipedia: Bot-Traffic tarnt sich zunehmend als menschlich, 19.10.2025 https://www.heise.de/news/Wikipedia-Bot-Traffic-tarnt-sich-zunehmend-als-menschlich-10778492.html (Achtung ohne Pur-Abo: Tracking)
Luthra, Mrinalini und Maria Eskevich. „Data-Envelopes for Cultural Heritage: Going beyond Datasheets.“ Proceedings of the Workshop on Legal and Ethical Issues in Human Language Technologies @ LREC-COLING 2024, S. 52–65. Torino, Italia: ELRA and ICCL, 2024. https://aclanthology.org/2024.legal-1.9/
Muno, Martin. „Internet-Archive: Unser digitales Gedächtnis ist bedroht.“ Deutsche Welle, 21. April 2026. https://p.dw.com/p/5CKXK
Shearer, Kathleen und Paul Walk. „The impact of AI bots and crawlers on open repositories: Results of a COAR survey.” April 2025, aufgerufen am 30.07.2025, https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf.
Wuttke, U., Maus, D., Rack, F., Rettinghaus, K., Oberbichler, S., & Petz, C. (2026, Februar 20). KI als Belastungsprobe für das offene Internet?. DHd 2026 Nicht nur Text, nicht nur Daten (DHd2026) (DHd2026), Wien, Österreich. https://doi.org/10.5281/zenodo.18696199
Nicht nur Text, nicht nur Daten … aber was dann? – ‚Theoretisieren‘ durch Praktiken in der digitalen Editorik, der Digital History und den Computational Literary Studies. Ein Bericht.
Autor*innen (alph.)
- Jonathan D. Geiger, Akademie der Wissenschaften und der Literatur Mainz, jonathan.geiger@adwmainz.de, https://orcid.org/0000-0002-0452-7075
- Jessica Hainke, Christian-Albrechts-Universität zu Kiel, jhainke@ndl-medien.uni-kiel.de
- Philipp Hegel, Akademie der Wissenschaften und der Literatur Mainz, Philipp.Hegel@adwmainz.de, https://orcid.org/0000-0001-6867-1511
- Alexa Lucke, Universität Siegen, alexa.lucke@uni-siegen.de, https://orcid.org/0009-0006-2738-2864
- Laura Untner, Freie Universität Berlin, laura.untner@fu-berlin.de, https://orcid.org/0000-0002-9649-0870
Originalblogpost: https://dhtheorien.hypotheses.org/2442
Einleitung
Am 25. Februar 2026 fand im Rahmen der jährlichen Digital-Humanities-Konferenz (DHd) ein Panel der AG Digital Humanities Theorie statt, das eine zentrale Frage in den Mittelpunkt stellte: Wie werden digitale Forschungspraktiken selbst zum Ausgangspunkt theoretischer Reflexion? Die Diskussion, an der sich Laura Untner (Freie Universität Berlin) und Alexa Lucke (Universität Siegen) aus den Computational Literary Studies (CLS), Silke Schwandt (Universität Bielefeld) und Christian Wachter (Universität Münster) aus der Digital History und Philipp Hegel (Akademie der Wissenschaften und der Literatur Mainz) aus der Digitalen Editorik beteiligten, zeigte, dass Theoriearbeit in den Digital Humanities (DH) nicht nur als externes Gerüst verstanden werden kann, sondern vielmehr auch aus der Praxis selbst erwächst. Im Folgenden werden einige Aspekte der Debatte zusammengefasst und es wird dazu eingeladen, über die Verflechtung von Theorie und Praxis sowie Theorie und Empirie in den DH wieder nachzudenken.
Was ist Theorie in den Digital Humanities?
In den Geisteswissenschaften war Theorie lange Zeit eng mit textbasierter Argumentation verbunden – dem Lesen, Interpretieren und Schreiben. In den DH verschiebt sich dieser Fokus: Hier entsteht Wissen nicht nur in klassischen Publikationen, sondern auch in Datenmodellen, Code-Zeilen oder Visualisierungen. Theorie und Theoriebildung hängen zunehmend von technischen Bedingungen ab, wodurch ihre impliziten Annahmen und Voraussetzungen nicht immer sichtbar werden. Zugleich wurde betont, dass Theoriearbeit in den DH drei zentrale Dimensionen umfasst: die methodologische (Wie operationalisieren wir Begriffe wie ‚Genre‘ oder ‚Autor*innenschaft‘?), die epistemologische (Welche Erkenntnisbedingungen liegen unseren Datenmodellen zugrunde?) und die technische (Wie prägen Infrastrukturen wie APIs oder Datenbanken unser Verständnis von Forschungsobjekten?). Theorie muss in diesem Zusammenhang nicht als Hindernis, sondern kann als Produktivitäts- und Transparenzwerkzeug verstanden werden – gerade dann, wenn sie explizit gemacht wird.
Praktiken des Theoretisierens in den Teilfeldern
Für die Computational Literary Studies (CLS) lag der epistemologische Schwerpunkt des Panels auf der Frage, wie Modellierungsprozesse theoretische Annahmen sichtbar machen (können). So wurden Text- und (Meta-)Datenmodelle wie Genre-Taxonomien oder Autorschaftskonzepte nicht als neutrale Perspektiven auf literaturgeschichtliche Kategorien wahrgenommen, sondern vielmehr hinsichtlich ihres Status zwischen (häufig normativen) theoretischen Konstrukten und empirischen Befunden diskutiert. Die digitale Hermeneutik (Möbus et al. 2025) etwa versuche, (latente) Vorannahmen in Daten und Datensätzen zu entschlüsseln und auf diese Weise den Mythos der ‚rohen Daten‘ (Gitelman 2013) zu entkräften. Ein Extrembeispiel für theoretische Reflexion stellt das WEMI-Modell (Work-Expression-Manifestation-Item) dar, das durch seine relationale Struktur zeigt, wie stark unser Verständnis von ‚Text‘ von theoretischen Vorannahmen geprägt ist. Besonders hervorgehoben wurde die Rolle der Formalisierung: Dabei wurde kritisch gefragt, warum bestimmte Literaturtheorien (wie Strukturalismus und Formalismus) formalisierbarer seien als andere und ob der Fokus in den CLS nicht stärker auf der Prozesshaftigkeit von Theoriebildung liegen sollte.
Im Hinblick auf die Digital History zeigte sich, dass das Digitale nicht einfach nur neue Methoden, sondern einen reflexiven turn (König 2021) auslöste. Traditionelle Praktiken wie Quellenkritik oder narrative Darstellungen erhalten durch digitale Werkzeuge eine neue Dimension: Erstere muss etwa Unsicherheiten in Datenmodellen reflektieren, während Visualisierungen wie Netzwerkanalysen zu ‚produktiven Irritationen‘ führen, die etablierte Erzählungen herausfordern. Ein Schlüsselmoment ist die Erkenntnis, dass Digital History nicht ‚Geschichte in Bits‘ ist, sondern eine Auseinandersetzung mit den Bedingungen, unter denen historisches Wissen heute entsteht. Besonders kontrovers diskutiert wurde, ob der Übergang von analogen zu digitalen Medien lediglich ein Medientransfer oder eine tiefgreifende Transformation darstelle.
Für die Digitale Editorik wurde besonders deutlich, wie technische Entwicklungen theoretische Fragen erst ermöglichen. Digitale Editionen entstanden etwa durch die Verschmelzung heterogener Bausteine, deren Zweck nicht primär die Erstellung digitaler Editionen war: von der Mikroelektronik (integrierter Schaltkreis, 1958) über Codierungsstandards auf der Grundlage von SGML (ab etwa 1987) bis hin zu webbasierten Präsentationsformen (HTTP, 1991) und vermutlich Transformermodellen (2017). Jede dieser Technologien brachte implizite Modell-Entscheidungen mit sich – etwa die Frage, wo die Grenze zwischen ‚Text‘ und ‚Apparat‘ verläuft oder wie Faksimiles die Entstehungsgeschichte eines Dokuments sichtbar machen. Eine zentrale These war, dass digitale Editionen nicht länger nur als ‚Ergebnisse‘, sondern als dynamische Forschungsumgebungen verstanden werden können, in denen Theorie und Praxis untrennbar miteinander verbunden sind.
Diskursive Synthesen
Über alle beteiligten Felder hinweg zeigte sich in der Diskussion, dass ‚Theorie‘ in den DH oft implizit in Infrastrukturen, Datenmodellen/Schemata oder Code/Algorithmen u. v. m. eingebettet ist, wodurch sie erst in Test- und Grenzsituationen sichtbar wird. So entstehen theoretische Reflexionen etwa dann, wenn Historiker*innen mit Informatiker*innen über Datenmodelle diskutieren oder wenn Literaturwissenschaftler*innen feststellen, dass ihre Operationalisierungen rechnerisch nicht nutz- oder ausführbar sind.
Ein weiterer Schwerpunkt war die Pluralität theoretischer Ansätze in Verbindung mit der Frage nach Formalisierbarkeit: Trotz (Quasi-)Standards wie den Richtlinien der TEI zeigt sich, dass fast jedes Projekt eigene Modellanpassungen vornimmt und dadurch die Standardisierungsidee aufspreizt. Einig waren sich die Panelist*innen vor allem darin, dass Kollaboration, gerade in interdisziplinären Teams, einen Raum für theoretische Reflexion schaffe, der in traditionellen Einzeldisziplinen oft fehle – was auch einem gewissen Zwang geschuldet sein könnte, in der Sache zusammenzukommen (Stichwort ‚Interoperabilität‘).
Besonders hervorgehoben wurde auch die Rolle von Visualisierungen: Tabellen, Netzwerke oder interaktive Karten machen nicht nur Daten sichtbar, sondern auch die Modell-Entscheidungen, die hinter ihnen stecken. So wird etwa durch die Darstellung von Textvarianten in digitalen Editionen deutlich, wie stark unser Verständnis von ‚Varianten‘ von technischen Repräsentationsmöglichkeiten abhängt. Gleichzeitig sei angemerkt, dass Visualisierungen auch mit Verdeckungseffekten einhergehen.
Ausblick: Theorie als Aufgabe der Community
Die Diskussion mündete in den Appell, Theoriearbeit in den DH systematischer zu verankern. Dazu gehören konkrete Schritte wie die noch stärkere Einbindung theoretischer Reflexionen in Projektbeschreibungen, die Förderung von Methodenpluralismus in Drittmittelanträgen oder die Entwicklung von Schulungsformaten, die Historiker*innen und Literaturwissenschaftler*innen in theorie- und datengetriebene Denkweisen einführen. Ein vielversprechender Ansatz ist die Idee, kritische Datenpraxis als Standard zu etablieren, also die kontinuierliche Reflexion darüber, wie Algorithmen, Interfaces und Infrastrukturen unser Wissen formen und dabei selbst Ausdruck unseres Wissens sind.
Wenn Theorie als integraler Bestandteil von Forschungspraxen verstanden wird, können die DH eine noch tragfähigere Brücke zwischen geisteswissenschaftlicher ‚Tiefe‘ und technischer Innovation schlagen. Der Schlüssel liegt darin, die unsichtbare Arbeit des Theoretisierens – im Labor, im Code, in den Datenmodellen – bewusster zu machen. Denn erst dann wird klar: Theorie ist nicht das Gegenteil von Praxis, sondern ihre treibende Kraft (wie auch Praxis die treibende Kraft von Theorie ist).
Die AG Digital Humanities Theorie bedankt sich beim Organisationsteam der DHd-Konferenz sowie bei allen Diskutant*innen im Plenum für Fragen, Anregungen und Kommentare. Die AG wird das Thema weiter bearbeiten und lädt daher alle Interessierten, vor allem auch aus weiteren Bereichen der DH, um die Debatte über CLS, Digitale Editorik und Digital History hinaus zu erweitern, zur Mitarbeit ein. Schreiben Sie dazu sehr gerne eine Mail an die Convenor der AG Jonathan D. Geiger (jonathan.geiger@adwmainz.de), Rabea Kleymann (rabea.kleymann@phil.tu-chemnitz.de) und Alexa Lucke (Alexa.Lucke@uni-siegen.de).
Referenzen
Gitelman, Lisa (Hrsg.) (2013). „Raw Data“ is an Oxymoron. Cambridge, MA: The MIT Press. DOI: https://doi.org/10.7551/mitpress/9302.001.0001.
König, Mareike (2021). „Die digitale Transformation als reflexiver turn: Einführende Literatur zur digitalen Geschichte im Überblick“. Neue Politische Literatur 66, Nr. 1: 37–60. DOI: https://doi.org/10.1007/s42520-020-00322-2.
Möbus, Dennis et al. (Hrsg.) (2025). Digital Hermeneutics II: Sources, Analysis, Interpretation, Annotation, and Curation. (Special Issue, Lecture Notes in Computer Science, LNCS, vol. 14566), Heidelberg u.a.: Springer. DOI: https://doi.org/10.1007/978-3-032-08697-6.
Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy
Autor:innen:
- Laura Döring, Universität Trier, doeringl@uni-trier.de, https://orcid.org/0009-0001-7129-2018
- Grigori Chlesberg, Herder-Institut für historische Ostmitteleuropaforschung – Institut der Leibniz-Gemeinschaft, grigori.chlesberg@herder-institut.de, https://orcid.org/0009-0000-9036-2723
- Dorothee Urbaum, Hochschule Darmstadt, dorothee.urbaum@h-da.de, https://orcid.org/0009-0003-5711-6303
- Jonathan D. Geiger, Akademie der Wissenschaften und der Literatur Mainz, jonathan.geiger@adwmainz.de, https://orcid.org/0000-0002-0452-7075
- Petra Steiner, Technische Universität Darmstadt, petra.steiner@tu-darmstadt.de, https://orcid.org/0000-0001-8997-2620
Für Originalbeitrag, siehe https://hdl.hypotheses.org/5097
Digitale Werkzeuge und die Arbeit mit Forschungsdaten verändern den wissenschaftlichen Alltag – und erfordern die Entwicklung neuer Kompetenzen. Eine besondere Stellung nehmen dabei Data Literacy (Schüller, Busch und Hindinger, 2019) und Forschungsdatenmanagement (FDM) ein, die über OER (Open Educational Resources) vermittelt werden können (Deimann et al., 2015). Doch OER zu FDM sind bisher über verschiedene Plattformen verstreut und damit schwer auffindbar. Plattformen wie DALIA (Ortmeyer et al., 2024) oder Sammlungen wie NFDI4Memory HISTOCAT und HERMES Resourcebase versuchen, hier Abhilfe durch Registraturen und kuratierte Sammlungen zu schaffen. Ein zentraler Schlüssel für die Auffindbarkeit und Nachnutzbarkeit der OER sind dabei allerdings gute Metadaten – doch bestehende Schemata (z. B. das Schema des Datenkompetenzzentrums HERMES (Urbaum et al., 2026) oder das DALIA Interchange Format (Geiger et al., 2026)) unterscheiden sich hinsichtlich fachspezifischer Angaben wie Disziplinen oder Methoden. Hier fehlen in vielen Fällen standardisierte Vokabulare zu einer Beschreibung von OER, um Such-Find-Prozesse effizienter werden zu lassen.
Vor diesem thematischen Hintergrund organisierten die Projekte HERMES, NFDI4Memory, DALIA und NFDI4Culture auf der 12. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum e.V. (DHd2026), die vom 23. bis 27. Februar 2026 an der Universität Wien stattfand, einen Workshop. Die Konferenz in Wien stand unter dem Motto „Nicht nur Text, nicht nur Daten“ und erweiterte damit ihren Fokus von den traditionellen text-basierten Analysen zu einer umfassenden, objekt-übergreifenden Perspektive. Neben Textkorpora standen nun auch Personen, Orte, materielle Kultur, Bild- und Klangobjekte, Klimadaten, genetische sowie neurophysiologische Messungen im Fokus.
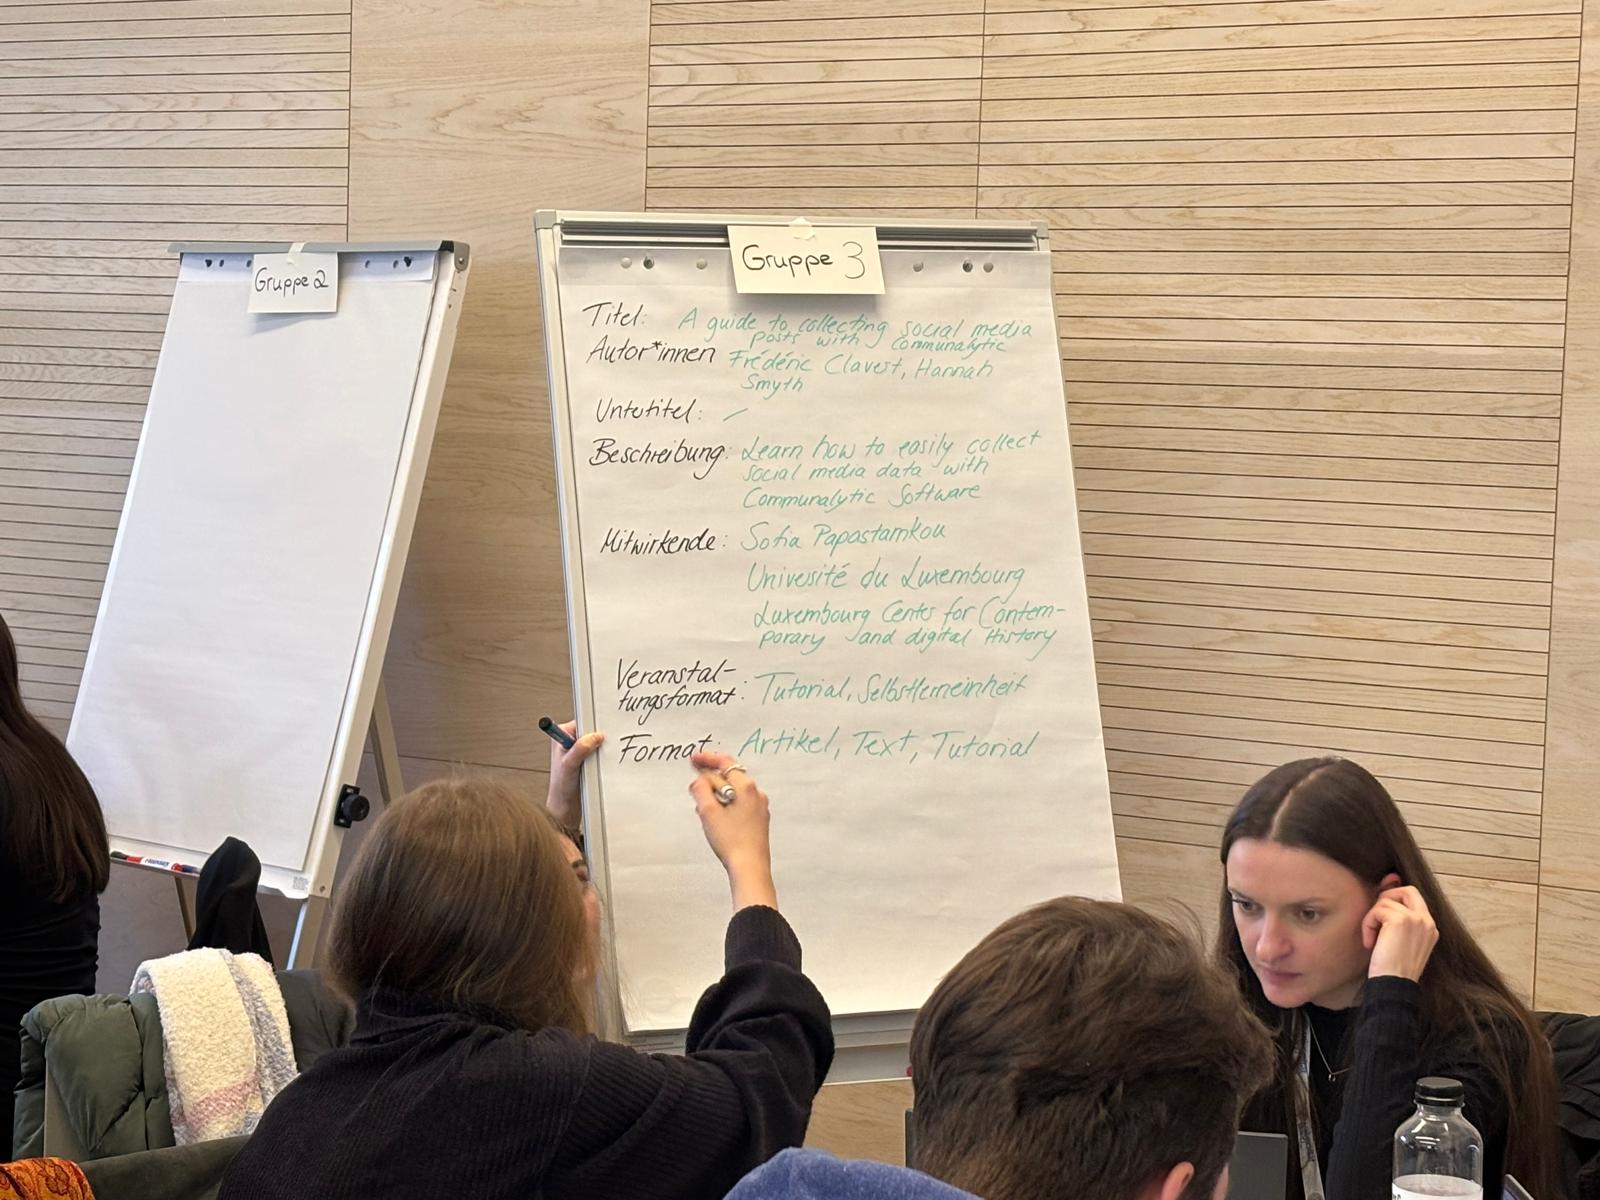
Insbesondere das technische Interesse der Konferenz-Teilnehmenden und die Breite des geisteswissenschaftlichen Disziplinen-Panoramas machten die DHd zu einer geeigneten Konferenz für den Workshop “Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy”. Unser Ziel war es, Metadatenschemata und disziplinspezifische Metadaten von OER unter die Lupe zu nehmen und so eine Grundlage für die Verbesserung der Schemata zu entwickeln. Der halbtägige Workshop konzentrierte sich daher auf die Untersuchung und Strukturierung von OER-Metadaten – insbesondere den Einsatz fachspezifischer, kontrollierter Vokabulare, Picklists und Metadatenschemata für geisteswissenschaftliche Lehr- und Lernmaterialien. Nach einer kurzen Vorstellung der Referent*innen und ihrer Projekte folgte ein Ice-Breaker, der die Unschärfe von Klassifikationen thematisierte. Die daran anschließende kompakte Einführung vermittelte einen Überblick über unseren Untersuchungsbereich wie OER-Metadatenstandards, Metadatenschemata, Vokabularien und deren disziplinäre Herausforderungen und Potenziale. In der Gruppenphase wurde die Think-Pair-Share-Methode nach Bönsch (2002) eingesetzt. Im Hauptteil durchliefen die Teilnehmenden in Kleingruppen einen klassischen Erschließungsprozess. Anhand ausgewählter OER aus verschiedenen geisteswissenschaftlichen Disziplinen untersuchten die Teilnehmenden, inwiefern die beiden OER-Metadatenschemata von HERMES und DALIA für die Ressourcen geeignet waren und inwiefern disziplinen-spezifische Angaben zu den Werten der einzelnen Attributen gemacht werden können. Das Moderationsteam unterstützte dabei. Abschließend wurden die Ergebnisse im Plenum präsentiert, Bedarfe diskutiert und nächste Schritte für die Weiterentwicklung von Picklists skizziert. Eine Reflexionsrunde fasste zentrale Erkenntnisse zusammen und eröffnete Anknüpfungspunkte.
Unter den Eindrücken der Kleingruppen gab es interessante Überschneidungen: Demnach waren Autor*innen- und Lizenzinformationen der Ressourcen häufig unklar oder fehlten ganz; Zielgruppen und Kompetenzstufen wurden uneinheitlich beschrieben oder nicht klar voneinander abgegrenzt. Beide Metadatenschemata wiesen Redundanzen bzw. zu viele Pflichtfelder auf, und Metadatenfelder wie Titel, Untertitel oder Versionsangaben konnten nicht konsistent angegeben werden. Die Teilnehmenden merkten zudem an, dass die Anpassbarkeit an fachspezifische Begriffe derzeit noch begrenzt ist.
Aus diesen Überschneidungen ergaben sich gemeinsame Empfehlungen: Vorgeschlagen wurde ein modularer Kern-/Erweiterungs-Ansatz, bei dem grundlegende Metadaten obligatorisch und fachspezifische Felder optional über kontrollierte Vokabulare (Picklists) ergänzt werden können. Darüber hinaus wurde angeregt, Lizenz- und Autor*innen-Angaben für OER klar auszuweisen; die Disziplinen-Taxonomie um digitale Geisteswissenschaften bzw. Digital Humanities zu erweitern sowie Metametadaten (Version, Datum, Provenienz, Autor*innen etc.) systematisch zu integrieren. Für komplexere Fälle wurde außerdem die Möglichkeit freier Ergänzungen als sinnvoll erachtet. Einheitliche Definitionen für OER, klare Rollenbezeichnungen und ein abgestuftes Kompetenzmodell wurden ebenfalls als wünschenswert erachtet. In der Gruppendiskussion wurde insbesondere die Bedeutung von Metametadaten für Versionierung und Nachvollziehbarkeit von Entwicklungen betont.
Die Organisator*innen danken allen Teilnehmenden herzlich für die rege und produktive Teilnahme und der DHd für die Ausrichtung der Konferenz in Wien. Auch uns hat der Workshop viele Impulse erbracht, die in die weitere Entwicklung der Arbeit an den Metadaten und Plattformen einfließen werden. Die inhaltliche Arbeit an OER und -Metadaten soll im Rahmen einer DHd-Arbeitsgruppe Data Literacy weitergeführt werden – Interessierte sind sehr herzlich zur Mitarbeit eingeladen und können sich in die Mailingliste eintragen und/oder unserem RocketChat-Channel (OER.Net) beitreten.
Referenzen
Bönsch, Manfred. 2002. Unterrichtsmethoden – kreativ und vielfältig. Schneider-Verlag Hohengehren.
Deimann, Markus, Jan Neumann und Jöran Muuß-Merholz. 2015. Whitepaper Open Educational Resources (OER) an Hochschulen in Deutschland – Bestandsaufnahme und Potenziale 2015. Transferstelle für OER. Hamburg. https://open-educational-resources.de/wp-content/uploads/Whitepaper-OER-Hochschule-2015.pdf (zugegriffen: 26.03.2026).
Geiger, Jonathan, Petra Steiner, Abdelmoneim Amer Desouki, Henrika Maria Hüppe und Frank Lange. 2026. DALIA Interchange Format (1.4). DOI: 10.5281/zenodo.17871138
Ortmeyer, Jochen, Jan-Michael Haugwitz, Petra Steiner, Thomas Stäcker, Torsten Schrade, Ulrich Sax, Gábor Kismihók, Matthias Müller, Peter F. Pelz und Sonja Herres-Pawlis. 2024. A Platform for the Provision of Teaching and Training Contents in Data Literacy: DALIA4NFDI. BASE4NFDI User Conference. Berlin, 20-21 November 2024. DOI: 10.5281/zenodo.14183168
Schüller, Katharina, Paulina Busch und Carina Hindinger. 2019. Future Skills: Ein Framework für Data Literacy. Hochschulforum Digitalisierung, 47. DOI: 10.5281/zenodo.3349865
Urbaum, Dorothee und Grigori Chlesberg. 2026. Metadatenschema und Picklisten für Open Educational Resources des Datenkompetenzzentrums HERMES – Humanities Education in Research, Data, and Methods (v1-1). DOI: 10.5281/zenodo.18679758
Urbaum, Dorothee, Laura Döring, Grigori Chlesberg, Jonathan D. Geiger und Petra Steiner. 2026. Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy. In: Silke Schwandt, Gabriel Viehhauser, Tara Andrews und Thomas Wallnig (Hg). 2026. Book of Abstracts – DHd 2026: Nicht nur Text, nicht nur Daten. 12. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum e.V. DHd2026, Universität Wien, 23.–27. Februar 2026. Wien. DOI: 10.5281/zenodo.18702757
Forschungsdaten im Zentrum: Ewig währt am längsten
Ein partizipativer Workshop der Initiative „Datenzentrum – wissenschaftliche Konzeption und Ausgestaltung“ der Berlin-Brandenburgischen Akademie der Wissenschaften (BBAW)
Berlin, 25. und 26. Juni 2026; Akademiegebäude am Gendarmenmarkt; Einstein-Saal
Der Wert geisteswissenschaftlicher Forschungsdaten für Wissenschaft und Gesellschaft ist nicht zuletzt durch den laufenden Aufbau der Nationalen Forschungsdateninfrastruktur (NFDI) offensichtlich geworden. Zentrale Fragen nach dem dauerhaften Betrieb vertrauenswürdiger Datenrepositorien und der langfristigen Verfügbarkeit der aggregierten Inhalte sind jedoch weiterhin offen.
Vor diesem Hintergrund lädt die Initiative „Datenzentrum – wissenschaftliche Konzeption und Ausgestaltung“ der BBAW zu einem zweitägigen Lunch-to-Lunch-Workshop ein. Diese 2025 eingerichtete Initiative erarbeitet ein Konzept für die organisatorischen und technischen Grundlagen für ein leistungsfähiges, zertifiziertes Repositorium und dessen infrastrukturelle Einbindung innerhalb der BBAW. Darauf aufbauend wird die Akademie ab 2028 ein eigenes Datenzentrum betreiben. Dessen Hauptaufgaben werden die Aggregation, Verfügbarhaltung und Archivierung von Forschungsdaten, Software und Diensten aus den Vorhaben und Projekten der Akademie sein. Darüber hinaus ist eine Öffnung des Repositoriums für externe Datengeber:innen vorgesehen.
Im Workshop werden anhand von Impulsvorträgen die unterschiedlichen Perspektiven aus Sicht von Forschung, Bibliothek, Archiv und IT reflektiert. Anschließend bieten verschiedene Thementische die Möglichkeit zu einer intensiven Auseinandersetzung mit spezifischen Fragen, von der technischen Einrichtung nachhaltiger Infrastrukturen zwischen quelloffenen und kommerziellen Lösungen bis hin zum Einsatz sog. Künstlicher Intelligenz samt deren ethischen Herausforderungen.
Um Anmeldung wird gebeten unter: www.bbaw.de/veranstaltungen/veranstaltung-workshop-datenzentrum-2026
Nähere Informationen zum Programm: https://datenzentrum.bbaw.de/veranstaltungen/workshop-2026. Die Seite befindet sich im Aufbau und wird fortlaufend aktualisiert.
From Manuscripts to AI: Reflections on DHd 2026
Overall, DHd 2026 was a truly memorable experience for me. What stood out was not only the diversity of research topics and approaches, but also the opportunity to engage with such talented and dedicated researchers. Being able to exchange ideas, receive feedback, and gain inspiration from other projects was both motivating and rewarding, and offered perspectives that I would not have encountered within my own academic environment. It also encouraged me to think more critically about how my own work fits into the broader field of digital humanities, and how it might contribute to ongoing discussions on combining computational methods with traditional manuscript studies.
I would like to sincerely thank the organizers for planning such a well-structured and inspiring conference. I am also very grateful for the travel grant, without which my participation would not have been possible.
Nicht nur Text, nicht nur Daten…Sondern?
Dieser Blogbeitrag zur DHd2026 in Wien entstand im Rahmen des DHd Early Career Reisestipendiums, gefördert durch NFDI 4 Culture. Neben der statischen Fassung hier im Blog ist über den Button auch eine scrollbare Version über GitHub verfügbar.
Unter dem Motto „Nicht nur Text, nicht nur Daten“ präsentierte sich die DHd 2026 in Wien als Einladung, die Vielfalt in der DH sichtbar zu machen. Als Erstbesucher, gefördert durch ein Early Career Reisestipendium von NFDI 4 Culture, konnte auch ich davon einen kleinen Ausschnitt erleben. Auch aus diesem begrenzten Blick sind dabei doch ein paar Themen geblieben, die sich in den von mir besuchten Sessions immer wieder verdichteten. Ausgehend davon stellt sich mein Bericht daher die im Motto implizit angelegte Frage nochmal ganz ausdrücklich:
Nicht nur Text, nicht nur Daten…SONDERN?
KI
Das Thema KI darf natürlich an keiner guten Konferenz fehlen – besonders nicht in den Digital Humanities. Auch an der diesjährigen DHd war das Thema daher wieder in vielen Beiträgen präsent. Dabei galt der Blick auf das Thema weniger dem Versprechen einer vollständigen Automatisierung bestimmter Schritte, sondern mehr als Werkzeug, um Zugänge zu schaffen. Zahlreiche Ansätze setzen auf geteilte Arbeit von Mensch und Maschine. Schlagwörter wie der Human-in-the-Loop markierten den Anspruch, selbst aktiv zu werden und gewonnene Ergebnisse nicht unreflektiert zu benutzen. Die Möglichkeit, durch die KI Zugänge zu schaffen wurde sowohl für DHler*innen, aber auch für potenzielle Nutzer*innen von DH-Produkten wie digitale Editionen erkannt. KI als archäologisches Werkzeug für ein Reverse Engineering vorhandener, nur schwer verständlicher Code- oder Datenstrukturen, aber auch durch die Verwendung eines Model Context Protocol als Zugriffspunkt für Nutzer*innen, die so im Dialog mit dem Sprachmodell die Daten durchsuchen können. Die Nutzung von KI als Aussicht auf neue Formen der Interaktion mit dem Material und als Mittel, um bestehende Barrieren zu senken.
Lessons Learned eines der ältesten DH-Projekte der Welt: Paradigmenwechsel von RDF-Strukturen zu AI-gestützter Erschließung in der MHDBDB
Zeppezauer-Wachauer, Katharina / Hintersteiner, Julia / van Beek, Alan / Steiner, ChristianZum Beitrag auf Zenodo
Agenten im Dienst der Edition: Dialogische Zugänge zu digitalen Editionen mittels Model Context Protocol (MCP) basierten KI-Agenten
Westphal, TimZum Beitrag auf Zenodo
Nachhaltigkeit
Auch das Thema Nachhaltigkeit hatte als Dauerbrenner der DH seinen festen Platz auf der diesjährigen DHd – nicht etwa deshalb, weil es so oft behandelt wird, sondern weil das Thema weiter brandaktuell bleibt. Zwischen technischem Anspruch, der Realität oft stark begrenzter Ressourcen und der Frage nach langfristiger Nutzung zeigt sich so eines der zentralen Spannungsfelder der Digital Humanities.
In den von mir besuchten Beiträgen wurde deutlich, dass digitale Editionen und Projekte nur dann langfristig erhalten werden können, wenn Nachhaltigkeit bereits früh in Planung und Konzeption mitgedacht wird. Projekte sollten ihre Komplexität am tatsächlichen Bedarf ausrichten und vorhandene Ressourcen berücksichtigen. Gleichzeitig können technische Strategien wie Reduktion (Minimalcomputing), die Nutzung wiederverwendbarer Module oder robuste Architekturen dazu beitragen, dass Projekte über längere Zeiträume nutzbar bleiben. Gerade Interfaces stehen hier im Fokus, da sie bei digitalen Editionen oft am zerbrechlichsten sind. Positiv aufgefallen war mir zumindest noch, dass in einem Beitrag auch die Barrierefreiheit über ARIA-Labeling berücksichtigt wurde – ein Ansatz, der gleichzeitig die Robustheit der Strukturen stärkt.
Der rosa Elefant im Raum oder: Wie viel Ewigkeit wollen wir uns leisten? Überlegungen zur langfristigen Verfügbarkeit digitaler Editionen
Esch, Claudia / Roeder, Torsten / Reul, ChristianZum Beitrag auf Zenodo
QUEDEE: Quest for Unrelenting Experimentation of Durable Electronic Editions
van Zundert, JorisZum Beitrag auf Zenodo
Generische Editionen – Bottom up? Ein static-site-basiertes Template für die synoptische Darstellung der Textversionen von Wernhers driu liet von der maget – und anderer Texte.
Haak, Carl Friedrich / Viehhauser, Gabriel / Miklautsch, Lydia / Müller, Stephan / Andorfer, PeterZum Beitrag auf Zenodo
Nachhaltiger Betrieb generischer Forschungsdatenwerkzeuge: Erfahrungen aus 10 Jahren Spacialist
Derntl, Michael / Brendel, Heiko / Opel, Severin / Quénéherve, Geraldine / Offermann, Martin / Rosenkranz, VinzenzZum Beitrag auf Zenodo
Perspektiven
Der Blick auf die eigene Arbeit und die erarbeiteten Ergebnisse wurde an der DHd in Wien aus verschiedenen Perspektiven. Verschiedene Beiträge wollten dafür sensibilisieren auch solche zuzulassen, die vielleicht weniger prominent sind – oder andere Aspekte betonen. Dabei lässt sich aus Bereichen wie der Gender-Forschung, Diversität, Multilingualität, Barrierefreiheit oder der Theorie viel Potential für eine inklusive und reflektierte Forschungspraxis gewinnen. Neue Perspektiven können in Daten neue Kontexte sichtbar machen. Methoden wie Data Crafting oder Entagled Data zeigen, dass Daten nicht nur produziert und gesammelt werden sollten, sondern stellen die Reflexion über verschiedene Kontexte von Daten in den Mittelpunkt. Perspektive in der DH heißt demnach, die eigenen Rahmenbedingungen mit-, um-, oder manchmal auch neuzudenken. Beginnen tut das oftmals aber erst bei der nötigen Sensibilisierung für diese.
The Dark Sides of DH revisited: From Utopia to Reality
Arnold, Matthias / Horváth, Alíz / Lang, Sarah / Müller-Laackman, Jonas / Roeder, TorstenZum Beitrag auf Zenodo
Nicht nur Text, nicht nur Daten … aber was dann? – ‚Theoretisieren‘ durch Praktiken in der digitalen Editorik, der Digital History und den Computational Literary Studies
Lucke, Alexa / Eggert, Lisa / Geiger, Jonathan D. / Gengnagel, Tessa / Hainke, Jessica / Hegel, Philipp / Schwandt, Silke / Untner, Laura / Wachter ChristianZum Beitrag auf Zenodo
Translations and the gender gap in the German National Library: A case study for women writers
Teichmann, LisaZum Beitrag auf Zenodo
Data As _______: Exploring the Plurality of Data in Visualization
Meyer, MiriahZum Text auf der DHd-Website
Digital Humanities Unpacked: The Politics and Practices of Data Work
Kinder-Kurlanda, KatharinaZum Text auf der DHd-Website
Bilder
Die Beschäftigung mit Bildern in der DH wirkt – für mich zumindest – oft noch wie der Sonderfall. Wenn sich doch die meisten mit Texten beschäftigen, wirken Bilder mehr wie dekorativer Zusatz. Dass sich das vielleicht aktuell zu ändern scheint zeigten einige Beiträge an der DHd. Insbesondere aus der Digital Art History rückten mehrere Vorträge die Analyse, Erschließung und Auswertung von Bildmaterial in den Blick. Ob es um die optimale Mischung von Bildern aus Herbarien und Drucken als Trainingsdaten für KI, die Entwicklung von Klassifizierungssystemen für Bildbeschreibungen oder die Erkennung historischer Szenen geht – Bilder traten hier als eigenständige Forschungsobjekte auf, die neue Perspektiven ermöglichen. Die Ausführungen zeigten das ihnen innewohnende Potenzial, das weit über bloße Illustration hinausgeht.
Deep Seeing the Sacred: Zur KI-gestützten Analyse historischer Bilderzählungen
Bell, Peter / Verstegen, UteZum Beitrag auf Zenodo
Die Erkennung von Pflanzen in Herbarien und Drucken: Kollektionsaufbau und Klassifikationsexperimente mit Bildanalyse-Systemen
Lindemaier, Lisa / Diem, Sebastian / Feuerstein-Herz, Petra / Draheim, Christina / Strötgen, Robert / Mandl, ThomasZum Beitrag auf Zenodo
From Miniature to Metadata: Transferring AI-Assisted Iconography to Medieval Manuscripts
Hintersteiner, Julia / Thomas, Drew B.Zum Beitrag auf Zenodo
Mit Blick zurück sind mir doch einige Themen von der DHd 2026 in Wien ganz gut in Erinnerung geblieben. Insgesamt aber bleibt der Überblick aber weiter nur ein Ausschnitt. Auf jeden Fall zeigte sich für mich an der DHd die Vielfalt, die in den Digital Humanities steckt. Vielleicht lässt sich ja an das ein oder andere noch anknüpfen…
Abstract, Review, Postersession – (M)ein Weg zur DHd2026
Wie nimmt man als Nachwuchswissenschaftler, zumal noch als Student, an einer wissenschaftlichen Tagung teil? Allgemeingültig beantworten kann das wohl weder ich noch jemand anders. In diesem kurzen Beitrag will ich aber zumindest meinen Weg zur DHd2026 in Wien nachzeichnen. Ich hoffe damit aus Nachwuchsperspektive allen, für die eine Teilnahme an der Konferenz ebenfalls einen ersten Schritt in die Wissenschaftswelt bedeuten würde, eine Vorstellung zu geben, wie dieser Weg aussehen könnte.
Vom Vorhaben zum fertigen Abstract…
Die diesjährige Konferenz begann für mich am 22. Februar mit Ankunft in Wien. Der Weg dahin nahm seinen Anfang dagegen – wie sicher für viele Forscherinnen und Forscher aus den DH – bald ein Jahr zuvor. Denn: Nach der DHd ist vor der DHd.
Im letzten Jahr hatte ich das Glück, im heimischen Bielefeld als Teil des studentischen Organisationsteams indirekt schon an der letzten DHd-Konferenz teilnehmen zu können. Kein halbes Jahr zuvor hatte ich meine Bachelorarbeit in der Germanistik eingereicht. In dem Zusammenhang entstand bei mir bereits die Frage: Wäre meine Arbeit wohl auch was für die DHd…?
Bald darauf stellte ich meine BA im Kolloquium der Bielefelder Arbeitsgruppe CLS vor, mit anschließendem Gespräch über Publikationsmöglichkeiten. Veröffentlichen in einer Fachzeitschrift(?) – theoretisch möglich, aber vielleicht eine zu große Hürde, wo man nach der ersten Qualifikationsarbeit gerade zu laufen angefangen hat. Womöglich konzentriert man sich besser aufs Studium, immerhin stellt eine Veröffentlichung in jedem Fall einen Mehraufwand dar! Aber die Arbeit war gut, sagt man mir, und wenn man in die Wissenschaft will, gibt es hier Chancen, die sich auszuschöpfen lohnen.
Die alternative Idee: Veröffentlichen im Rahmen einer Konferenz – immerhin schwirrt die nächste DHd schon in den Köpfen rum und hier gäbe es niedrigschwelligere Einstiegsmöglichkeiten. Man könnte es versuchen, und bei Erfolg würde man diesmal als echter Teilnehmer mit eigenem Beitrag an der ersten Wissenschaftskonferenz teilnehmen. Etwa zur selben Zeit dürfte der Call for Papers eingegangen sein.
Ein Poster soll es werden. Mit Deadline für die Abstracts am 1. August ist im Juli Schreibarbeit angesagt. Eine 47-seitige Bachelorarbeit will auf 750 Wörter gestutzt werden und am Ende soll sogar noch so etwas wie eine Aussage rauskommen. Mit tatkräftiger Unterstützung von Prof. Dr. Berenike Herrmann und der ganzen AG ergeht eine x-malige Feedbackschleife – man unterschätze nicht, wie man – vor allem mit sich selbst – um jedes Wort kämpft, um das Abstract passend hinzubekommen. Am Ende bin ich zufrieden, der Beitrag ist im glücklicherweise gut funktionierenden Fidus Writer abgetippt und schließlich auf ConfTool hochgeladen. Dann heißt es auf das Open Peer-Review-Verfahren warten, um zu erfahren, ob man angenommen wurde oder nicht.
…über Reviewprozess und Posterdesign…
Und das dauert, naturgemäß. Über drei Monate, in denen das Leben natürlich weitergeht, aber man – weil es das erste Mal ist – trotzdem ungeduldig wartet. Schließlich wissen wir, ich und die weiteren drei(!) an AG-Projekten beteiligten Hilfskräfte mit Einreichungen, dass unsere Poster-Abstracts angenommen wurden! Die Freude ist groß.
Sofort geht es aber weiter, denn für das Metagutachten und die Veröffentlichung im Book of Abstracts wollen die Beiträge binnen eines Monats überarbeitet werden. Außerdem muss man sich nun ernsthaft Gedanken machen, wie man eigentlich nach Wien kommt.
In den nächsten Wochen wird sich für Konferenz und Workshops registriert, es werden Absprachen getroffen und Reisen und Unterkünfte gebucht. Man beachte: Für all das muss man üblicherweise in Vorleistung gehen, und es kommt ein bisschen was zusammen. Aber es gibt Finanzierungsmöglichkeiten. Neben der Forschungskommission der eigenen Universität, ggf. sogar der betreffenden AG, schreiben die Beteiligten am Stipendienprogramm des DHd-Verbands großzügig eine ganze Reihe Reisekostenstipendien aus, für die man übrigens nicht zwingend einen Konferenzbeitrag mitbringen muss. Wer den ganzen Organisations- und Verwaltungsaufwand zum ersten Mal macht, berechne aber auch hier etwas Zeit und Nerven ein, die immer dazugehören.
Im neuen Jahr schließlich, nachdem die Überarbeitung für das Metagutachten eingereicht und die meisten Fragen geklärt sind (die letzten werden es noch auf den letzten Drücker, keine Sorge), muss nur noch das eigentliche Poster designt werden. Also nochmal reduzieren und fürs Auge aufbereiten, bei ConfTool hochladen und ab in den Druck. Dann endlich ist alles in trockenen Tüchern und ein paar Tage später ist man, eh man sich versieht, auf dem Weg zur Konferenz.
…bis schließlich zum Ziel
Und was erwartet einen da? Nun, vorausgesetzt das gewählte Verkehrsmittel bringt einen erst einmal planmäßig an sein Ziel, eine ganze Menge. Mit Wien in meinem Fall zunächst eine prächtige Kulturstadt im Herzen Europas, die ich trotz des vollen Konferenzprogramms etwas Zeit hatte, zu erkunden. Neben großen, auch im Frühjahr schönen Gärten und viel ansehnlichem habsburgischen Prunk gehörte dazu nicht zuletzt das Hauptgebäude der ältesten Universität im heutigen deutschsprachigen Raum, wo die Konferenz ihre Räumlichkeiten fand.

Auch das war drin: Schloss Schönbrunn mit der Stadt im Hintergrund, aufgenommen von der Gloriette-Anhöhe
In den Workshops gab es dort ungezwungenen Erfahrungsaustausch im Konferenz-Du und Raum zum Ausprobieren und Selbermachen. Das Kernprogramm, in dem ich durch meine Teilnahme die Möglichkeit hatte, eine ganze Reihe hochaktueller, interessanter Vorträge in breitgefächerten Konferenztracks zu hören, war gerahmt von zwei großen Keynotes im Audimax, die Anlass für anregende Gespräche boten. Dazwischen tischten die Veranstalter im kleinen und großen Festsaal zu Eröffnungsfeier und Kaffeepausen und nicht zuletzt zum großen Empfang im Ballsaal des Wiener Rathauses auf.
Der Mittelpunkt der Konferenz war für mich aber die große Poster-Vorstellung am Donnerstag. Nach vormittäglichem Poster-Slam, wo einige Mutigere die restlichen Teilnehmer kreativ und humorvoll schon auf ihre Poster heißgemacht hatten, warteten die zwei aufeinanderfolgenden Poster-Sessions mit insgesamt 98 Beiträgen.
Es war eindrucksvoll, das eigene Poster dort endlich im A0-Format neben all den anderen hängen zu sehen, zumal im üppigen großen Festsaal der Universität Wien. Während der Poster-Session hatte ich die Möglichkeit, mit gestandenen Wissenschaftlern und anderen Studenten und frisch Promovierenden gleichermaßen ins Gespräch zu kommen, Zusammenhänge meiner Arbeit zu erklären und Rückfragen zu beantworten. Und in der zweiten Session konnte ich dann auch selbst herumgehen und mich mit anderen wiederum über ihre Poster austauschen. Bei all dem habe ich die Erfahrung machen dürfen, mich wirklich als Teil einer wissenschaftlichen Community zu fühlen.
In diesem Sinne kann ich allen, die wie ich noch weit am Anfang ihres akademischen Werdegangs stehen, nur empfehlen, bei Möglichkeit auch diese Erfahrungen zu machen. Ob mit eigenem Beitrag oder ohne, der Weg zur DHd kann für Nachwuchswissenschaftler ganz unterschiedlich aussehen – aber es lohnt sich in jedem Fall, ihn zu beschreiten.
—
Dieser Beitrag ist im Rahmen eines Early Career-Reisestipendiums für die 13. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum e.V. entstanden. Mein herzlicher Dank gebührt dem DHd-Verband als Stipendiengeber für die finanzielle Ermöglichung meiner Teilnahme.
Call for Proposals: Open-Access-Tage 2026
- Publizieren im Wandel: Was macht eine Open-Access-Publikation aus? Im Fokus der Aufmerksamkeit stehen überwiegend Zeitschriftenartikel. Die Vielfalt der Publikationen (z. B. digitale Editionen, Datenpublikationen, Enhanced Publications) in den wissenschaftlichen Disziplinen geht jedoch deutlich darüber hinaus. Wie können wir die unterschiedlichen Publikationskulturen und die zum Teil neu entstehenden Publikationsformate unterstützen und gestalten?
- Ethische und rechtliche Rahmenbedingungen: Wie können Vorgaben und Prinzipien so gestaltet werden, dass sie Open Access nachhaltig vorantreiben? Die juristischen Herausforderungen gehen über Fragen zu Urheberrecht und Lizenzen hinaus. Konkrete Fragestellungen umfassen auch Themen wie Publikationsverträge, Sicherung von Autor*innenrechten, Titelrechte von Zeitschriften sowie Governance-Modelle.
- Offene Infrastrukturen: Offene, scholarly-owned Infrastrukturen unterstützen bereits heute das wissenschaftsgeleitete Publizieren. Wie können diese Systeme kollaborativ weiterentwickelt und betrieben werden, um Stabilität, Nachhaltigkeit und eine bedarfsorientierte Weiterentwicklung zu gewährleisten? Und wie sichern wir angesichts vielfältiger Herausforderungen langfristig den Zugang zu Forschungsergebnissen und Daten?
„Ceci n’est pas un texte.“* – Mein Rückblick auf die DHd 2026 in Wien
Fast 600 Menschen kamen zur DHd 2026 unter dem Motto „Not only text, not only data“ an einer der ältesten Universitäten des deutschsprachigen Raums zusammen – und damit zugleich in einer Stadt, in der Kaffeehäuser seit 2011 zum immateriellen UNESCO-Kulturerbe zählen. In fünf Tagen bot die Konferenz eine Mischung aus Workshops, Panels und Postern – einige davon sind mir besonders in Erinnerung geblieben und stehen in diesem Blog-Post noch einmal kurz im Mittelpunkt.
Workshops: Experimentieren, Annotieren, Automatisieren
Wie für die DHd üblich, fanden an den ersten beiden Tagen Workshops statt – insgesamt 18 an der Zahl. Am Montag entschied ich mich für den Workshop „Beyond the Cloud: Democratizing GPU Access for the Digital Humanities with DHInfra.at“, der von Forschenden der Universität Graz und der Universität für Weiterbildung Krems ausgerichtet wurde. Vorgestellt wurde mit DHInfra ein Forschungsinfrastrukturprojekt, das GPU-Ressourcen bereitstellt, um lokale Hardwaregrenzen und Abhängigkeiten von kommerziellen Cloudlösungen zu überbrücken.
Im Workshop erhielten die Teams Zugriff auf DHInfra und arbeiteten mithilfe von Jupyter Notebooks und Large Language Models an der Bereinigung eines historischen Datensatzes mit fehlerhafter OCR. Das Vorgehen war dreistufig angelegt: Zunächst ging es um reines Prompt Engineering, anschließend um das Feinjustieren der Modellparameter, und in einem dritten Schritt wurden synthetische Beispiele erzeugt, um die Genauigkeit weiter zu steigern. Ein gewisser Gamification-Aspekt durfte dabei nicht fehlen: Eine fortlaufend aktualisierte Bestenliste wurde an die Wand projiziert, auf der sich insbesondere Team Fish, Death to AI und Team 1234 ein enges Rennen lieferten.
Am Dienstag nahm ich am Workshop „Film- und Videoanalyse mit VIAN & TIB-AV-A – Grundlagen, Anwendungen und Schnittstellen“ teil. Dabei wurden mit VIAN und TIB-AV-A zwei Tools vorgestellt und praktisch angewendet, die unterschiedliche Möglichkeitsräume in der Arbeit mit Video als Daten eröffnen. Während VIAN als manuelles Annotationstool stärker an klassische filmwissenschaftliche Arbeitsweisen anknüpft und „Annotation als Schule des Sehens“ greifbar macht, eröffnen automatisierte Verfahren wie TIB-AV-A ganz andere analytische Potenziale.
Der zweite Teil des Workshops widmete sich genau diesen Verfahren: Die Teilnehmenden konnten unterschiedliche Methoden der automatisierten Filmanalyse selbst erproben. TIB-AV-A bietet dabei ein breites Spektrum an Funktionen – von Emotionserkennung über Farbanalyse bis hin zur Objektklassifikation. Insgesamt war der Workshop so aufgebaut, dass auch Einsteiger:innen den Weg von der manuellen Annotation hin zur automatisierten Analyse nachvollziehen konnten und ein Gefühl dafür entwickelten, wann ein minimalistisches Tool wie VIAN und wann ein eher umfassendes System wie TIB-AV-A sinnvoll eingesetzt werden kann.
Von Data Selfies, Data Jewellery zu Data Ghosts – Opening Keynote von Miriah Meyer
Eröffnet wurde die Konferenz mit einer Keynote von Miriah Meyer. Sie ist Professorin am Fachbereich Wissenschaft und Technologie der Universität Linköping. Ihre Keynote trug den Titel Data As ___: Exploring the Plurality of Data in Visualization und bot einen Überblick über Konzepte, die Visualisierung und Daten zusammendenken.
Der Begriff „Data“ stand dabei als roter Faden im Vordergrund und wurde unterschiedlich gefasst: Data as Input, Data as Ground Truth, Data as Entangled und Data as Design Material. Sie machte zudem deutlich, dass Daten auch persönlich sind, und stellte eine Reihe von Projekten vor, an denen sie selbst beteiligt war – unter anderem mit Jugendlichen als Zielgruppe. Mit ihnen erprobte sie Methoden des Data Crafting bzw. der Data Physicalization, die von Data Selfies über Data Jewellery bis hin zu Data Ghosts reichten. Besonders spannend für mich war dabei, wie Miriah Meyer mit diesen Ansätzen das Prozesshafte von Daten hervorhob.
Dabei ging sie auch auf unerwartete Nebenprodukte ein: Auf einer physischen Karte sollten Besuchende mithilfe von Stickerpunkten emotionale Orte markieren. Dabei entstanden u. a., wie sie es bezeichnete, Data Graffiti – also Punkte, die sich (absichtlich) zu Wörtern oder Symbolen formten und auf die Miriah Meyer humorvoll verwies. Nach dieser spannenden Perspektive aus der Data-Vis-Community folgte die Eröffnungsfeier mit Schnittchen und Wein, die den Abend stimmungsvoll ausklingen ließ.
Zwischen Klang, Kritik und Virtualität: Der Konferenzmittwoch
Am Konferenzmittwoch begannen die Panels, die das Motto „Not only text, not only data“ auf unterschiedliche Weise einlösten. Den Auftakt meines Tages bildeten Beiträge aus der Digital Musicology, die ein breites methodisches Spektrum abdeckten. Besonders in Erinnerung blieb mir der Vortrag „Soundful Dickens – Sound in Literary Fiction“, in dem Svenja Guhr und Michaela Mahlberg zeigten, wie sich Klangereignisse in literarischen Texten computergestützt erfassen lassen. Ausgangspunkt war dabei die Idee, Klang systematisch zu modellieren, indem lauttragende sprachliche Einheiten identifiziert und hinsichtlich ihrer Intensität beschrieben werden, um so neue Perspektiven auf Dickens’ Romane zu eröffnen.
Gleichzeitig wurde in anderen Vorträgen deutlich, wie produktiv sich die digitale Musikwissenschaft mit Fragen der Datenmodellierung und -infrastruktur auseinandersetzt: So zielte ein Beitrag darauf ab, das XML-basierte MEI-Datenmodell in eine semantisch anschlussfähige RDF-Ontologie zu überführen, während ein anderer zeigte, wie sich mithilfe von Large Language Models quellenbezogene Daten aus der neuen Schubert-Ausgabe automatisiert extrahieren und weiterverarbeiten lassen.
Nach der Mittagspause verschob sich der Fokus hin zur Wissenschaftsgeschichte der DH. Florian Windhager eröffnete das Panel mit Überlegungen zur Rolle und insbesondere zur Verantwortung der Digital Humanities im Kontext einer „zweiten Säkularisierung“ (nach Simon During) und entwarf mit Komplizenschaft, Widerstand, Migration und Nachfolgearbeit vier mögliche Reaktionsweisen. Damit verband er die Frage nach den Digital Humanities mit einem breiteren Nachdenken über Kultur nach der Hochkultur, etwa im Kontext von Konzepten wie „Dopamine Culture“.
Auch die folgenden Beiträge knüpften an diese Perspektivverschiebung an: Anna Maria Neubert analysierte 714 Drittmittelprojekte (1996–2021) aus einer feministischen Perspektive und machte dabei strukturelle Unterschiede in Forschungsnetzwerken sichtbar. Sie schloss mit der Betonung der Notwendigkeit intersektionaler Perspektiven in den Digital Humanities. Das letzte Projekt widmete sich der Landschaft von 866 Wissenschaftsblogs in Deutschland und stellte Fragen nach Open Science und Open Access, etwa im Hinblick auf Standardisierungen wie DOI, ISSN oder Creative-Commons-Lizenzen.
Zum Abschluss des Tages wechselte ich in ein Panel unter dem thematischen Dach „Virtualität“, das sich zwischen Architektur, VR und Eye-Tracking bewegte. Den Auftakt bildeten Überlegungen zur Dokumentationspraxis in der Architekturforschung, vorgestellt anhand von IDOVIR (Infrastructure for Documentation of Virtual Reconstructions), einem Taxonomieprojekt, das sich der Integration vielfältiger Quellen – von physischen und digitalen 3D-Modellen über naturwissenschaftliche Analysen bis hin zu Oral History und Inschriften – widmet.
Vom Physischen ging es anschließend in den virtuellen Raum: Mit ExPresS XR wurde ein No-Code-Tool für die Entwicklung von XR-Ausstellungen vorgestellt, das einen niederschwelligen Zugang zur Gestaltung immersiver VR-Erlebnisse eröffnet. Der Fokus liegt dabei auf Anwendungen im musealen und wissenschaftlichen Kontext – von der Vermittlung über die Forschung bis hin zur kuratorischen Praxis.
Unter der Leitfrage „Was bestimmt die Zeit?“ zeigte der abschließende Vortrag anhand einer Eye-Tracking-Studie, dass sich Aufmerksamkeit im Museum entlang klarer Muster verteilt: Kunstwerke werden länger betrachtet als Texte, Größe und Gattung beeinflussen die Verweildauer signifikant, und Sehen und Lesen stehen in einem engen Zusammenhang.
Ein sehr gelungener Start, der noch einmal deutlich machte, welche Debatten in den Digital Humanities – fernab der Literatur, an ihren Rändern oder im Zusammenspiel mit GLAM – geführt werden.
Doctoral Consortium und Poster-Slam: Mein Konferenzdonnerstag
Meinen Donnerstag begann ich mit dem Doctoral Consortium: Die vorgestellten Projekte reichten von der computergestützten Modellierung literarischer Aufmerksamkeit am Beispiel von Sherlock-Holmes-Erzählungen (Jan Angermeier) über die digitale Kartierung von Akteur:innen der Stonewall-Bewegung und damit verbundene Fragen nach Sichtbarkeit und Gewichtung innerhalb queerer Geschichtsschreibung (Robin Luger) bis hin zur Analyse von 54 sowjetischen Theaterstücken der Jahre 1945 bis 1964, in der Ekaterina Kolevatora familiäre Modelle im Spannungsfeld von Spätstalinismus und Tauwetter-Periode untersuchte.
Ein Highlight des Tages war die Postersession, insbesondere der Poster-Slam, der mit viel Poesie, Star-Wars-Referenzen und sogar aus dem Grab auferstandenen Protagonist:innen überzeugte. Insgesamt wurden auf der DHd2026 fast 100 Poster präsentiert. Der Empfang und die Preisverleihung des Slams fanden am Abend im Rathaus statt und bildeten mit Buffet, Musik und anschließender Party einen gelungenen Abschluss des Tages – in einer besonders schönen Atmosphäre.
Zum Abschluss: Panels und Keynote am Freitag
Der Freitag begann für mich mit Präsentationen aus dem Bereich der Digital Art History, in denen unterschiedliche Zugänge zur computergestützten Bildanalyse zusammenkamen. Ein Vortrag widmete sich der Frage, wie sich Vision-Language-Modelle wie CLIP für kunsthistorische Analysen nutzen lassen und wie ihre Entscheidungen mithilfe von Explainable Artificial Intelligence nachvollziehbar werden können. Dabei zeigte sich, dass die Modelle bei konkreten Objekten überzeugend arbeiten, bei abstrakteren Konzepten jedoch an ihre Grenzen stoßen.
Diese Spannbreite zwischen methodischer Reflexion und praktischer Anwendung setzte sich in den folgenden Beiträgen fort: Mit PortApp wurde eine App zur Analyse und Durchsuchung frühneuzeitlicher Porträts vorgestellt, die sowohl Ähnlichkeitssuchen als auch die Suche mit eigenem Bildmaterial ermöglicht. Gleichzeitig zeigte das Tool „Suchkind“, wie sich multimodale Modelle mit domänenspezifischer Annotation kombinieren lassen, um visuelle Vorstellungen von Kindheit in historischen Kinder- und Jugendbüchern systematisch analysierbar zu machen.
Die Closing Keynote von Katharina Kinder-Kurlanda (Universität Klagenfurt) führte diese Perspektiven auf einer Metaebene zusammen. In ihrem Vortrag „Digital Humanities Unpacked: The Politics and Practices of Data Work“ machte sie deutlich, dass digitale Daten stets in komplexe Machtverhältnisse, Infrastrukturen und gesellschaftliche Kontexte eingebettet sind, und plädierte dafür, die Digital Humanities als kritische Disziplin zu verstehen, die nicht nur Methoden anwendet, sondern auch deren politische und epistemologische Implikationen reflektiert.
Dies bildete den Abschluss der sehr erfolgreichen #DHd2026 in Wien. Ich freue mich schon jetzt auf die DHd2027 in Marburg unter dem Titel „Mind the Gap! – Wissen, Unsicherheit und Verantwortung“ (1.–5. März 2027 am MCDCI).
Und möchte mich an dieser Stelle herzlich bei NFDI4Culture und dem DHd bedanken, die mir durch das Reisestipendium die Teilnahme an dieser inspirierenden Konferenzwoche in Wien ermöglicht haben. Neben zahlreichen inhaltlichen Impulsen, die genau an die Schnittstellen anknüpfen, an denen ich mich künftig verorten möchte, nehme ich vor allem die Begegnungen mit – eine wachsende Kontaktliste und einige neue WhatsApp-Gruppen, die die DH-Community einmal mehr als offen, lebendig und vernetzt zeigen.
*Der Titel bezieht sich übrigens auf einen Satz, den ein Konferenzteilnehmer auf seinem LED-Badge hatte – ein Goodie aus dem Konferenzbeutel, das selbst programmiert werden konnte und auf dem die vergnüglichsten Aussagen angezeigt wurden, u. a. selbstverständlich „I love DHd“.
Von Alica Müller
Die Philosophie von Maß und Morphem – Fantastische Daten und wo sie zu finden sind
Ein Reisebericht der DHd 2026
Mit dem Bachelorzeugnis in der einen und der Zulassung zum Digital Humanities-Studium in der anderen Hand fühlte ich mich zu Beginn der DHd doch ein wenig wie Jacob Kowalski, als er das erste Mal mit der Welt der Zauberer und Hexen in Kontakt kam. Alles wirkte auf eigenartige Weise vertraut und doch – ja, wie sollte man es anders beschreiben – magisch.
Aus der englischen Linguistik kommend, trug ich einige Fragen mit in das erste Semester meines Masterstudiums. Eine davon drängte sich besonders in den Vordergrund: Wo stehen die Digital Humanities in einer Welt, in der doch Natur- und Geisteswissenschaften so klar und fein säuberlich getrennt scheinen? Es mag genau dieser Schein sein, der trügt. Gerade in der Sprachwissenschaft ist diese Linie noch mit Leichtigkeit wegzudenken. Doch wie könnte man überhaupt versuchen, das menschliche Verlangen nach Bedeutung von sich und der Welt, welches über Jahrhunderte in Bild und Schrift festgehalten wurde, mit reduktiven Ansätzen zu quantifizieren? Ein Algorithmus könnte doch unmöglich die irrationalen und subtilen Gefühls- und Denkweisen nachvollziehen, die uns Menschen so vertraut sind. Genau mit diesen Fragen beschäftigt sich der Essay „Meursault as a Data Point“ von Abhinav Pratap. Seine philosophische Sichtweise stimmte mich in den Tagen vor Beginn der DHd-Jahreskonferenz neugierig und offen dafür, als „Neuling“ in diesem Bereich meine eigene Meinung zu formen. Das majestätische Gebäude der Universität Wien begrüßte mich mit der Eleganz der Neurenaissance an jenem Montagmorgen. Passend zu dem Leitmotto der diesjährigen Konferenz dachte ich mir: „In jedem Text findet man Daten; doch gilt dies auch andersherum?“
Die Konferenz wurde in meinem Fall von Mark Hall von der The Open University (UK) mit seinem Workshop Arbeiten mit der μEdition eröffnet. In seiner dazugehörigen DHd-Publikation stellte er sich unter anderem die Frage: „[…] [W]ie viel Edition braucht eine Edition, um eine Edition zu sein?“ (Hall, 2026). Wir durften in dem Workshop ein praxisfähiges Tool mit Community-Zugang ausprobieren. Ich sah dies als eine angenehme Gegenbewegung zur totalen Datenlogik. Die μEdition arbeitet mit Blick auf pragmatische Produktions- und Publikationspfade, unter anderem mit statischen HTML-Ausgaben und niederschwelligen Wegen, um Editionen für Forschende zugänglich zu machen und den „Publikationsflow“ zu vereinfachen (Hall, 2026). Was in seinem Projekt ebenfalls eine große Rolle spielt, ist, dass nicht alles sofort auf maximale Komplexität ausgelegt sein muss. Vielmehr sollen Einstiege erleichtert werden und damit auch das Wachstum der jeweiligen Edition. Nicht nur Text bedeutet hier also Publizieren: Es geht auch darum, Editionen für alle zugänglich zu machen und dabei mit kleinen Ressourcen arbeitsfähig zu bleiben.
Als Sprachwissenschaftlerin stolperte ich in meinem Bachelorstudium nur selten über literaturwissenschaftliche Annotation. Umso erfrischender war für mich der Workshop, an dem ich am zweiten Tag der DHd teilnehmen durfte. Graphbasierte Text- und Wissensmodellierung mit dem ATAG-Editor und Entity-Manager wurde geleitet von Maximilian Michel, Sebastian Enns, Vincent Neeb und Andreas Kuczera von der Akademie der Wissenschaften und der Literatur Mainz sowie der Technischen Hochschule Mittelhessen. Komplementär zur μEdition adressiert ATAG die Frage, wie man Text so speichert bzw. modelliert, dass das Datenmodell dem editorischen Denken näherkommt. In der ersten Theoriephase wurden alle Teilnehmenden in die browserbasierten Tools, den ATAG-Editor und den Entity-Manager, eingeführt. In der Praxisphase wurde jedem von uns ein Text ausgeteilt, mit dem wir unseren eigenen Regest, aufgeteilt in Summary, Archival History und Commentary, erstellen durften. Anschließend wurde uns freigestellt, die Tools zu testen und „wild drauf los“ zu annotieren (je nach Vorliebe). Zum Schluss wurde uns die Verknüpfung unserer Texte, Annotationen und Entitäten in einem Netzwerk auf Basis von Labeled Property Graphs visualisiert. Ich empfand dieses Tool als wunderbare Möglichkeit für webbasierte und vor allem kollaborative Annotation und es hat mir persönlich gezeigt, dass Text nicht bloß einer Kategorie angehört, sondern auch eine Praktik selbst ist.
„Dinge sind […] nicht nur einfach wahrzunehmende „Gegenüber“, sondern sie konstruieren die Umwelt des Menschen und bestimmen die Möglichkeit seines Handelns.“ (Peter Hahn, Materielle Kultur, 2014, S. 31)
Sind Zeichnungen, Bilder, Gemälde und Abbildungen auch Dinge im Sinne des obigen Zitats? Der Vortragsblock zu Digital Art History zeigte mit sehr interessanten Anwendungspraktiken den „Zustand“ der Digital Humanities in Bezug auf die Analyse von historischen Bilderzählungen und mittelalterlichen Manuskripten bis hin zur Erkennung von Pflanzen in Herbarien und Drucken. In den Vorträgen wurde unter anderem gezeigt, wie schwer es ist, Figuren (z. B. Maria oder den Engel Gabriel in Verkündigungsszenen) zuverlässig über Stile hinweg zu erkennen. Es wurde argumentiert, dass unter anderem Gesichtsdaten für eine erfolgreiche Analyse nicht ausreichen und es an Kontext im Sinne von zugehörigem Körper und Umgebung bedarf, um die Erkennung zu verbessern. Die Kernfrage lautet hier: Was zählt als Signal und was als Rauschen, wenn Kunstwerke zu Datensätzen werden?
Auch die Automatisierung des Klassifikationssystems ICONCLASS wurde behandelt. Dieses wurde seit den 1940er-Jahren für Bildinhalte entwickelt und wird heute in vielen kulturellen Sammlungen zur inhaltlichen Erschließung verwendet (Thomas, n. d.). Da die manuelle Vergabe solcher Klassifizierungscodes aufwändig ist, nutzen neue Automatisierungsansätze multimodale Modelle, Vektorsuche und Retrieval-Augmented Generation (RAG), um Iconclass-Klassifikationen aus Bildbeschreibungen abzuleiten, und berichten teils deutlich bessere Ergebnisse als reine Keyword-Methoden (Thomas, n. d.).
Mit diesen Ansätzen werden Bilder zu:
- Daten (Computer Vision, Feature-Extraktion, Klassifikation)
- Bedeutung (ikonographische Kategorien)
- Interpretation (Ambiguität, Kontext, Fehlklassifikation)
Der damit erzeugte Modelloutput ist dabei nicht einfach Bedeutung, sondern eine konstruierte Leseart, die sehr produktiv sein kann, jedoch immer wieder neu interpretiert werden muss, um auf blinde Flecken aufmerksam zu werden.
Nach den wunderbaren Vorträgen habe ich am Donnerstag meine ganz persönliche Winkelgasse und damit auch mein Highlight der DHd gefunden: die Postersessions.
Umgeben zu sein von so vielen talentierten, motivierten Forschenden, die die verschiedensten Projekte vorstellen, ließ keinen Nischenwunsch offen. Ich hatte das Glück, drei Personen für ein kleines Interview zu gewinnen.
Anja Gerber von der Klassik Stiftung Weimar adressiert mit NFDI4Objects die Zusammenführung heterogener Daten zu materiellem Kulturerbe und nutzt dafür Anschluss an Modelle wie CIDOC CRM bzw. Crosswalk-Ontologien. Das von ihr vorgestellte Projekt ist ein schönes Beispiel für Daten als semantische Vermittlung zwischen den Communities der Archäologie, Museen, Restaurierung und Forschung.
Der Posterbeitrag von Nina Brolich von der Universität Erfurt beschäftigt sich mit der Frage: Welche Infrastrukturen zwingen uns zu bestimmten Fragestellungen? Und welche öffnen neue Alternativen? Mit ihrem Projekt Edge AI zeigt sie, dass sich Aufgaben in den DH wie Entity Recognition auch lokal und mobil auf Mikrocontrollern mit einfacher Netzwerkarchitektur lösen lassen – im Kontrast zu der Idee, dass alles über immer größere Rechenressourcen laufen müsse.
Schließlich hat mich Erik Radisch von der Sächsischen Akademie der Wissenschaften zu Leipzig in das Projekt eines 3D-Positionssystems für Zeichnungen und Bilder in den Höhlen von Kucha in Zentralasien eingeführt. Hierbei wird versucht, die Wandgemälde, die teils entfernt und in Museen gebracht wurden, zu dokumentieren und ihren ursprünglichen Standort zu rekonstruieren. Dabei adressiert er auch das Modellierungsdilemma, dass schematische Darstellungen Bereiche erzeugen können, die es so im Original nicht gibt, und dass man bei diesen Verzerrungen methodisch mitdenken muss. In jedem Fall war es eine tolle Erfahrung, in den Stand des Projekts mit der bereitgestellten VR-Brille einmal selbst eintauchen zu dürfen.
Ob Kaffeepause, Rathausempfang, Posterslam, Eröffnungsfeier oder Exkursion: Die DHd2026 war von der Einführungs- bis zur Abschlusskeynote eine wahrlich magische Erfahrung. Ein großes und von Herzen kommendes Dankeschön geht hierbei an CLARIAH-AT, die mir mit der Vergabe des Stipendiums einen großen Schritt in meine persönliche Entwicklung als Forscherin in den Digital Humanities und zugleich die Erfahrung einer wunderbaren und inspirierenden Community ermöglicht haben.
Für all die Workshops, Poster Sessions und Vorträge finden Sie, liebe Leserinnen und Leser, alle wissenschaftlichen Essays, Links und Nennungen sowie weiterführende Literatur am Ende dieser Seite. Gerade für diejenigen, die erst seit kurzem den Wind der DH in ihren Segeln spüren, kann ich nur wärmstens empfehlen, sich dieser Literatur zu widmen. Wer weiß, vielleicht erweitert sie auch Ihren Horizont und führt Sie auf ganz neue, unerwartete Gewässer.
Nun, von Harry Potter zur Seemannsweisheit – so richtig entscheiden konnte ich mich in meinen verwendeten Metaphern ja nicht. Und wie sieht es mit meinem anfänglichen Dilemma der DH und der vielen unbeantworteten Fragen aus? Geisteswissenschaften existieren nicht ohne die komplexen Fragen menschlicher Existenz. Informationswissenschaft wiederum arbeitet mit quantifizierbaren Strukturen, die Daten greifbar machen. Die Digital Humanities erscheinen mir deshalb weniger als Kompromiss zwischen beiden Welten, sondern eher als ein Raum der Symbiose; ein Ort, an dem Interpretation und Modellierung nebeneinander existieren können. Und vielleicht ist es genau diese dritte Instanz, die während der DHd am deutlichsten hervortrat: der Forschende selbst, der zwischen Daten und Bedeutung vermittelt und ihnen Bedeutung gibt.
Storymap und Netzwerkvisualisierung
Um diese vielen Eindrücke, Projekte und Methoden nicht nur erzählerisch, sondern auch visuell darzustellen, habe ich im Anschluss an diesen Blogbeitrag eine kleine digitale Dokumentation erstellt. Eine StoryMap führt durch meine persönlichen Stationen der Konferenz, während eine Netzwerkvisualisierung die Verbindungen zwischen den erwähnten Projekten, Methoden und Forschenden veranschaulichen soll. Die Knoten der Netzwerkanalyse repräsentieren Forschende, Projekte, Institutionen und methodische Ansätze, während die Kanten ihre thematischen Verbindungen darstellen. Betrachtet man das Ergebnis, erkennt man, wie stark die Digital Humanities von interdisziplinären Verknüpfungen zwischen Edition, Kulturerbedaten, visueller Analyse und digitalen Modellierungsverfahren geprägt sind.
Beide Visualisierungsformen verstehen sich als Versuch, die verknüpften Wege der DHd auch mit Methoden aus dem eigenen Fachgebiet abzubilden – selbstverständlich völlig experimentell.

Literatur
Hall, M. (2024). Edition & niederschwellige digitale Editionen.
Kuczera, A. (2024). Applied Text as Graph: ATAG – Graphbasierte Text- und Wissensmodellierung.
Mandl, T. (2026). Plants in historical herbarium collections (DHd2026 Beitrag).
Pratap, A. (2025). Meursault as a Data Point. Essay.
Prathmesh M.., et al. (2020). Recognizing characters in art history using deep learning.
Thomas, D. B. (n.d.). Automating Iconclass: LLMs and RAG for large-scale classification of religious woodcuts.
Interviews
Brolich, N. (2026, 27. Februar). DH on the Edge [Poster session interview].
Gerber, A. (2026, 27. Februar). Vom Objekt zum Wissensnetz [Poster session interview].
Radisch, E. (2026, 27. Februar). 3D Positioning System for the Paintings in the Caves of Kucha [Poster session interview].
Verwendete Materialien
- DHd2026 Konferenzprogramm
- Poster Sessions
- Workshopmaterialien der Vortragenden
Weiterführende Literatur
De Boer, V., et al. (2024). Hybrid Intelligence for Digital Humanities.
Peck, E. (2019). Data is personal: Approaches to making data tangible. Linköping University.
Hullman, J. (2019). Why authors don’t visualize uncertainty. IEEE Transactions on Visualization and Computer Graphics.
Nicht nur Text, nicht nur Daten: Erfahrungen von der DHd 2026 in Wien
Ich bin mit großer Vorfreude und dank des Reisekosten-Stipendiums des DHd-Verbandes zur DHd 2026 nach Wien gefahren. Die Universität Wien machte bereits beim Ankommen einen sehr imposanten Eindruck. Gleich am ersten Tag startete ich mit dem Workshop „Beyond entities: Inhaltsbasierte Erschließung digitaler Editionen mit KI“. Dort haben wir uns erst zu den Grundlagen von RDF und zu Ontologien wie z. B. FOAF bringen lassen, bevor wir praktisch wurden: Mithilfe vorgefertigter Jupyter-Notebooks und Beispieldatensätzen probierten wir verschiedene LLM-Modelle mit unterschiedlichen Parametern aus und schauten uns die Ergebnisse der RDF-Tripel-Extraktion an. Ein spannender und sehr praxisorientierter Einstieg.
Am nächsten Tag war ich beim Workshop „LLMs unter Kontrolle: Offene Modelle in Forschung und Praxis“. Der Workshop zielt genau auf das, was ich als Nachwuchswissenschaftler wichtig finde: einen transparenten und reflektierten Umgang mit generativer KI in den Digital Humanities zu fördern. Von besonderer Bedeutung für mich war der methodische Einsatz von LLMs in der eigenen Forschung. Die praktische Arbeit mit lokalen, offenen Modellen wie OLMo 2 (1B) und OLMo 3 (7B) über LM Studio zeigte, wie viel Kontrolle und Reproduzierbarkeit man dadurch gewinnt. Zugleich wurde deutlich, wie problematisch proprietäre Online-Modelle sein können, weil sie sich verändern, Outputs nicht dauerhaft dokumentiert sind und Trainingsdaten sowie Gewichtungen oft intransparent bleiben. Der darauffolgende Theorie-Block vermittelte entsprechende Evaluationsstrategien für den Einsatz solcher Modelle. Abschließend fand eine Reflexionsrunde statt, die dazu anregte, mögliche Use Cases für die eigene Forschung neu zu denken.
Zwischendurch besuchte ich Vorträge, die von technischen Umsetzungen bis zu praktischen Anwendungen reichten: Die Präsentation zur „Digitalen Erschließung des Schematismus“ demonstrierte eindrucksvoll, wie aus historischem Druck durch OCR, NER und Transformer-Modelle schrittweise eine vernetzte Graphdatenbank entsteht, mit dem Ziel, Personen verbindlich Verwaltungseinheiten zuzuordnen.
In den Poster-Sessions wurden viele überaus interessante Poster präsentiert. Eines davon befasste sich beispielsweise mit der Frage: „Wie kompatibel ist meine Bibliothek mit Digital Humanities?“ und erinnerte daran, dass Digital Humanities oft schon in den eigenen Beständen stecken und nur gefördert werden müssen.
Der Vortrag „Semantic Modelling of Intermedial and Intertextual References in Comics“ zeigte das epistemische Potenzial semantischer Modellierung: Am Beispiel von „Sibylla“ zeigte sich, wie Wissensgraphen literarisches und visuelles Wissen strukturiert, transparent und interoperabel abbilden können. Gerade für intermediale Forschung ein großer Gewinn. Ebenso praxisnah war der Beitrag zu „Fachspezifische Datenmodelle als Brücke zwischen materieller Kultur, Theorie und Praxis“: die Arbeit mit WissKI Barrels erschien mir als echter Gamechanger für kleinere Museen, weil sie Nachhaltigkeit und sofortige Einsatzfähigkeit im Sammlungsdaten-Lebenszyklus verbindet und damit Theorie und Praxis greifbar zusammenbringt.
Den Abschluss der Konferenz bildete die Keynote, die viele der zuvor diskutierten Fragen noch einmal auf einer übergeordneten Ebene bündelte: Ausgehend von der Kritik an Big Data als vermeintlichem Paradigmenwechsel wurde deutlich, dass digitale Daten keineswegs neutral oder automatisch erkenntnisfördernd sind. Vielmehr bestimmen Plattformen, APIs und intransparente Algorithmen maßgeblich, welche Daten überhaupt zugänglich sind und wie valide Forschungsergebnisse sein können. Besonders eindrücklich war der Punkt um Forschungsethik und den Umgang mit Social-Media-Daten, wie etwa die Frage nach Anonymisierung, Einwilligung und Zitierpraxis. Das zentrale Plädoyer lautete, statt nur kritische Distanz einzunehmen, eine „kritische Nähe“ zu Daten zu entwickeln: Verzerrungen und Lücken nicht nur zu bemängeln, sondern sie als Teil des analytischen Prozesses produktiv zu machen und die Politik der Daten sichtbar werden zu lassen. Für mich rundete dies Keynote den Kongress perfekt ab. Sie verband technische Praxis, ethische Reflexion und wissenschaftstheoretische Perspektive zu einem klaren Auftrag für die zukünftige Arbeit in den Digital Humanities.
Insgesamt nehme ich aus Wien nicht nur vielfältige Impulse und die fachlichen Erkenntnisse mit, sondern auch, das Gefühl mit den Digital Humanities eine wissenschaftliche Community kennengelernt zu haben, die einen sehr herzlichen, neugierigen und manchmal auch etwas selbstironischen Geist in sich vereint, mit dem ich mich sehr verbunden fühle.
Recap of the DHd 2026 Conference in Vienna
Two weeks ago, I had the pleasure in attending the DHd 2026 in Vienna! The week long conference started with being greeted and checked in by extremely kind and helpful people and receiving a DHd tote bag containing a travel mug, a programmable LED name tag, a program book, a DHd pen, and a notebook.
Then the first workshop began. I had enrolled in Workshop 6: Library Labs als Innovation Hubs für DH – Worldcafé & Community Building. Here we heard from the Bibliothek für Bildungsgeschichtliche Forschung des DIPF, the Deutsche National Bibliothek, the Stabi Lab which is part of the Staatsbibliothek zu Berlin, DIGIPOP, and the Vernetzungs- und Kompetenzstelle Open AccessBrandenburg. Each presented what offers they have, what events they host, how to access their datasets and open source resources, and how to get in touch. Then after a 15-minute coffee and pastry break, we broke out into groups and discussed the overarching theme of Library Labs, broken up into the subcategories of physical location, teaching formats, personnel/resources, target groups and communication, and cooperation and sustainability. The breakout groups was an amazing opportunity to learn and chat with other people attending the conference and hear about the work they are currently involved in.
The next day I participated in the workshop hosted by the DNBLab from the Deutsche Nationalbibliothek called “Von der Forschungsidee zumDatenkorpus”. Here we learned how to use the DNB SRU Query Tool to query and create metadata sets via the SRU interface. This workshop was again a very open and welcoming space, with all coding levels represented and everyone working together to use the tool and create visualizations from the datasets.
During the lunch break after, due to the sunny weather, many people decided to picnic outside at a nearby park before the next workshop. Tuesday evening was the Opening Keynote from Miriah Meyer, a professor in the Department of Science and Technology at Linköping University who is funded by the WASP program. Her research focuses on developing visualization tools that support exploratory and reflective data analysis and provide new ideas for using data in our lives. These tools enable people to learn more about their own data, redefine their perspectives, and revolutionize their thinking. In her keynote “Data As _: Exploring the Plurality of Data in Visualization”, she presented four different perspectives on data that reflect the range of approaches used by visualization researchers. By clearly distinguishing these perspectives, she opened new possibilities for how we create and use data and visualizations, and how we can simultaneously question our common notions of data-driven work. She also described the various projects she is and has been involved in, including one where young women are the target audience, with whom she explored Data Crafting and Data Physicalization Methods.
After the interesting Keynote, we all went to the Main Ceremonial Hall (Grosser Festsaal) for the Opening Reception where we were welcomed with food, drinks, and deserts and had time to socialize. Starting Wednesday and going until Thursday at noon, there were lectures where 2 to 3 people or groups presented their work, each total lecture lasting 1.5 hours and each having an overarching topic. The topics included digital soundscapes, digital art history, research data standards, Doctoral consortiums, named entities, digital editions, history of DH research, research software engineering, graph networks, virtuality, AI in interaction scenarios, epistemology and interpretation, research platforms as well as panel discussions. Between each lecture, there was either a coffee and pastry break, or a lunch break.
Thursday after the first coffee break, everyone headed to the Audimax where the Poster Slam took place. Each person or group presenting a poster had 60 seconds to introduce themselves, their topic and their research. The audiences applause level was recorded and whichever group received the loudest applause won. The slams were all so creative, with people working with props, being wrapped in toilet paper, performing poetry, sonnets, raps, and skits. After the Poster Slam followed lunch, and afterwards everyone gathered in the Main Ceremonial Hall for two Poster Sessions where we were able to ask questions and hear more about each poster from each of the participants.
In the evening, we were invited to the Reception in the City Hall. We entered the City Hall and were greeted with breathtaking architecture. The mayor’s representative welcomed us, speeches were held, the awards of the Poster Slam and the Poster Sessions were announced, selfies were taken and the buffet was opened. The night continued with food, drinks, desserts, and dancing and then once the City Hall closed, everyone went to a bar where bingo was played at midnight.
On Friday there were two more lecture sessions with topics including historical perspectives, digital editions II, text recognition, automation and AI, operationalization, multimodality, data modeling, digital art history II, and two more panel discussions.
This was followed by lunch and then the closing Keynote which was held by Katharina Kinder-Kurlanda, a Professor of Humanwissenschaft des Digitalen at the University of Klagenfurt in Austria. She works across disciplines in digital humanities, science and technology studies, sociology of technology, and internet research. Her research interests include new epistemologies for big data, algorithms in everyday life, data practices, social casual games, and (fair) artificial intelligence. The keynote invited us to understand digital humanities as a critical discipline that not only applies digital methods but also reflects on their social implications. She asked the question of how can we, as researchers in digital humanities, make the politics of data visible?
Following the Keynote, closing remarks were made, the Organizational Team from Vienna was brought on stage and given roses and thanked for their amazing effort, and there was a presentation about the DHd Conference 2027 which will take place in Marburg Germany.
Overall, the DHd 2026 was an amazing experience! It was an extremely open and supportive environment, allowing everyone to meet and learn from their peers and the pioneers of the field. I am very grateful to the DHD for the scholarship and this opportunity. Thank you for the inspiring week full of wonderful presentations, workshops, posters, delicious food and drinks and lovely interactions. I’m already looking forward to next year! 
Rückblick zur DHd2026 – Ein Konferenzbericht aus Wien
Dieser Beitrag entstand im Rahmen eines Early Career Reisestipendiums von CLARIAH-AT für die DHd2026 in Wien. Herzlichen Dank für die Ermöglichung dieser Teilnahme.
Was macht eine wissenschaftliche Community aus? Und gehöre ich dazu? Diese Frage hatte ich im Gepäck, als ich als Masterstudierende der Digital Humanities an der Universität Regensburg zum ersten Mal zur DHd fuhr. Die DHd2026 war meine erste große DH-Konferenz und eine Einladung, die Community nun endlich live zu erleben. Das Ziel: Wien.Eine prachtvolle Stadt, eine beeindruckende Universität und ein Tagungsthema, das neugierig macht: Not just text, not just data. Was steckt in den Digital Humanities jenseits von Textkorpora und Datentabellen? Die Konferenz hat darauf viele spannende Antworten geliefert.
GPU für die GW – aber bitte DSGVO-konform
Der erste Konferenztag führte mich in den Halbtagsworkshop „Beyond the Cloud: Democratizing GPU Access for the Digital Humanities“ des DHInfra-Teams der Universität Graz und der Universität für Weiterbildung Krems. Der Bedarf an rechenintensiven Methoden wächst in der DH rasant, während kommerzielle Anbieter wie AWS oder Google Colab ernsthafte Fragen zu Datenschutz und Datensouvränität aufwerfen. DHInfra setzt hier mit einer föderierten, DSGVO-konformen GPU-Infrastruktur an. Der Workshop war dabei mehr als eine Demonstration, er diente als finale Testphase vor dem offiziellen Launch, in der die Teilnehmenden LLMs feintunen und API-basierte Workflows entwickeln konnten und gleichzeitig direktes Feedback zur Plattform gaben.
Data as…
Den Auftakt der Konferenz bildete am Abend die Eröffnungskeynote von Miriah Meyer mit dem Titel „Data as…: Exploring the Plurality of Data in Visualization“. Mit einer scheinbar simplen Frage: „Was sind eigentlich Daten?“ eröffnete sie ein breites Panorama: Daten als Input, als Ground Truth, als Design Material, als etwas Verflochtenes. Wer diese Rahmungen explizit benennt und hinterfragt, gewinnt neue Perspektiven auf Visualisierungen und die eigene Forschungspraxis. Beim anschließenden Empfang wurden diese Gedanken in Gesprächen weitergeführt. Ein schöner Beweis dafür, wie eine gute Keynote eine Konferenz inhaltlich in Gang setzt.
Annotieren: Mensch, Maschine oder beides?
Am zweiten Tag folgte der ganztägige Workshop „Film- und Videoanalyse mit VIAN & TIB-AV-A“. Die zentrale methodologische Frage: Wann annotieren wir manuell, wann die Maschine? VIAN Light macht diese Spannung produktiv, indem es manuelle Annotation mit automatischer Einstellungserkennung kombiniert und damit Raum lässt für das, was Eva Hielscher „Doing ELAN“ nennt: den Annotationsprozess selbst als erkenntnisleitenden Akt. Das Fazit des Tages: Automatisierung ersetzt die manuelle Annotation nicht. Hybride Workflows, die beides kombinieren, sind der Schlüssel.
Die Politik der Daten
Besonders nachhaltig haben mich zwei Panels beschäftigt. Im Panel „KI als Belastungsprobe für das offene Internet“ diskutierten Klaus Rettinghaus, Sarah Oberbichler, David Maus und Grischka Petri, was der Boom generativer KI bedeutet: Bot-Traffic, der sich als menschlich tarnt, blockierte Archive, ignorierte Lizenzen. Die Kernfrage: Welche Infrastrukturen bauen wir auf, welche Daten legen wir unter welchen Bedingungen offen? Das sind im Kern politische Entscheidungen und Geisteswissenschaftler:innen können mit ihrer kritischen Datenperspektive aktiv mitgestalten.
Das Panel „The Dark Sides of DH revised: From Utopia to Reality“ richtete den Blick nach innen: auf sprachliche Vielfalt, feministische Datenpraktiken, Repräsentation und ein erweitertes Verständnis von Nachhaltigkeit jenseits von Effizienz. Was mich überzeugte, war der konstruktive Grundton: Es ging nicht nur darum, Probleme zu benennen, sondern gemeinsam darüber nachzudenken, was die DH werden könnte, wenn wir diese Lücken ernst nehmen.
Research Software, Posterslam und Empfang im Wiener Rathaus
Ein weiteres Panel widmete sich Research Software Engineering. Sabina Mollenhauer plädierte für eine Richtungsumkehr: Ethnografische Methoden könnten aktiv zur Gestaltung nachhaltiger Research Software beitragen statt Wissen nur von STEM zu übernehmen. Kevin Kuck und Kevin Wunsch zeigten, wie automatisierte Workflows in Editionsprojekten Raum für inhaltliche Forschung schaffen. Kristin Herold, Hizkiel Alemayehu und Daniel Jettka diskutierten am Beispiel Edirom Online, wie Software nach Projektende überlebt: durch Modularisierung, Community-Building und gezielte Kleinstförderungen.
Ein Highlight der Konferenz war der Posterslam: In kürzester Zeit überzeugten die Slamenden das Publikum von ihrer Forschung, gemessen per Lautstärkemessgerät, Kostüme und popkulturelle Referenzen inklusive. Eine mitreißende Einleitung zu zwei Postersessions, bei denen Zeit für viele spannende Gespräche war.
Daten sind nie neutral
Den krönenden Abschluss des letzten Abends bildete der Empfang im Wiener Rathaus, ein sehr imposanter und beeindruckender Rahmen für eine Konferenz, die inhaltlich als auch atmosphärisch viel zu bieten hatte. Und passend zum Gastgeber durfte musikalisch natürlich auch Falco und der Wiener Walzer nicht fehlen.
Was bleibt
Was mich überrascht hat, war die Atmosphäre: offen, vielfältig, von echtem gegenseitigem Interesse geprägt. Gespräche entstanden schnell und unkompliziert, über Fachgrenzen und Karrierestufen hinweg. Als jemand, die gerade mitten im Studium steckt, war es besonders wertvoll, das Gefühl zu haben, wirklich Teil einer Community zu sein, nicht nur Beobachterin.
Das Stipendium von CLARIAH-AT hat mir nicht nur die Reise nach Wien ermöglicht, sondern einen Einblick gegeben, worum es in den Digital Humanities im besten Sinne geht: das gemeinsame Nachdenken über Methoden, Infrastrukturen und Verantwortung, mit Menschen, die das wirklich ernst nehmen.
Sophia Babl, Masterstudium Digital Humanities, Universität Regensburg
From Modelling to Transcription: Workshop Notes from DHd2026
During DHd2026 in Vienna, many discussions revolved around how digital tools shape the way we work with texts and data. Instead of trying to summarise the entire conference, this blog post focuses on the workshops I attended during the first days and on a few ideas that stayed with me throughout the week.
Looking back at my notes, I realised they already suggested a structure for this post. The workshops I attended raised questions about modelling, transcription, and data that later reappeared in other panels and keynotes during the conference.
Note 1: Starting with Practice
My first two days at the conference were shaped by workshops, and that felt like a good way to begin. Rather than starting with big claims about digital humanities, I started by sitting down with tools, notebooks, scripts, and a lot of practical questions.
On the first day, I attended the workshop “Beyond Entities: Inhaltsbasierte Erschließung digitaler Editionen mit KI.” We worked with Python, APIs, and Jupyter notebooks to extract RDF triples from TEI-encoded early modern letters. What I found especially interesting was that the workflow did not stop at named entities. Instead, it tried to model conceptual relations in the texts. Themes such as emotion, illness, or social order became part of a semantic structure that could then be visualised and analysed further.

I liked that this workshop stayed close to the material while still asking what kinds of structures can be made visible through computational methods. It also made very clear that modelling is never neutral. Even at the level of prompts and extraction rules, decisions shape what the final data looks like.
Note 2: From Audio to Text
The second workshop I attended, “Vom Audio zum Text: Automatisierte Transkriptionen mit Whisper,” shifted the focus from written material to spoken language. We looked at automated transcription workflows, compared tools, and worked through Python-based pipelines for transcription and speaker diarisation.

What stayed with me most was the discussion after the practical part. Our reflections quickly clustered around three terms: transfer, opportunities, and limits.
The question of transfer came up in relation to both teaching and research. We talked about how automated transcription might be built into thesis work, methods courses, or training materials. There were ideas about shared standards, open educational resources, and also about making these workflows usable for people who are not deeply technical.
The opportunities were easy to see. Automated transcription can save time, give a quick overview of larger amounts of audio material, and make certain kinds of corpus building much more realistic. Reusable code and adaptable workflows also make it easier to test different research setups.
At the same time, the workshop discussion was just as much about the limits. In qualitative work especially, transcripts are never just raw text. Things like pauses, laughter, overlap, hesitation, and speaker dynamics matter, and automated systems do not capture all of this equally well. We also kept coming back to transparency, validation, and the need to check what a model is actually doing.
For me, this workshop was useful precisely because it did not present automation as a magic solution. It showed where these tools can help, but also where they flatten the material.
Note 3: The Keynote as a Frame
Only after these two workshops came the opening keynote by Miriah Meyer, “Data As ___________: Exploring the Plurality of Data in Visualization.” By that point, I already had the workshop experiences in mind, and that made the keynote even more interesting to listen to.
What I took from it was not one single definition of data, but the opposite. Data appeared here as something plural, shaped, and dependent on context. Meyer spoke about data as entangled, as design material, and as connection. That fit surprisingly well with what I had just seen in the workshops. Whether we are extracting semantic triples from letters or producing transcripts from audio, data do not simply appear ready-made. They are produced through tools, settings, modelling choices, and research interests.
The question “Is data graffiti data?” while looking at sticker emojis museum visitors made on a data sheet, stayed with me because it made this point in a way that was funny and sharp at the same time. It pushed against the idea of data as something clean and self-evident.
Looking Back at the Rest of the Week
For me, the workshops were an amazing start to DHd2026 because they made it possible to move back and forth between trying things out and thinking about what those methods actually imply for research practice.
As the conference continued, I noticed that many of the themes from the workshops reappeared in other sessions. Panels such as “Not Just Text, Intertext!” and projects like NAKAR returned to questions of modelling, connection, and interpretation. The final keynote by Katharina Kinder-Kurlanda then made the political and epistemic side of data work even more explicit.
Looking back at my notes now, this connection between experimentation and reflection is probably my main takeaway from the week. The interesting part is not only that digital tools can do more and more. They also force us to ask more precise questions about modelling, interpretation, transparency, and what we even mean when we call something data. In that sense, the workshops were not just an introduction to tools, but also to the questions that come with using them.
This blog post was written as part of a travel grant for the DHd 2026 conference. My sincere thanks go to NFDI4Memory for supporting my participation, and to the conference organizers for their excellent work in making the event such a positive experience.
CfP: Editopia – Zur Zukunft von Dokumentologie und Editorik im Postdigitalen
Das Institut für Dokumentologie und Editorik (IDE) schaut in die Glaskugel und fragt: Wie werden sich digitale Editionen in den nächsten 20 Jahren entwickeln? Auf der Suche nach Antworten veranstalten wir am 02.-04. September 2026 in Wuppertal eine Konferenz und laden herzlich zu Paper-Proposals ein. Details dazu auf https://editopia2026.i-d-e.de/. Einreichungsfrist ist der 22. März 2026.
Die Benachrichtigung über die Annahme erfolgt bis Ende April 2026. Eine Publikation ausgewählter Beiträge ist in der SIDE-Schriftenreihe vorgesehen. Die Konferenzsprachen sind Englisch und Deutsch. Die Teilnahme ist auf 60 Personen begrenzt. Eine Tagungsgebühr wird nicht erhoben.
- Format: Vorträge, 20 Minuten Länge
- Abstract: 2000-4000 Zeichen inkl. Leerzeichen und Referenzen
- Deadline: 22. März 2026
- Sprachen: Englisch und Deutsch
- Teilnehmer: max. 60 Personen
- Gebühr: keine