❌

普通视图

Received before yesterday

Join the 3rd Base4NFDI User Conference in Berlin (November 24–25)

2026年9月24日 19:29
How can shared research data management services become truly useful for diverse research communities? How can generic infrastructure services be integrated into disciplinary workflows? And what does sustainable operation of such services look like in practice?
 
These questions are at the heart of the 3rd Base4NFDI User Conference (UC4B2026), which will take place at the Staatsbibliothek zu Berlin – Haus Potsdamer Straße on November 24–25. The conference brings together Base4NFDI, its funded basic service teams, and the wider National Research Data Infrastructure (NFDI) community for two days of exchange, collaboration, and hands-on discussions.
 
For researchers, data stewards, infrastructure providers, and community representatives from the humanities and cultural studies, UC4B2026 offers an excellent opportunity to engage directly with services that are shaping the future of research data management in Germany.
 
This year’s programme focuses on practical exchange and strategic reflection. Participants can look forward to hands-on sessions, incubator presentations, and opportunities to showcase how basic services are being integrated into specific communities. The event will also address broader questions such as operating models, long-term sustainability, and the successful technical and organisational roll-out of services across the NFDI consortia.
 
A particular strength of UC4B2026 is its interactive format. Rather than simply presenting finished results, the conference invites participants to discuss needs, challenges, and possible paths towards broader adoption. This makes it especially relevant for communities in the humanities and cultural studies, where research data, methods, tools, and workflows are often highly diverse and context-dependent.
 
At its core, the conference aims to strengthen collaboration between basic service teams and NFDI consortia. It showcases the progress of Base4NFDI services while opening up space to discuss how shared infrastructure can support concrete research practices across disciplines.
 
Participation is free of charge.
Registration: https://events.gwdg.de/event/1337/registrations/1091/

Base4NFDI is an initiative of all 26 NFDI consortia. It develops, integrates, and operates shared basic services for research data management across the NFDI community. Existing services are adapted or extended to support researchers from different disciplines.
If you are interested in research data management, sustainable infrastructure, or the future of shared services in the NFDI, UC4B2026 is the place to be. We warmly invite you to join us in Berlin and contribute your perspective.

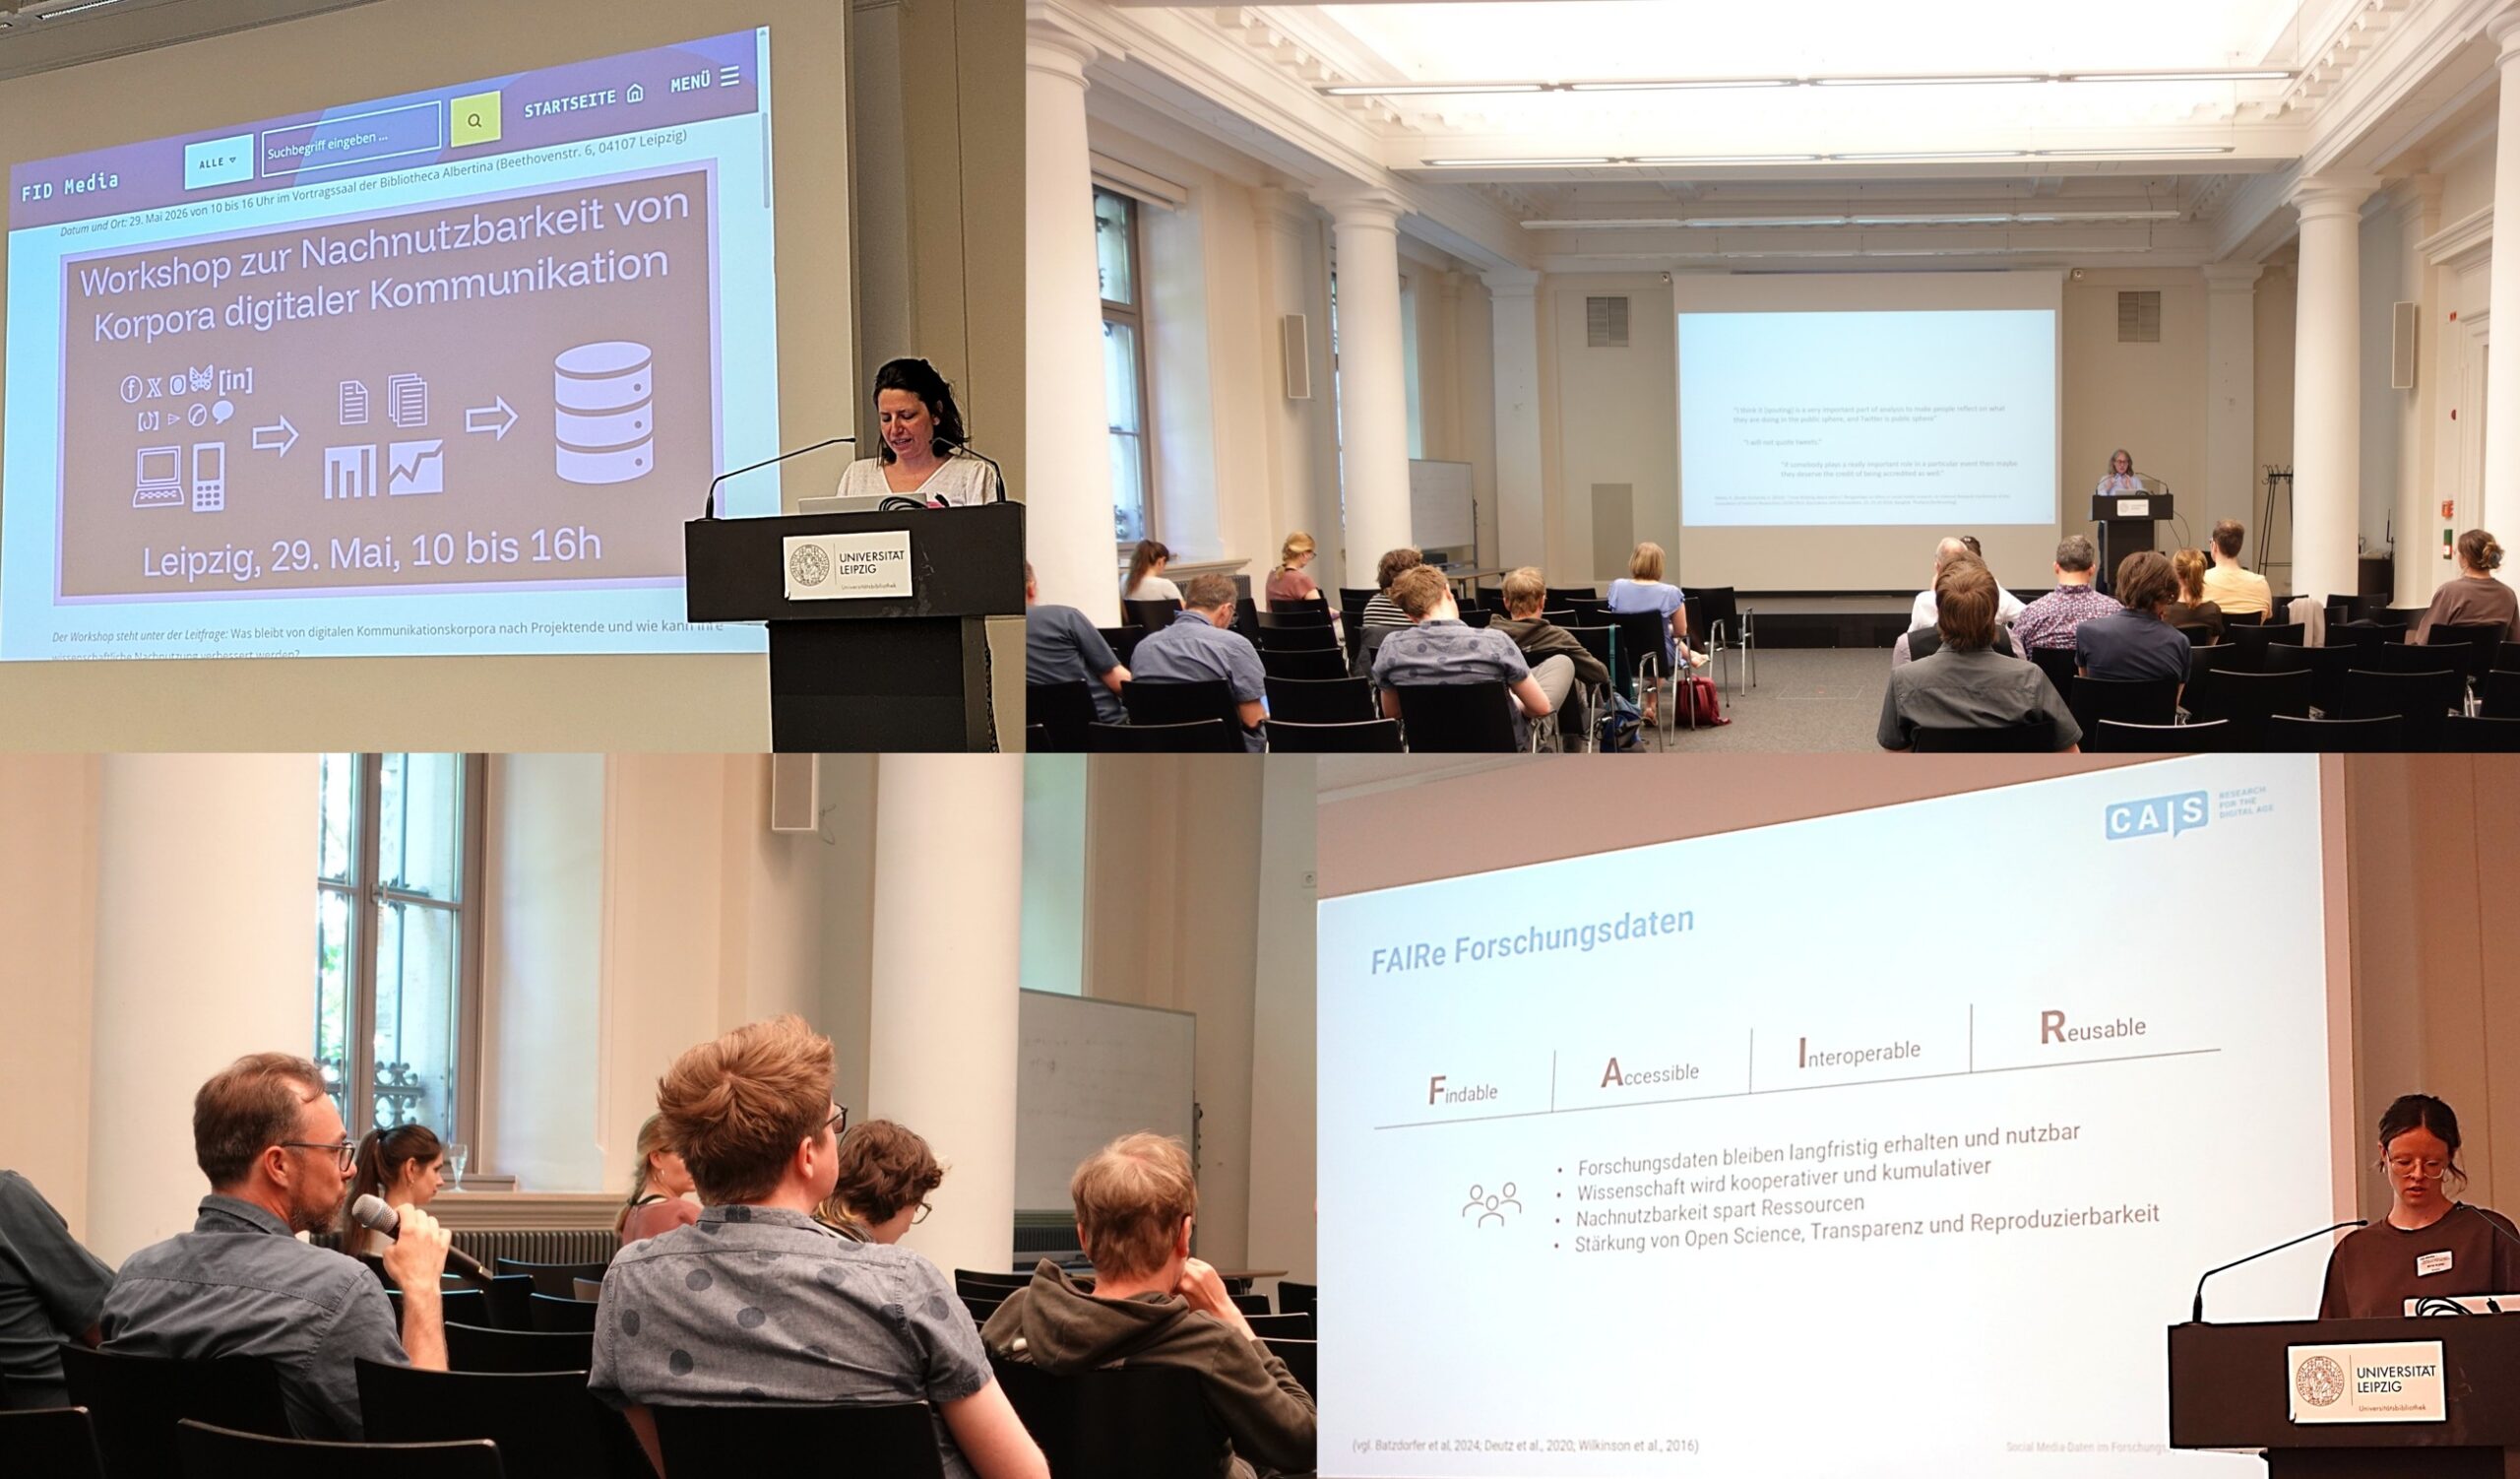
Workshopbericht „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ (29.05.26 in Leipzig)

2026年9月2日 15:28

Von Lukas Hohendorf, Kai Matuszkiewicz, Lydia Riedl und Paula Rinke

Fotos: FID Media

Fotos: FID Media

Ausgangspunkt

In digitalen Räumen werden fortlaufend Daten produziert, die für die Kommunikations- und Medienwissenschaft von hoher Relevanz sind, darunter Beiträge und Kommentare in sozialen Medien, Kommunikationsverläufe in Messenger-Diensten, audiovisuelle und auditive Inhalte, digitale Zeitungsarchive und digitalisierte historische Quellen oder journalistische Online-Angebote. In Forschungsprojekten entstehen daraus häufig umfangreiche Korpora. Viele Forschende wissen aus eigener Erfahrung, dass diese nach Projektende jedoch oft schwer auffindbar, nur eingeschränkt dokumentiert oder aufgrund rechtlicher, ethischer und technischer Rahmenbedingungen nicht ohne Weiteres nachnutzbar bleiben.

An dieser Ausgangsproblematik setzte der Workshop „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ an, den der FID Media am 29. Mai 2026 an der Universitätsbibliothek Leipzig veranstaltete. In ihrer Begrüßung führte Patricia Blume in diese Ausgangsproblematik ein und benannte als übergeordnete Fragen des Workshops, wie digitale Kommunikationskorpora entstehen, unter welchen Bedingungen sie wissenschaftlich analysiert werden können und welche Rolle fachnahe wissenschaftliche Infrastrukturen künftig bei ihrer Dokumentation und Vernetzung spielen können, um sie niedrigschwellig nachnutzbar zu machen.

Wie durch Lukas Hohendorf in seiner anschließenden Einführung erläutert, strukturierte sich der Workshop dabei entlang wichtiger Stationen des üblichen Forschungsprozesses. Im ersten Panel ging es um die Entstehung digitaler Kommunikationsdaten und die methodischen, epistemischen und ethischen Entscheidungen, die bereits die Datenerhebung beeinflussen. Das zweite Panel rückte die Frage in den Vordergrund, wie aus projektgebundenen Datensammlungen längerfristig nachnutzbare Forschungsressourcen werden können. Das dritte Panel diskutierte schließlich die Potenziale und Grenzen vernetzter Kommunikationskorpora für Analyseformen, insbesondere in der Computational Communication Science (CCS).

Von digitaler Kommunikation zu Korpora für die Forschung

Das erste Panel, moderiert von Patricia Blume, widmete sich der grundlegenden Frage, wie digitale Kommunikationsspuren überhaupt zu Forschungsdaten werden. Die Beiträge veranschaulichten, dass digitale Daten nicht einfach „vorliegen“, sondern in komplexen technischen, sozialen und institutionellen Prozessen hergestellt werden. Welche Daten verfügbar sind, welche Lücken entstehen und welche Kommunikationsformen überhaupt beobachtbar werden, hängt von Plattformarchitekturen, Zugangsmöglichkeiten, Erhebungspraktiken, ethischen Entscheidungen und rechtlichen Rahmenbedingungen ab.

Katharina Kinder-Kurlanda (Universität Klagenfurt) nahm in ihrem Beitrag „Epistemische Herausforderungen von Big Social Media Data für die Sozialwissenschaft“ die Entstehungsbedingungen digitaler Daten in den Blick. Sie zeigte, dass Forschung mit großen Datenbeständen aus sozialen Medien immer auch mit asymmetrischen Datenökonomien verbunden ist. Während plattformbetreibende Unternehmen umfangreiche Datenbestände kontrollieren, sind Forschende häufig auf instabile oder nachträglich eingeschränkte Zugänge angewiesen. Diese Abhängigkeit schlägt sich nicht nur in der Datenerhebung selbst nieder, sondern beschränkt auch den Möglichkeitsraum der Forschungsfragen, die wissenschaftlich überhaupt bearbeitbar sind.

Ein zentrales Thema ihres Beitrags war die Sichtbarkeit von Datenarbeit. Viele Entscheidungen, die für wissenschaftliche Ergebnisse maßgeblich sind, bleiben in Publikationen oft unterbelichtet: Wie wurden Daten erhoben, bereinigt, ausgeschlossen, anonymisiert oder transformiert? Welche Plattformbedingungen haben den Zugang strukturiert? Welche ethischen Abwägungen waren im Forschungsprozess erforderlich? Kinder-Kurlanda betonte, dass Datenpraktiken situiert, iterativ und plattformgebunden sind. Transparenz über diese Praktiken ist daher eine Voraussetzung für die Überprüfbarkeit und Einordnung wissenschaftlicher Ergebnisse.

Auch die Archivierung digitaler Plattformdaten wurde als besondere Herausforderung sichtbar. Am Beispiel früherer Twitter-Forschung wurde aufgezeigt, dass die Archivierung von IDs zwar eine Zeit lang als praktikabler Kompromiss galt, langfristig aber keine verlässliche Perspektive bietet, wenn die Rehydrierung, d.h. die Wiederherstellung der Inhalte, weiterhin von der Plattform abhängig bleibt. Dagegen kann die Archivierung von Code, Erhebungsprotokollen, Dokumentationen und Verarbeitungsroutinen auch dann wissenschaftlichen Mehrwert erzeugen, wenn die vollständigen Rohdaten nicht dauerhaft geteilt werden können. In der Diskussion wurde zudem herausgestellt, dass Forschungsethik nicht vollständig an formale Verfahren oder Infrastrukturen delegiert werden kann. Ethikkommissionen, institutionelle Leitlinien und Beratungsangebote können unterstützen, die Verantwortung für konkrete Forschungsentscheidungen bleibt jedoch Teil der wissenschaftlichen Praxis.

Erik Koenen (Universität Bremen) weitete den Blick auf digitale Zeitungsportale und die epistemischen Folgen der Digitalisierung journalistischer Quellen. Im Zentrum des Beitrags stand, dass digitalisierte Zeitungen nicht einfach analoge Objekte in digitaler Form sind. Sie liegen zugleich als Bild, Layout, Volltext, Metadatenstruktur und Suchumgebung vor. Damit verändern sich nicht nur die Zugriffswege, sondern auch der epistemische Status der Quelle selbst. Digitale Zeitungsportale fungieren nicht allein als Archive, sondern auch als methodische und epistemische Forschungsumgebungen.

Koenen argumentierte, dass digitale Zeitungsportale als medientechnische Assemblagen verstanden werden müssen. Sie sind digitale Archive, Sammlungen, Lesesäle, Suchmaschinen und Experimentalsysteme zugleich. Anknüpfend an wissenschaftstheoretische Perspektiven, unter anderem an Ludwik Flecks Konzept wissenschaftlicher Denkstile und Hans-Jörg Rheinbergers Begriff des Experimentalsystems, zeigte er, dass digitale Technologien neue Formen wissenschaftlicher Beobachtung und Interpretation hervorbringen. Distant Reading und Distant Viewing eröffnen neue Perspektiven auf Medienwandel, Layoutgeschichte und öffentliche Kommunikation, setzen aber zugleich eine digitale Quellenkritik voraus, die sich mit Datenformaten, Auszeichnungspraktiken, OCR-Qualität, Portallogiken und Suchinfrastrukturen auseinandersetzt.

Vanessa Angenendt (Universität Duisburg-Essen) brachte mit ihrem Projekt zu Misogynie in Chat-Kommunikation eine weitere Perspektive auf die Entstehung digitaler Kommunikationsdaten ein. Ihr Beitrag befasste sich nicht mit öffentlicher Plattformkommunikation, sondern mit privater oder halböffentlicher Chat-Kommunikation, die der Forschung bislang nur schwer zugänglich ist. Die Datengrundlage bilden Datenspenden, um Chatverläufe zu erfassen, in denen frauenfeindliche oder misogyne Kommunikation sichtbar wird.

Der Beitrag verdeutlichte die gesellschaftliche Relevanz innovativer Wege der Datengewinnung, weil sozial unerwünschte Phänomene wie digitale Misogynie strukturell bedingt häufig in Kommunikationsräumen stattfinden, die sich klassischen Erhebungsverfahren entziehen. Datenspenden eröffnen hier die Möglichkeit, alltägliche und oft verdeckte benachteiligende Praktiken, die in ungleichen Geschlechterverhältnissen verankert sind, empirisch sichtbar zu machen. So zeigten präsentierte Analysen beispielsweise, dass Misogynie in Chat-Kommunikation nicht nur in einzelnen abwertenden Aussagen sichtbar wird, sondern häufig im Verlauf der Interaktion ähnliche Dynamiken erzeugt. Veranschaulicht wurde dies anhand typischer Sequenzen von Kontaktaufnahme, Ablehnung oder Beendigungsversuch, anschließendem Nachsetzen und Herabwürdigen als Machtdemonstration. Konzepte wie „Unwanted Pursuit Behavior“, „Misogynistic Backlash“ oder „Freezing“ systematisierten, wie Kontrolle, Abwertung und Einschüchterung kommunikativ hergestellt werden.

Zugleich zeigte der Beitrag, welche methodischen und ethischen Herausforderungen mit der Analyse privater Kommunikationsräume verbunden sein können. So muss die Datenspende niedrigschwellig organisiert sein, gleichzeitig aber die Datensouveränität der spendenden Personen respektieren. Nach der Einreichung erfolgt eine irreversible Anonymisierung; die Daten werden für die Analyse aufbereitet, enthalten jedoch keine vollständigen Metadaten. Gerade weil es sich um sensible Daten handelt, stellen sich Fragen der Zugänglichkeit, Nachnutzung und Dokumentation besonders nachdrücklich.1 Auch methodische Leerstellen wurden benannt: Chats, die gelöscht wurden, können nicht untersucht werden, und die Zusammensetzung der Datenspendenden ist durch Rekrutierungswege, Bildungshintergründe und mediale Kooperationspartner:innen geprägt.

Insgesamt zeigte das erste Panel, dass Digitale Kommunikationskorpora keine neutralen Abbilder digitaler Kommunikation sind. Vielmehr sind sie Ergebnisse von Entscheidungen, Infrastrukturen, Machtverhältnissen und Praktiken. Für ihre spätere Nachnutzung reicht es daher nicht aus, Daten lediglich abzulegen. Dokumentiert werden muss auch, wie sie entstanden sind, welche Zugänge möglich waren, welche Ausschlüsse vorgenommen wurden, welche Unsicherheiten bestehen und welche rechtlichen oder ethischen Einschränkungen gelten.

Vom Korpus-Silo zur nachnutzbaren Forschungsdatenlandschaft

Das zweite Panel verschob den Fokus von der Entstehung digitaler Korpora auf ihre langfristige Nachnutzung und wurde von Lydia Riedl moderiert. Ausgangspunkt war die Beobachtung, dass viele Korpora in einzelnen Projekten entstehen und nach Projektabschluss in Datensilos verbleiben. Sie sind dann zwar für das ursprüngliche Projekt nutzbar, werden aber für andere Forschende kaum auffindbar, sind unzureichend dokumentiert oder können aus rechtlichen, ethischen oder technischen Gründen nicht geteilt oder mit anderen Daten verknüpft werden. Alle Beiträge griffen dabei einzelne oder mehrere der FAIR-Prinzipien2 (findable, accessible, interoperable, reusable) auf und übertrugen sie auf die besonderen Bedingungen digitaler Kommunikationskorpora.

Vincent Fröhlich (Universität Erlangen-Nürnberg) eröffnete das Panel mit einem Beitrag zu infrastrukturellen Bedarfen der Forschung mit Daten aus sozialen Medien im Bereich Demokratie- und Rechtsextremismusforschung. Er betonte, dass die Volatilität von Plattformdaten eine zentrale Herausforderung darstellt. Inhalte werden gelöscht, Accounts verschwinden, Schnittstellen ändern sich, Zugänge werden eingeschränkt. Was heute erhoben werden kann, ist morgen möglicherweise nicht mehr verfügbar. Für die Forschung bedeutet dies, dass Fragen der Sicherung, Dokumentation und Nachvollziehbarkeit frühzeitig mitgedacht werden müssen.

Besonders betonte Fröhlichs Beitrag, dass Sicherheit in diesem Forschungsfeld mehrdimensional ist. Es geht nicht nur um die Sicherheit der Daten selbst, sondern auch um die Sicherheit der Forschenden und der beforschten Personen. Wer zu Rechtsextremismus, Desinformation oder demokratiegefährdender Kommunikation forscht, kann selbst zur Zielscheibe werden. Forschungsinfrastrukturen müssen neben der Auffindbarkeit und Nachnutzung von Daten auch Schutzräume, Zugriffskontrollen und gut reflektierte Formen der Sichtbarkeit mitdenken. In der Diskussion wurde die Spannung zwischen wissenschaftlicher Sichtbarkeit, die insbesondere für Qualifikations- und Karrierewege wichtig ist, und dem Schutz von Forschenden thematisiert. Hier zeigte sich, dass Infrastrukturen auch institutionelle Sensibilisierung und Schutzmechanismen unterstützen können.

Birte Kuhle (Center for Advanced Internet Studies) griff die Frage nach nachnutzbaren Daten aus der Perspektive des Forschungsdatenlebenszyklus auf. Ihr Beitrag zu praktischen Herausforderungen im Umgang mit Daten aus sozialen Medien zeigte, dass Forschungsdatenmanagement nicht erst am Ende eines Projekts beginnt. Bereits in der Phase „Discover, Plan & Design“ stellen sich Fragen des Samplings, der Plattformauswahl sowie zu ihren jeweiligen Beschränkungen, der Datenzugänge und der rechtlichen Rahmenbedingungen. In der Phase der Datenerhebung können geplante Zugänge, etwa über Plattform-APIs, kurzfristig wegfallen. Forschende müssen dann alternative Wege wie Datenspenden oder Webscraping prüfen, die wiederum eigene ethische und rechtliche Fragen aufwerfen.

Auch die Verarbeitung und Analyse von Daten aus sozialen Medien ist mit erheblicher Datenarbeit verbunden. Daten müssen bereinigt, strukturiert, mit IDs versehen, versioniert und dokumentiert werden. Multimodale Daten erhöhen den Aufwand zusätzlich, weil Text, Bild, Audio und Video unterschiedliche Formate, Werkzeuge und Dokumentationslogiken erfordern. Für die Phase „Publish, Archive & Share“ stellte Kuhle die Frage, was überhaupt veröffentlicht werden darf, welche Teile eines Datensatzes zugänglich gemacht werden können und wie FAIR-Prinzipien unter Bedingungen eingeschränkter Teilbarkeit umgesetzt werden können.

Als zentrale take-aways formulierte Kuhle, dass die Arbeit mit Social-Media-Daten technische, methodische sowie rechtlich-ethische Kompetenzen verlangt und häufig mit hohem Ressourcenaufwand bei zugleich fehlenden Unterstützungs- und Anreizstrukturen verbunden ist. FAIR-Prinzipien, Community-Standards und Forschungsdateninfrastrukturen erscheinen vor diesem Hintergrund nicht als nachgelagerte Formalia, sondern als Voraussetzung dafür, Social-Media-Daten transparenter, nachvollziehbarer und nachnutzbarer zu machen. Die Diskussion zeigte darüber hinaus, dass Metadatenstandards, Codeveröffentlichung und Dokumentationspraktiken bislang noch nicht einheitlich etabliert sind.

Philipp Knöpfle (LMU München) widmete sich mit Blick auf das Projekt „Meta-Rep“ der Reproduzierbarkeit und Replizierbarkeit computationaler Kommunikationsforschung. Anhand eines Literaturreviews zu mehreren hundert Studien zeigte er, dass Daten und Code in der CCS bislang nur selten systematisch geteilt werden. Besonders problematisch ist dies bei Plattformdaten, da sie sich oft nur schwer oder gar nicht replizieren lassen. Wenn Datenzugänge eingeschränkt sind, Plattformen Inhalte löschen oder Schnittstellen verändern, kann eine spätere Replikation schnell unmöglich werden.

Knöpfle unterschied dabei zwischen Reproduzierbarkeit und Replizierbarkeit und zeigte, dass beide Ziele unterschiedliche Anforderungen an Daten, Code und Dokumentation stellen. Selbst wenn Rohdaten aus rechtlichen oder praktischen Gründen nicht geteilt werden können, können Begleitmaterialien oder Metadaten durchaus hilfreich dabei sein, Studienergebnisse besser einzuordnen. Hierzu zählen die Veröffentlichung von Code, die Dokumentation der Datenerhebung, die Beschreibung von Samplingentscheidungen, die Offenlegung von Preprocessing-Schritten und die Angabe von Tools inklusive Parametern und Versionierung. In der Diskussion kam auf, dass die Wahl geeigneter Ablageorte ebenfalls eine praktische Frage ist. Während Plattformen wie The Open Science Framework (OSF) zum Zeitpunkt des Workshops vielen Forschenden niedrigschwelliger erschienen3, bieten institutionelle Git-Infrastrukturen andere Vorteile, setzen aber höhere technische Kompetenzen voraus.

Eine verbindende Klammer über die Beiträge im zweiten Panel hinweg war, dass Nachnutzbarkeit nicht zwingend vollständige Offenlegung aller Daten bedeutet. Gerade digitale Kommunikationsdaten sind häufig sensibel, rechtlich geschützt oder plattformabhängig. Umso wichtiger sind gestufte Zugangsmodelle, umfängliche und verständliche Dokumentation, sowie die Sicherung von Kontextinformationen. Auch nicht vollständig teilbare Korpora können wertvoll für die Forschung bleiben, wenn nachvollziehbar ist, wie sie entstanden sind, welche Analysen mit ihnen durchgeführt wurden und unter welchen Bedingungen andere Forschende daran anschließen können.

Vernetzte Kommunikationskorpora analysieren: Potenziale und Fallstricke

Das dritte Panel wurde von Kai Matuszkiewicz moderiert und richtete den Blick auf die Analyse vernetzter Kommunikationskorpora. Welche neuen Forschungsperspektiven entstehen, wenn digitale Kommunikationsdaten gut dokumentiert, referenzierbar und miteinander verknüpfbar sind? Und welche methodischen Voraussetzungen müssen erfüllt sein, damit großskalige, plattformübergreifende und KI-gestützte Analysen valide Ergebnisse liefern?

Marko Bachl (FU Berlin) eröffnete das Panel mit einem Beitrag zu Bias und epistemischen Konsequenzen für die CCS. Ausgangspunkt war ein statistisches Verständnis von Bias als systematischem Fehler, der von zufälliger Varianz zu unterscheiden ist. Der Bias-Variance-Tradeoff diente dabei als analytisches Raster, um Chancen und Risiken automatisierter Verfahren in der Kommunikationsforschung einzuordnen.

Am Beispiel von Large Language Models (LLMs) in der Inhaltsanalyse zeigte Bachl, dass automatisierte Verfahren neue Möglichkeiten eröffnen. So können sie beispielsweise nicht-textuelle Kommunikationsinhalte transkribieren, Inhalte extrahieren, große Stichproben klassifizieren und damit Analysen ermöglichen, die hand-codiert kaum durchführbar wären. Zugleich können sie die Reproduzierbarkeit erhöhen, weil dieselben Verfahren auf große Datenmengen konsistent angewendet werden können. Diese Reduktion von Varianz geht jedoch nicht automatisch mit einer Reduktion von Bias einher. Im Gegenteil: Automatisierte Verfahren können systematische Verzerrungen erzeugen oder verstärken, wenn Trainingsdaten, Modellarchitekturen, Prompts oder Validierungsmaßstäbe bestimmte Perspektiven privilegieren.

In der anschließenden Diskussion wurde dafür plädiert, dass die Bewertung von KI-gestützten Verfahren nicht abstrakt erfolgen kann. Entscheidend ist, welches Forschungsziel verfolgt wird, welcher Referenzmaßstab angesetzt wird und welche Formen von Fehlern in Kauf genommen werden wollen. Menschliche Codierungen sind dabei nicht automatisch ein unverzerrter Goldstandard, sondern selbst Ergebnis sozialer Umstände sowie methodischer und interpretativer Entscheidungen. Gerade deshalb braucht die CCS eine explizite Auseinandersetzung mit Validierung, Bias, De-Biasing und den epistemischen Annahmen automatisierter Analyseverfahren.

Felix Victor Münch (GESIS/HBI) knüpfte mit seinem Beitrag an die forschungspraktischen Potenziale von LLMs an. Im Zentrum stand die Frage, wie diese zur plattform-, medien- und sprachübergreifenden Verknüpfung von Kommunikationsdaten eingesetzt werden können. Münch zeigte anhand mehrerer Anwendungsbeispiele, dass LLMs nicht nur als dialogische Systeme verstanden werden sollten, sondern als Werkzeuge zur Strukturierung, Transformation, Klassifikation und Verknüpfung großer, heterogener Datenbestände.

Ein Beispiel bezog sich auf die plattformübergreifende Analyse von Kommunikation zu Klimawandel, Desinformation und rechtsextremen Diskursen. Hier wurden große Datenmengen über längere Zeiträume hinweg erhoben und mit Verfahren wie Embeddings, Clustering und Netzwerkanalysen ausgewertet. Ein weiteres Beispiel stellte die Analyse von politischer Kommunikation in TikTok-Videos dar. Semantische Ähnlichkeitsmodelle wurden genutzt, um Themenprofile, Nähebeziehungen und Kommunikationsstrukturen zwischen unterschiedlichen Akteur:innen sichtbar zu machen.

Die Beispiele zeigten anschaulich, welche analytischen Möglichkeiten entstehen können, wenn Daten aus unterschiedlichen Plattformen, medialen Formen und Sprachen in gemeinsame Repräsentationsräume überführt werden können. Dadurch werden Vergleiche möglich, die zuvor nur mit erheblichem manuellem Aufwand oder überhaupt nicht realisierbar waren. Zugleich zeigte Münch, dass solche Pipelines technisch und organisatorisch voraussetzungsreich sind. Sie erfordern Rechenressourcen, methodisches Know-how, sorgfältige Datenaufbereitung und Verfahren zur Qualitätskontrolle. LLMs können solche Prozesse perspektivisch vereinfachen, ersetzen aber nicht die Notwendigkeit, Datenkontexte, Modellentscheidungen und Bewertungskriterien transparent zu dokumentieren.

Jakob Jünger (Universität Münster) schloss das Panel mit einem Beitrag zu Normdaten und Knowledge Graphs als Grundlage für Sekundäranalysen. Sein Ausgangspunkt war die Frage, wie geistes- und sozialwissenschaftliche Arbeitspraktiken stärker miteinander verbunden werden können. Während klassische Nachweis- und Katalogsysteme Literatur, Daten oder Projekte auffindbar machen, erlauben sie meist keine strukturierte Abfrage wissenschaftlicher Aussagen, Beziehungen und Kontexte. Normdaten, kontrollierte Vokabulare, Ontologien und Knowledge Graphs können hier neue Formen der Vernetzung ermöglichen.

Jünger erläuterte Normdaten als Identifier, Vokabulare und Ontologien, die Entitäten eindeutig beschreibbar und miteinander verknüpfbar machen. Knowledge Graphs bilden solche Entitäten und ihre Beziehungen als Netzwerk ab. Als bekanntes Beispiel wurde Wikidata herangezogen. Für die Kommunikationswissenschaft skizzierte Jünger drei mögliche Beteiligungsformen: bestehende Datensätze können mit Normdaten angereichert werden, bestehende Wissensbestände können um neue fachlich relevante Entitäten erweitert werden, und fachnahe Infrastrukturen können eigene Knowledge Graphs aufbauen und betreiben.

Besonders relevant wurde diese Perspektive im Hinblick auf Interoperabilität. Daten werden nicht allein dadurch FAIR, dass sie irgendwo abgelegt werden. Sie müssen auffindbar, zugänglich, interoperabel und nachnutzbar beschrieben sein. Für die Kommunikations- und Medienwissenschaft eröffnet dies erhebliche Potenziale. Forschungsprojekte, Datensätze, Publikationen, Tagungsbeiträge, Personen, Institutionen, Quellen, Methoden und Untersuchungsgegenstände könnten miteinander verknüpft werden. Damit würde nicht nur die Recherche verbessert, sondern auch die Grundlage für Sekundäranalysen, fachgeschichtliche Auswertungen und neue Formen der Wissensrepräsentation geschaffen.

Das dritte Panel zeigte insgesamt, dass vernetzte Kommunikationskorpora große Analysepotenziale eröffnen können. LLMs, computationale Methoden, Normdaten und Knowledge Graphs ermöglichen neue Perspektiven auf Kommunikationsdynamiken über Plattform-, Medien-, Sprach- und Zeitgrenzen hinweg. Zugleich wurde sichtbar, dass diese Potenziale sich nur dann in wissenschaftlich belastbare Ergebnisse verwirklichen lassen, wenn Datenqualität, Validierung, Interoperabilität, Dokumentation und Bias systematisch reflektiert werden.

Fünf zentrale Erkenntnisse des Workshops

Über alle drei Panels hinweg zog sich der Befund, dass digitale Kommunikationskorpora keine bloßen Sammlungen neutraler Daten sind. Sie entstehen durch soziale, rechtliche, wissenschaftliche, technische und ethische Entscheidungen sowie durch die Bedingungen ihrer Erhebung, Verarbeitung und Aufbereitung. Ihre Qualität bemisst sich daher nicht allein an Umfang oder technischer Verfügbarkeit, sondern an der Nachvollziehbarkeit ihrer Entstehung, Prozessierung und Kontextualisierung.

Eine zweite zentrale Erkenntnis war, dass diese Bedingungen der Datenentstehung systematischer dokumentiert werden müssen. Dazu gehören Plattformbedingungen, Zugangspfade, Samplingentscheidungen, Löschungen und Ausschlüsse, fehlende Daten, Anonymisierungsschritte, Metadatenverluste und ethische Abwägungen. Gerade bei Daten aus sozialen Medien, Datenspenden oder digitalisierten Quellen ist entscheidend, welche Teile der Kommunikation sichtbar werden, welche unsichtbar bleiben und wie diese Einschränkungen der Datenbasis nachvollziehbar gemacht werden können.

Drittens zeigte sich, dass Nachnutzung nicht mit vollständiger Offenheit gleichgesetzt werden darf. Viele digitale Kommunikationsdaten können aus guten Gründen nicht frei zugänglich gemacht werden. Trotzdem können sie durch beschreibende Metadaten, Code, Dokumentationen, Analyseprotokolle, kontrollierte Zugangsmodelle oder Verweise auf geeignete Kontaktstellen wissenschaftlich anschlussfähig bleiben.

Viertens wurde die Bedeutung von Interoperabilität sichtbar. Wenn Forschungsdaten, Publikationen, Projekte, Personen, Institutionen, Quellen und Methoden isoliert voneinander dokumentiert werden, bleiben viele Anschlussmöglichkeiten ungenutzt. Entitätenbasierte Modelle, Normdaten und Knowledge Graphs können dazu beitragen, Forschungsergebnisse nicht nur abzulegen, sondern in fachliche Zusammenhänge durch die Nutzung von Semantic-Web-Anwendungen einzubetten.

Eine fünfte zentrale Erkenntnis liegt darin, dass Infrastrukturen nicht erst am Ende des Forschungsprozesses relevant werden. Sie können bereits in der Planungsphase helfen, Datenerhebungen besser zu koordinieren, rechtliche und ethische Fragen frühzeitig zu klären, Dokumentationsstandards mitzudenken und spätere Nachnutzung vorzubereiten.

Perspektiven für die Arbeit des FID Media

Für den FID Media ergaben sich aus dem Workshop mehrere konkrete Handlungsfelder, die bereits in der von Lukas Hohendorf moderierten Abschlussdiskussion aufgegriffen wurden und in der weiteren strategischen Entwicklung geprüft und mit der Fachcommunity vertieft werden sollen.

Ein erstes mögliches Handlungsfeld liegt in der Entwicklung fachspezifischer Dokumentationsvorlagen für digitale Kommunikationskorpora. Diese sollten gemeinsam mit Forschenden erarbeitet werden und unterschiedliche Datentypen berücksichtigen: Plattformdaten, Chatdaten, journalistische Inhalte, audiovisuelle Materialien, digitalisierte Quellen und multimodale Korpora. Solche Vorlagen könnten Mindestangaben zu Datenherkunft, Erhebungswegen, Sampling, Plattformbedingungen, Preprocessing, Versionierung, Anonymisierung, rechtlichen Grundlagen und Nutzungsrechten, Zugangsbedingungen und möglichen Verzerrungen enthalten. Ziel wäre keine zusätzliche Bürokratie, sondern eine praxistaugliche Unterstützung für Forschende, die ihre Daten nachvollziehbar und nachnutzbar dokumentieren möchten. In der Entwicklung derartiger Vorlagen liegt eine Zusammenarbeit mit NFDI-Konsortien nahe, wie sie bereits in der Vergangenheit gepflegt wurde, insbesondere mit dem von NFDI4Culture, Text+, BERD@NFDI und KonsortSWD getragenen Arbeitskreis Social Media-Daten in der Forschungspraxis.

Ein zweites Handlungsfeld betrifft den Aufbau einer fachnahen Nachweis-, Register- und Vermittlungsinfrastruktur für digitale Kommunikationskorpora. Ein solches Angebot könnte geplante, laufende und abgeschlossene Korpusvorhaben in der Kommunikations- und Medienwissenschaft sichtbar machen: Welche Projekte erheben oder nutzen Daten zu welchen Plattformen, Quellen, Zeiträumen und Themen, mit welchen Methoden und unter welchen Zugangsbedingungen? Besonders vielversprechend wäre dabei eine Funktion für geplante Datenerhebungen. Forschende könnten Vorhaben frühzeitig eintragen, wodurch sich Kooperationsmöglichkeiten erkennen lassen, bevor Daten mehrfach, inkompatibel oder unter hohem Aufwand parallel erhoben werden. Zugleich könnte der FID Media abgeschlossene Projekte, Datensätze, Publikationen, Codebooks, Präsentationen, Personen, Einrichtungen, Methoden und Einträge in externen Repositorien fachlich erschließen und miteinander verknüpfen. Der FID Media müsste dafür nicht alle Daten selbst speichern, sondern Daten könnten dort öffentlich publiziert, archiviert oder kontrolliert zugänglich gemacht werden, wo die jeweils geeigneten technischen und rechtlichen Voraussetzungen bestehen. Der FID Media könnte durch ein zentrales Forschungsregister ergänzend dafür sorgen, dass diese Ressourcen für die Kommunikations- und Medienwissenschaft sichtbar, verständlich kategorisiert und mit weiteren fachlichen Informationen verknüpft werden. Das entitätenbasierte Modell des Repositoriums des FID Media bietet hierfür eine vielversprechende Grundlage und könnte perspektivisch einen Beitrag zu potenziellen fachlichen Wissensgraphen der Kommunikations- und Medienwissenschaft leisten.

Ein drittes Handlungsfeld besteht in der Weiterentwicklung von Beratung und Vernetzung von Forschenden mit Infrastrukturen. Der Workshop zeigte, dass Forschende bei digitalen Kommunikationskorpora regelmäßig mit rechtlichen, ethischen und technischen Fragen konfrontiert sind: Was darf erhoben werden? Was darf gespeichert, geteilt oder veröffentlicht werden? Welche Teile eines Datensatzes können offen zugänglich sein, welche nur kontrolliert, welche gar nicht? Welche Dokumentation ist sinnvoll, wenn Daten nicht geteilt werden können? Hier prüft der FID Media, in seinen bestehenden Beratungsangeboten, etwa zu Urheberrecht, Open Access, Open Science und Forschungsdatenmanagement, noch stärker die spezifischen Bedarfe digitaler Kommunikationsforschung zu berücksichtigen.

Fazit

Der Workshop hat gezeigt, dass die Frage „Was bleibt von digitalen Kommunikationskorpora?“ nicht erst nach Projektende gestellt werden sollte. Sie beginnt bereits bei der Auswahl von Quellen, Plattformen und Zugängen, setzt sich in Sampling, Datenerhebung, Datenbereinigung und Analyse fort und reicht bis zur Publikation, Archivierung und späteren Nachnutzung. Digitale Kommunikationskorpora sind nur dann langfristig wissenschaftlich wertvoll, wenn ihre Entstehungsbedingungen, ihre Einschränkungen und ihre Nutzungskontexte nachvollziehbar bleiben.

Für die Kommunikations- und Medienwissenschaft ergibt sich daraus eine doppelte Herausforderung. Einerseits eröffnen digitale Korpora neue Forschungsperspektiven, etwa auf schwer zugängliche Kommunikationsräume, langfristige Medienentwicklungen, plattformübergreifende Diskurse oder multimodale Kommunikationsdynamiken. Andererseits entstehen neue Anforderungen an Quellenkritik, Datenethik, Dokumentation, Reproduzierbarkeit, Interoperabilität und Infrastrukturen.

Der FID Media nimmt aus dem Workshop den Auftrag mit, diese Fragen gemeinsam mit der Fachcommunity weiterzuverfolgen. Ziel ist es, digitale Kommunikationskorpora nicht nur als projektgebundene Datensammlungen zu betrachten, sondern als potenziell vernetzte Forschungsressourcen, die zukünftige Forschung vorbereiten, erleichtern und sichtbar machen können. Entscheidend wird sein, hierfür niedrigschwellige, fachnahe und zugleich methodisch passende Angebote zu entwickeln. Diese reichen von der Beratung in der Planungsphase über Standards in der Dokumentation und der Registrierung laufender Vorhaben bis hin zur Unterstützung bei der Publikation, Verzeichnung und Vernetzung abgeschlossener Projekte.

Der Workshop hat damit den Blick weg vom einzelnen Korpus hin auf die Voraussetzungen seiner wissenschaftlichen Anschlussfähigkeit gelenkt. Für Open Science in der Kommunikations- und Medienwissenschaft folgt daraus, dass nicht allein entscheidend ist, ob Daten veröffentlicht werden können, sondern ob ihre Herkunft, Reichweite, Einschränkungen und Beziehungen so beschrieben sind, dass sie in der Forschungscommunity weitergedacht, geprüft und kombiniert werden können. Hierin liegt die künftige Infrastrukturaufgabe, die Kommunikations- und Medienwissenschaft darin zu unterstützen, aus verstreuten Projektspuren einen übersichtlichen und möglichst vollständigen Orientierungsraum zu schaffen, in dem neue Forschung nicht immer wieder bei null beginnen muss, sondern auf bereits geleistete Aufwände und vorhandene Erkenntnisse aufbauen und bestehende Ergebnisse produktiv nachnutzen kann.


1 In der Diskussion wurde außerdem die öffentliche Verfügbarkeit der Daten unter ethischen Gesichtspunkten zur Debatte gestellt, da sie sich als Trainingsmaterial für böswillige Chatbotbetreibende eignen würden.

2 Wilkinson, M., Dumontier, M., Aalbersberg, I. et al. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data 3, 160018. https://doi.org/10.1038/sdata.2016.18

3 Anmerkung: Nach dem Workshop kündigte das Center for Open Science an, den Bereich OSF Projects wegen fehlender Finanzierung auslaufen zu lassen, so dass ab November 2026 keine neuen Projekte mehr angelegt werden können. Diese Entwicklung zeigt, dass Open Science nicht allein niedrigschwellige Werkzeuge, sondern wissenschaftsgeleitete, institutionell fest verankerte und dauerhaft finanzierte Infrastrukturen benötigt, um die langfristige Verfügbarkeit von Forschungsinhalten sicherstellen und die FAIR-Prinzipien umzusetzen.

Der Text dieses Beitrags steht unter der Lizenz Creative Commons Namensnennung 4.0 International (CC BY 4.0). Die Abbildungen sind von dieser Lizenz ausgenommen; alle Rechte vorbehalten.

Aufeinander zugehen: Die Dokumentation des GND-Forums Humanities@NFDI vom 23./24. Juni 2026

2026年7月27日 14:58

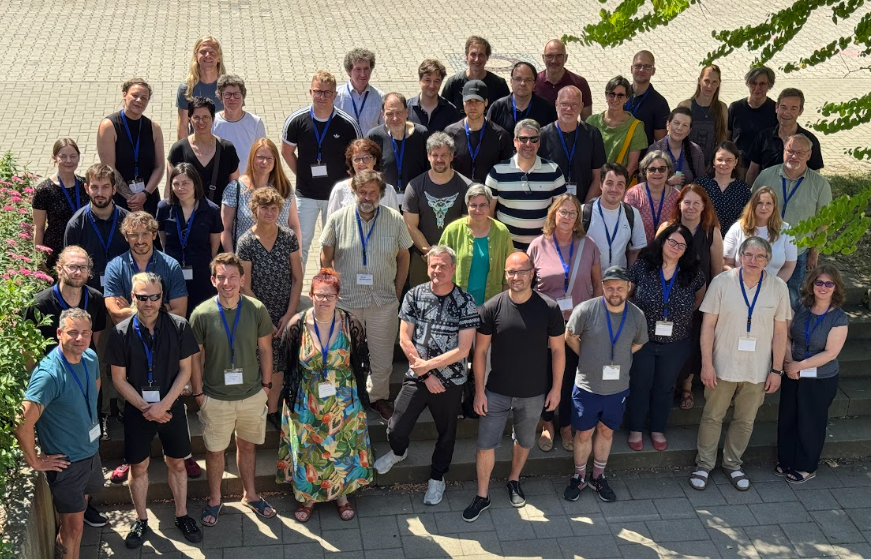
Wie kann die Gemeinsame Normdatei (GND) die Zusammenarbeit der geistes- und kulturwissenschaftlichen NFDI-Konsortien stärken? Dieser Frage widmeten sich knapp 80 Teilnehmende beim GND-Forum Humanities@NFDI am 23. und 24. Juni 2026 in Göttingen.

Unter dem Motto „Aufeinander zugehen“ wurden Tools und Services mit GND-Bezug vorgestellt, unterschiedliche Perspektiven auf zentrale GND-Entitätstypen diskutiert und gemeinsam Perspektiven für eine vertiefte Zusammenarbeit entwickelt. Die Ergebnisse des Forums sind nun in drei Publikationen und einem Blogpost dokumentiert:

🔹 Zwölf Tools und Anwendungen mit GND-Bezug – eine Sammlung praktischer Steckbriefe zu Anwendungen aus den beteiligten Konsortien und der GND-Zentrale: Zur Steckbriefsammlung.

🔹 „Eine Rose ist eine Rose …“ – die Ergebnisse der Fishbowl-Diskussionen zu Geografika, Sachbegriffen, Körperschaften und Werken: Zur Dokumentation der Diskussionen.

🔹 „Eine lingua franca“ – ein Positionspapier mit fünf Thesen zur Zukunft der Zusammenarbeit und zur GND als verbindender Infrastruktur: Zum Positionspapier. Über Kommentare und Anmerkungen zum Positionspapier freuen wir uns sehr, nutzen Sie dafür bitte diesen Link.

Die Dokumentation lädt dazu ein, die Diskussionen und Ergebnisse des Forums nachzulesen und den gemeinsamen Weg zu einer stärker vernetzten geistes- und kulturwissenschaftlichen Forschungsdateninfrastruktur weiterzugehen.

Gruppenfoto GND-Forum Humanities@NFDI

Gruppenfoto GND-Forum Humanities@NFDI

Clustertreffen des N4O CC Data Capture and Creation zum Thema Culture Cloud am 8. September 2026

2026年7月27日 14:20

Am 8. September 2026, 14:30 bis 16:00 Uhr, findet das nächste Clustertreffen des CC Data Capture and Creation statt.

Dieses Mal wird unser Co-Chair Frank Dührkohp (Verbundzentrale des GBV) einen Einblick in das Projekt Culture Cloud geben.

Mit der Culture Cloud entsteht erstmals eine landesweite Kulturdateninfrastruktur für Niedersachsen, die Informationen aus Museen, Archiven, Bibliotheken und der Denkmalpflege zusammenführt. Was bislang dezentral gespeichert und oft schwer auffindbar war, wird nun über einheitliche Standards vernetzt und zentral zugänglich gemacht. So können die Daten künftig über digitale Portale leichter gefunden, miteinander verknüpft und für Forschung, Kultur und Öffentlichkeit nutzbar werden – bei voller Datenhoheit der jeweiligen Einrichtungen.

Hier sind die Zoom-Zugangsdaten:

https://dainst-org.zoom.us/j/93071809817?pwd=YVscWm2i20FHyG8hgVhcO712Wya9Vv.1

Meeting-ID: 930 7180 9817
Kenncode: 032259

Eine Anmeldung ist nicht erforderlich, wir freuen uns auf einen Austausch!

KI als Belastungsprobe für das offene Internet? Bericht vom Panel bei der DHd 2026 in Wien

2026年7月16日 23:58

Autor*innen (in alphabetischer Reihenfolge): David Maus, Staats- und Universitätsbibliothek Hamburg, https://orcid.org/0000-0001-9292-5673; Sarah Oberbichler, Luxembourg Centre for Contemporary and Digital History (C²DH), https://orcid.org/0000-0002-1031-2759 ; Grischka Petri, FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur ,https://orcid.org/0000-0002-2548-449X; Cindarella Petz, Leibniz-Institut für Europäische Geschichte (IEG) Mainz, https://orcid.org/0000-0002-6178-7332 ; Klaus Rettinghaus, Sächsische Landesbibliothek — Staats- und Universitätsbibliothek Dresden (SLUB), https://orcid.org/0000-0003-1898-2543; Ulrike Wuttke, Fachhochschule Potsdam. Fachbereich Informationswissenschaften, SeDOA, https://orcid.org/0000-0002-8217-4025 

Hintergrund des Panels auf der DHd 2026

Am 25. Februar 2026 fand bei der DHd 2026 in Wien das Panel “KI als Belastungsprobe für das offene Internet” (Link zum Abstract auf Zenodo: https://doi.org/10.5281/zenodo.18696199) statt. Organisiert wurde das Panel von Ulrike Wuttke (Fachhochschule Potsdam, Fachbereich Informationswissenschaften, SeDOA), David Maus (Staats- und Universitätsbibliothek Hamburg), Fabian Rack (FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur, NFDI4Culture), Klaus Rettinghaus (Sächsische Landesbibliothek – Staats- und Universitätsbibliothek Dresden), Sarah Oberbichler (Luxembourg Centre for Contemporary and Digital History (C²DH), und Cindarella Petz (Digital Historical Research | DH Lab, Leibniz-Institute of European History (IEG)). Moderiert wurde das Panel von Ulrike Wuttke, Klaus Rettinghaus und Cindarella Petz. Da Fabian Rack zum Termin leider verhindert war, nahm an seiner Stelle für die NFDI4Culture Grischka Petri (FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur) neben David Maus und Sarah Oberbichler einen Sitz als Panelist*in ein. 

Im Mittelpunkt des Panels stand der Umgang mit den durch die momentanen KI-Entwicklungen verursachten Herausforderungen für offene Informationsinfrastrukturen, wie z. B. KI-Bot-Aktivitäten, sowie der Umgang mit aktuellen rechtlichen Herausforderungen und methodische Implikationen, insbesondere für die Digital Humanities (Shearer und Walk 2025 (COAR-Umfrage), Berg-Weiß 2025, COAR 2026). Die Paneldiskussion adressierte neben technischen und rechtlichen Lösungsansätzen Chancen und Herausforderungen des aktuellen Paradigmenwechsels im Umgang mit offenen Informationsinfrastrukturen und hinterfragte, wie sich der aktuelle KI-Trend mit den Prinzipien offenen Wissens und ethischen Prinzipien in den Digital Humanities und darüber hinaus vereinbaren lässt. Dabei wurden von den Panelist*innen technische, ethische und rechtliche Aspekte beleuchtet.

Einleitung KI und offenes Internet

Eingeleitet wurde das Panel durch Klaus Rettinghaus mit einer thematischen Einführung zum Thema KI und offenes Internet. Er führte aus, dass als OpenAI im November 2022 ChatGPT vorstellte, einerseits das Interesse an dieser neuen Technologie auf Benutzerseite groß war; andererseits die Sorgen bei den Tech-Giganten viel größer waren, nun unter Zugzwang gesetzt zu sein, um schnell zu handeln. Dies führte dazu, dass viele eifrig mit dem Training eigener Modelle begannen, um nicht den Anschluss zu verlieren (Hao 2026).

Ein Problem bei dieser Entwicklung ist, dass die KI-Modelle immer mehr Trainingsdaten benötigen, die sie sich ungefragt und oftmals ohne Erlaubnis überall besorgen und damit den Internet-Traffic in ungeahnte Höhen treiben (Heise 2025a). Das führt dazu, dass inzwischen zahllose KI-Bots das gesamte World Wide Web “abgrasen” und sich dabei als „normale“ Benutzer tarnen (Heise 2025b). Viele „Hüter“ des freien Wissens (wie z.B. Bibliotheken, Wikipedia) werden von Stiftungen oder der öffentlichen Hand finanziert und sind technisch weder für diesen gigantischen Anstieg des Verkehrs ausgelegt noch vorbereitet (Bsp. Thread Fitzpatrick 2026). Sie versuchen, dem Treiben Herr zu werden, indem sie Schranken aufbauen und sich immer mehr abschotten. Klaus Rettinghaus stellte diese Punkte dem Plenum und den Panelist*innen zur Diskussion, denn noch ist kein Ende dieses “Spuks” vorhersehbar und wirft diese neue Realität viele Fragen auf.

Paneldiskussion

Ziel der Paneldiskussion war es, grundlegende Aspekte der aktuellen KI-Entwicklungen in Bezug auf das offene Internet zu diskutieren. Mit Sarah Oberbichler, David Maus und Grischka Petri waren drei Expert*innen der Einladung auf das Panel gefolgt, um die verschiedenen Perspektiven der Akteursgruppen Forschung, Infrastruktur/Bibliothek, Rechtswissenschaft, zu vertreten. 

Mit kurzen Referaten von jeweils 5 Minuten und den jeweils anschließenden Gelegenheiten zur direkten Nachfragen und Kommentaren stellten die drei Panelist*innen ihre Sichtweisen vor. 

Sarah Oberbichler (C²DH, Luxemburg) näherte sich der Problematik aus der Perspektive der Forschungsdatenpraxis in den Digital Humanities und stellte dabei eine grundlegende begriffliche Unterscheidung in den Mittelpunkt: Was bedeutet „offen“ überhaupt? Und für wen? Offene Daten umfassen mindestens zwei Dimensionen, die in der Praxis nicht immer klar unterschieden werden: öffentliche Verfügbarkeit (technische Offenheit) im Sinne des freien Internetzugangs und rechtliche Offenheit durch Lizenzen, die Weiterverwendung für Forschung und Lehre erlauben, auch wenn Inhalte hinter einem Login liegen. Eine wesentliche Frage für Forschende lautet deshalb nicht: Sind die Daten zugänglich? Sondern: Sind sie auffindbar, nutzbar und nachnutzbar?

Am Beispiel des Internet Archive lässt sich zeigen, wie das massenhafte Scraping das offene Internet selbst verändert, und damit die Archivierung historisch bedeutsamer Quellen gefährdet. Da KI-Unternehmen das Internet Archiv als kostenlose Datenquelle nutzen, hatten im April 2026 241 Medienhäuser den Zugang für das Archiv blockiert, gleichzeitig schließen dieselben Häuser aber Lizenzdeals mit KI-Firmen ab (Muno 2026). Das Ergebnis ist eine strukturelle Verzerrung des digitalen Gedächtnisses: Qualitätsjournalismus verschwindet aus dem Archiv, während Blogs, Verschwörungsseiten und Content Farms übrig bleiben. Und da Medienhäuser nicht immer selbst archivieren und das Internet Archive blockiert wird, archiviert am Ende niemand.

In diesem Kontext gibt es keine klare Lösungen, jedoch mögliche Neuausrichtungen: (1) ethische KI-Implementierung statt Massenscraping; (2) öffentliche Dokumentation von Datensätzen statt unbegrenztem Datenzugang, etwa durch sogenannte Data Envelopes (Luthra & Eskevich, 2024), die Auffindbarkeit gewährleisten, ohne unkontrollierten Zugriff zu erzwingen; und (3) gemeinsame KI-Entwicklung, bei der Kultureinrichtungen, Forschende und KI-Entwickler:innen zusammenarbeiten und einen Paradigmenwechsel von Quantität zu Qualität vollziehen. 

David Maus nahm eine Einschätzung aus der Perspektive eines Infrastrukturanbieters vor. Aus der praktischen Arbeit an forschungsnaher Infrastruktur, den Bibliothekskatalogen und den daran angeschlossenen Informationssystemen, stellen sich die massenhaften Zugriffe auch als Angriff auf die Infrastruktur dar. Weil die Bots die etablierten Steuerungsmechanismen (Robots Exclusion Protocol, aka robots.txt) schlicht ignorieren und gnadenlos aus allen Richtungen die verfügbare Bandbreite verbrauchen, legen sie regelmäßig Teile der Infrastruktur lahm. Sei es, dass die Systeme unter der Last zusammenbrechen oder sei es, dass die Betreibenden ihre Dienste einstellen oder nur noch restriktiv zugänglich machen.

Als Konsequenz drückte er seine Erwartung einer stärkeren Zentralisierung und Homogenisierung der online verfügbaren Angebote aus. Der Schutz vor aggressiven Bots erfordert eine Infrastruktur, die Angebote von engagierten Einzelpersonen oder kleinen Facharbeitsgruppen nicht aufbringen können. Infrastrukturanbieter wiederum skalieren ihre Dienste darüber, dass sie Plattformen mit einer einheitlichen Grundstruktur anbieten. Angebote, die selbst keine Ressourcen für einen Bot-Schutz haben, verschwinden aus dem Netz oder müssen sich den Plattformen der Infrastrukturanbieter anpassen.

Grischka Petri führte aus, dass es aus rechtlicher Perspektive ernüchternd ist, nach Maßnahmen zu suchen, mit denen man gegen die Verursacher der Server-Sonderbelastung juristisch vorgehen könnte. Die Auswirkungen gleichen einem DoS-Angriff, dafür ist eigentlich das Computerstrafrecht zuständig. Allerdings ist es in den Bot-Downloads nicht vorgesehen, dass die besuchten Server in die Knie gehen sollen – im Gegenteil, man will sie ja nutzen. Der Ansatz scheitert also schon am Vorsatz. Das Urheberrecht bietet attraktive Kategorien an, um Nutzungen zu regeln – allerdings besteht das Problem ganz unabhängig vom urheberrechtlichen Status der Daten. Womöglich ist es für Anbieter gemeinfreier Inhalte sogar noch größer. Das Prinzip Lkw-Maut erscheint erfolgversprechender. Das ist eine Infrastrukturabgabe für eine Sondernutzung. Abseits einer staatlichen Regulierung hat die Wikimedia Foundation mit Wikimedia Enterprise einen solchen Weg eingeschlagen und bietet entsprechende Sondernutzungsverträge an.

Letztlich zeigt sich aber, dass mit rechtlichen Instrumenten keine Betriebssicherheit zu erlangen ist, weshalb am Ende die Empfehlung für technische Maßnahmen übrig bleibt. Initiativen wie die CC Signals, die sich selbst als “a technical and legal tool and a social proposition” beschreiben, sind vom guten Willen der beteiligten Akteure abhängig.

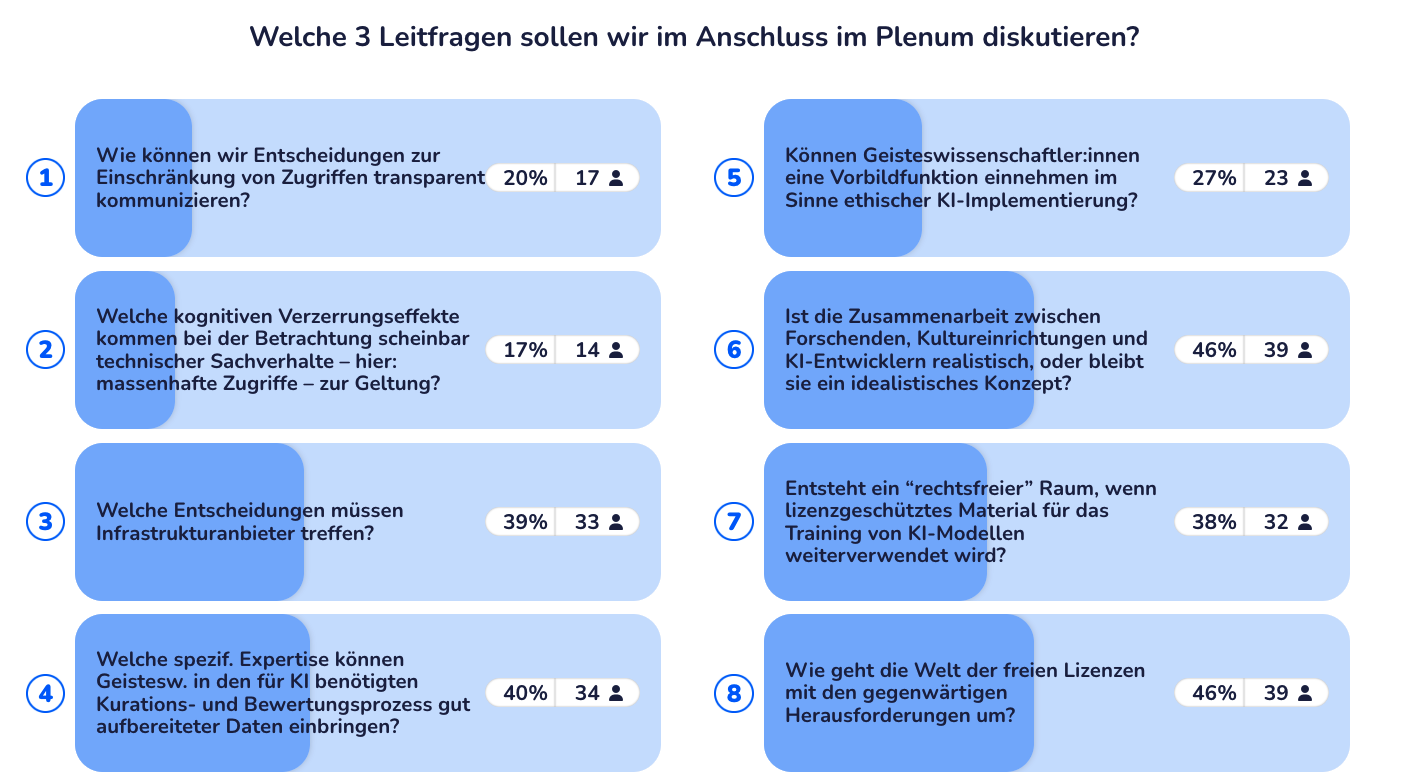
Nach dem Austausch auf dem Podium zwischen den Panelist*innen wurde die mit allen Teilnehmenden im Plenum von Cindarella Petz mit einer digitalen Intervention eingeleitet, in welcher die zu diskutierenden Fragen mithilfe von Wooclap zur Abstimmung gebracht wurden. 

Umfrageergebnisse mit Wooclap.

Mithilfe eines webbasierten Etherpads hatte das Publikum die Möglichkeit, anonym Fragen zu stellen und interessante Aspekte zu kommentieren. Im Pad wurden konkrete Standards und unterschiedliche Granularitäten von Nutzungslizenzen diskutiert, Ansätze zur Umleitung von Webcrawlern durch beispielsweise “LLMs.txt” oder “MCP” aufgeworfen, partizipatorische Elemente der Organisation von Wissenschaften, Forschung und GLAM-Institutionen angeregt und die ethische Nutzung von gecrawlten Datensätzen wie “Common Crawl” hinterfragt und welche rechtliche Rahmenbedingung geschaffen werden müssten, um eine Haftbarmachung von Massencrawlern und Stör-Bots zu erreichen.

Fazit und Ausblick

Die Diskussion zeigte deutlich, das wissenschaftsadäquate Lösungsszenarien für die komplexe Herausforderung durch die aktuellen KI-Entwicklungen nur mittels einer diversen Perspektive – unter Einbeziehung verschiedener Akteure und der Einbeziehung fachlicher, rechtlicher, technologischer und ethischer Aspekte herausgearbeitet werden können. Es wurde deutlich, dass es notwendig ist, dass die kritischen Stimmen lauter werden müssen. Letztendlich “befüttert” der KI-Einsatz in der Forschung in vielen Fällen (zumindest implizit) genau die gleichen Akteure, die für den im Panel kritisch betrachteten “ruchlosen” Umgang mit den digitalen Commons und Infrastrukturen insbesondere aus dem Kulturerbebereich (CHI) verantwortlich sind. 

Zusätzlich stellt sich die Frage, welche Expertise und Kompetenzen Digital Humanist(a)s in die Herausarbeitung von “Leitplanken” (Werten, Richtlinien, Forschungsethik) für den KI-Einsatz einbringen könnten bzw. sollten. In dieser neuen Phase des offenen Internets gibt es keine einfachen Lösungen. Alles “wegzuschließen” (d.h. technologische oder rechtliche Sperren) würde vor allem auch der Forschung selbst schaden. Was nützt es, wenn mensch alles finden kann, aber nicht mehr damit arbeiten kann. Wichtiger scheint es, den großen kommerziellen KI-Akteuren (Tech-Giganten) Einhalt zu gebieten bzw. ihr Handeln und die Nutzung ihrer Tools kritisch zu hinterfragen. Das Feedback im Saal bestärkte auf jeden Fall das große Potenzial von Digital Humanist(a)s und der LIS-Community (Library and Information Science) in der Politikberatung und der Herausarbeitung kritischer Punkte. Die Zeit ist reif, den Finger in die Wunde zu legen.

Quellen 

Berg-Weiß, Alexander. “Offen für manche Menschen oder doch für alle(s)? KI-Bots und ihre Auswirkungen auf den Betrieb von Repositorien.” BuB 77 Nr. 7(2025), S. 372-75. 

COAR, Navigating the Uneasy Interdependence of AI and Open Science, A COAR Statement, 3.3.2026

https://coar-repositories.org/news-updates/navigating-the-uneasy-interdependence-of-ai-and-open-science/ 

Fitzpatrick 2026, “Just FYI: this is part of the damage being done by extractive AI companies. Their scraper bots routinely DDOS us, and they multiply to take up as much bandwidth as is available. We are having to put a huge percentage of our developers’ time into just keeping the site alive rather than building its future. They are actively destroying everything worthwhile about the internet.” https://hcommons.social/@kfitz/115854657278743117, Mastodon, 7.1.2026, 17:02.  

Hao, Karen. 2026. Empire of AI: dreams and nightmares in Sam Altman’s OpenAI. New York: Penguin Books.

Heise (2025a), „Besorgniserregender Trend“: KI verursacht immer mehr Traffic, 21.08.2025 https://www.heise.de/news/Analyse-KI-Crawler-koennen-Server-ueberlasten-10560038.html (Achtung ohne Pur-Abo: Tracking)

Heise (2025b), Wikipedia: Bot-Traffic tarnt sich zunehmend als menschlich, 19.10.2025 https://www.heise.de/news/Wikipedia-Bot-Traffic-tarnt-sich-zunehmend-als-menschlich-10778492.html (Achtung ohne Pur-Abo: Tracking)

Luthra, Mrinalini und Maria Eskevich. „Data-Envelopes for Cultural Heritage: Going beyond Datasheets.“ Proceedings of the Workshop on Legal and Ethical Issues in Human Language Technologies @ LREC-COLING 2024, S. 52–65. Torino, Italia: ELRA and ICCL, 2024. https://aclanthology.org/2024.legal-1.9/  

Muno, Martin. „Internet-Archive: Unser digitales Gedächtnis ist bedroht.“ Deutsche Welle, 21. April 2026. https://p.dw.com/p/5CKXK

Shearer, Kathleen und Paul Walk. „The impact of AI bots and crawlers on open repositories: Results of a COAR survey.” April 2025, aufgerufen am 30.07.2025, https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf.

Wuttke, U., Maus, D., Rack, F., Rettinghaus, K., Oberbichler, S., & Petz, C. (2026, Februar 20). KI als Belastungsprobe für das offene Internet?. DHd 2026 Nicht nur Text, nicht nur Daten (DHd2026) (DHd2026), Wien, Österreich. https://doi.org/10.5281/zenodo.18696199

Text+: Forschungsdateninfrastruktur für text- und sprachbasierte Forschung wird weiter ausgebaut

2026年7月14日 17:50

Die Gemeinsame Wissenschaftskonferenz (GWK) hat am 10. Juli 2026 die Förderung der Forschungsdateninfrastruktur „Text+“ für zwei weitere Jahre mit insgesamt rund sechs Millionen Euro beschlossen. Neue mitantragstellende Einrichtung ist die Niedersächsische Staats- und Universitätsbibliothek Göttingen (SUB Göttingen). Sie übernimmt damit für die Universität Göttingen die Verantwortung für die finanzielle, organisatorische und strategische Weiterentwicklung des Vorhabens.


In der zweiten Förderphase von Text+ soll die in den vergangenen Jahren aufgebaute Forschungsdateninfrastruktur für text- und sprachbasierte Forschungsdaten weiterentwickelt, verstetigt und noch stärker in die wissenschaftliche Praxis integriert werden.


„Die Weiterförderung von Text+ ist ein starkes Signal für die Forschungsdateninfrastrukturen in Deutschland und für den Forschungsstandort Göttingen. Text- und sprachbezogene Daten sind ein wesentlicher Bestandteil unseres kulturellen Gedächtnisses und zugleich eine zentrale Grundlage für die Qualität von Sprachmodellen und Künstlicher Intelligenz. Zusammen mit den drei anderen NFDI-Konsortien der ‘Humanities@NFDI’-Gruppe können wir in der zweiten Förderphase die gemeinsam aufgebauten Strukturen festigen, unsere Angebote nachhaltig verankern und die Idee einer gemeinsamen ‘One NFDI’ vorantreiben“, erläutert der Sprecher für Text+, Prof. Dr. Philipp Wieder von der Universität Göttingen.


Der Fokus der zweiten Förderphase, beginnend ab Oktober 2026, liegt auf dem Betrieb einer stabilen und leistungsfähigen Infrastruktur, der Konsolidierung und Weiterentwicklung zentraler Dienste für das Forschungsdatenmanagement sowie der langfristigen Sicherung und Bereitstellung von Daten. Zugleich wird Text+ seine Angebote noch enger am Bedarf der wissenschaftlichen Communitys ausrichten und die Zusammenarbeit mit Partnern innerhalb und außerhalb der NFDI weiter vertiefen. Die FAIR-Data-Prinzipien zur Förderung einer offenen Nachnutzbarkeit von Forschungsdaten sind dabei zentral für das Angebot.


Die Nationale Forschungsdateninfrastruktur, mit der Bund und Länder seit 2019 den Aufbau verlässlicher Strukturen für den Umgang mit Forschungsdaten fördern, hat zum Ziel, Forschungsdaten aus allen Wissenschaftsbereichen langfristig zugänglich, interoperabel und nachnutzbar zu machen. Die Konsortien decken vielfältige Wissenschaftsdisziplinen ab: von Kultur- über Sozial-, Geistes- und Ingenieurwissenschaften bis hin zu Lebens- und Naturwissenschaften. Dazu arbeiten Fachcommunitys gemeinsam mit Universitäten, Bibliotheken, Rechenzentren, Archiven und weiteren Infrastruktureinrichtungen an Standards, Diensten und Beratungsangeboten für ein nachhaltiges Forschungsdatenmanagement.


Die Entscheidung zur Weiterförderung fällt in eine Phase, in der auch die NFDI insgesamt strategisch weiterentwickelt wird. Bund und Länder haben im Juli 2026 die Grundlage für eine langfristige Fortführung der NFDI über das Jahr 2028 hinaus beschlossen. Ziel ist eine stärker koordinierte, nachhaltige und leistungsfähige Forschungsdateninfrastruktur in Deutschland. Text+ wird dazu weiterhin einen wichtigen Beitrag für die geistes- und kulturwissenschaftliche Forschung leisten.

Einladung zum Clustertreffen des N4O CC Authority Files – Die AG Archäologiethesaurus: Ein Normvokabular für die Archäologie, 12.8.2026, 13:00 Uhr

2026年7月14日 16:12

Hiermit laden wir Euch sehr herzlich zum Clustertreffen am 12. August 2026, 13:00 Uhr, mit dem Thema „Die AG Archäologiethesaurus: Ein Normvokabular für die Archäologie“ mit Victoria Biesterfeld vom LVR-Landesmuseum Bonn ein.

Für die digitale Erfassung archäologischer Bestände sind kontrollierte Vokabulare unerlässlich. Nur Objekte mit einheitlichen Bezeichnungen sind langfristig auffindbar und entsprechen den FAIR-Prinzipien guten Forschungsdatenmanagements. Während in kunst- und kulturhistorischen Disziplinen bereits seit langem anerkannte und standardisierte Thesauri existieren, fehlt in der Archäologie ein vergleichbares Vokabular bislang weitgehend.

Die AG Archäologiethesaurus – eine unabhängige Arbeitsgruppe ohne institutionelle Anbindung, hervorgegangen aus einer Initiative des Archäologischen Museums Hamburg im Jahr 2008 – hat sich zum Ziel gesetzt, ein einheitliches, überregional nutzbares Vokabular archäologischer Objektbezeichnungen zu entwickeln. Dieses soll die Ansprache und Inventarisierung von  umfangreichen Beständen in Landesmuseen und Landesämtern, aber auch von kleineren regionalen Sammlungen erleichtern.

Als Zwischenschritte auf dem Weg zum digitalen Thesaurus erscheinen seit 2012 die „Bestimmungsbücher Archäologie“, in denen sukzessive einzelne Objektgruppen (wie z.B. Fibeln, Gürtel, Pfeil- und Lanzenspitzen) aufgearbeitet werden. Diese haben sich sowohl in der praktischen Sammlungsarbeit als auch bei Grabungsfirmen schnell als nützliche Standardwerke etabliert.

Aktueller Fokus der Arbeitsgruppe ist die digitale Umsetzung des sog. Archäologischen Objektbezeichnungsthesaurus (AOT) in ein interoperables Format, das institutions- und softwareunabhängig nutzbar ist. Geplant ist, das Vokabular in xTree bereitzustellen und dort auch danach weiterhin redaktionell zu betreuen, um seine technische Implementierung in unterschiedliche Sammlungsdatenbanken zu ermöglichen und deren Nutzenden stets ein aktuelles Vokabular anbieten zu können. Parallel dazu werden weitere Objektgruppen nach und nach erschlossen und sowohl in Print veröffentlicht als auch digital integriert; selbstverständlich sind auch Mappings zu anderen Thesauri vorgesehen.

Der Vortrag stellt die AG, ihre Entstehung, Arbeitsweise und Ziele vor und diskutiert, wo sich Anknüpfungspunkte zur Community von NFDI4Objects ergeben –  insbesondere im Hinblick auf technische Lösungen, Interoperabilität und mögliche Kooperationen bei der weiteren Entwicklung des digitalen Archäologiethesaurus.

Hier sind die Zoom-Zugangsdaten:

https://dainst-org.zoom.us/j/94508989488?pwd=zVXisbncIEgOOwEle1NQuG7hA2YNbp.1

Meeting-ID: 945 0898 9488
Kenncode: 357332

Eine Anmeldung ist nicht erforderlich, wir freuen uns auf Eure Teilnahme.


Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy

2026年5月11日 21:38

Autor:innen:


Für Originalbeitrag, siehe https://hdl.hypotheses.org/5097

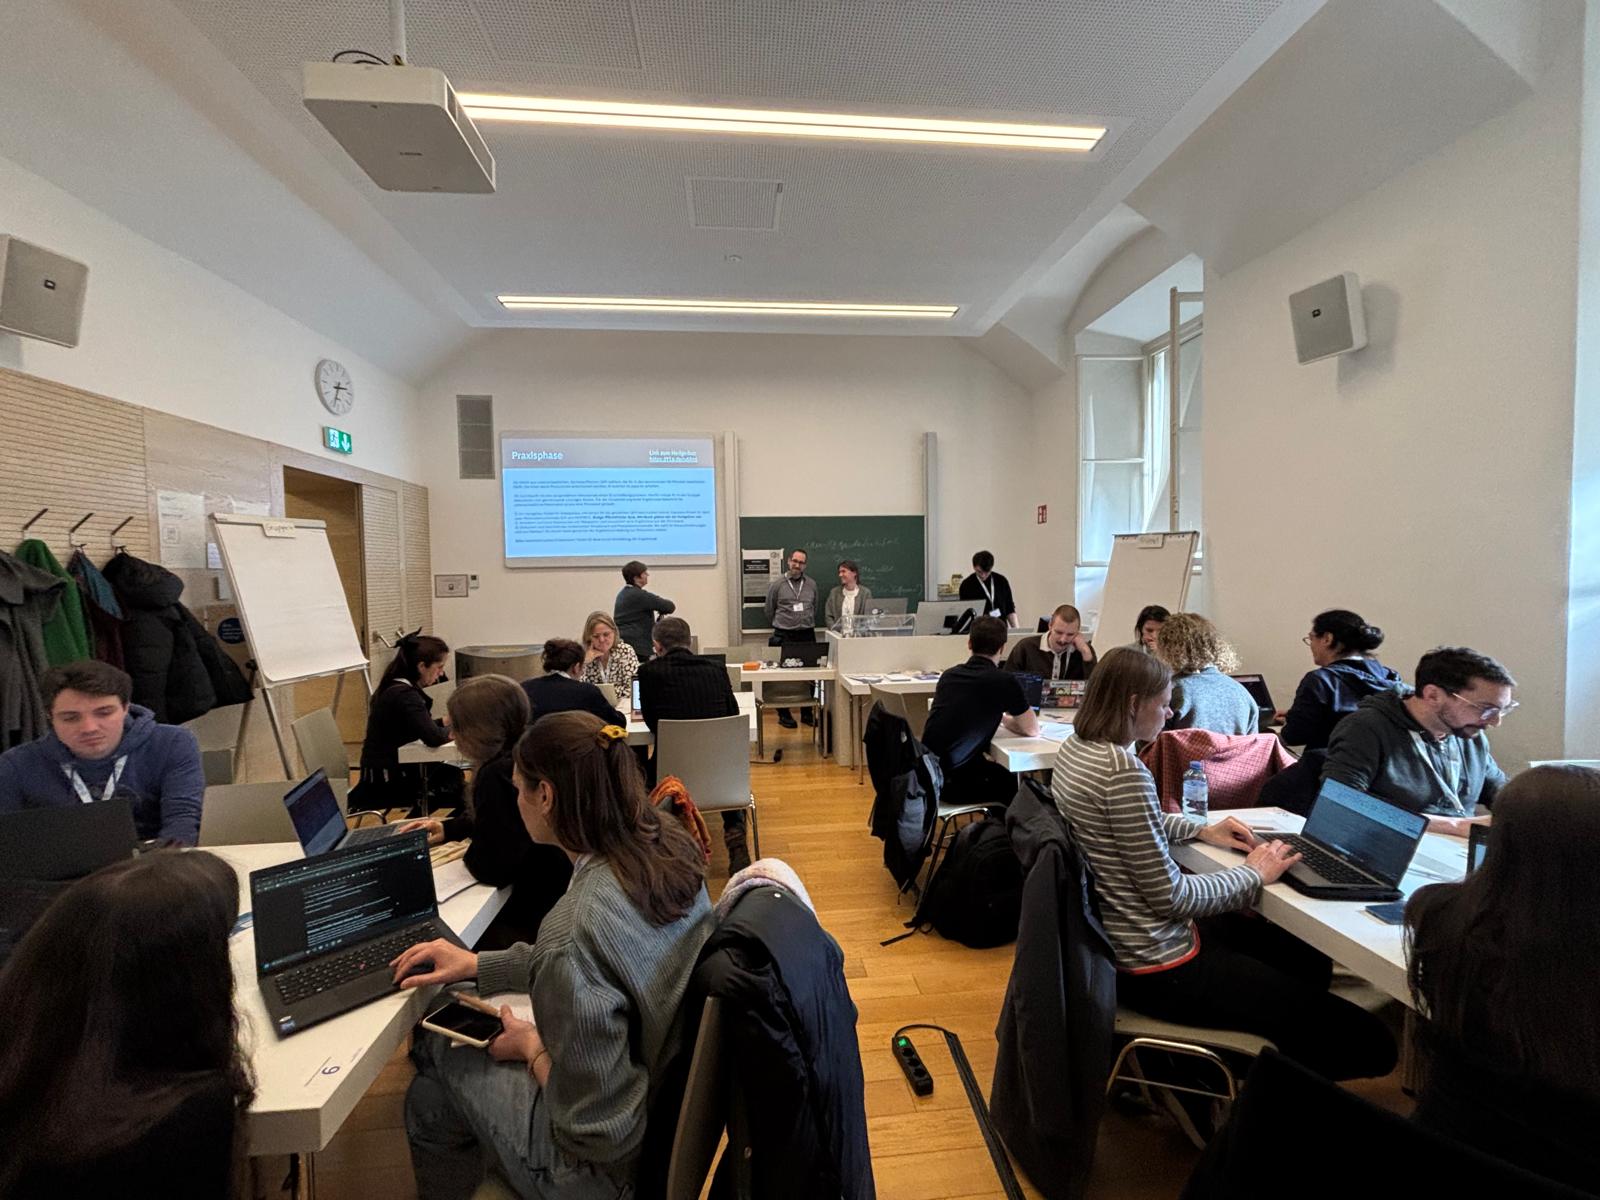
Abb. 1: Gruppenarbeitsphase: Beschreibung disziplinspezifischer OER (Quelle: NFDI4Memory)

Digitale Werkzeuge und die Arbeit mit Forschungsdaten verändern den wissenschaftlichen Alltag – und erfordern die Entwicklung neuer Kompetenzen. Eine besondere Stellung nehmen dabei Data Literacy (Schüller, Busch und Hindinger, 2019) und Forschungsdatenmanagement (FDM) ein, die über OER (Open Educational Resources) vermittelt werden können (Deimann et al., 2015). Doch OER zu FDM sind bisher über verschiedene Plattformen verstreut und damit schwer auffindbar. Plattformen wie DALIA (Ortmeyer et al., 2024) oder Sammlungen wie NFDI4Memory HISTOCAT und HERMES Resourcebase versuchen, hier Abhilfe durch Registraturen und kuratierte Sammlungen zu schaffen. Ein zentraler Schlüssel für die Auffindbarkeit und Nachnutzbarkeit der OER sind dabei allerdings gute Metadaten – doch bestehende Schemata (z. B. das Schema des Datenkompetenzzentrums HERMES (Urbaum et al., 2026) oder das DALIA Interchange Format (Geiger et al., 2026)) unterscheiden sich hinsichtlich fachspezifischer Angaben wie Disziplinen oder Methoden. Hier fehlen in vielen Fällen standardisierte Vokabulare zu einer Beschreibung von OER, um Such-Find-Prozesse effizienter werden zu lassen.

Vor diesem thematischen Hintergrund organisierten die Projekte HERMES, NFDI4Memory, DALIA und NFDI4Culture auf der 12. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum e.V. (DHd2026), die vom 23. bis 27. Februar 2026 an der Universität Wien stattfand, einen Workshop. Die Konferenz in Wien stand unter dem Motto „Nicht nur Text, nicht nur Daten“ und erweiterte damit ihren Fokus von den traditionellen text-basierten Analysen zu einer umfassenden, objekt-übergreifenden Perspektive. Neben Textkorpora standen nun auch Personen, Orte, materielle Kultur, Bild- und Klangobjekte, Klimadaten, genetische sowie neurophysiologische Messungen im Fokus.

Abb. 2: Organisationsteam Workshop Kontext und Klarheit (Quelle: Jonathan D. Geiger)

Insbesondere das technische Interesse der Konferenz-Teilnehmenden und die Breite des geisteswissenschaftlichen Disziplinen-Panoramas machten die DHd zu einer geeigneten Konferenz für den Workshop “Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy”. Unser Ziel war es, Metadatenschemata und disziplinspezifische Metadaten von OER unter die Lupe zu nehmen und so eine Grundlage für die Verbesserung der Schemata zu entwickeln. Der halbtägige Workshop konzentrierte sich daher auf die Untersuchung und Strukturierung von OER-Metadaten – insbesondere den Einsatz fachspezifischer, kontrollierter Vokabulare, Picklists und Metadatenschemata für geisteswissenschaftliche Lehr- und Lernmaterialien. Nach einer kurzen Vorstellung der Referent*innen und ihrer Projekte folgte ein Ice-Breaker, der die Unschärfe von Klassifikationen thematisierte. Die daran anschließende kompakte Einführung vermittelte einen Überblick über unseren Untersuchungsbereich wie OER-Metadatenstandards, Metadatenschemata, Vokabularien und deren disziplinäre Herausforderungen und Potenziale. In der Gruppenphase wurde die Think-Pair-Share-Methode nach Bönsch (2002) eingesetzt. Im Hauptteil durchliefen die Teilnehmenden in Kleingruppen einen klassischen Erschließungsprozess. Anhand ausgewählter OER aus verschiedenen geisteswissenschaftlichen Disziplinen untersuchten die Teilnehmenden, inwiefern die beiden OER-Metadatenschemata von HERMES und DALIA für die Ressourcen geeignet waren und inwiefern disziplinen-spezifische Angaben zu den Werten der einzelnen Attributen gemacht werden können. Das Moderationsteam unterstützte dabei. Abschließend wurden die Ergebnisse im Plenum präsentiert, Bedarfe diskutiert und nächste Schritte für die Weiterentwicklung von Picklists skizziert. Eine Reflexionsrunde fasste zentrale Erkenntnisse zusammen und eröffnete Anknüpfungspunkte.

Abb. 3: Beschreibung von OER anhand ausgewählter Metadatenschemata (Quelle: NFDI4Memory)

Unter den Eindrücken der Kleingruppen gab es interessante Überschneidungen: Demnach waren Autor*innen- und Lizenzinformationen der Ressourcen häufig unklar oder fehlten ganz; Zielgruppen und Kompetenzstufen wurden uneinheitlich beschrieben oder nicht klar voneinander abgegrenzt. Beide Metadatenschemata wiesen Redundanzen bzw. zu viele Pflichtfelder auf, und Metadatenfelder wie Titel, Untertitel oder Versionsangaben konnten nicht konsistent angegeben werden. Die Teilnehmenden merkten zudem an, dass die  Anpassbarkeit an fachspezifische Begriffe derzeit noch begrenzt ist.

Aus diesen  Überschneidungen  ergaben sich gemeinsame Empfehlungen: Vorgeschlagen wurde ein modularer Kern-/Erweiterungs-Ansatz, bei dem grundlegende Metadaten obligatorisch und fachspezifische Felder optional über kontrollierte Vokabulare (Picklists) ergänzt werden können. Darüber hinaus wurde angeregt,  Lizenz- und Autor*innen-Angaben für OER klar auszuweisen; die  Disziplinen-Taxonomie um digitale Geisteswissenschaften bzw. Digital Humanities zu erweitern sowie Metametadaten (Version, Datum, Provenienz, Autor*innen etc.) systematisch zu integrieren. Für komplexere Fälle wurde außerdem die Möglichkeit freier Ergänzungen als sinnvoll erachtet. Einheitliche Definitionen für OER, klare Rollenbezeichnungen und ein abgestuftes Kompetenzmodell wurden ebenfalls als  wünschenswert erachtet. In der Gruppendiskussion wurde insbesondere die Bedeutung  von Metametadaten für Versionierung und Nachvollziehbarkeit von Entwicklungen betont.

Die Organisator*innen danken allen Teilnehmenden herzlich für die rege und produktive Teilnahme und der DHd für die Ausrichtung der Konferenz in Wien. Auch uns hat der Workshop viele Impulse erbracht, die in die weitere Entwicklung der Arbeit an den Metadaten und Plattformen einfließen werden. Die inhaltliche Arbeit an OER und -Metadaten soll im Rahmen einer DHd-Arbeitsgruppe Data Literacy weitergeführt werden – Interessierte sind sehr herzlich zur Mitarbeit eingeladen und können sich in die Mailingliste eintragen und/oder unserem RocketChat-Channel (OER.Net) beitreten.

Referenzen

Bönsch, Manfred. 2002. Unterrichtsmethoden – kreativ und vielfältig. Schneider-Verlag Hohengehren.

Deimann, Markus, Jan Neumann und Jöran Muuß-Merholz. 2015. Whitepaper Open Educational Resources (OER) an Hochschulen in Deutschland – Bestandsaufnahme und Potenziale 2015. Transferstelle für OER. Hamburg. https://open-educational-resources.de/wp-content/uploads/Whitepaper-OER-Hochschule-2015.pdf (zugegriffen: 26.03.2026).

Geiger, Jonathan, Petra Steiner, Abdelmoneim Amer Desouki, Henrika Maria Hüppe und Frank Lange. 2026. DALIA Interchange Format (1.4). DOI: 10.5281/zenodo.17871138

Ortmeyer, Jochen, Jan-Michael Haugwitz, Petra Steiner, Thomas Stäcker, Torsten Schrade, Ulrich Sax, Gábor Kismihók, Matthias Müller, Peter F. Pelz und Sonja Herres-Pawlis. 2024. A Platform for the Provision of Teaching and Training Contents in Data Literacy: DALIA4NFDI. BASE4NFDI User Conference. Berlin, 20-21 November 2024. DOI: 10.5281/zenodo.14183168

Schüller, Katharina, Paulina Busch und Carina Hindinger. 2019. Future Skills: Ein Framework für Data Literacy. Hochschulforum Digitalisierung, 47. DOI: 10.5281/zenodo.3349865

Urbaum, Dorothee und Grigori Chlesberg. 2026. Metadatenschema und Picklisten für Open Educational Resources des Datenkompetenzzentrums HERMES – Humanities Education in Research, Data, and Methods (v1-1). DOI: 10.5281/zenodo.18679758

Urbaum, Dorothee, Laura Döring, Grigori Chlesberg, Jonathan D. Geiger und Petra Steiner. 2026. Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy. In: Silke Schwandt, Gabriel Viehhauser, Tara Andrews und Thomas Wallnig (Hg). 2026. Book of Abstracts – DHd 2026: Nicht nur Text, nicht nur Daten. 12. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum e.V. DHd2026, Universität Wien, 23.–27. Februar 2026. Wien. DOI: 10.5281/zenodo.18702757

Praxislabor 2026: Recogito – gemeinsames semantisches Annotieren im Browser (Do. 21.05.26, 13:30 – 15:00 Uhr)

2026年5月11日 15:17

Recogito ist eine Webumgebung, mit der man in Texten und Bildern Orte, Personen und Ereignisse einfach semantisch auszeichnen kann. Die Dokumente können gemeinsam bearbeitet und Orte bereits während der Annotation auf Karten angezeigt werden. Die Annotationen können in einer Vielzahl von Formaten exportiert werden, um dann weitere Schritte in GIS, Gephi oder in digitalen Editionen vorzunehmen. Der Einstieg ist niedrigschwellig und jede:r kann sofort starten. Recogito wurde 2018 mit dem DH Award ausgezeichnet und seitdem umfangreich weiterentwickelt.

Information und Zoomlink: https://digigw.hypotheses.org/7494

Praxislabor 2026: Wikibase verstehen und praktisch nutzen? (online, 7.5.26, 20 Uhr)

2026年5月5日 21:01

Im Rahmen des Praxislabors 2026 zeigt dir Olaf Simons, wie du mit Wikibase eigene Datenprojekte umsetzen und dich mit bestehenden Wissensnetzwerken wie Wikidata oder FactGrid verbinden kannst.
Keine alternative Textbeschreibung für dieses Bild vorhandenDer Workshop richtet sich an alle, die erste Schritte mit strukturierten Daten und Knowledge Graphen machen wollen.

📅 07.05.2026
🕗 20:00 – 21:30 Uhr
👉 Alle Infos & Details im Blog:
https://digigw.hypotheses.org/7420


Forschungsdaten im Zentrum: Ewig währt am längsten

2026年4月15日 21:38

Ein partizipativer Workshop der Initiative „Datenzentrum – wissenschaftliche Konzeption und Ausgestaltung“ der Berlin-Brandenburgischen Akademie der Wissenschaften (BBAW)

Berlin, 25. und 26. Juni 2026; Akademiegebäude am Gendarmenmarkt; Einstein-Saal


Der Wert geisteswissenschaftlicher Forschungsdaten für Wissenschaft und Gesellschaft ist nicht zuletzt durch den laufenden Aufbau der Nationalen Forschungsdateninfrastruktur (NFDI) offensichtlich geworden. Zentrale Fragen nach dem dauerhaften Betrieb vertrauenswürdiger Datenrepositorien und der langfristigen Verfügbarkeit der aggregierten Inhalte sind jedoch weiterhin offen.

Vor diesem Hintergrund lädt die Initiative „Datenzentrum – wissenschaftliche Konzeption und Ausgestaltung“ der BBAW zu einem zweitägigen Lunch-to-Lunch-Workshop ein. Diese 2025 eingerichtete Initiative erarbeitet ein Konzept für die organisatorischen und technischen Grundlagen für ein leistungsfähiges, zertifiziertes Repositorium und dessen infrastrukturelle Einbindung innerhalb der BBAW. Darauf aufbauend wird die Akademie ab 2028 ein eigenes Datenzentrum betreiben. Dessen Hauptaufgaben werden die Aggregation, Verfügbarhaltung und Archivierung von Forschungsdaten, Software und Diensten aus den Vorhaben und Projekten der Akademie sein. Darüber hinaus ist eine Öffnung des Repositoriums für externe Datengeber:innen vorgesehen.

Im Workshop werden anhand von Impulsvorträgen die unterschiedlichen Perspektiven aus Sicht von Forschung, Bibliothek, Archiv und IT reflektiert. Anschließend bieten verschiedene Thementische die Möglichkeit zu einer intensiven Auseinandersetzung mit spezifischen Fragen, von der technischen Einrichtung nachhaltiger Infrastrukturen zwischen quelloffenen und kommerziellen Lösungen bis hin zum Einsatz sog. Künstlicher Intelligenz samt deren ethischen Herausforderungen.


Um Anmeldung wird gebeten unter: www.bbaw.de/veranstaltungen/veranstaltung-workshop-datenzentrum-2026

Nähere Informationen zum Programm: https://datenzentrum.bbaw.de/veranstaltungen/workshop-2026. Die Seite befindet sich im Aufbau und wird fortlaufend aktualisiert.

Save the Date: 12. Juni 2026 – 4. Community Meeting von NFDI4Objects

2026年4月9日 14:31

Das vierte Community Meeting 2026 von NFDI4Objects findet virtuell statt! Die Veranstaltung richtet sich an Einsteiger:innen und Interessierte und bietet spannende Einblicke in die Arbeit des Konsortiums. Freut euch auf interaktive Formate, Austauschmöglichkeiten und dezentrale Online-Workshops.

Programm und Workshop-Termine folgen in Kürze – merken Sie sich den Termin schon jetzt vor!

Gemeinsame Sprechstunde zum Forschungsdatenmanagement der Humanities-Konsortien

2026年3月13日 22:52

Ab März 2026 findet eine gemeinsame Sprechstunde zum Forschungsdatenmanagement der vier Humanities@NFDI-Konsortien (NFDI4Memory, NFDI4Culture, NFDI4Objects und Text+) statt.

Sie richtet sich an Studierende, Forschende sowie Mitarbeitende aus Forschungs- und Sammlungsinstitutionen und bietet Raum für Fragen rund um das Forschungsdatenmanagement.

Am 17.03.2026 von 9:00–10:00 Uhr findet die erste Online-Sprechstunde statt. Die Teilnahme ist auch ohne Anmeldung über Zoom möglich.

Einmal im Monat stehen künftg Expert:innen aus den beteiligten NFDI-Konsortien für Fragen bereit. Bei Bedarf können Themen auch in Breakout-Räumen im Einzelgespräch vertieft werden. Eine Terminübersicht für 2026 findet sich auf der Humanities@NFDI-Unterseite.

Bei dringenden Fragen können Sie sich jederzeit auch an die Helpdesks wenden:

Am 2. Juli 2026: SSHOMP-Editathon von GKFI und Text+ in Bonn – mitmachen, lernen, vernetzen

2026年3月10日 23:40

Am 2. Juli 2026 laden der Verein Geistes- und Kulturwissenschaftliche Forschungsinfrastrukturen (GKFI e.V.) und das NFDI-Konsortium Text+ gemeinsam mit dem SSH Open Marketplace zu einem Editathon in die Geschäftsstelle der Max Weber Stiftung in Bonn ein.

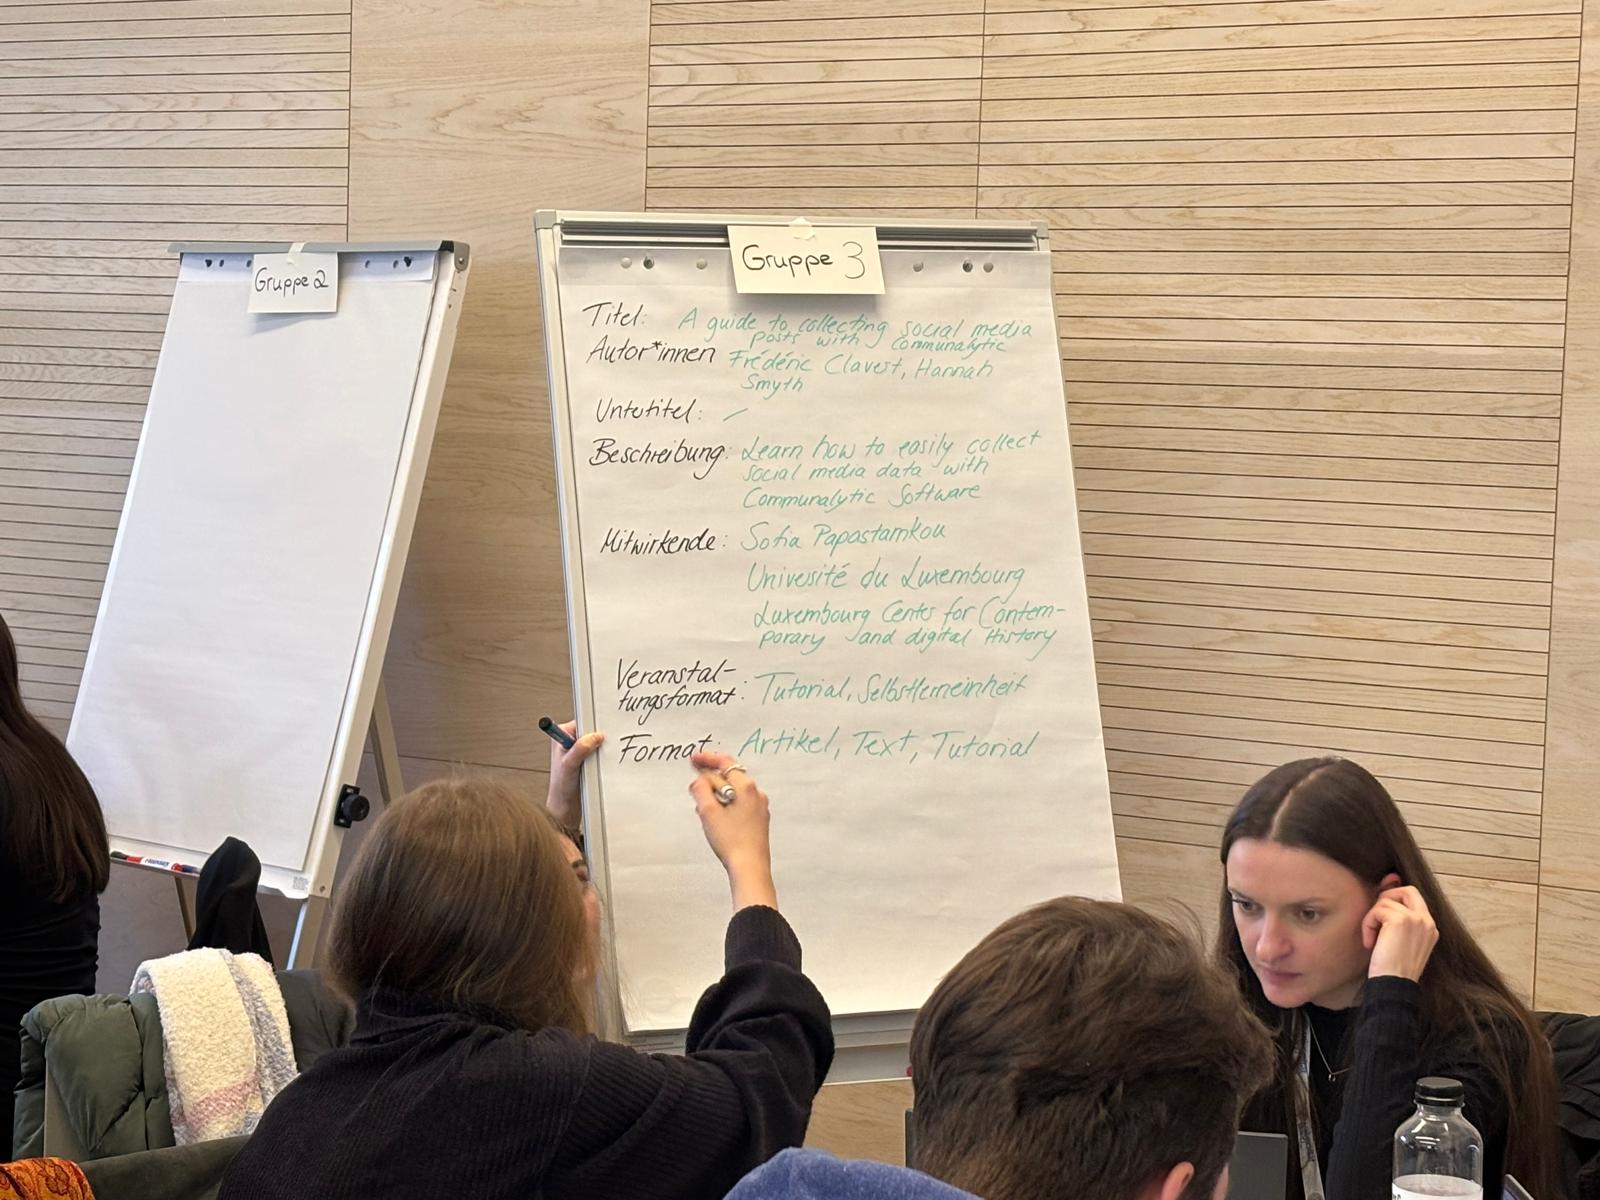
Die Idee: Wissenschaftliche Ressourcen aus den Geistes- und Sozialwissenschaften – von Werkzeugen und Diensten über Trainingsmaterialien bis hin zu Workflows und Datensätzen – im SSH Open Marketplace sichtbar, gut beschrieben und leichter auffindbar machen. Dabei können neue Einträge angelegt und bestehende ergänzt oder überarbeitet werden. Das Ziel: Mehr Sichtbarkeit und Nutzbarkeit für digitale Angebote in unserer Community.

Das Ganze läuft in entspannter Atmosphäre:

  • keine Teilnahmegebühr
  • Snacks und Getränke warten auf die Teilnehmenden
  • wer mag, trifft sich schon am Vorabend in einem örtlichen Restaurant (Selbstzahlerbasis)
  • Arbeitsmaterial wird vorbereitet, Vorkenntnisse sind nicht nötig – nur ein Smartphone, Tablet oder Notebook sollte mitgebracht werden
  • maximal 20 Plätze vor Ort – schnell anmelden!

Eingeladen sind nicht nur Mitglieder von GKFI und Text+, sondern auch Kolleginnen und Kollegen aus anderen Projekten, die den SSH Open Marketplace nutzen möchten. Disziplinär ist alles willkommen, solange es einen Bezug zu Geistes- oder Sozialwissenschaften hat.

Der Ablauf:
Ein kurzer Impuls zum SSH Open Marketplace mit Beispielen aus GKFI, Text+ und weiteren Kontexten – anschließend Gruppenarbeit, in der Ressourcen gemeinsam eingepflegt und Workflows erprobt werden. Schließlich kann jede*r die eigenen Services, Daten oder Materialien direkt ins internationale Portal bringen, wo sie dank API-Anbindung auch von anderen Plattformen geharvestet werden können.

Anmeldung und Infos:

Anmeldung: https://events.gwdg.de/event/1386/ 

Bitte vorab prüfen, ob der Login mit vorhandenen Credentials (es wird kein eigener Account benötigt) schon möglich ist: https://marketplace.sshopencloud.eu/
Fragen oder Probleme? Einfach eine Mail an: textplus-operations-office@lists.gwdg.de

Wir freuen uns auf einen produktiven, lockeren Tag mit vielen neuen Einträgen und spannenden Gesprächen – jetzt anmelden und einen Platz sichern!

Relaunch von forschungsinfrastrukturen.de: GKFI und Angebotskatalog im neuen Design

2026年2月25日 17:09
Der Relaunch von forschungsinfrastrukturen.de ist abgeschlossen!
Die Website des GKFI – Verein Geistes- und kulturwissenschaftliche Forschungsinfrastrukturen – präsentiert sich ab sofort in einem neuen, klaren und konsistenten Design. Inhalte und Struktur wurden grundlegend überarbeitet, sodass Informationen zu Zielen, Gremien und Services des Vereins nun noch schneller und einfacher zu finden sind. Damit unterstützt die Website das zentrale Anliegen des GKFI: Forschungsinfrastrukturen in den Geistes- und Kulturwissenschaften in Deutschland und im europäischen Kontext zu stärken, zu koordinieren und sichtbarer zu machen.
Wir freuen uns über Feedback zum neuen Auftritt – schreiben Sie uns gerne unter kontakt@forschungsinfrastrukturen.de.
 
Logo GKFI
 
Auch der GKFI-Angebotskatalog hat ein neues Gesicht bekommen. Er bietet einen strukturierten Überblick über die Services, die von den Mitgliedseinrichtungen im Bereich der Forschungsinfrastrukturen bereitgestellt werden. Die Angebote sind nach Fachbereichen geordnet, enthalten kurze Beschreibungen und verweisen direkt auf die Website des jeweiligen Services.
Alle aufgeführten Dienste sind etablierte Forschungsinfrastruktur-Angebote, die Forschung durch Beratung, Bereitstellung, Weiterentwicklung und Vermittlung von Werkzeugen, Daten und Expertise unterstützen. Sie folgen den Prinzipien von Open Science, erfüllen gemeinsame Qualitätsstandards im GKFI-Netzwerk und werden von den verantwortlichen Einrichtungen betrieben.
Technisch ist der Katalog nun direkt mit dem SSH Open Marketplace verbunden: Per API-Call werden die dort vom GKFI-Koordinierungsrat geprüften und eingetragenen Services automatisch auf die GKFI-Website übertragen. So bleibt der Überblick aktuell und zuverlässig – und Forschende finden noch leichter passende Infrastrukturangebote für ihre Arbeit.
 
Der Verein Geistes- und kulturwissenschaftliche Forschungsinfrastrukturen e.V. engagiert sich für die Weiterentwicklung und Vernetzung geistes- und kulturwissenschaftlicher Forschungsinfrastrukturen in Deutschland und Europa. Er koordiniert nationale Knoten zu europäischen Infrastrukturen, arbeitet mit wissenschaftspolitischen Akteuren, Fachgesellschaften und Interessensgruppen zusammen und fokussiert auf digitale Forschungsinfrastrukturen, Forschungsdaten, virtuelle Forschungsumgebungen sowie digitale Forschungsprozesse mit besonderem Blick auf die Perspektiven der Nutzenden in Forschung und Lehre.
Die Motivation: Gestaltung der digitalen Transformation in den Geistes- und Kulturwissenschaften, Bündelung vorhandener Angebote, Begleitung aktueller Entwicklungen und digitaler kultureller Praktiken.
Mitmachen können institutionelle wie individuelle Mitglieder – durch die Förderung der Vereinsangebote, Mitarbeit in Gremien, Mitgestaltung künftiger Entwicklungen und Teilnahme an Veranstaltungen, Tagungen und Workshops.

Bericht vom NFDI4Culture Community Plenary 2025: „Gemeinsame Daten – Gemeinsame Praxis – Gemeinsames Wissen“ und die Stimmen der Community

2026年2月18日 19:23

NFDI4Culture, das Konsortium zur Förderung des Forschungsdatenmanagements für materielle und immaterielle Kulturgüter innerhalb der Nationalen Forschungsdateninfrastruktur (NFDI), zelebrierte vom 24. bis 26. September 2025 an der Akademie der Wissenschaften und der Literatur | Mainz bereits zum 5. Mal seine größte jährliche Zusammenkunft, das NFDI4Culture Community Plenary. Diskutiert wurde insbesondere das Fokusthema „Datensouveränität, infrastrukturelle Resilienz und Wissenschaftsfreiheit“, aber auch der aktuelle Stand, Ergebnisse des Arbeitsprogramms und die Strategie des Konsortiums für die Zukunft. 
Über die Details der drei Konferenz-Tage gibt dieser chronologisch-thematisch gegliederte Bericht ausführlich Auskunft, der gerne auch selektiv gelesen werden kann und zur Veranschaulichung viele authentische Stimmen von Plenary-Teilnehmenden aus der NFDI4Culture-Community wiedergibt. Eine englische Version des Berichts findet sich in Kürze auf dem NFDI4Culture Portal.

Gruppenfoto von NFDI4Culture und der Community, auf dem alle jubeln
NFDI4Culture und die Community – Autor:in: Alexander Stark

Vor allem begegneten sich die rund 100 Teilnehmenden vor Ort – Vertreter:innen der Mitgliedsinstitutionen, die Mitarbeitenden des Konsortiums sowie Besucher:innen aus der (inter-)nationalen Forschung und digitalen Infrastruktur – endlich (wieder) einmal persönlich. Bei einem großen und in weiten Teilen digital durchgeführten Projekt wie NFDI4Culture stärkte das Zusammentreffen spürbar das Netzwerk der fachlich sehr vielfältigen Community sowie die geteilte Motivation und Leidenschaft für Forschungsdatenmanagement im Bereich Kulturdaten. Auch europäische Besucher:innen und Interessierte reisten zum Community Plenary, um bei NFDI4Culture mitzuwirken und sich auszutauschen, wie beispielsweise Rafael Uriarte, Ph.D., vom Kunsthistorischen Institut in Florenz, der in einem kurzen Interview seine Beweggründe schilderte:

„I came here to see what kind of contribution we can make and how to convince people to open their data, especially in art history.“

Wer nicht persönlich nach Mainz kommen konnte, hatte Gelegenheit, virtuell an den wesentlichen Programmpunkten teilzunehmen.

Konferenz-Tag 1: Workshop-Wednesday, Helpdesk-Speed-Dating und DigAMus Award


Workshops zum Forschungsdatenmanagement und Helpdesk-Speed-Dating

Zu den besonderen Programm-Highlights zählte zunächst das attraktive Workshopangebot: In entspannter und kollegialer Atmosphäre konnten die Teilnehmenden neue Skills, Tools und Techniken entdecken und die eigenen praktischen Fähigkeiten erweitern – von Pythonprogrammierung über Knowledge Graphs bis hin zur Nachhaltigkeit im Forschungsdatenmanagement. Besonderer Beliebtheit erfreute sich der „Data Stories“-Workshop. Teilnehmer Thomas Kollatz (Akademie der Wissenschaften und der Literatur | Mainz) berichtet anschließend:

„Wir sind im Workshop verdammt weit gekommen, aus unseren Daten eine lebendige Story zu machen.“ 

Gleichzeitig bot das NFDI4Culture-Helpdesk-Team für alle Anliegen rund um Forschungsdaten Speed-Date-Beratungen für die Plenary-Teilnehmenden an, wie beispielsweise von Jun.-Prof. Dennis Ried (Universität Halle-Wittenberg) wahrgenommen:

„Das Beratungsgespräch mit Leuten, die sich mit Förderstrukturen auskennen, hatte einen großen Mehrwert für mich, einfach gemeinsam Ideen zu sortieren.“

Helpdesk-Mitarbeiter Dr. Grischka Petri resümiert:

„Es waren durchaus umfangreiche Beratungen und auch sehr dichte, teils spezielle Infogespräche dabei. Natürlich können auch wir in einer halben Stunde die Dinge nicht vollständig lösen, aber wir konnten Türen aufstoßen und einen Wegweiser für die weiteren Schritte mit auf den Weg geben.“


Verleihung des DigAMus Awards für herausragende digitale Projekte im Kulturbereich

Präsentation der DigAMus Award Figur auf einer offnen Handfläche
DigAMus Award Figur – Autor:in: DigAMus Award Team

Die festliche Abendveranstaltung bot Gelegenheit für die schicke Abendgarderobe: Die GLAMouröse Verleihung des DigAMus Awards, der für herausragende digitale Projekte im Kulturbereich vergeben wird, fand erstmals im Rahmen des NFDI4Culture Community Plenarys statt. Das Organisationsteam des DigAMus Awards kam dafür ganz in Gold und Silber. Zusammen mit den goldenen Award-Figuren verliehen sie dem Event einen Hauch von Oscar-Flair.
Ein Gong-Schlag (wie es in der Akademie der Wissenschaften und der Literatur Mainz Tradition ist) läutete die Zeremonie der Preisverleihung ein und lud die Teilnehmenden vor Ort in den Plenarsaal ein. Neben dem Live-Event wurde auch die Möglichkeit der Online-Teilnahme angeboten. Die anspruchsvolle Umsetzung des hybriden Events wurde als sehr gelungen gelobt: Das Ineinandergreifen von Technik (Zoom-Stream) und Live-Event vor Ort bot eine abwechslungsreiche und unterhaltsame Mischung aus Präsenz, Einspielung von Videos und Online-Beteiligung, die alle Zuschauenden von Nah und Fern inkludierte.
Nach Vorstellung der Favoriten-Projekte auf der Shortlist wurde der DigAMus Award in sechs verschiedenen Kategorien verliehen. Für die Gewinner-Projekte gab es viel Applaus, sogar Jubelrufe aus dem Publikum. Besonders die Freude der „Five Guides“ vom TikTok-Kanal @five.guides des LWL-Museums für Archäologie und Kultur (Gewinner-Projekt in der Kategorie “Zeitgemäße Vermittlung”) war regelrecht ansteckend und erfüllte den ganzen Raum. Man merkte den Guides einfach an, dass es ihnen eine Herzensangelegenheit ist, jungen Menschen einen Zugang zu Kultur und Museen auf Augenhöhe zu bieten. Die Projektbeteiligte Marie Jakob sagte nach der Verleihung:

„In das Projekt ist viel Arbeit hineingeflossen. Daher ist der Award eine tolle Bestätigung, dass wir damit einen Nerv getroffen und einen guten Job gemacht haben.“

DigAMus Award Preisträger:innen "Five Guides" bei der Verleihung der Kategorie "Zeitgemäße Vermittlung"
DigAMus Award Preisträger:innen „Five Guides“ bei der Verleihung der Kategorie „Zeitgemäße Vermittlung“ – Autor:in: DigAMus Award Team


Der Publikumspreis, für den 1500 Menschen abgestimmt hatten, ging an den Museums-Podcast „Auf die Ohren“ des Ägyptischen Museums München zur altägyptischen Kulturgeschichte. Die Gewinnerinnen Roxane Bicker und Nora Heil, beide online zugeschaltet, waren ehrlich „überrascht und unvorbereitet“, „Jetzt haben wir richtig was zu feiern auf unserem Team-Fest!“

Johannes Sauter vom DigAMus-Award-Team, extra aus Bern angereist, erläuterte die Kooperation zwischen NFDI4Culture und dem DigAMus Award:

„Da sind so viele Daten aus den eingereichten Projekten – die wollen wir weiter für die Community nutzbar machen.“ NFDI4Culture unterstützt dabei insbesondere in Punkto Datenqualität und -struktur bei der Datenübertragung zu Wikidata.

“Wikidata ist dabei nicht nur Beifang. Der Preis an sich ist natürlich wichtig, auch für die Sichtbarkeit, aber der Hauptwert liegt in den Daten. Von der Kooperation mit NFDI4Culture erhoffen wir uns, dass die Community diese kuratierten Daten aufgreift und nutzt”, erklärte Johannes Sauter und ergänzte:

“Es war cool, offizieller Programmpunkt beim NFDI4Culture Community Plenary zu sein. Wir sind hier so gut aufgenommen worden, sowohl organisatorisch als auch vom Publikum. Hier ist eine sehr offene und dynamische Community, die Bock hat, wirklich etwas zu machen!”

Seine Mitstreiterin Sonja Thiel, zugeschaltet aus den USA, bekräftigte, die Kooperation habe die Verleihung des DigAMus Award in dieser Form erst möglich gemacht.

Konferenz-Tag 2: Aktueller Stand des Konsortiums und Fishbowl-Diskussion „Datensouveränität, infrastrukturelle Resilienz und Wissenschaftsfreiheit“


Spokesperson-Report, Neuigkeiten zu den Diensten und Arbeitsbereichen von NFDI4Culture

Am Donnerstag, 25.09.25, präsentierte NFDI4Culture dem Plenum den aktuellen den Stand des Konsortiums mit Berichten und wissenschaftlich Beiträgen zu den neuesten Aktivitäten und Services sowie einem Ausblick auf kommende Vorhaben. Zum Warm-Up gab eine live-Umfrage Einblicke, welche NFDI4Culture-Dienste bereits besonders gern genutzt werden (was die geneigten Leser:innen im Übrigen gern für sich selbst entscheiden dürfen). Anschließend stellten die Mitarbeitenden von NFDI4Culture, ergänzt durch kreative Show-Einlagen, ihre Updates, Beispiele und Insights zu den verschiedenen NFDI4Culture-Diensten und Arbeitsbereichen vor, darunter: 

  • Neuer Research Data Management Organiser zum Erstellen von Datenmanagementplänen
  • Data Quality Assessment und FAIR-Check zur Einschätzung der Qualität der eigenen Daten, jetzt noch interaktiver und mit Fairness-Gradmesser
  • Zusammenarbeit von NFDI4Culture mit verschiedenen Fachinformationsdiensten
  • LIDO (Lightweight Information Describing Objects), ein internationaler XML-Standard zur Beschreibung von Objekten und Lingua Franca für Museen, zu der NFDI4Culture künftig auch eine LIDO-Service-Stelle anbieten will
  • MEI (Music Encoding Initiative), ein offener, von der Community entwickelt XML-Standard zur Codierung von Musiknoten, zu dem NFDI4Culture aktuell ein MEI-Repositorium und ein MEI-Korpus für Kulturschaffende und Wissenschaft plant
  • Daten der Theaterwissenschaften und Performing Arts: Entwicklung von Services für spezielle ereignisbezogene Daten (wie z.B. Aufführungen)
  • FOSS (Free Open Source Software): bestehende Dienste mit der Community weiterentwickeln
  • Release der 3. Version des NFDI4Culture Portals als Zugangspunkt zu Ressourcen und Diensten sowie als Forschungsinformationssystem
  • NFDI4Culture Registry für Forschungswerkzeuge und Datendienste – nicht nur zum Explorieren, Suchen, Filtern und Finden, sondern auch Anlaufstelle für Forschende und Entwickler:innen, die ihre Angebote (Software, Skripte, Webanwendungen, Datenrepositorien oder -portale) zur Nachnutzung zentral verzeichnen möchten
  • Der Culture Knowlege Graph (KG) stellt eine Verbindung zwischen allen Forschungsdaten der Community her (Daten zu inzwischen rund 18 Mio. Entitäten). Zum Durchsuchen des KGs bietet NFDI4Culture neben der SPARQL-Schnittstelle nun auch eine neue Data Search mit spezieller Incipit-Suche für Musiknotation und KI-basierter Bildersuche
  • Institutionelle Resilienz für Kulturerbe im digitalen Raum: Schutzstrategien für Kulturgüter und -Daten zur Prävention für den Katastrophen- oder Krisenfall

Die Präsentationen zu diesen sowie allen weiteren Vorträgen werden in Kürze auf dem NFDI4Culture Portal zur Verfügung gestellt.

Spokesperson Torsten Schrade präsentiert dem Publikum die Vision „Gemeinsame Daten – Gemeinsame Praxis – Gemeinsames Wissen“ – Autor:in: Alexander Stark

Im Spokesperson-Report berichtet Konsortiumssprecher Prof. Torsten Schrade außerdem über die aktive Teilhabe diverser NFDI4Culture-Communities und der inzwischen rund 70 Participants, die beispielsweise Beiträge zu internationalen Metadatenstandards geleistet haben. Torsten Schrade betont:

„Partizipation ist das wichtigste, das Herz von NFDI4Culture ist eine gemeinsame, Community-geleitete Entwicklung einer gemeinsamen Datenkultur!”

Wegen der Breite der vertretenen Fachdisziplinen ist NFDI4Culture eines der größten und heterogensten Konsortien in der NFDI. Die Communities dieser verschiedenen Disziplinen sollen nun zu einer “Community of Practice” zusammengeführt werden, so Prof. Holger Simon, Co-Spokesperson von NFDI4Culture, „so wollen wir unsere Vision ‚Gemeinsame Daten – Gemeinsame Praxis – Gemeinsames Wissen‘ mit Leben füllen.“

Berichtet wurde weiter unter anderem über folgende Themen:

  • Der NFDI4Culture Helpdesk hat sich zum „Rückgrat“ von NFDI4Culture entwickelt und verzeichnet inzwischen über 760 Beratungsvorgänge zu Themen wie Copyright, Publikation und Databases. Dabei wird deutlich: Für Sustainability braucht es rechtliche Klarheit, rund 40% der Helpdesk-Anfragen gingen an den Legal Helpdesk.
  • Weiterbildung im Bereich Forschungsdatenmanagement (FDM) und Data/Code Literacy mit der Culture Research Data Academy, dem Educational Resource Finder und der Culture Knowledge Base (zentrales Informationsmedium zu FDM mit Handreichungen, Video-Tutorials und kuratierten Linkempfehlungen) – mit inzwischen rund 110 gut kuratieren Empfehlungen, alle maßgeschneidert für die NFDI4Culture-Community.
  • Der Research Output Index zeigt, was NFDI4Culture zu bieten hat: Konferenzbeiträge und -berichte, wissenschaftliche Literatur, Artikel und vieles mehr.
  • Community AAI (Authorization Authentification Identification), ein NFDI-Basis-Dienst, mit dem man sich sowohl für die Dienste von NFDI4Culture als auch für die anderer Konsortien anmelden kann – einmal anmelden, alle Dienste nutzen.
  • Dienste über Konsortien hinweg weiterentwickeln am Beispiel von Semantic Kompakkt (freie Software zur Annotation von 3D-Daten und gleichzeitig Repositorium zur Speicherung): erste Abbildung eines chemischen Moleküls in Semantic Kompakkt in Zusammenarbeit mit NFDI4Chem.
  • Internationalisierung: Ausloten der Zusammenarbeit mit fachspezifischen (inter-)nationalen GLAM-Infrastrukturen und Ausbau des internationalen Netzwerks.

Konsortiumssprecher Torsten Schrade fasste noch einmal zusammen:

„Back to the Future mit NFDI4Culture: mit Innovation, Partizipation, KI, 3D, KG, Datenqualität und Internationalisierung – das Abenteuer geht weiter!“


Datensouveränität, infrastrukturelle Resilienz und Wissenschaftsfreiheit – Fishbowl-Diskussion

Ein weiteres Highlight auf dem NFDI4Culture Community Plenary war das hochkarätig besetzten Panel „Datensouveränität, infrastrukturelle Resilienz und Wissenschaftsfreiheit“ mit Prof. Dr. Andrea Rapp (Präsidentin der Akademie der Wissenschaften und der Literatur | Mainz), Prof. Dr. York Sure Vetter (Direktor der NFDI) und Prof. Dr. Dörte Schmidt (NFDI-Kuratoriums-Mitglied). Dieser wichtige Programmpunkt konnte auch online verfolgt werden.
Das interaktive Fishbowl-Gespräch, an dem sich auch das Publikum beteiligen konnte, befasste sich nicht nur mit technischen Infrastrukturen und Datenräumen, sondern auch mit der Frage der Sicherung grundlegender Werte unserer digitalisierten Wissensgesellschaft. Digitale Souveränität und gesellschaftliche Resilienz werden in internationalen Aushandlungsprozessen mit geopolitischer Dimension verhandelt, die ein hohes Maß an „Datendiplomatie“ erfordern. Die Diskussionsrunde lotete aus, wie die NFDI und besonders ihre geistes- und kulturwissenschaftlichen Konsortien einen Beitrag zu einer verantwortungsvollen digitalen Transformation in Deutschland und Europa leisten können.

In ihren Eingangsstatements gaben die Panelist:innen Einblicke in ihre Perspektiven auf diese Themen. Den Anfang machte Prof. Andrea Rapp: Das NFDI4Culture Community Plenary zeige, was „durch die Wissenschaft organisiert“ bedeute: „Das sind mehr als eine Handvoll Nerds, sondern eine lebendige Community!“. Drei Punkte waren Andrea Rapp in ihrer Ansprache besonders wichtig: 1. In Verbindung mit dem Thema Wissenschaftsfreiheit sprach sie über langfristige Verpflichtungen am Beispiel von digitalen Editionen und wie diese die Wissenschaftsfreiheit stützen können, indem sie transparent Rechenschaft ablegen, was sich im Digitalen optimal organisieren lasse. 2. Datenqualität als Voraussetzung für KI-gestützte Verfahren: „Die unvermeidliche KI und Large Language Models sind Wahrscheinlichkeitsmodelle. Diese brauchen vertrauenswürdige Umgebungen und eine qualitätsgesicherte Datengrundlage.“ 3. Die fach- und domänenspezifischen Kompetenzen für die Langzeitverfügbarkeit von geisteswissenschaftlichen und Kulturgut-Daten sieht Andrea Rapp vor allem bei den Akademien, ergänzt durch die Universitäten: „Wir brauchen den Auftrag und die Ausstattung dafür, so fühlen wir uns gut gerüstet für diese Aufgabe“.

NFDI-Direktor Prof. York Sure-Vetter fasste zu Beginn zusammen, wie die NFDI in den letzten fünf Jahren gewachsen ist, hin zu einer „international sichtbaren Infrastruktur mit technischer Weitsicht“. Zwischen den Mitgliedern der NFDI sei trotz der fachlichen Unterschiede ein Vertrauensverhältnis aufgebaut worden, das es erlaube, gemeinsam an übergreifenden Querschnittsthemen zu arbeiten. Dabei verlieh York Sure-Vetter auch seiner Anerkennung für die hohe Professionalität von NFDI4Culture Ausdruck.
Einer seiner wichtigsten Talking Points galt der Demokratie: „Als eine Wissensinfrastruktur mit Bottom-up-Prinzip ist die NFDI wichtig für die Demokratie. Das müssen wir erhalten! Dafür ist auch Transparenz wichtig.“ Darüber hinaus schaffe die in Europa einzigartige föderierte Struktur der NFDI Resilienz, und zwar genau über diese Verteilung von technischen Ressourcen und auch Köpfen. Zur Resilienz-Strategie der NFDI gehören Cyber-Security, Redundanz und offene Standards. Mit ihren sicheren, interoperablen Diensten und ihrer förderierten Struktur könnte NFDI auch als strukturelles Role Model und Innovationsmotor in der EU dienen. 
Dass NFDI-Direktor York Sure-Vetter persönlich mit Diskussionsbeiträgen am NFDI4Culture Community Plenary teilnahm, ist bei 26 NFDI-Konsortien und nur 52 Wochen im Jahr keine Selbstverständlichkeit und freute die Community daher ganz besonders.

Prof. Dörte Schmidt eröffnete ihre Rede mit dem Statement, sie sei „geflasht, was wir geschafft haben in fünf Jahren: eine Vielfalt an Daten und wie kooperativ wir uns zusammenraufen, statt in Konkurrenz zueinander zu gehen“. Sie pflichtete York Sure-Vetter bei, dass Demokratie eine Grundvoraussetzung und die Wissenschafts- und Kunstfreiheit, die in Art. 5 des Grundgesetzes festgehalten ist, uns ermöglichen zu definieren, was für eine Gesellschaft wir sein wollen.
Beim Thema Datensouveränität sprach Dörte Schmidt von der NFDI als einem „vielköpfigen Souverän“, dessen Vorteile wir nutzen sollten, denn er bilde einen Gegenvorschlag zu Daten-Hegemonien und Monopolismen. Das bringe technische, ethische und rechtliche Anforderungen mit sich und mache Aushandlungen in unterschiedlichen Rechtsräumen nötig. „Für infrastrukturelle Resilienz müssen wir verteilt denken, denn verteilte Netzwerke sind nicht so angreifbar. Auch Redundanz wird in gewissem Maß wird gebraucht. Wir lernen gerade, was Resilienz bedeutet, und dass sie oft auch der Effizienz und vor allem dem Finanzierungskampf gegenübergestellt werden muss“. Dörte Schmidt beendet ihre Ansprache mit dem Aufruf „Denkt vernetzt! Das ist unsere demokratische Aufgabe“.

In der anschließenden Diskussionsrunde, der Fishbowl, nahmen neben den geladenen Panelist:innen auch wechselnde Diskutant:innen aus dem Publikum auf zusätzlichen freien Stühlen Platz und an der Diskussion teil. Moderiert wurde die Runde von Konsortiumssprecher Torsten Schrade.

Fishbowl Discussion mit Prof. Dörte Schmidt, Prof. Andrea Rapp, Peter Gietz, Prof. Torsten Schrade, Prof. York Sure Vetter, Dr. Grischka Petri
Fishbowl Discussion: Prof. Dörte Schmidt, Prof. Andrea Rapp, Peter Gietz, Prof. Torsten Schrade, Prof. York Sure Vetter, Dr. Grischka Petri – Autor:in: Alexander Stark

Beim Thema der europäischen Anschlussfähigkeit der NFDI stellt sich York Sure-Vetter verschiedene Dienste für die European Open Science Cloud (EOSC) vor, darunter auch der Authentifizierungsdienst. Daraufhin gab Moderator Torsten Schrade die Frage an das Publikum weiter: „Welche Dienste brauchen wir?” Peter Gietz (DAASI International) ergriff die Gelegenheit sowie einen freien Stuhl in der Diskussionsrunde und bestätigte: „Die NFDI4Culture-AAI [Authorization Authentification Identification] funktioniert. NFDI4Culture ist ein super Beispiel für Vernetzung, auch auf technischer Seite der Dienste.“ Als weiteres positives Beispiel wurde wiederholt Eduroam[1] genannt und mit viel Zustimmung aus dem Saal quittiert.
Auch über die angestrebte Verstetigung der NFDI wurde diskutiert. Dörte Schmidt machte sich dafür stark, die Politik zu überzeugen, „dass eine Investition in Köpfe einen Teil dieser Verstetigung darstellt“. Peter Gietz stimmte zu und merkte an: „In einem freien Raum sorgen eben diese Köpfe für Innovation“. Andrea Rapp nannte ergänzend die institutionelle Kontinuität. Einig waren sich alle, dass auch das bestehende Netzwerk verstetigt werden müsse, um nicht mit der Finanzierung wieder von vorne anfangen zu müssen.
Auch das Spannungsverhältnis zwischen Demokratie und Kapitalismus wurde in der Diskussion erneut aufgegriffen. Andrea Rapp brachte den Begriff der Allmende [im Sinne eines gemeinsamen Gutes der modernen Informationsgesellschaft, beispielsweise in Form von freier Software] in die Diskussion ein und merkte an: „Gemeingut macht Arbeit“. Moderator Torsten Schrade sprach den Konflikt zwischen Plattform-Ökonomie vs. Allmende an und fragte: „Können wir den Plattform-Giganten entkommen?“ York Sure-Vetter antwortete, es sei ein Machtkampf und führte ein Beispiel an: „Die großen Sprachmodelle haben sogar Experten überrascht, aber noch mehr Daten führen jetzt nicht mehr zu besseren Modellen, es tritt eine Saturierung ein. Für den Betrieb braucht man Rechenzentren so groß wie Manhattan. Wenn man da beispielsweise an Stromausfälle denkt… Es ist schwer, dem zu entkommen, wir müssen unsere Nische finden“.

[1] Eduroam: internationale Hochschul-Initiative, die Studierenden und Wissenschaftler:innen über ihren Universitätsaccount einen WLAN-Zugang an allen teilnehmenden Institutionen ermöglicht. Analog dazu funktioniert auch der NFDI4Culture-AAI-Dienst, über den allen Nutzenden, die über DFN bei NFDI4Culture registriert sind, der gesamte Dienste-Kosmos der NFDI zur Verfügung steht.

In ihren Schlussstatements gaben die Panelist:innen eine Einschätzung, was in den kommenden Jahren besonders wichtig werde. Dörte Schmidt sprach sich dafür aus, „dass wir uns auf unsere Aufgaben und Ziele besinnen, vor allem auf unser Alleinstellungsmerkmal, das uns von großen Playern unterscheidet. Wir können etwas leisten in der Gesellschaft“. 
Andrea Rapp stellte heraus, die Wissenschaft werde getragen von Personen, die ertüchtigt werden müssten, sich als Teil ihrer wissenschaftlichen Arbeit auch um Souveränität zu kümmern. Dafür bedürfe es Freiraum, Ansprechpartner und finanzieller Mittel.
York Sure-Vetter betonte die Bedeutung der Validierung der Dienste, die einerseits bottom-up funktioniere, indem die Communities durch ihre Nutzung zeigen, ob bestimmte Dienste, wie z.B. der Helpdesk, Anklang finden oder nicht. Gleichzeitig müsse die Führung top-down Entscheidungen treffen und „der Politik erklären können, wo wir das Geld gut investiert sehen”. Gebraucht werde also sowohl eine Politik, die unterstützt, als auch Nutzende, welche die Dienste wertschätzen.

Im Nachgang der Veranstaltung fasste Andrea Rapp ihre gewonnenen Erkenntnisse aus der Diskussion noch einmal für den vorliegenden Bericht zusammen:

„Die nachhaltige Zukunft der NFDI stellt uns vor große Herausforderungen, zugleich ist bei der Community, sowohl an der Basis als auch bei den Institutionen, Wille und Commitment groß, sich diesen Herausforderungen zu stellen und Verantwortung zu übernehmen. Dafür müssen Institutionen und Wissenschaftler:innen ertüchtigt werden.“


Rahmenprogramm: Spirio-Konzert, inspirierender Gesang, Ess- und Feierkultur

Aufgelockert wurden die Vorträge und Diskussionen von einem musikalischen Programm erster Güte. Die „Early Birds“ (die ersten 50 Plenary-Registrierten) wurden mit einem ganz besonderen Konzerterlebnis überrascht: Im Kalkhof-Rose-Saal, Deutschlands erstem Kammermusiksaal in Holzbauweise, wurde die innovative Steinway Spirio-Konzerttechnologie vorgeführt. Dabei handelt es sich um ein Selbstspielsystem, das live-Darbietungen von Pianist:innen weltweit von einem zum anderen Spirio-Flügel in Echtzeit übertragen oder aufzeichnen und originalgetreu wiedergeben kann, so authentisch, als würde die Künstlerin oder der Künstler selbst am Flügel sitzen. Geboten wurden Stücke gespielt von Hayato Sumino, Vladimir Horowitz, Jacob Collier und Arseniy Gusev.

Doch auch alle anderen Gäste kamen in den Genuss eines besonderen Konzerts: Zum musikalischen Rahmenprogramm des Plenarys zählte auch Sopranistin Lindsey Neumann aus den USA, begleitet am Klavier von Konzertpianistin Andrea Jantzen. Die beiden boten Lieder von F. Mendelssohn, R. Quilter und G. Puccini dar, mit einer Intensität und Präsenz in Stimme und Performance, die den Zuhörenden das Gefühl vermitteln konnte, ganz persönlich angesprochen zu sein. Lindsey Neumann berichtete, dass sie in der Vorbereitung auf ihren Auftritt den Auftrag erhalten habe, das Publikum zu inspirieren – was ihr zweifelsohne gelungen ist.

Konzert: Sopranistin Lindsey Neumann, begleitet am Klavier von Konzertpianistin Andrea Jantzen
Konzert: Sopranistin Lindsey Neumann, begleitet am Klavier von Konzertpianistin Andrea Jantzen – Autor:in: Team Social Media


Auch über das Konzert-Programm hinaus konnten die Plenary-Besucher:innen die Veranstaltung sinnlich und kulinarisch genießen. Das bunte Tagesprogramm wurde abends von einem Dinner, einem guten Glas Wein und anschließender Party gekrönt – letztere genießen in NFDI4Culture-Kreisen bereits einen legendären Ruf. DJane Fran(ziska Fritzsche) von BASE4NFDI sowie die Musik-Wünsche der Anwesenden sorgten für einen ausgelassenen (Tanz-)Abend, der sicher vielen in Erinnerung bleibt.

Party!! DJane Fran(ziska Fritzsche) dancing
Party!! DJane Fran(ziska Fritzsche) dancing – Autor:in: Team Social Media


Konferenztag 3: Markt der Möglichkeiten, 4CultureHour auf Mastodon und Stimmen aus der Community


Markt der Möglichkeiten und 4CultureHour auf Mastodon

Mit dem Markt der Möglichkeiten am Freitag, 26.09.25, bot NFDI4Culture einen Begegnungsraum vor Ort, in dem Services von NFDI4Culture, aber auch Participants und Partner:innen des Konsortiums sich anhand von Posterpräsentationen vorstellen und miteinander ins Gespräch kommen konnten. Die Marktbesucher:innen waren eingeladen zum Schlendern, Entdecken und Netzwerken. In der Speakers-Corner wurde in kurzen Marktreden auf interessante Marktstände, Veranstaltungen oder gute Ideen aufmerksam gemacht.

 
Menschen und Poster auf dem Markt der Möglichkeiten
Auf dem Markt der Möglichkeiten – Autor:in: Alexander Stark


Dr. Fabian Pittroff (Ruhr-University Bochum) stellte mit seinem Poster beispielsweise eine „Infrabel zur Ethnografie zum Umgang mit Forschungsdaten“ vor. Infrabel setzt sich zusammen aus den Wörtern Infrastruktur und Fabel und thematisierte in diesem Falle anhand der Feldmaus und des Pelikans verschiedene Arten der Pflege von Forschungsdaten. Im Unterschied zur klassischen Fabel, in der Tiere die Eigenschaften von Menschen verkörpern, haben diese in der Infrabel Eigenschaften von Infrastrukturen. Der Markt der Möglichkeiten hat sich laut Fabian Pittroff gelohnt: 

„Die Poster haben gut funktioniert, um ins Gespräch zu kommen.“ 

In einem kurzen Interview führte er auf die Frage nach seinen Eindrücken vom NFDI4Culture Community Plenary aus: 

„Ich bin zum Plenary gekommen, weil ich den Eindruck habe, dass mir NFDI4Culture beim Einarbeiten in das Thema FDM potenziell viel Arbeit abnehmen kann. Ich habe mir darüber hinaus viel Überraschendes notiert. Mich interessiert auch, wie sich NFDI4Culture organisiert. Es fand recht viel Selbstverständigung des Konsortiums statt, dadurch bekam man Einblicke in den Inner Circle – gleichzeitig fühlte ich mich sehr willkommen. Und was mir aus der Fishbowl-Diskussion noch in Erinnerung geblieben ist, waren Schlagworte wie ‚verteilte, aber vernetzte Strukturen‘, ‚mit stolz von unseren Daten sprechen‘ und ‚Lust an der Heterogenität‘.“

Auch andere Marktbesucher:innen konnten von den Posterpräsentationen profitieren:

„Bei den Postern habe ich sogar etwas gelernt, was ich für unser Projekt Buber-Korrespondenzen Digital verwenden kann“, freute sich Thomas Kollatz (Akademie der Wissenschaften und der Literatur | Mainz).

Eine Zusammenstellung aller vertretenen Poster wird in Kürze auf dem NFDI4Culture Portal veröffentlicht.

Collage aus den Postern vom Markt der Möglichkeiten
Poster-Collage – Autor:in: Katja Sternitzke


Mit der 4CultureHour, die sich dann sogar auf mehrere „Hours“ ausweitete, wurde der Markt der Möglichkeiten vom NFDI4Culture-Social-Media-Team live auf Mastodon begleitet. Bereits die Social-Media-Berichterstattung der beiden Vortage hatte viel Resonanz erzeugt. Während des letzten Konferenztages hatten Interessierte nun die Möglichkeit, direkt auf die Poster zu reagieren oder Fragen zu stellen. Teilweise konnten diese dann sogar von der Poster-betreuenden Person auf Mastodon beantwortet werden. So übertrug sich die allseitige Begeisterung auch in den digitalen Raum. Weitere Eindrücke von NFDI4Culture in den Sozialen Medien sind auch auf LinkedIn und auf Mastodon unter #4CultureCommunityPlenary zu finden.


Die Community resümiert

Bevor sich alle auf die Heimreise machten, rekapitulierten einige Plenary-Teilnehmende für uns ihre persönlichen Eindrücke von der Veranstaltung. Dennis Ried (Uni Halle-Wittenberg), der übrigens 2024 mit dem NFDI4Culture Music Award ausgezeichnet wurde, fasste seine Plenary-Erfahrung folgendermaßen zusammen:

„Ich wollte mir ein Bild machen, was für Dienste es bei NFDI4Culture gibt, was die können und wie sie funktionieren. Mich persönlich interessiert darüber hinaus besonders die Verbindung von 3D-Daten und Musikwissenschaft und wie man die einsetzen kann. Es gäbe da gute Möglichkeiten für fächerübergreifenden Datenaustausch, zum Beispiel bei antiker Musik mit der Archäologie, wenn sich beispielsweise Musik auf antiken Amphoren findet. Beim Data-Stories-Workshop habe ich nebenbei noch erfahren, was man mit dem Culture Knowledge Graph alles machen kann. Insgesamt finde ich es beeindruckend, wie stark die NFDI als Ganzes aus 1000 Einzelteilen hervorgegangen ist. Nur bei den ganzen internen Kürzeln blicke ich noch nicht durch – wenn ich mir etwas wünschen könnte, dann wäre es ein Glossar der Abkürzungen“.

Andreas Kohlbecker vom ZKM Karlsruhe, welches Participant bei NFDI4Culture ist, war zum NFDI4Culture Community Plenary gekommen, um zu erfahren, was der aktuelle Stand des Konsortiums ist und wohin die Reise künftig geht – und auch, weil er gerne die Kommunikationskanäle des Konsortiums, wie beispielsweise den RocketChat, nutzen möchte. Des Weiteren nahm er am Workshop zu den Base4NFDI-Services teil:

„Da konnte man sehen, was sich inzwischen in der NFDI alles getan hat. Ich wollte mich informieren, wie genau ich die Tools bei uns im Haus nutzen kann, um Probleme zu lösen. Der Workshop war echt ein Highlight, weil sich danach ein Gesprächsfäden über die drei Konferenztage hinweg ergeben hat. Insgesamt hat es sich wirklich gelohnt, nach Mainz zu kommen, ich habe mich sehr wohl gefühlt, konnte mein Netzwerk erweitern – und NFDI4Culture kann tolle Parties feiern!“

Für die Zukunft möchte er dem Konsortium noch mit auf den Weg geben: „NFDI4Culture muss europäischer werden!“. Genau das hat NFDI4Culture mit seinen Internationalisierungsbestrebungen auch vor.

NFDI-Kollegin Veronica Haas (Universität Mannheim) vom Konsortium BERD@NFDI verabschiedete sich mit den Worten:

„So eine schöne Konferenz – und die Musikeinlagen waren beeindruckend!“

Auch NFDI4Culture freut sich, besonders nach diesem fruchtbaren Austausch, dem gemeinsamen Lernen, Glitzern, Feiern, Netzwerken, Diskutieren, Konzert-Erleben, Schlemmen und Tanzen, auf ein Wiedersehen mit der Community – allerspätestens beim nächsten Culture Community Plenary!

Gruppenfoto von NFDI4Culture und der Community
NFDI4Culture und die Community – Autor:in: Alexander Stark

Text+ Workshop „Sprach- und Textdaten für Gesellschaft, Gesundheit und Medizin“ am 05.-06.03.2026 in Hamburg

2025年12月19日 16:09

Das NFDI-Konsortium Text+ lädt ein zum Workshop „Sprach- und Textdaten für Gesellschaft, Gesundheit und Medizin“ am 05.-06.03.2026 am Hamburger Zentrum für Sprachkorpora (HZSK). Der zweitägige Workshop (Lunch-to-Lunch) der TaskArea „Collections“ widmet sich den Schnittstellen zwischen sprach- und textbasierten Forschungsdaten und angrenzenden Disziplinen in den Bereichen Gesellschaft, Gesundheit und Medizin. Gemeinsam wollen wir erkunden, wie sich Forschungsdatenmanagement (FDM) für text- und sprachbasierte Forschung in diesen interdisziplinären Kontexten gestalten lässt.

Text+ ist ein Konsortium der Nationalen Forschungsdateninfrastruktur (NFDI) und hat zum Ziel, sprach- und textbasierte Forschungsdaten langfristig zu erhalten und ihre Nutzung in der Wissenschaft zu ermöglichen. Der Workshop bietet ein Forum für den Austausch über nachhaltige und sichere Bereitstellung, Analyse und Nachnutzung von Forschungsdaten. Dabei geht es u.a. um Fragen der mehrsprachigen Kommunikation und Multimodalität.

Programm-Highlights:

  • Keynotes und Fachvorträge zu aktuellen Herausforderungen und Lösungen im FDM für sprach- und textbasierte Forschungsdaten mit dem Fokus auf die Bereiche Gesellschaft, Gesundheit und Medizin
  • Posterpräsentationen und Demos: Teilnehmende sind eingeladen, eigene Ansätze und Projekte vorzustellen
  • Möglichkeiten der Erschließung weiterer Sprach- und Textdaten sowie deren Integration in Text+ und NFDI4Health

Zielgruppe:

Forscherinnen und Forscher aus den Geistes-, Sozial- und Lebenswissenschaften sowie alle, die sich für sprach- und textbasierte Daten in interdisziplinären Kontexten interessieren.

Anmeldung:

Die Anmeldung erfolgt via: https://events.gwdg.de/event/1252/registrations/1005/. Die Teilnahmegebühr beträgt 40 €. Nach der Anmeldung über die Eventwebsite erhalten Sie alle Informationen zur Überweisung.

Wir freuen uns auf Ihre Teilnahme!

SSH Open Marketplace & FAIR Practices Training Series 2026

2025年12月4日 00:04

Das SSH Open Marketplace Editorial Board startet 2026 eine achtteilige praxisorientierte Online-Workshopreihe, um digitale Kompetenzen und FAIR-Praktiken in den Sozial- und Geisteswissenschaften zu stärken. Jeden dritten Freitag im Monat von 13:00 bis 14:30 Uhr (CET), geht es online um offene Wissenschaft, gute Datenpraxis und den smarten Einsatz des SSH Open Marketplace im Forschungsalltag. Die Termine reichen von Feburar bis November 2026 – mit einer Pause im Juli und August.

Worum geht es?

Die SSH Open Marketplace & FAIR Practices Training Series 2026 verbindet Schlüsselfragen von FAIR, CARE und Open Science mit praktischen Hands-on-Sessions rund um den SSH Open Marketplace als Discovery-Portal für Tools, Services, Trainingsmaterialien, Daten und Workflows. Der Adressatenkreis sind allgemein Interessierte mit Bezug zu den Social Sciences and Humanities, aber insbesondere Forschende, Datenmanager:innen und Forschungsservices in den SSH, die ihre Daten und Workflows besser auffindbar, nachnutzbar und anschlussfähig machen wollen – ohne sich allein durch die Vielzahl an Angeboten kämpfen zu müssen.

Weitere Hintergrundinformationen rund um den SSH Open Marketplace sowie das Editorial Team gibt es hier.

Save the dates

– 20. Februar: FAIR, CARE & Open Science Principles

– 20. März: Introduction to SSH Open Marketplace

– 17. April: Making the most of the SSH Open Marketplace

– 15. Mai: Contributing to SSH Open Marketplace

–  19. Juni: Thematic Arts and Humanities

– 18. September: Thematic GLAM institutions

– 16. Oktober: Thematic language data

– 20. November: Thematic Social sciences

Die Teilnahme ist online, kostenfrei und auf Interaktion ausgelegt: In allen Sessions sind Fragen, Use Cases aus laufenden Forschungsprojekten wie auch der Blick in eigene Datenbestände gerne gesehen. Wer sich nun den Vorsatz gesetzt hat, im kommenden Jahr die eigenen digitalen Forschungspraktiken weiter auszubauen, kann sich hier registrieren, um auf dem Laufenden zu bleiben.

Download

SSHOMP_2026 Online Training Series (PDF)

Bekanntgabe der neuen Kooperationsprojekte von Text+ für 2026

2025年10月28日 19:46

von Antonina Werthmann, Jutta Bopp und Magdalena Ljubić (alle IDS Mannheim)

Text+ fördert jährlich ausgewählte Kooperationsprojekte – mit dem Ziel, das Angebot an Daten und Services kontinuierlich zu erweitern und der wissenschaftlichen Gemeinschaft langfristig zugänglich zu machen. Wir freuen uns, für 2026 die Förderung folgender fünf Projekte bekanntzugeben, die aus 14 eingereichten Vorschlägen ausgesucht wurden. Informationen zu bisher geförderte Projekten finden sich in unserer Blog-Reihe Text+Plus.

FADE

„Frühneuzeitliche Ärztebriefe: Aufbereitung, Datenharmonisierung und Einbindung“
Ines Röhrer (Bayerische Akademie der Wissenschaften)
Task Area in Text+: Collections

Das Projekt zielt auf die strukturelle und technische Erneuerung der Datenbank Frühneuzeitliche Ärztebriefe (1500–1700) ab. Die rund 65.000 Briefmetadatensätze werden aus einem nicht anschlussfähigen Format herausgelöst, nachhaltig aufbereitet und über CorrespSearch, die Text+ Registry sowie eine neue Webplattform langfristig zugänglich gemacht.

Transcription+

„ISO 24624:2016 – Transcription of spoken language: Ressourcen, Dokumentation und multilinguales Demokorpus “
Dr. Thomas Schmidt (Universität Duisburg-Essen)
Task Areas in Text+: Collections und Infrastructure/Operations

Das Projekt bereitet bestehende Ressourcen zur Anwendung des TEI-basierten ISO-Standards ISO 24624:2016 – Transcription of spoken language auf. Ein mehrsprachiges Demonstrationskorpus sowie Code zur Verarbeitung von Transkripten werden in Text+ integriert. Damit werden Dokumentation und Nutzbarkeit des Standards verbessert und seine Nutzerbasis erweitert.

IDIOM+

„Digitale Inschriftenforschung – Maya-Hieroglyphen in Text+“
Dr. Christian Prager (NRW Akademie der Wissenschaften und der Künste / Rheinische Friedrich-Wilhelms-Universität Bonn)
Task Area in Text+: Editions

IDIOM+ erschließt ein bislang unterrepräsentiertes Korpus zur Schrift- und Sprachkultur des Klassischen Maya. Ziel ist die Integration der Forschungsdaten des Projekts Textdatenbank und Wörterbuch des Klassischen Maya (TWKM) in die Text+-Infrastruktur. Eine FCS-kompatible API verknüpft RDF-Metadaten, TEI/XML-kodierte Inschriften und JSON-basierte Sprachdaten zu einer durchsuchbaren, semantisch angereicherten Struktur. Über SRU/SRW werden die Daten föderiert zugänglich gemacht.

AWV 2.0

„Langzeitverfügbarkeit und Integration der Altägyptischen Wörterbücher im Verbund“
PD Dr. Franziska Naether (Sächsische Akademie der Wissenschaften zu Leipzig)
Task Area in Text+: Lexical Resources

Ziel des Projekts ist die Transformation der Datenbank Altägyptische Wörterbücher im Verbund, um wichtige lexikographische Grundlagen und Forschungsergebnisse der altägyptischen Sprache wieder der Wissenschaft zugänglich zu machen. Die ägyptischen Lemmata werden in Unicode (Transkription und Hieroglyphen) umgesetzt und mit dem Release 2.0 des Thesaurus Linguae Aegyptiae verknüpft.

MuLingFrames

„Entwicklung eines sprachenübergreifenden Standard-Repräsentationsmodells für framesemantische Daten“
Prof. Dr. Oliver Czulo (Institut für Translatologie gGmbH)
Task Area in Text+: Lexical Resources

Ausgehend vom einsprachigen Berkeley FrameNet sollen mehrsprachige FrameNets harmonisiert werden. Ein einheitliches FrameNet-Datenformat wird entwickelt, das bestehende Erweiterungen wie G-FOL (englisch-deutsch) und Kicktionary (englisch-französisch-spanisch-deutsch) integriert. Die Ressourcen werden in das neue Format überführt, dokumentiert und frei zugänglich gemacht, um die Weiterentwicklung sprachenübergreifender, framesemantischer Daten zu fördern.


Wir sind gespannt auf die innovativen Ansätze dieser Projekte und überzeugt, dass sie die Infrastruktur von Text+ nachhaltig bereichern werden. Wir freuen uns auf eine enge, produktive und erfolgreiche Zusammenarbeit im Jahr 2026!


DiHMA.Lab mit MaRDI und NFDI4Objects am 14. und 15. Oktober an der FU Berlin

2025年9月7日 18:08

Am 14. und 15. Oktober 2025 lädt das DiHMa.Lab der Freien Universität Berlin in Kooperation mit dem ZIB zu einem gemeinsamen Workshop der Konsortien MaRDI und NFDI4Objects an die Freie Universität Berlin ein. Rund um das Thema „Objekte und Methoden“ wird der interdisziplinäre Workshop verschiedene Perspektiven aus der Mathematik und objektbasierten Geisteswissenschaften zusammenführen. Ziel ist es, Ansätze, Werkzeuge und Fragestellungen beider Disziplinen in den Dialog zu bringen, Schnittstellen sichtbar zu machen und gemeinsame methodische Herausforderungen zu diskutieren.

Das vorläufige Programm wird noch aktualisiert:

Tag 1

14.10.2025, 10:00-12:00 Uhr

Im Vorfeld des Workshops findet ein Ediathon: “Object meets Maths: Wikidata als Knowledge Hub” statt. Kommt sehr gern mit Daten und Notebooks vorbei.

12 Uhr Mittag auf Selbstzahlerbasis in der Mensa

14.10.2025 (13:00-16:45 Uhr)  

  • Icebreaker und Vorstellungsrunde (13:00-13:45)
  • Vorstellung der NFDI-Konsortien (14:00-14:45)
  • Statistische Methoden (15:00-15:45)
  • Datenintegration Wissensgraph (16:00-16:45)
  • Ab 17 Uhr gemeinsamer Ausklang auf Selbstzahlerbasis in der Eierschale

Tag 2

15.10.2025 (09:00 – 13:00 Uhr)

  • Wissenschaftliche Objektsammlungen und multimodale Forschungsdaten (9:00-9:45)
  • Use Case Datenanalyse “Windows on Data” (10:00-10:45) 
  • Interdisziplinäres Arbeiten (Challenges / Schwierige Fälle / was ist nicht operationalisierbar? / was ist bereits gut operationalisiert?) / MARDI als Methodendatenbank (11:00-11:45) 
  • Fishbowl: Zusammenarbeit mathematische Methoden in kulturhistorischen Fragestellungen (12:00-13:00)
  • Ab 13 Uhr gemeinsames Mittagessen auf Selbstzahlerbasis in der Mensa

Veranstaltungsort: Villa Engler, Altensteinstraße 2-4, 14195 Berlin (am Haupteingang des Botanischen Gartens)

Alle Informationen finden sich hier: https://www.ada.fu-berlin.de/ada-labs/dihma-lab/DiHMa-MARDI-N4O/index.html

Zur Anmeldung: https://www.ada.fu-berlin.de/ada-labs/dihma-lab/Modulbeschreibungen_DIHMa/PM-Anmeldung_DHIMA_LAB/index.html 

Mit freundlichen Grüßen Eure Local Organizers
Anja Gerber, Christin Keller, Dennis Mischke, Fabian Fricke, Marco Reidelbach, Marcus Weber

❌