❌

普通视图

Received before yesterday

Workshopbericht „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ (29.05.26 in Leipzig)

2026年9月2日 15:28

Von Lukas Hohendorf, Kai Matuszkiewicz, Lydia Riedl und Paula Rinke
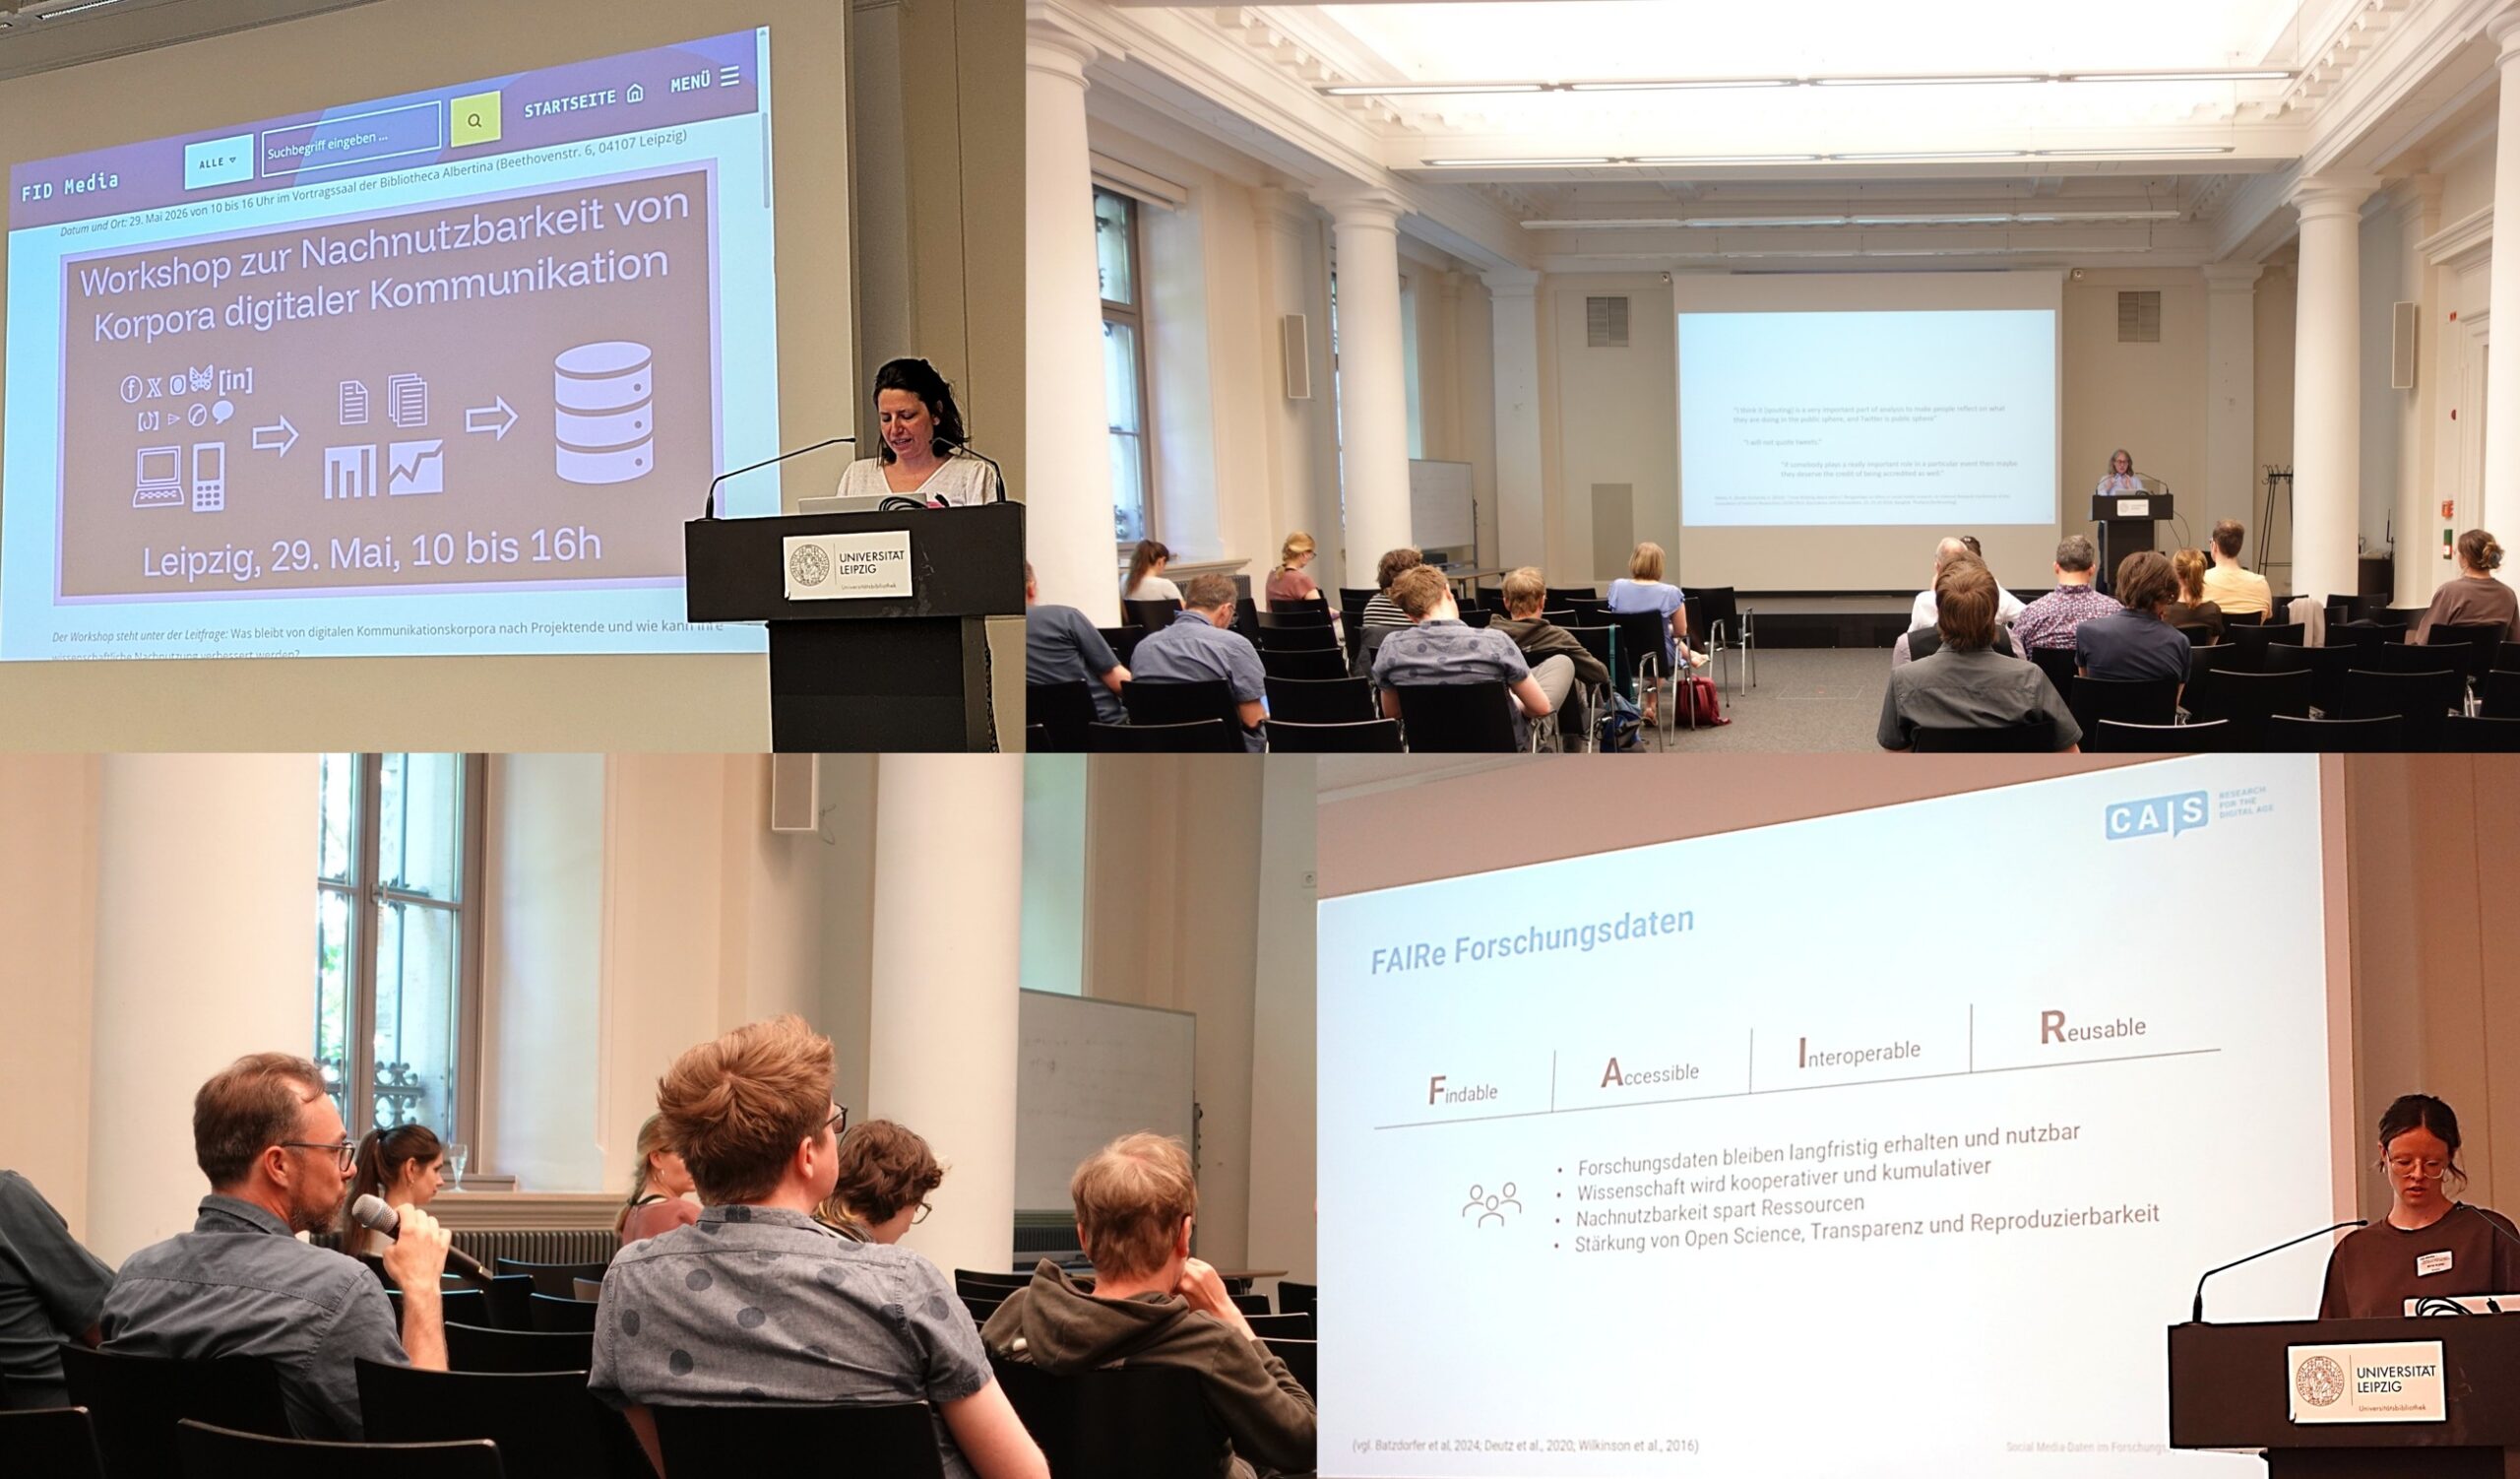
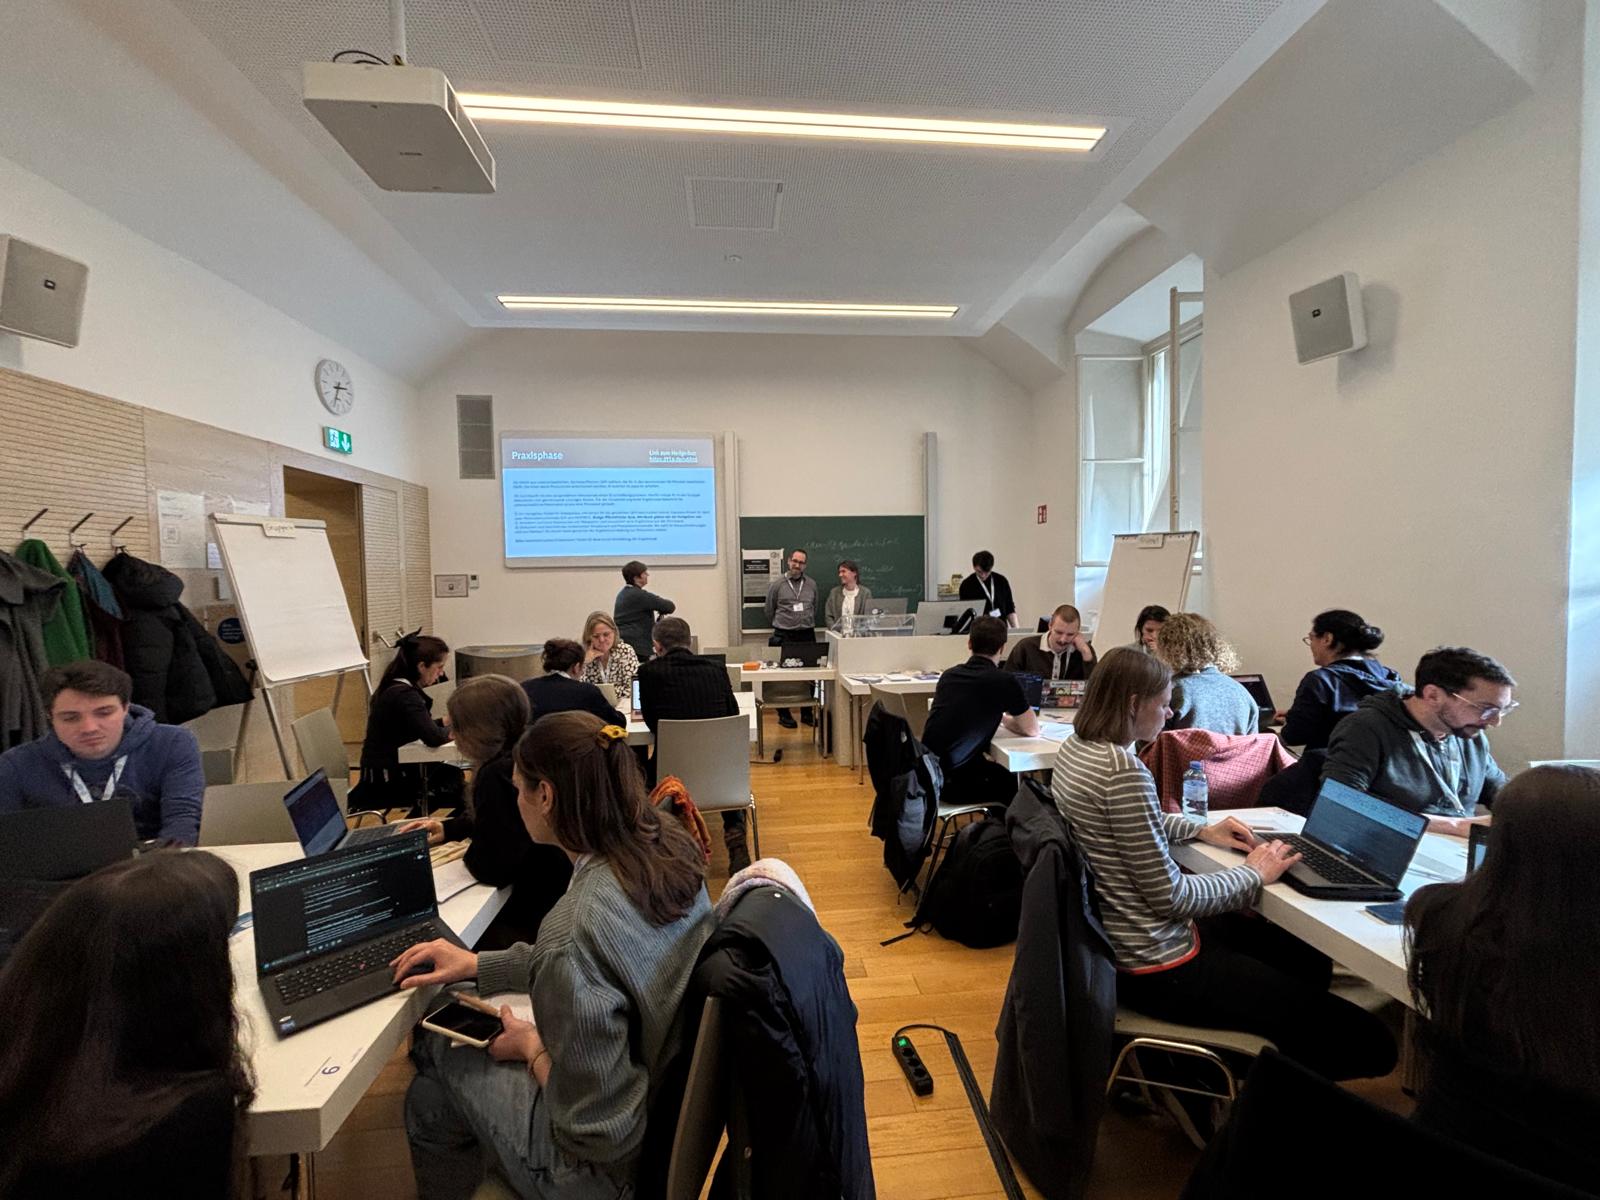
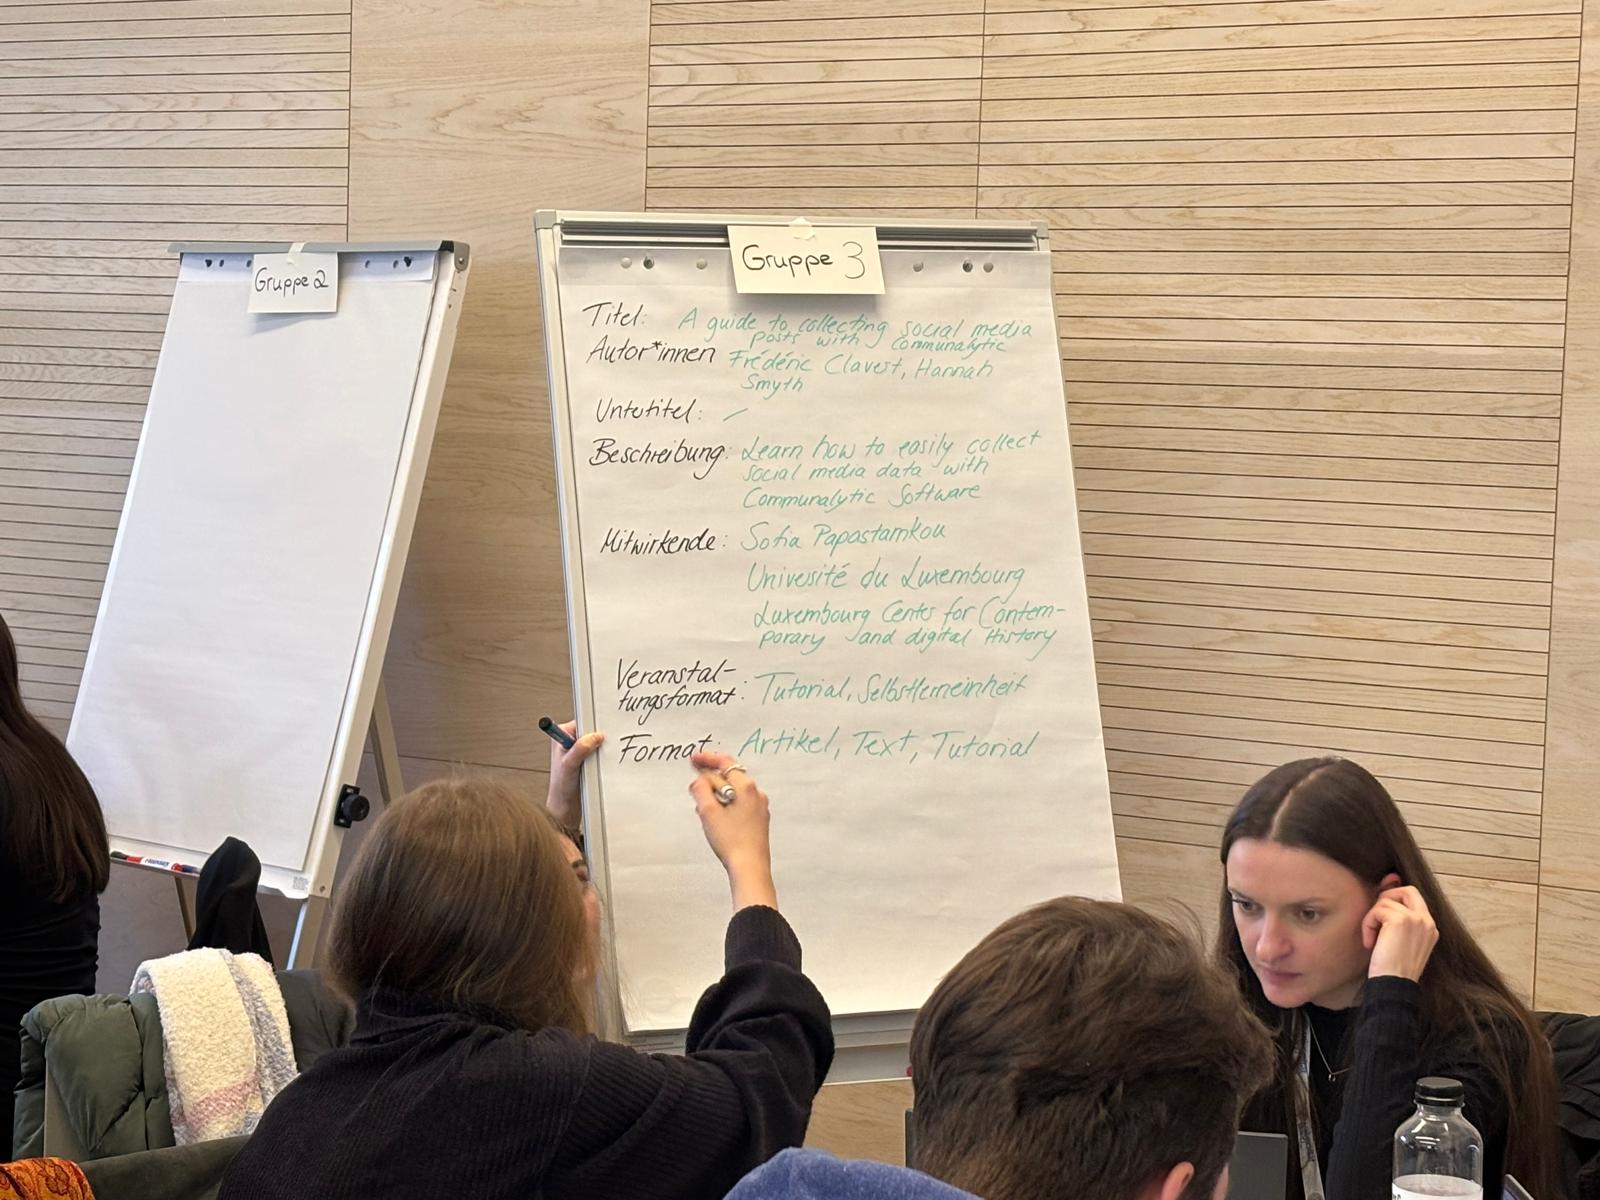
Fotos: FID Media

Fotos: FID Media

Ausgangspunkt

In digitalen Räumen werden fortlaufend Daten produziert, die für die Kommunikations- und Medienwissenschaft von hoher Relevanz sind, darunter Beiträge und Kommentare in sozialen Medien, Kommunikationsverläufe in Messenger-Diensten, audiovisuelle und auditive Inhalte, digitale Zeitungsarchive und digitalisierte historische Quellen oder journalistische Online-Angebote. In Forschungsprojekten entstehen daraus häufig umfangreiche Korpora. Viele Forschende wissen aus eigener Erfahrung, dass diese nach Projektende jedoch oft schwer auffindbar, nur eingeschränkt dokumentiert oder aufgrund rechtlicher, ethischer und technischer Rahmenbedingungen nicht ohne Weiteres nachnutzbar bleiben.

An dieser Ausgangsproblematik setzte der Workshop „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ an, den der FID Media am 29. Mai 2026 an der Universitätsbibliothek Leipzig veranstaltete. In ihrer Begrüßung führte Patricia Blume in diese Ausgangsproblematik ein und benannte als übergeordnete Fragen des Workshops, wie digitale Kommunikationskorpora entstehen, unter welchen Bedingungen sie wissenschaftlich analysiert werden können und welche Rolle fachnahe wissenschaftliche Infrastrukturen künftig bei ihrer Dokumentation und Vernetzung spielen können, um sie niedrigschwellig nachnutzbar zu machen.

Wie durch Lukas Hohendorf in seiner anschließenden Einführung erläutert, strukturierte sich der Workshop dabei entlang wichtiger Stationen des üblichen Forschungsprozesses. Im ersten Panel ging es um die Entstehung digitaler Kommunikationsdaten und die methodischen, epistemischen und ethischen Entscheidungen, die bereits die Datenerhebung beeinflussen. Das zweite Panel rückte die Frage in den Vordergrund, wie aus projektgebundenen Datensammlungen längerfristig nachnutzbare Forschungsressourcen werden können. Das dritte Panel diskutierte schließlich die Potenziale und Grenzen vernetzter Kommunikationskorpora für Analyseformen, insbesondere in der Computational Communication Science (CCS).

Von digitaler Kommunikation zu Korpora für die Forschung

Das erste Panel, moderiert von Patricia Blume, widmete sich der grundlegenden Frage, wie digitale Kommunikationsspuren überhaupt zu Forschungsdaten werden. Die Beiträge veranschaulichten, dass digitale Daten nicht einfach „vorliegen“, sondern in komplexen technischen, sozialen und institutionellen Prozessen hergestellt werden. Welche Daten verfügbar sind, welche Lücken entstehen und welche Kommunikationsformen überhaupt beobachtbar werden, hängt von Plattformarchitekturen, Zugangsmöglichkeiten, Erhebungspraktiken, ethischen Entscheidungen und rechtlichen Rahmenbedingungen ab.

Katharina Kinder-Kurlanda (Universität Klagenfurt) nahm in ihrem Beitrag „Epistemische Herausforderungen von Big Social Media Data für die Sozialwissenschaft“ die Entstehungsbedingungen digitaler Daten in den Blick. Sie zeigte, dass Forschung mit großen Datenbeständen aus sozialen Medien immer auch mit asymmetrischen Datenökonomien verbunden ist. Während plattformbetreibende Unternehmen umfangreiche Datenbestände kontrollieren, sind Forschende häufig auf instabile oder nachträglich eingeschränkte Zugänge angewiesen. Diese Abhängigkeit schlägt sich nicht nur in der Datenerhebung selbst nieder, sondern beschränkt auch den Möglichkeitsraum der Forschungsfragen, die wissenschaftlich überhaupt bearbeitbar sind.

Ein zentrales Thema ihres Beitrags war die Sichtbarkeit von Datenarbeit. Viele Entscheidungen, die für wissenschaftliche Ergebnisse maßgeblich sind, bleiben in Publikationen oft unterbelichtet: Wie wurden Daten erhoben, bereinigt, ausgeschlossen, anonymisiert oder transformiert? Welche Plattformbedingungen haben den Zugang strukturiert? Welche ethischen Abwägungen waren im Forschungsprozess erforderlich? Kinder-Kurlanda betonte, dass Datenpraktiken situiert, iterativ und plattformgebunden sind. Transparenz über diese Praktiken ist daher eine Voraussetzung für die Überprüfbarkeit und Einordnung wissenschaftlicher Ergebnisse.

Auch die Archivierung digitaler Plattformdaten wurde als besondere Herausforderung sichtbar. Am Beispiel früherer Twitter-Forschung wurde aufgezeigt, dass die Archivierung von IDs zwar eine Zeit lang als praktikabler Kompromiss galt, langfristig aber keine verlässliche Perspektive bietet, wenn die Rehydrierung, d.h. die Wiederherstellung der Inhalte, weiterhin von der Plattform abhängig bleibt. Dagegen kann die Archivierung von Code, Erhebungsprotokollen, Dokumentationen und Verarbeitungsroutinen auch dann wissenschaftlichen Mehrwert erzeugen, wenn die vollständigen Rohdaten nicht dauerhaft geteilt werden können. In der Diskussion wurde zudem herausgestellt, dass Forschungsethik nicht vollständig an formale Verfahren oder Infrastrukturen delegiert werden kann. Ethikkommissionen, institutionelle Leitlinien und Beratungsangebote können unterstützen, die Verantwortung für konkrete Forschungsentscheidungen bleibt jedoch Teil der wissenschaftlichen Praxis.

Erik Koenen (Universität Bremen) weitete den Blick auf digitale Zeitungsportale und die epistemischen Folgen der Digitalisierung journalistischer Quellen. Im Zentrum des Beitrags stand, dass digitalisierte Zeitungen nicht einfach analoge Objekte in digitaler Form sind. Sie liegen zugleich als Bild, Layout, Volltext, Metadatenstruktur und Suchumgebung vor. Damit verändern sich nicht nur die Zugriffswege, sondern auch der epistemische Status der Quelle selbst. Digitale Zeitungsportale fungieren nicht allein als Archive, sondern auch als methodische und epistemische Forschungsumgebungen.

Koenen argumentierte, dass digitale Zeitungsportale als medientechnische Assemblagen verstanden werden müssen. Sie sind digitale Archive, Sammlungen, Lesesäle, Suchmaschinen und Experimentalsysteme zugleich. Anknüpfend an wissenschaftstheoretische Perspektiven, unter anderem an Ludwik Flecks Konzept wissenschaftlicher Denkstile und Hans-Jörg Rheinbergers Begriff des Experimentalsystems, zeigte er, dass digitale Technologien neue Formen wissenschaftlicher Beobachtung und Interpretation hervorbringen. Distant Reading und Distant Viewing eröffnen neue Perspektiven auf Medienwandel, Layoutgeschichte und öffentliche Kommunikation, setzen aber zugleich eine digitale Quellenkritik voraus, die sich mit Datenformaten, Auszeichnungspraktiken, OCR-Qualität, Portallogiken und Suchinfrastrukturen auseinandersetzt.

Vanessa Angenendt (Universität Duisburg-Essen) brachte mit ihrem Projekt zu Misogynie in Chat-Kommunikation eine weitere Perspektive auf die Entstehung digitaler Kommunikationsdaten ein. Ihr Beitrag befasste sich nicht mit öffentlicher Plattformkommunikation, sondern mit privater oder halböffentlicher Chat-Kommunikation, die der Forschung bislang nur schwer zugänglich ist. Die Datengrundlage bilden Datenspenden, um Chatverläufe zu erfassen, in denen frauenfeindliche oder misogyne Kommunikation sichtbar wird.

Der Beitrag verdeutlichte die gesellschaftliche Relevanz innovativer Wege der Datengewinnung, weil sozial unerwünschte Phänomene wie digitale Misogynie strukturell bedingt häufig in Kommunikationsräumen stattfinden, die sich klassischen Erhebungsverfahren entziehen. Datenspenden eröffnen hier die Möglichkeit, alltägliche und oft verdeckte benachteiligende Praktiken, die in ungleichen Geschlechterverhältnissen verankert sind, empirisch sichtbar zu machen. So zeigten präsentierte Analysen beispielsweise, dass Misogynie in Chat-Kommunikation nicht nur in einzelnen abwertenden Aussagen sichtbar wird, sondern häufig im Verlauf der Interaktion ähnliche Dynamiken erzeugt. Veranschaulicht wurde dies anhand typischer Sequenzen von Kontaktaufnahme, Ablehnung oder Beendigungsversuch, anschließendem Nachsetzen und Herabwürdigen als Machtdemonstration. Konzepte wie „Unwanted Pursuit Behavior“, „Misogynistic Backlash“ oder „Freezing“ systematisierten, wie Kontrolle, Abwertung und Einschüchterung kommunikativ hergestellt werden.

Zugleich zeigte der Beitrag, welche methodischen und ethischen Herausforderungen mit der Analyse privater Kommunikationsräume verbunden sein können. So muss die Datenspende niedrigschwellig organisiert sein, gleichzeitig aber die Datensouveränität der spendenden Personen respektieren. Nach der Einreichung erfolgt eine irreversible Anonymisierung; die Daten werden für die Analyse aufbereitet, enthalten jedoch keine vollständigen Metadaten. Gerade weil es sich um sensible Daten handelt, stellen sich Fragen der Zugänglichkeit, Nachnutzung und Dokumentation besonders nachdrücklich.1 Auch methodische Leerstellen wurden benannt: Chats, die gelöscht wurden, können nicht untersucht werden, und die Zusammensetzung der Datenspendenden ist durch Rekrutierungswege, Bildungshintergründe und mediale Kooperationspartner:innen geprägt.

Insgesamt zeigte das erste Panel, dass Digitale Kommunikationskorpora keine neutralen Abbilder digitaler Kommunikation sind. Vielmehr sind sie Ergebnisse von Entscheidungen, Infrastrukturen, Machtverhältnissen und Praktiken. Für ihre spätere Nachnutzung reicht es daher nicht aus, Daten lediglich abzulegen. Dokumentiert werden muss auch, wie sie entstanden sind, welche Zugänge möglich waren, welche Ausschlüsse vorgenommen wurden, welche Unsicherheiten bestehen und welche rechtlichen oder ethischen Einschränkungen gelten.

Vom Korpus-Silo zur nachnutzbaren Forschungsdatenlandschaft

Das zweite Panel verschob den Fokus von der Entstehung digitaler Korpora auf ihre langfristige Nachnutzung und wurde von Lydia Riedl moderiert. Ausgangspunkt war die Beobachtung, dass viele Korpora in einzelnen Projekten entstehen und nach Projektabschluss in Datensilos verbleiben. Sie sind dann zwar für das ursprüngliche Projekt nutzbar, werden aber für andere Forschende kaum auffindbar, sind unzureichend dokumentiert oder können aus rechtlichen, ethischen oder technischen Gründen nicht geteilt oder mit anderen Daten verknüpft werden. Alle Beiträge griffen dabei einzelne oder mehrere der FAIR-Prinzipien2 (findable, accessible, interoperable, reusable) auf und übertrugen sie auf die besonderen Bedingungen digitaler Kommunikationskorpora.

Vincent Fröhlich (Universität Erlangen-Nürnberg) eröffnete das Panel mit einem Beitrag zu infrastrukturellen Bedarfen der Forschung mit Daten aus sozialen Medien im Bereich Demokratie- und Rechtsextremismusforschung. Er betonte, dass die Volatilität von Plattformdaten eine zentrale Herausforderung darstellt. Inhalte werden gelöscht, Accounts verschwinden, Schnittstellen ändern sich, Zugänge werden eingeschränkt. Was heute erhoben werden kann, ist morgen möglicherweise nicht mehr verfügbar. Für die Forschung bedeutet dies, dass Fragen der Sicherung, Dokumentation und Nachvollziehbarkeit frühzeitig mitgedacht werden müssen.

Besonders betonte Fröhlichs Beitrag, dass Sicherheit in diesem Forschungsfeld mehrdimensional ist. Es geht nicht nur um die Sicherheit der Daten selbst, sondern auch um die Sicherheit der Forschenden und der beforschten Personen. Wer zu Rechtsextremismus, Desinformation oder demokratiegefährdender Kommunikation forscht, kann selbst zur Zielscheibe werden. Forschungsinfrastrukturen müssen neben der Auffindbarkeit und Nachnutzung von Daten auch Schutzräume, Zugriffskontrollen und gut reflektierte Formen der Sichtbarkeit mitdenken. In der Diskussion wurde die Spannung zwischen wissenschaftlicher Sichtbarkeit, die insbesondere für Qualifikations- und Karrierewege wichtig ist, und dem Schutz von Forschenden thematisiert. Hier zeigte sich, dass Infrastrukturen auch institutionelle Sensibilisierung und Schutzmechanismen unterstützen können.

Birte Kuhle (Center for Advanced Internet Studies) griff die Frage nach nachnutzbaren Daten aus der Perspektive des Forschungsdatenlebenszyklus auf. Ihr Beitrag zu praktischen Herausforderungen im Umgang mit Daten aus sozialen Medien zeigte, dass Forschungsdatenmanagement nicht erst am Ende eines Projekts beginnt. Bereits in der Phase „Discover, Plan & Design“ stellen sich Fragen des Samplings, der Plattformauswahl sowie zu ihren jeweiligen Beschränkungen, der Datenzugänge und der rechtlichen Rahmenbedingungen. In der Phase der Datenerhebung können geplante Zugänge, etwa über Plattform-APIs, kurzfristig wegfallen. Forschende müssen dann alternative Wege wie Datenspenden oder Webscraping prüfen, die wiederum eigene ethische und rechtliche Fragen aufwerfen.

Auch die Verarbeitung und Analyse von Daten aus sozialen Medien ist mit erheblicher Datenarbeit verbunden. Daten müssen bereinigt, strukturiert, mit IDs versehen, versioniert und dokumentiert werden. Multimodale Daten erhöhen den Aufwand zusätzlich, weil Text, Bild, Audio und Video unterschiedliche Formate, Werkzeuge und Dokumentationslogiken erfordern. Für die Phase „Publish, Archive & Share“ stellte Kuhle die Frage, was überhaupt veröffentlicht werden darf, welche Teile eines Datensatzes zugänglich gemacht werden können und wie FAIR-Prinzipien unter Bedingungen eingeschränkter Teilbarkeit umgesetzt werden können.

Als zentrale take-aways formulierte Kuhle, dass die Arbeit mit Social-Media-Daten technische, methodische sowie rechtlich-ethische Kompetenzen verlangt und häufig mit hohem Ressourcenaufwand bei zugleich fehlenden Unterstützungs- und Anreizstrukturen verbunden ist. FAIR-Prinzipien, Community-Standards und Forschungsdateninfrastrukturen erscheinen vor diesem Hintergrund nicht als nachgelagerte Formalia, sondern als Voraussetzung dafür, Social-Media-Daten transparenter, nachvollziehbarer und nachnutzbarer zu machen. Die Diskussion zeigte darüber hinaus, dass Metadatenstandards, Codeveröffentlichung und Dokumentationspraktiken bislang noch nicht einheitlich etabliert sind.

Philipp Knöpfle (LMU München) widmete sich mit Blick auf das Projekt „Meta-Rep“ der Reproduzierbarkeit und Replizierbarkeit computationaler Kommunikationsforschung. Anhand eines Literaturreviews zu mehreren hundert Studien zeigte er, dass Daten und Code in der CCS bislang nur selten systematisch geteilt werden. Besonders problematisch ist dies bei Plattformdaten, da sie sich oft nur schwer oder gar nicht replizieren lassen. Wenn Datenzugänge eingeschränkt sind, Plattformen Inhalte löschen oder Schnittstellen verändern, kann eine spätere Replikation schnell unmöglich werden.

Knöpfle unterschied dabei zwischen Reproduzierbarkeit und Replizierbarkeit und zeigte, dass beide Ziele unterschiedliche Anforderungen an Daten, Code und Dokumentation stellen. Selbst wenn Rohdaten aus rechtlichen oder praktischen Gründen nicht geteilt werden können, können Begleitmaterialien oder Metadaten durchaus hilfreich dabei sein, Studienergebnisse besser einzuordnen. Hierzu zählen die Veröffentlichung von Code, die Dokumentation der Datenerhebung, die Beschreibung von Samplingentscheidungen, die Offenlegung von Preprocessing-Schritten und die Angabe von Tools inklusive Parametern und Versionierung. In der Diskussion kam auf, dass die Wahl geeigneter Ablageorte ebenfalls eine praktische Frage ist. Während Plattformen wie The Open Science Framework (OSF) zum Zeitpunkt des Workshops vielen Forschenden niedrigschwelliger erschienen3, bieten institutionelle Git-Infrastrukturen andere Vorteile, setzen aber höhere technische Kompetenzen voraus.

Eine verbindende Klammer über die Beiträge im zweiten Panel hinweg war, dass Nachnutzbarkeit nicht zwingend vollständige Offenlegung aller Daten bedeutet. Gerade digitale Kommunikationsdaten sind häufig sensibel, rechtlich geschützt oder plattformabhängig. Umso wichtiger sind gestufte Zugangsmodelle, umfängliche und verständliche Dokumentation, sowie die Sicherung von Kontextinformationen. Auch nicht vollständig teilbare Korpora können wertvoll für die Forschung bleiben, wenn nachvollziehbar ist, wie sie entstanden sind, welche Analysen mit ihnen durchgeführt wurden und unter welchen Bedingungen andere Forschende daran anschließen können.

Vernetzte Kommunikationskorpora analysieren: Potenziale und Fallstricke

Das dritte Panel wurde von Kai Matuszkiewicz moderiert und richtete den Blick auf die Analyse vernetzter Kommunikationskorpora. Welche neuen Forschungsperspektiven entstehen, wenn digitale Kommunikationsdaten gut dokumentiert, referenzierbar und miteinander verknüpfbar sind? Und welche methodischen Voraussetzungen müssen erfüllt sein, damit großskalige, plattformübergreifende und KI-gestützte Analysen valide Ergebnisse liefern?

Marko Bachl (FU Berlin) eröffnete das Panel mit einem Beitrag zu Bias und epistemischen Konsequenzen für die CCS. Ausgangspunkt war ein statistisches Verständnis von Bias als systematischem Fehler, der von zufälliger Varianz zu unterscheiden ist. Der Bias-Variance-Tradeoff diente dabei als analytisches Raster, um Chancen und Risiken automatisierter Verfahren in der Kommunikationsforschung einzuordnen.

Am Beispiel von Large Language Models (LLMs) in der Inhaltsanalyse zeigte Bachl, dass automatisierte Verfahren neue Möglichkeiten eröffnen. So können sie beispielsweise nicht-textuelle Kommunikationsinhalte transkribieren, Inhalte extrahieren, große Stichproben klassifizieren und damit Analysen ermöglichen, die hand-codiert kaum durchführbar wären. Zugleich können sie die Reproduzierbarkeit erhöhen, weil dieselben Verfahren auf große Datenmengen konsistent angewendet werden können. Diese Reduktion von Varianz geht jedoch nicht automatisch mit einer Reduktion von Bias einher. Im Gegenteil: Automatisierte Verfahren können systematische Verzerrungen erzeugen oder verstärken, wenn Trainingsdaten, Modellarchitekturen, Prompts oder Validierungsmaßstäbe bestimmte Perspektiven privilegieren.

In der anschließenden Diskussion wurde dafür plädiert, dass die Bewertung von KI-gestützten Verfahren nicht abstrakt erfolgen kann. Entscheidend ist, welches Forschungsziel verfolgt wird, welcher Referenzmaßstab angesetzt wird und welche Formen von Fehlern in Kauf genommen werden wollen. Menschliche Codierungen sind dabei nicht automatisch ein unverzerrter Goldstandard, sondern selbst Ergebnis sozialer Umstände sowie methodischer und interpretativer Entscheidungen. Gerade deshalb braucht die CCS eine explizite Auseinandersetzung mit Validierung, Bias, De-Biasing und den epistemischen Annahmen automatisierter Analyseverfahren.

Felix Victor Münch (GESIS/HBI) knüpfte mit seinem Beitrag an die forschungspraktischen Potenziale von LLMs an. Im Zentrum stand die Frage, wie diese zur plattform-, medien- und sprachübergreifenden Verknüpfung von Kommunikationsdaten eingesetzt werden können. Münch zeigte anhand mehrerer Anwendungsbeispiele, dass LLMs nicht nur als dialogische Systeme verstanden werden sollten, sondern als Werkzeuge zur Strukturierung, Transformation, Klassifikation und Verknüpfung großer, heterogener Datenbestände.

Ein Beispiel bezog sich auf die plattformübergreifende Analyse von Kommunikation zu Klimawandel, Desinformation und rechtsextremen Diskursen. Hier wurden große Datenmengen über längere Zeiträume hinweg erhoben und mit Verfahren wie Embeddings, Clustering und Netzwerkanalysen ausgewertet. Ein weiteres Beispiel stellte die Analyse von politischer Kommunikation in TikTok-Videos dar. Semantische Ähnlichkeitsmodelle wurden genutzt, um Themenprofile, Nähebeziehungen und Kommunikationsstrukturen zwischen unterschiedlichen Akteur:innen sichtbar zu machen.

Die Beispiele zeigten anschaulich, welche analytischen Möglichkeiten entstehen können, wenn Daten aus unterschiedlichen Plattformen, medialen Formen und Sprachen in gemeinsame Repräsentationsräume überführt werden können. Dadurch werden Vergleiche möglich, die zuvor nur mit erheblichem manuellem Aufwand oder überhaupt nicht realisierbar waren. Zugleich zeigte Münch, dass solche Pipelines technisch und organisatorisch voraussetzungsreich sind. Sie erfordern Rechenressourcen, methodisches Know-how, sorgfältige Datenaufbereitung und Verfahren zur Qualitätskontrolle. LLMs können solche Prozesse perspektivisch vereinfachen, ersetzen aber nicht die Notwendigkeit, Datenkontexte, Modellentscheidungen und Bewertungskriterien transparent zu dokumentieren.

Jakob Jünger (Universität Münster) schloss das Panel mit einem Beitrag zu Normdaten und Knowledge Graphs als Grundlage für Sekundäranalysen. Sein Ausgangspunkt war die Frage, wie geistes- und sozialwissenschaftliche Arbeitspraktiken stärker miteinander verbunden werden können. Während klassische Nachweis- und Katalogsysteme Literatur, Daten oder Projekte auffindbar machen, erlauben sie meist keine strukturierte Abfrage wissenschaftlicher Aussagen, Beziehungen und Kontexte. Normdaten, kontrollierte Vokabulare, Ontologien und Knowledge Graphs können hier neue Formen der Vernetzung ermöglichen.

Jünger erläuterte Normdaten als Identifier, Vokabulare und Ontologien, die Entitäten eindeutig beschreibbar und miteinander verknüpfbar machen. Knowledge Graphs bilden solche Entitäten und ihre Beziehungen als Netzwerk ab. Als bekanntes Beispiel wurde Wikidata herangezogen. Für die Kommunikationswissenschaft skizzierte Jünger drei mögliche Beteiligungsformen: bestehende Datensätze können mit Normdaten angereichert werden, bestehende Wissensbestände können um neue fachlich relevante Entitäten erweitert werden, und fachnahe Infrastrukturen können eigene Knowledge Graphs aufbauen und betreiben.

Besonders relevant wurde diese Perspektive im Hinblick auf Interoperabilität. Daten werden nicht allein dadurch FAIR, dass sie irgendwo abgelegt werden. Sie müssen auffindbar, zugänglich, interoperabel und nachnutzbar beschrieben sein. Für die Kommunikations- und Medienwissenschaft eröffnet dies erhebliche Potenziale. Forschungsprojekte, Datensätze, Publikationen, Tagungsbeiträge, Personen, Institutionen, Quellen, Methoden und Untersuchungsgegenstände könnten miteinander verknüpft werden. Damit würde nicht nur die Recherche verbessert, sondern auch die Grundlage für Sekundäranalysen, fachgeschichtliche Auswertungen und neue Formen der Wissensrepräsentation geschaffen.

Das dritte Panel zeigte insgesamt, dass vernetzte Kommunikationskorpora große Analysepotenziale eröffnen können. LLMs, computationale Methoden, Normdaten und Knowledge Graphs ermöglichen neue Perspektiven auf Kommunikationsdynamiken über Plattform-, Medien-, Sprach- und Zeitgrenzen hinweg. Zugleich wurde sichtbar, dass diese Potenziale sich nur dann in wissenschaftlich belastbare Ergebnisse verwirklichen lassen, wenn Datenqualität, Validierung, Interoperabilität, Dokumentation und Bias systematisch reflektiert werden.

Fünf zentrale Erkenntnisse des Workshops

Über alle drei Panels hinweg zog sich der Befund, dass digitale Kommunikationskorpora keine bloßen Sammlungen neutraler Daten sind. Sie entstehen durch soziale, rechtliche, wissenschaftliche, technische und ethische Entscheidungen sowie durch die Bedingungen ihrer Erhebung, Verarbeitung und Aufbereitung. Ihre Qualität bemisst sich daher nicht allein an Umfang oder technischer Verfügbarkeit, sondern an der Nachvollziehbarkeit ihrer Entstehung, Prozessierung und Kontextualisierung.

Eine zweite zentrale Erkenntnis war, dass diese Bedingungen der Datenentstehung systematischer dokumentiert werden müssen. Dazu gehören Plattformbedingungen, Zugangspfade, Samplingentscheidungen, Löschungen und Ausschlüsse, fehlende Daten, Anonymisierungsschritte, Metadatenverluste und ethische Abwägungen. Gerade bei Daten aus sozialen Medien, Datenspenden oder digitalisierten Quellen ist entscheidend, welche Teile der Kommunikation sichtbar werden, welche unsichtbar bleiben und wie diese Einschränkungen der Datenbasis nachvollziehbar gemacht werden können.

Drittens zeigte sich, dass Nachnutzung nicht mit vollständiger Offenheit gleichgesetzt werden darf. Viele digitale Kommunikationsdaten können aus guten Gründen nicht frei zugänglich gemacht werden. Trotzdem können sie durch beschreibende Metadaten, Code, Dokumentationen, Analyseprotokolle, kontrollierte Zugangsmodelle oder Verweise auf geeignete Kontaktstellen wissenschaftlich anschlussfähig bleiben.

Viertens wurde die Bedeutung von Interoperabilität sichtbar. Wenn Forschungsdaten, Publikationen, Projekte, Personen, Institutionen, Quellen und Methoden isoliert voneinander dokumentiert werden, bleiben viele Anschlussmöglichkeiten ungenutzt. Entitätenbasierte Modelle, Normdaten und Knowledge Graphs können dazu beitragen, Forschungsergebnisse nicht nur abzulegen, sondern in fachliche Zusammenhänge durch die Nutzung von Semantic-Web-Anwendungen einzubetten.

Eine fünfte zentrale Erkenntnis liegt darin, dass Infrastrukturen nicht erst am Ende des Forschungsprozesses relevant werden. Sie können bereits in der Planungsphase helfen, Datenerhebungen besser zu koordinieren, rechtliche und ethische Fragen frühzeitig zu klären, Dokumentationsstandards mitzudenken und spätere Nachnutzung vorzubereiten.

Perspektiven für die Arbeit des FID Media

Für den FID Media ergaben sich aus dem Workshop mehrere konkrete Handlungsfelder, die bereits in der von Lukas Hohendorf moderierten Abschlussdiskussion aufgegriffen wurden und in der weiteren strategischen Entwicklung geprüft und mit der Fachcommunity vertieft werden sollen.

Ein erstes mögliches Handlungsfeld liegt in der Entwicklung fachspezifischer Dokumentationsvorlagen für digitale Kommunikationskorpora. Diese sollten gemeinsam mit Forschenden erarbeitet werden und unterschiedliche Datentypen berücksichtigen: Plattformdaten, Chatdaten, journalistische Inhalte, audiovisuelle Materialien, digitalisierte Quellen und multimodale Korpora. Solche Vorlagen könnten Mindestangaben zu Datenherkunft, Erhebungswegen, Sampling, Plattformbedingungen, Preprocessing, Versionierung, Anonymisierung, rechtlichen Grundlagen und Nutzungsrechten, Zugangsbedingungen und möglichen Verzerrungen enthalten. Ziel wäre keine zusätzliche Bürokratie, sondern eine praxistaugliche Unterstützung für Forschende, die ihre Daten nachvollziehbar und nachnutzbar dokumentieren möchten. In der Entwicklung derartiger Vorlagen liegt eine Zusammenarbeit mit NFDI-Konsortien nahe, wie sie bereits in der Vergangenheit gepflegt wurde, insbesondere mit dem von NFDI4Culture, Text+, BERD@NFDI und KonsortSWD getragenen Arbeitskreis Social Media-Daten in der Forschungspraxis.

Ein zweites Handlungsfeld betrifft den Aufbau einer fachnahen Nachweis-, Register- und Vermittlungsinfrastruktur für digitale Kommunikationskorpora. Ein solches Angebot könnte geplante, laufende und abgeschlossene Korpusvorhaben in der Kommunikations- und Medienwissenschaft sichtbar machen: Welche Projekte erheben oder nutzen Daten zu welchen Plattformen, Quellen, Zeiträumen und Themen, mit welchen Methoden und unter welchen Zugangsbedingungen? Besonders vielversprechend wäre dabei eine Funktion für geplante Datenerhebungen. Forschende könnten Vorhaben frühzeitig eintragen, wodurch sich Kooperationsmöglichkeiten erkennen lassen, bevor Daten mehrfach, inkompatibel oder unter hohem Aufwand parallel erhoben werden. Zugleich könnte der FID Media abgeschlossene Projekte, Datensätze, Publikationen, Codebooks, Präsentationen, Personen, Einrichtungen, Methoden und Einträge in externen Repositorien fachlich erschließen und miteinander verknüpfen. Der FID Media müsste dafür nicht alle Daten selbst speichern, sondern Daten könnten dort öffentlich publiziert, archiviert oder kontrolliert zugänglich gemacht werden, wo die jeweils geeigneten technischen und rechtlichen Voraussetzungen bestehen. Der FID Media könnte durch ein zentrales Forschungsregister ergänzend dafür sorgen, dass diese Ressourcen für die Kommunikations- und Medienwissenschaft sichtbar, verständlich kategorisiert und mit weiteren fachlichen Informationen verknüpft werden. Das entitätenbasierte Modell des Repositoriums des FID Media bietet hierfür eine vielversprechende Grundlage und könnte perspektivisch einen Beitrag zu potenziellen fachlichen Wissensgraphen der Kommunikations- und Medienwissenschaft leisten.

Ein drittes Handlungsfeld besteht in der Weiterentwicklung von Beratung und Vernetzung von Forschenden mit Infrastrukturen. Der Workshop zeigte, dass Forschende bei digitalen Kommunikationskorpora regelmäßig mit rechtlichen, ethischen und technischen Fragen konfrontiert sind: Was darf erhoben werden? Was darf gespeichert, geteilt oder veröffentlicht werden? Welche Teile eines Datensatzes können offen zugänglich sein, welche nur kontrolliert, welche gar nicht? Welche Dokumentation ist sinnvoll, wenn Daten nicht geteilt werden können? Hier prüft der FID Media, in seinen bestehenden Beratungsangeboten, etwa zu Urheberrecht, Open Access, Open Science und Forschungsdatenmanagement, noch stärker die spezifischen Bedarfe digitaler Kommunikationsforschung zu berücksichtigen.

Fazit

Der Workshop hat gezeigt, dass die Frage „Was bleibt von digitalen Kommunikationskorpora?“ nicht erst nach Projektende gestellt werden sollte. Sie beginnt bereits bei der Auswahl von Quellen, Plattformen und Zugängen, setzt sich in Sampling, Datenerhebung, Datenbereinigung und Analyse fort und reicht bis zur Publikation, Archivierung und späteren Nachnutzung. Digitale Kommunikationskorpora sind nur dann langfristig wissenschaftlich wertvoll, wenn ihre Entstehungsbedingungen, ihre Einschränkungen und ihre Nutzungskontexte nachvollziehbar bleiben.

Für die Kommunikations- und Medienwissenschaft ergibt sich daraus eine doppelte Herausforderung. Einerseits eröffnen digitale Korpora neue Forschungsperspektiven, etwa auf schwer zugängliche Kommunikationsräume, langfristige Medienentwicklungen, plattformübergreifende Diskurse oder multimodale Kommunikationsdynamiken. Andererseits entstehen neue Anforderungen an Quellenkritik, Datenethik, Dokumentation, Reproduzierbarkeit, Interoperabilität und Infrastrukturen.

Der FID Media nimmt aus dem Workshop den Auftrag mit, diese Fragen gemeinsam mit der Fachcommunity weiterzuverfolgen. Ziel ist es, digitale Kommunikationskorpora nicht nur als projektgebundene Datensammlungen zu betrachten, sondern als potenziell vernetzte Forschungsressourcen, die zukünftige Forschung vorbereiten, erleichtern und sichtbar machen können. Entscheidend wird sein, hierfür niedrigschwellige, fachnahe und zugleich methodisch passende Angebote zu entwickeln. Diese reichen von der Beratung in der Planungsphase über Standards in der Dokumentation und der Registrierung laufender Vorhaben bis hin zur Unterstützung bei der Publikation, Verzeichnung und Vernetzung abgeschlossener Projekte.

Der Workshop hat damit den Blick weg vom einzelnen Korpus hin auf die Voraussetzungen seiner wissenschaftlichen Anschlussfähigkeit gelenkt. Für Open Science in der Kommunikations- und Medienwissenschaft folgt daraus, dass nicht allein entscheidend ist, ob Daten veröffentlicht werden können, sondern ob ihre Herkunft, Reichweite, Einschränkungen und Beziehungen so beschrieben sind, dass sie in der Forschungscommunity weitergedacht, geprüft und kombiniert werden können. Hierin liegt die künftige Infrastrukturaufgabe, die Kommunikations- und Medienwissenschaft darin zu unterstützen, aus verstreuten Projektspuren einen übersichtlichen und möglichst vollständigen Orientierungsraum zu schaffen, in dem neue Forschung nicht immer wieder bei null beginnen muss, sondern auf bereits geleistete Aufwände und vorhandene Erkenntnisse aufbauen und bestehende Ergebnisse produktiv nachnutzen kann.


1 In der Diskussion wurde außerdem die öffentliche Verfügbarkeit der Daten unter ethischen Gesichtspunkten zur Debatte gestellt, da sie sich als Trainingsmaterial für böswillige Chatbotbetreibende eignen würden.

2 Wilkinson, M., Dumontier, M., Aalbersberg, I. et al. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data 3, 160018. https://doi.org/10.1038/sdata.2016.18

3 Anmerkung: Nach dem Workshop kündigte das Center for Open Science an, den Bereich OSF Projects wegen fehlender Finanzierung auslaufen zu lassen, so dass ab November 2026 keine neuen Projekte mehr angelegt werden können. Diese Entwicklung zeigt, dass Open Science nicht allein niedrigschwellige Werkzeuge, sondern wissenschaftsgeleitete, institutionell fest verankerte und dauerhaft finanzierte Infrastrukturen benötigt, um die langfristige Verfügbarkeit von Forschungsinhalten sicherstellen und die FAIR-Prinzipien umzusetzen.

Der Text dieses Beitrags steht unter der Lizenz Creative Commons Namensnennung 4.0 International (CC BY 4.0). Die Abbildungen sind von dieser Lizenz ausgenommen; alle Rechte vorbehalten.

Karte, Wissensnetz, JSON: Wie der Datenatlas Sankt Aldegund funktioniert

作者Ben Thoma
2026年8月15日 04:02

Im ersten Teil dieser kleinen Serie begann alles mit einer Einwohnerzahl. Aus 549 wurden irgendwann 530, 526 und 580 – und aus der Frage nach der richtigen Zahl entwickelte sich Schritt für Schritt ein Datenmodell für meinen Heimatort Sankt Aldegund.

Damit entstand eine Grundlage, auf der sich sehr unterschiedliche Informationen miteinander verbinden lassen: Gebäude und Bauphasen, historische Ereignisse, Quellen, Koordinaten, Bevölkerungszahlen und Kulturorte.

Der nächste Schritt führte zurück zu dem, womit das Projekt ursprünglich einmal angefangen hatte: zur Gestaltung.

Wie wird aus all diesen Daten eine Oberfläche, auf der sich Zusammenhänge tatsächlich erkennen lassen? Wie lässt sich ein langgezogenes Moseldorf auf einer Karte erfassen? Wann hilft eine Linie, wann eine Zahl, wann ein Diagramm? Und an welchen Stellen lohnt sich auch einmal der Blick direkt in die Datenstruktur?

Genau dort treffen im Datenatlas Sankt Aldegund Datenmodellierung, Webentwicklung und Gestaltung aufeinander.

Ein Dorf zwischen Mosel und Steillage

Sankt Aldegund besitzt eine Form, die man auf der Karte sofort erkennt.

Der historische Ort zieht sich schmal zwischen Mosel und Hang entlang. Straßen, Häuser und Denkmäler folgen dieser Topografie. Für die Denkmalkarte wollte ich genau diese räumliche Struktur sichtbar machen und den verfügbaren Raum gut nutzen.

Die Koordinaten der Denkmäler liefern dafür die Grundlage.

Aus ihnen berechnet der Atlas zunächst die räumlichen Abstände. Anschließend wird die gesamte Punktgeometrie gemeinsam gedreht, sodass die Längsrichtung des Ortes in der Darstellung besser zur Geltung kommt.

Die relativen Positionen und Abstände bleiben dabei erhalten. Die Kirche bleibt neben ihren Nachbarn, die Form des Ortes bleibt dieselbe. Lediglich die Orientierung der gesamten Darstellung verändert sich.

Auch der Nordpfeil folgt dieser Drehung und zeigt weiterhin die geografische Orientierung.

So entstehen aus derselben Punktwolke zwei Ansichten: geografisch nordorientiert und für die Atlasansicht gemeinsam gedreht.

Dieselben Punkte, dieselben Abstände – eine andere Ausrichtung.

Koordinaten Sankt Aldegund

Abb. 1: Dieselben georeferenzierten Denkmalpunkte in zwei Ansichten. Für die Atlasdarstellung wird die gesamte Punktgeometrie gemeinsam gedreht; relative Positionen und Abstände bleiben erhalten.

Wenn fünf Denkmäler sehr eng zusammenrücken

Im historischen Ortskern liegen manche Denkmäler dicht beieinander.

Auf der Karte können dadurch mehrere Marker auf wenigen Pixeln zusammentreffen. Der Atlas fasst sie in solchen Situationen vorübergehend zu einer Gruppe zusammen.

Steht beispielsweise eine 5 in einem Marker, liegen dort fünf einzelne Objekte dicht beieinander.

Mit zunehmender Vergrößerung lösen sie sich wieder in ihre einzelnen Punkte auf.

Im Datenbestand bleiben währenddessen fünf eigenständige Objekte mit fünf eigenen Kennungen und fünf eigenen Koordinaten erhalten. Die Karte wählt abhängig von Maßstab und verfügbarem Raum eine passende Darstellung dafür.

Dieses kleine Detail zeigt sehr anschaulich, wie Datenstruktur und Benutzeroberfläche zusammenspielen.

45 / 45 und 10 / 45 erzählen unterschiedliche Geschichten

Bei den Denkmal-Daten stieß ich auf eine andere gestalterische Frage.

Einige Eigenschaften sind nahezu vollständig dokumentiert, andere bei einem kleineren Teil der Objekte.

Der Datenbestand sieht beispielsweise so aus:

45 / 45 – Bauform
44 / 45 – Material
43 / 45 – Koordinaten
10 / 45 – ausdrücklich genannte Stilzuordnung

Diese vier Zahlen sehen ähnlich aus. Für eine Auswertung beschreiben sie jedoch sehr unterschiedliche Datengrundlagen.

Bei der Bauform steht der vollständige Denkmalbestand zur Verfügung. Eine Auswertung der Stilzuordnungen basiert dagegen auf zehn entsprechend beschriebenen Objekten.

Bei analytischen Kennzahlen führt der Atlas deshalb Ergebnis, Grundgesamtheit sowie vorhandene und fehlende Werte gemeinsam.

So bleibt bei jedem Prozentwert unmittelbar erkennbar, auf welcher Datengrundlage er beruht.

Datenabdeckung Einzeldenkmäler

Abb. 2: Datenabdeckung im Denkmalbestand. Bauform, Material, Koordinaten und Stilzuordnung sind unterschiedlich dicht erfasst – eine wichtige Bezugsgröße für spätere Auswertungen.

Auch „nicht datiert“ erzählt etwas über den Ort

Für zwei bestehende Einzeldenkmäler ist derzeit keine belastbare veröffentlichte Datierung bekannt.

Im Atlas stehen sie entsprechend als:

nicht datiert

Auch das gehört zur Beschreibung des Datenbestands.

Eine Jahrhundertsauswertung zeigt damit neben den bekannten Zeitangaben zugleich, wie vollständig die zeitliche Einordnung der Gebäude derzeit möglich ist.

Ähnlich verhält es sich bei historischen Bevölkerungszahlen. Zwischen manchen überlieferten Werten liegen Jahre oder Jahrzehnte. Die Abstände zwischen den Datenpunkten gehören ebenso zur Geschichte der Daten wie die Zahlen selbst.

Solche Lücken zeigen, an welchen Stellen die Quellenlage dicht ist und wo weitere Recherche noch neue Erkenntnisse bringen kann.

Eine Kirche, zwölf Ereignisse und viele Wege durch die Geschichte

Schon im ersten Teil spielte die Alte katholische Pfarrkirche St. Bartholomäus eine wichtige Rolle.

Im Datenmodell trägt sie die Kennung:

SA-KD-004

Mit diesem einen Datensatz sind zahlreiche historische Ereignisse verbunden.

Eines davon ist:

EV-007

die erste belegte Kirche an diesem Ort im Jahr 1144.

Das Ereignis wiederum verweist auf die Quellen, aus denen sich diese Aussage ableitet.

Damit entsteht zunächst eine einfache Kette:

Kirche → Ereignis → Quelle

Bei derselben Kirche wiederholt sich dieses Prinzip über viele Jahrhunderte.

1522 kommt der „Christus in der Rast“ hinzu.
1601 die Stiftung des Rultz-Altars.
1762/63 der Umbau der Kirche.
nach Oktober 1872 die Profanierung.
1967–1971 die Restaurierung.
3. Oktober 1971 die erneute Weihe.

Aus einer Kirche wächst so ein historischer Knotenpunkt.

Genau diese Struktur bildet das Wissensnetz grafisch ab. Eine Linie steht dort für eine Beziehung, die im Datenbestand hinterlegt ist. Aus Kennungen und Verweisen entsteht auf dem Bildschirm ein Netz aus Bauwerken, Ereignissen, Kulturorten und Quellen.

Beziehungsmodell Alte Kirche St. Aldegund

Abb. 3: Ein Ausschnitt aus dem Beziehungsmodell der Alten Kirche. Von SA-KD-004 führen gespeicherte Verknüpfungen zu historischen Ereignissen und von dort zu den jeweils hinterlegten Quellen.

Dieselben Daten, andere Fragen

Besonders deutlich wird die Rolle der Gestaltung bei den Bevölkerungsdaten.

Eine Zeitreihe zeigt, wie sich die Einwohnerzahl über Jahrzehnte entwickelt hat.

Eine Altersstruktur zeigt, wie sich die Bevölkerung zu einem bestimmten Zeitpunkt zusammensetzt.

Und die im ersten Beitrag beschriebenen Zahlen 530, 526 und 580 erzählen wiederum etwas über unterschiedliche Stichtage, Quellen und Erhebungszusammenhänge.

Jede dieser Darstellungen greift auf Daten über denselben Ort zurück und stellt eine andere Frage an sie.

Das gilt ebenso für die Gebäudestatistik. 224 Gebäude mit Wohnungen lassen sich als Gesamtzahl nennen. Eine Gruppierung nach einer, zwei oder mehreren Wohnungen zeigt zusätzlich die innere Struktur dieses Bestands.

Auswahl, Reihenfolge, Gruppierung, Abstände und Beschriftungen formen so unterschiedliche Ansichten auf denselben Datenbestand.

Ein Blick unter die Oberfläche

An dieser Stelle darf es ein wenig technischer werden.

Hinter Karten, Zeitreihen und Verbindungen stehen strukturierte Datensätze. Die Alte Kirche sieht in stark gekürzter Form beispielsweise so aus:

{
  "id": "SA-KD-004",
  "name": "Alte katholische Pfarrkirche St. Bartholomäus",
  "datierung_text": "spätes 12./frühes 13. Jahrhundert; Umbauten bis 1762/63",
  "analyseanker": 1200,
  "sources": ["S02", "S03", "S06", "S11", "S14", "S20"]
}

Das Ereignis von 1144 greift dieselbe Kennung wieder auf:

{
  "id": "EV-007",
  "jahr_von": 1144,
  "titel": "Alte Kirche erstmals erwähnt",
  "verknuepfte_objekte": ["SA-KD-004"],
  "sources": ["S06", "S11", "S14"]
}

Hier wird die Beziehung sichtbar, bevor überhaupt eine Linie gezeichnet wird.

SA-KD-004 bezeichnet die Kirche.

Im Ereignis EV-007 taucht dieselbe Kennung unter verknuepfte_objekte auf. Daneben stehen die IDs der zugehörigen Quellen.

Aus genau solchen Verweisen erzeugt der Atlas später Detailseiten, Zeitleisten und Beziehungen im Wissensnetz.

Für technisch Interessierte ist das der direkteste Blick darauf, wie der Atlas unter seiner Oberfläche funktioniert.

JSON Datenstruktur

Abb. 4: Blick in die Datenstruktur des Atlas. Die Kennung SA-KD-004 verbindet den Denkmal-Datensatz der Alten Kirche mit dem Ereignis EV-007 und den jeweils zugeordneten Quellen.

Gestaltung übersetzt Struktur

Viele Entscheidungen im Atlas beginnen im Datenmodell und enden in einer sichtbaren Form.

  • Koordinaten werden zu Punkten.
  • Zeitangaben werden zu Positionen auf einer Zeitachse.
  • Beziehungen werden zu Linien.
  • Grundgesamtheiten werden zu Diagrammen.
  • Kennungen verbinden Datensätze miteinander und führen den Besucher von einem Objekt zum nächsten.

Die Gestaltung bringt diese unterschiedlichen Ebenen in eine Form, die sich lesen, vergleichen und erkunden lässt.

So erscheint derselbe historische Ort gleichzeitig als Straßen- und Gebäudestruktur, als Folge von Ereignissen, als Quellenbestand, als JSON-Datensatz und als grafisches Beziehungsnetz.

All diese Ansichten beschreiben Sankt Aldegund aus einer anderen Richtung.

Wieder zurück nach Sankt Aldegund

Der erste Beitrag begann mit einer einfachen Ortsgrafik und einer Einwohnerzahl.

Heute lässt sich Sankt Aldegund im Atlas auf ganz unterschiedliche Weise betrachten: als Karte, als Zeitreihe, als Netz historischer Beziehungen, als Sammlung einzelner Denkmäler oder als strukturierter Datenbestand.

  • Unter einer Zahl steht ihre Datengrundlage.
  • Hinter einem Kartenpunkt stehen Koordinaten und ein Datensatz.
  • Eine Linie im Wissensnetz führt auf eine gespeicherte Beziehung zurück.
  • Jede Visualisierung eröffnet einen bestimmten Blick auf denselben strukturierten Bestand.

Damit schließt sich der Kreis zur ursprünglichen Grafik.

Damals wollte ich Sankt Aldegund auf einen Blick zeigen.

Heute kann man sich durch den Ort hindurchklicken.

Über den Autor: Ben Thoma ist Grafiker und Webprogrammierer und entwickelt seit rund 20 Jahren Websites. Sankt Aldegund ist sein Heimatort. Den Datenatlas entwickelt er als eigenes Projekt an der Schnittstelle von Gestaltung, Webentwicklung, Ortsgeschichte und strukturierten Daten.

Weiter in den Daten

530, 526 oder 580? Wie St. Aldegund zum Datenatlas wurde

作者Ben Thoma
2026年8月13日 04:14

Am Anfang stand eine Grafik über Sankt Aldegund, meinen kleinen Heimatort an der Mosel.

Ich wollte den Ort auf einen Blick zeigen: das Panorama an der Mosel, markante Gebäude, Fläche, Postleitzahl, Höhenlage, geografische Koordinaten – und natürlich die Einwohnerzahl. Für diese Grafik trug ich 549 Einwohner ein. Die Zahl hatte mir damals auf Nachfrage das Einwohnermeldeamt genannt.

Seit rund 20 Jahren entwickle ich Websites und arbeite dabei immer wieder mit strukturierten Daten. Bei Sankt Aldegund bekam diese Arbeit eine ungewöhnlich lokale Dimension. Nachdem die Grafik fertig war, wollte ich genauer wissen, wie belastbar einzelne Angaben über meinen Heimatort eigentlich sind, woher sie stammen und wie sie sich miteinander in Beziehung setzen lassen.

Ausgerechnet die vermeintlich einfache Einwohnerzahl erwies sich dabei als ausgesprochen ergiebig.

Abb. 1: Mit dieser Grafik begann die Geschichte des späteren Datenatlas Sankt Aldegund. Für die Einwohnerzahl trug ich damals 549 ein – eine Angabe, die mir auf Nachfrage beim Einwohnermeldeamt genannt worden war.

2022 hat drei Einwohnerzahlen

Wer nach der Einwohnerzahl Sankt Aldegunds für 2022 sucht, kann auf mindestens drei Angaben stoßen:

530 Einwohner zählt der Zensus zum Stichtag 15. Mai 2022.

526 Einwohner weist die Bevölkerungsfortschreibung des Statistischen Landesamtes Rheinland-Pfalz zum 31. Dezember 2022 aus.

Eine landeskundliche Beschreibung bei KuLaDig nennt 580 Einwohner mit dem Zeitbezug „Stand 2022“.

530, 526 oder 580?

Der Unterschied steckt im Kontext. Der Zensus beschreibt die Bevölkerung an einem konkreten Stichtag und folgt seiner eigenen Erhebungsmethodik. Die Bevölkerungsfortschreibung nennt den amtlichen Stand zum Jahresende. Die landeskundliche Angabe bei KuLaDig – einem Informationssystem zur historischen Kulturlandschaft – stammt wiederum aus einem anderen Veröffentlichungszusammenhang.

Damit wurde für mich eine Frage immer wichtiger:

Was genau beschreibt eine Zahl – und worauf gründet sie sich?

Diese Frage wurde zum Ausgangspunkt für die Arbeitsweise des Atlas. Die drei Werte stehen dort heute bewusst nebeneinander; Stichtag, Quelle und Bezugsrahmen gehören zur jeweiligen Aussage.

Abb. 2: Gebäudestruktur im Datenatlas Sankt Aldegund. Die Visualisierung zeigt 224 Gebäude mit Wohnungen und verteilt sie nach der Zahl der enthaltenen Wohneinheiten.

Eine Zahl bringt die nächsten Fragen mit

Mit der Einwohnerzahl öffnete sich die Recherche in viele Richtungen.

Beim Christophorushaus in der Christophorusstraße 10 erzählt ein einzelnes Baujahr beispielsweise nur einen Ausschnitt seiner Geschichte:

1473 – historischer Kern
1710 – Erweiterung durch einen Nebenbau
1765 – Datierung des Wappens

Die Alte katholische Pfarrkirche St. Bartholomäus spannt einen noch größeren Zeitraum auf. Ihre Baugeschichte reicht vom späten 12. beziehungsweise frühen 13. Jahrhundert über mehrere Bauphasen bis zu Umbauten in den Jahren 1762/63.

Solche Fälle führten zu einer feineren Struktur für historische Zeitangaben. Ich erfasste die ursprüngliche Datierungsformulierung, Zeiträume und Jahrhundertzuordnungen getrennt und ergänzte dort, wo Auswertungen einen eindeutigen zeitlichen Bezugspunkt brauchten, einen Analysewert.

Aus der Datierung „spätes 12./frühes 13. Jahrhundert; Umbauten bis 1762/63“ lässt sich die Alte Kirche beispielsweise mehreren Jahrhunderten zuordnen. Für bestimmte zeitliche Analysen erhält sie zusätzlich den Analyseanker 1200.

Parallel verknüpfte ich historische Ereignisse mit den betreffenden Bauwerken, ordnete Quellen den jeweiligen Aussagen zu, ergänzte Koordinaten für räumliche Darstellungen und kennzeichnete selbst berechnete Werte als eigene analytische Ebene.

Aus immer mehr einzelnen Informationen entstand so Schritt für Schritt eine gemeinsame Struktur.

Also habe ich mir ein System gebaut

Auch das Datenmodell entwickelte sich aus den Anforderungen, die während der Arbeit am Atlas entstanden. Sobald dieselbe Kirche in Karte, Zeitleiste, historischen Ereignissen und mehreren Quellen auftauchte, brauchte ich eine eindeutige Zuordnung.

Ich entwickelte ein eigenes Kennungssystem.

Die Alte katholische Pfarrkirche St. Bartholomäus bekam beispielsweise die Kennung:

SA-KD-004

SA steht für Sankt Aldegund.
KD bezeichnet die Kulturdenkmäler.
004 identifiziert diesen Datensatz innerhalb der Gruppe.

Für andere Bereiche entstanden weitere Kürzel:

EV-007 bezeichnet ein historisches Ereignis.
S14 bezeichnet eine Quelle.
SA-KO-008 bezeichnet einen Kulturort.

Diese Kürzel sind eine eigene Konvention des Atlas. Ihre eigentliche Stärke zeigt sich dort, wo sie wieder aufeinandertreffen.

EV-007 beschreibt beispielsweise die erste belegte Kirche an diesem Ort im Jahr 1144. Dieser Ereignisdatensatz verweist auf SA-KD-004, also auf die Alte Kirche.

Zum Ereignis gehören wiederum die Quellen, auf denen die Aussage beruht.

SA-KD-004 → EV-007 → S14
Bauwerk → Ereignis → Quelle

Aus zunächst technischen Kennungen wurden damit feste Verbindungspunkte des Datenmodells.

Abb. 3: Bevölkerung im Verlauf und im Querschnitt: Jahresstände, Zensus 2022 und Altersstruktur werden im Atlas als getrennte, aber aufeinander bezogene Ansichten dargestellt.

1097 – und plötzlich wird eine Jahreszahl kompliziert

Je tiefer die Recherche in die Geschichte Sankt Aldegunds führte, desto interessanter wurden auch Angaben, die auf den ersten Blick vollkommen eindeutig wirkten.

Ein besonders gutes Beispiel ist 1097.

Der 11. Juli dieses Jahres wird traditionell mit einer frühen urkundlichen Erwähnung Sankt Aldegunds verbunden. Die entsprechende Besitzbestätigung Erzbischof Egilberts ist als Nr. 392 im Mittelrheinischen Urkundenbuch überliefert.

Für eine Zeitleiste erscheint das zunächst wunderbar eindeutig:

1097 → Erwähnung → Urkunde

Bei der genaueren Beschäftigung mit der Quelle kommt eine weitere Ebene hinzu.

Der Diplomatiker Theo Kölzer – also ein Wissenschaftler, der historische Urkunden untersucht – ordnet das Dokument als Spurium ein. In der Urkundenforschung bezeichnet man damit ein Schriftstück, dessen überlieferter Entstehungszeitpunkt und tatsächliche Herstellung auseinanderliegen.

Kölzer untersucht dafür unter anderem die Schrift. Diese Methode heißt Paläographie: Historische Handschriften lassen sich anhand von Buchstabenformen, Abkürzungen und charakteristischen Eigenheiten einzelner Schreiber zeitlich und räumlich einordnen.

Im Fall der Urkunde von 1097 erkennt Kölzer dieselbe Schreiberhand, die auch bei einer compositio von 1182 begegnet.

Plötzlich besteht die Information aus mehreren Ebenen:

1097 – das überlieferte Datum
die Urkunde – die historische Überlieferung
die diplomatische Untersuchung – ihre fachliche Einordnung
der Ereignisdatensatz – die strukturierte Zusammenführung im Atlas

Das Jahr 1097 bleibt damit sichtbar. Zugleich bekommt es den Quellenkontext, der für seine historische Einordnung entscheidend ist.

Aus einer Jahreszahl wurde eine kleine Lektion darüber, wie viel Information hinter einem scheinbar einfachen Datum stecken kann.

Vier Jahre, die in keiner Quelle stehen

Manche neuen Daten entstehen direkt aus vorhandenen Angaben.

Eine Quelle zum historischen Brunnenstübchen nennt für den Bau einer Zubringerleitung den Zeitraum 2010 bis 2013.

Für bestimmte Auswertungen interessierte mich zusätzlich, wie viele Kalenderjahre dieser Zeitraum berührt:

2010 · 2011 · 2012 · 2013

Das Ergebnis lautet: vier Kalenderjahre.

Diese Vier entsteht durch meine eigene Auswertung.

Im Datenmodell behandle ich deshalb beide Angaben getrennt. Der Zeitraum 2010–2013 bleibt als Quelleninformation erhalten. Die Zahl Vier bekommt eine Kennzeichnung als analytisch abgeleiteter Wert.

Beim spätrömischen Steinkammergrab lässt sich dasselbe Prinzip über einen wesentlich größeren Zeitraum beobachten.

Die archäologische Einordnung lautet ungefähr:

300–350 n. Chr.

Daraus lässt sich für eine Analyse zusätzlich ableiten:

Zeitspanne: 50 Jahre

Quellenwert und Analysewert können so gemeinsam verwendet werden, während ihre jeweilige Herkunft erkennbar bleibt.

Für mich liegt darin ein wichtiger Teil der Datenarbeit: Auch eine sehr einfache Rechnung erzeugt eine neue Information. Deshalb sollte sich nachvollziehen lassen, wer sie erzeugt hat und aus welcher Grundlage sie entstanden ist.

Wenn 31.000 Reichsmark im Jahr 1899 auftauchen

Manchmal steckt die Quellenkritik in einem einzigen Wort.

Für den Ausbau der Wasserversorgung Sankt Aldegunds im Jahr 1899 nennt eine verwendete Quelle Kosten von 31.000 Reichsmark.

Die Währungsbezeichnung fällt aus der Zeit.

1899 galt im Deutschen Reich die Mark. Die Reichsmark löste die Mark erst 1924 als offizielle Währung ab. Die Währungsgeschichte lässt sich auch bei der Deutschen Bundesbank nachvollziehen.

Im Atlas führe ich den Betrag deshalb als:

31.000 Mark

Gleichzeitig dokumentiert der Datensatz, dass die verwendete Quelle den Begriff „Reichsmark“ nennt.

Für solche Fälle habe ich die Kennzeichnung quellenkritisch korrigiert eingeführt.

Die Quelle bleibt damit nachvollziehbar, die historische Einordnung wird präziser und auch meine redaktionelle Entscheidung ist dokumentiert.

Aus diesem und ähnlichen Fällen entwickelte sich eine einfache Regel:

Jede Veränderung an einer Quellenangabe bekommt einen nachvollziehbaren Grund – und dieser Grund gehört zum Datensatz.

Was an einer einzigen Kirche zusammenkommt

An der Alten Kirche lässt sich inzwischen fast das gesamte Prinzip des Atlas erklären.

Nehmen wir noch einmal:

SA-KD-004

die Alte katholische Pfarrkirche St. Bartholomäus.

Eine ihrer Beziehungen führt zu:

EV-007

der ersten belegten Kirche an diesem Ort im Jahr 1144.

Dieses Ereignis wiederum verweist auf die Quellen, aus denen sich die Aussage herleitet.

Damit haben wir zunächst drei Ebenen:

Kirche → Ereignis → Quelle

Doch bei derselben Kirche wiederholt sich dieses Muster.

1522 kommt mit dem „Christus in der Rast“ eine weitere historische Ebene hinzu.

1601 folgt die Stiftung des Rultz-Altars.

1762/63 wird der Umbau der Kirche erfasst.

nach Oktober 1872 ihre Profanierung.

1967–1971 die umfassende Restaurierung.

3. Oktober 1971 die erneute Weihe.

Jedes dieser Ereignisse besitzt wiederum eigene Quellenbezüge. Weitere Verbindungen führen zu Kulturorten und anderen Datensätzen.

Aus einem einzelnen Bauwerk wächst so ein Netz aus Zeitpunkten, Vorgängen, Orten und Belegen.

Genau daraus entstand später das Wissensnetz des Atlas.

Die entscheidende Frage lautete inzwischen nicht mehr allein:

Was weiß ich über dieses Gebäude?

Sondern auch:

Was hängt mit diesem Gebäude zusammen?

Aus einer Einwohnerzahl wurde ein Ortsmodell

In der Grafik, mit der diese Geschichte begann, steht bis heute:

549 Einwohner

Damals war das genau die Information, die ich für die Gestaltung brauchte.

Heute würde ich dieselbe Zahl zusätzlich mit ihrem Stichtag, ihrer Quelle und ihrem Erhebungszusammenhang erfassen. Ich würde sie neben andere Einwohnerzahlen stellen und sichtbar machen, welche Aussage jede einzelne von ihnen trägt.

Dieser Unterschied beschreibt ziemlich genau die Entwicklung des Projekts.

Aus Angaben wurden Datensätze. Datensätze bekamen eindeutige Kennungen. Gebäude erhielten mehrere Zeitebenen. Ereignisse wurden mit ihren Quellen verbunden. Eigene Berechnungen bekamen eine dokumentierte Herkunft. Quellenkritische Entscheidungen fanden ihren Platz direkt im Datenbestand.

Aus all diesen Schritten entstand ein Modell, mit dem sich Sankt Aldegund über Zeit, Raum, Quellen und Beziehungen erschließen lässt.

Die 549 in meiner ursprünglichen Grafik waren eine Zahl.

Im Datenatlas wäre dieselbe Zahl heute eine Information mit Herkunft, Zeitpunkt und Kontext.

Dazwischen liegt die Geschichte dieses Projekts.

Im zweiten Teil: Wenn Daten sichtbar werden

Mit dem Datenmodell entstand eine neue gestalterische Aufgabe: Wie werden diese Strukturen auf dem Bildschirm verständlich?

Im zweiten Teil geht es deshalb um die Karten des Atlas, um Wissensnetze und Diagramme, um unterschiedlich dicht belegte Datenbereiche – und um einen Blick direkt in die technische Struktur einzelner Datensätze.

Oder anders gesagt:

Was passiert, wenn aus einem Datenmodell eine Benutzeroberfläche wird?

Über den Autor: Ben Thoma ist Grafiker und Webprogrammierer und entwickelt seit rund 20 Jahren Websites. Sankt Aldegund ist sein Heimatort. Den Datenatlas entwickelt er als eigenes Projekt an der Schnittstelle von Gestaltung, Webentwicklung, Ortsgeschichte und strukturierten Daten.

Weiter in den Daten

Universität Heidelberg: Research Data Engineer 100% E13 (w/m/d)

2026年8月3日 16:38

Heidelberg University is a comprehensive university with a strong focus on research and international standards. With around 32,200 students and 9,540 employees, including numerous top researchers, it is a globally respected institution that also has outstanding economic significance for the Rhine-Neckar metropolitan region.

The Heidelberg Center for Digital Humanities is one of Germany′s leading institutions in the fields of digital and computational humanities. Its key areas of focus are digital linguistics, digital heritage, and AI/machine learning. Thanks to its close ties with the Interdisciplinary Center for Scientific Computing (IWR), the HCDH pursues the computational humanities with particular intensity.

The Research Data Engineer full-time position (E13, 100%) for a term of 4 years, with the option to extend is available at the Heidelberg Center for Digital Humanities (HCDH) starting December 1, 2026 (or earliest possible).

Your responsibilities:

  • Bridging the gap between cultural heritage data and advanced computational research: Design and build data storage layers and data processing pipelines that enable our humanities researchers to create and analyze massive, heterogeneous datasets (including legacy data)—ranging from historical texts and archives to multimedia, 3D and spatial data
  • Research Collaboration: Act as the technical consultant for humanities scholars, translating complex research questions into viable computational and database requirements
  • Data Pipelines: Design, implement, and maintain scalable pipelines to ingest, clean, and harmonize diverse cultural heritage and other data and create interoperable datasets for research
  • Data architecture: Design, implement, and maintain data structures and connect to existing data storage layers and infrastructure
  • Semantic Web & Knowledge Graphs: Develop and optimize graph databases, ontologies, and semantic models (e.g., using RDF, OWL, CIDOC-CRM) to interconnect complex historical and cultural data
  • Tool Development & Automation: Build custom APIs, and scripts (primarily in Python) to automate data ingestion, text-mining, and natural language processing (NLP) workflows
  • FAIR and FAIR4RS principles: Collaborate with the Research Data Unit and Scientific Software Center and its Data Science Unit at the IWR, and the University Computing Centre (HPC and storage infrastructure)

Your profile:

  • Education & Background: Preferably a PhD, but MA/MSc are encouraged to apply
  • Soft Skills: Strong communication skills to effectively collaborate across interdisciplinary teams of software engineers and traditional humanities scholars
  • Core Tech Stack: Excellent knowledge of Python (plus libraries like Open3D, Pandas, SpaCy, or NLTK) and version control using Git, experience with Rust and/or PyTorch is a plus
  • Database & Semantic Web Skills: Strong experience with databases (e.g., Neo4j, GraphDB, NoSQL, SQL) and semantic web technologies (e.g., SPARQL, JSON-LD)
  • DH Standards: Ideally knowledge of text encoding standards (e.g., TEI-XML) and metadata schemas (e.g., Dublin Core, MODS, LIDO); desirable: Experience with working with humanities’ data
  • Independent and structured work style, ability to work in teams and to fixed timelines
  • Language requirements: Very good English language skills, desirable: basic German skills

We offer:

  • The opportunity to work at the cutting edge of digital and computational humanities using modern AI and data engineering methods
  • Work in an innovative environment with the opportunity of professional training and qualification in the emerging professional field of research data engineering
  • A highly collaborative, interdisciplinary, and international research environment
  • Support for active contributions to the Open Source and Digital Humanities communities
  • Excellent opportunities for independent research and further academic training
  • Flexible working hours and a good work-life balance; part-time remote work is possible
  • Opportunity for further training and building a professional network by participating in national and international conferences
  • A dedicated team that supports each other
  • Workplace in the very Center of Heidelberg Altstadt with good public transport
  • Access to university sports offers
  • Support for employee mobility through a subsidized Deutschlandticket

The position is a 4-year fixed-term position with the possibility of extension. Remuneration is based on the TV-L collective agreement (pay group 13). The position is suitable for job-sharing.

We look forward to receiving your application (in English), including the following documents: cover letter, CV including a project list, proof of academic degree, employment references and list of references (2-3 names and contact details), by 14 September 2026, sent to as a single PDF file via email to nele.schneidereit@uni-heidelberg.de (max. of 25 MB).

There will be a two-stage process, with online interviews taking place in the first half of October. We will invite the remaining candidates to an in-person interview on October 23. Please save the date.

Heidelberg University stands for equal opportunities and diversity. Qualified female candidates are especially invited to apply. People with severe disabilities will be given preference if they are equally qualified. Information on job advertisements and the collection of personal data is available at www.uni-heidelberg.de/en/job-market.

Call for proposals: NFDI4Culture Art History Award (AHA)

2026年7月27日 15:29

Der NFDI4Culture Art History Award zeichnet Datenpublikationen und wissenschaftliche Arbeiten aus, die sich mit kunst- und kulturhistorischen Themen beschäftigen und dabei in besonderer Weise zu den Zielen in den Aufgabenbereichen des Konsortiums beitragen.

Unter allen Bewerbungen werden in zwei Kategorien durch die Jury der kunsthistorischen Community in NDFI4Culture bis zu fünf Einreichungen prämiert.

Einreichungszeitraum 2026: 01.07.2026–30.09.2026

Einreichungsthemen

Wir regen die Auseinandersetzung mit den Arbeitsbereichen unseres Konsortiums an und empfehlen eine Bezugnahme in der Einreichung zum Beispiel zu folgenden Schwerpunkten:

  • (Weiter-)Entwicklung von Standards für Datenformate zur Codierung kunsthistorischer bzw. kulturwissenschaftlicher (Forschungs-)Daten
  • (Weiter-)Entwicklung von Forschungssoftware für kunst- und kulturwissenschaftliche Anwendungsfälle
  • Beiträge zur nachhaltigen Archivierung und Verfügbarmachung kunst- und kulturwissenschaftlicher (Forschungs-)Daten
  • Strategien im Umgang mit Bild-, Persönlichkeits- bzw. Urheberrechtsfragen
  • Entwicklung von Ideen zur Vermittlung kunst- und kulturwissenschaftlicher (Forschungs-)Daten und Ergebnisse
  • Schaffung von Möglichkeiten und Formaten zur institutionsübergreifenden Zusammenarbeit

Kategorien

Der Award wird in den folgenden zwei Kategorien vergeben:

Kategorie 1 (Wissen teilen): bis zu 1.500 €

Eingereicht werden können in den Jahren 2025/26 abgeschlossene Qualifikationsarbeiten (M. A., Prom. und vergleichbare) und fachwissenschaftliche Aufsätze aus allen kunst- und kulturhistorischen Fachgebieten, deren Ergebnisse im Weiteren zu den Aufgabenbereichen von NFDI4Culture beitragen. Die Publikationen müssen Open Access und mit persistentem Identifier (z. B. DOI) frei verfügbar sein. 

Kategorie 2 (Daten teilen): bis zu 1.500 €

Eingereicht werden können Datenpublikationen unterschiedlicher Art von Kulturschaffenden und Wissenschaftler:innen aus allen kunst- und kulturhistorischen Fachgebieten, deren Ergebnisse im Weiteren zu den Aufgabenbereichen von NFDI4Culture beitragen und die nach den FAIR-Prinzipien veröffentlicht wurden.

Jury

Die Jury des NFDI4Culture Art History Award setzt sich zusammen aus Vertreter:innen von NFDI4Culture, dem Deutschen Verband für Kunstgeschichte, dem Arbeitskreis Digitale Kunstgeschichte und einer/einem Vertreter:in von Early Career Researchers.

Bewerbung

Sehr gerne unterstützt der Culture Helpdesk vorbereitend dabei, mögliche Anknüpfungspunkte des eigenen Projektvorschlags an die Ziele des Konsortiums zu identifizieren und herauszuarbeiten. Die Dokumentation der in der Beratung identifizierten Punkte werden in der Beurteilung der Anträge durch die Jury wertgeschätzt.

Die Bewerbung sollte folgende Unterlagen enthalten:

Kategorie 1

  1. Lebenslauf
  2. Qualifikationsarbeit  
  3. eine Darstellung des Projekts, die deutlich macht, inwiefern die Arbeit zu Zielen von NFDI4Culture beiträgt und inwiefern kunst- und kulturhistorische Daten einbezogen sind (max. 1 Seite)
  4. Übersicht über den geplanten Einsatz der Projektmittel

Kategorie 2

  1. Lebenslauf
  2. eine Darstellung der Datenpublikation, die deutlich macht, inwiefern sie zu Zielen von NFDI4Culture beiträgt und inwiefern kunst- und kulturhistorische Daten nach FAIR-Prinzipien veröffentlicht wurden (max. 2 Seiten)
  3. Übersicht über den geplanten Einsatz der Projektmittel

Bewerbungen können bis zum 30. September 2026 mit dem Betreff “NFDI4Culture Art History Award” an das Culture Coordination Office gesendet werden. Bei Fragen wenden Sie sich bitte ebenfalls an diese Adresse: coordination-office@nfdi4culture.de.

Mit der Einreichung eines Vorschlags erklären alle Teilnehmenden, dass sie die Teilnahmebedingungen gelesen und ihnen zugestimmt haben.

Alle Informationen, z. B. zum Zeitplan, den Projektmitteln und den Teilnahmebedingungen, finden sich hier: https://nfdi4culture.de/de/nachrichten/details/nfdi4culture-art-history-award-aha.html.

Aufeinander zugehen: Die Dokumentation des GND-Forums Humanities@NFDI vom 23./24. Juni 2026

2026年7月27日 14:58

Wie kann die Gemeinsame Normdatei (GND) die Zusammenarbeit der geistes- und kulturwissenschaftlichen NFDI-Konsortien stärken? Dieser Frage widmeten sich knapp 80 Teilnehmende beim GND-Forum Humanities@NFDI am 23. und 24. Juni 2026 in Göttingen.

Unter dem Motto „Aufeinander zugehen“ wurden Tools und Services mit GND-Bezug vorgestellt, unterschiedliche Perspektiven auf zentrale GND-Entitätstypen diskutiert und gemeinsam Perspektiven für eine vertiefte Zusammenarbeit entwickelt. Die Ergebnisse des Forums sind nun in drei Publikationen und einem Blogpost dokumentiert:

🔹 Zwölf Tools und Anwendungen mit GND-Bezug – eine Sammlung praktischer Steckbriefe zu Anwendungen aus den beteiligten Konsortien und der GND-Zentrale: Zur Steckbriefsammlung.
🔹 „Eine Rose ist eine Rose …“ – die Ergebnisse der Fishbowl-Diskussionen zu Geografika, Sachbegriffen, Körperschaften und Werken: Zur Dokumentation der Diskussionen.

🔹 „Eine lingua franca“ – ein Positionspapier mit fünf Thesen zur Zukunft der Zusammenarbeit und zur GND als verbindender Infrastruktur: Zum Positionspapier. Über Kommentare und Anmerkungen zum Positionspapier freuen wir uns sehr, nutzen Sie dafür bitte diesen Link.

Die Dokumentation lädt dazu ein, die Diskussionen und Ergebnisse des Forums nachzulesen und den gemeinsamen Weg zu einer stärker vernetzten geistes- und kulturwissenschaftlichen Forschungsdateninfrastruktur weiterzugehen.

Gruppenfoto GND-Forum Humanities@NFDI

Gruppenfoto GND-Forum Humanities@NFDI

Clustertreffen des N4O CC Data Capture and Creation zum Thema Culture Cloud am 8. September 2026

2026年7月27日 14:20

Am 8. September 2026, 14:30 bis 16:00 Uhr, findet das nächste Clustertreffen des CC Data Capture and Creation statt.

Dieses Mal wird unser Co-Chair Frank Dührkohp (Verbundzentrale des GBV) einen Einblick in das Projekt Culture Cloud geben.

Mit der Culture Cloud entsteht erstmals eine landesweite Kulturdateninfrastruktur für Niedersachsen, die Informationen aus Museen, Archiven, Bibliotheken und der Denkmalpflege zusammenführt. Was bislang dezentral gespeichert und oft schwer auffindbar war, wird nun über einheitliche Standards vernetzt und zentral zugänglich gemacht. So können die Daten künftig über digitale Portale leichter gefunden, miteinander verknüpft und für Forschung, Kultur und Öffentlichkeit nutzbar werden – bei voller Datenhoheit der jeweiligen Einrichtungen.

Hier sind die Zoom-Zugangsdaten:

https://dainst-org.zoom.us/j/93071809817?pwd=YVscWm2i20FHyG8hgVhcO712Wya9Vv.1

Meeting-ID: 930 7180 9817
Kenncode: 032259

Eine Anmeldung ist nicht erforderlich, wir freuen uns auf einen Austausch!

Cross-NFDI-Event Bauwerksnormdaten, 26. bis 27. August 2026, in Hannover

2026年7月14日 16:22

Am 26. und 27. August 2026 findet an der Technischen Informationsbibliothek Hannover (TIB) ein konsortienübergreifender Workshop zu Bauwerksreferenz- und Normdaten statt. Zu diesem Thema haben sich NFDI4Culture, NFDI4Objects, NFDI4ING mit weiteren Partnern in einer Special Interest Group zusammengefunden.

Das Lunch-to-Lunch-Event versteht sich als Auftaktveranstaltung, um einen fächerübergreifenden Austausch zu initiieren. Wir möchten das Thema aus unterschiedlichen Perspektiven, etwa bei der Erschließung in Sammlungen und Archiven, bei der Erfassung in Ämtern der Denkmalpflege sowie im Rahmen archäologischer und ingenieurwissenschaftlicher Forschungsprojekte in den Blick nehmen, um anhand praxisnaher Beispiele die Bedarfe, den individuellen Umgang und die aktuell tatsächlich praktizierten Modalitäten der Ansetzung zusammenzutragen. Initiativen zur automatisierten Realisierung mit Wikidata und Wikibase, Anbindung an die GND und Prozessierung per RDM-Pipeline bringen technische Perspektiven ein. Ein anschließendes Barcamp ermöglicht die Vertiefungen und Weiterentwicklung der in den Talks adressierten Aspekte. Ausgehend vom gemeinsamen Ziel, qualitativ hochwertige Referenzdaten bereitzustellen und zu nutzen, ist der Frage nachzugehen, welche Strukturen zur Verfügung stehen, welche neu geschaffen werden müssen und wie Effizienz ohne Qualitätsverlust gelingen kann. Am zweiten Tag sind alle TeilnehmerInnen eingeladen, an einer Roadmap mitzuarbeiten. Die Kleingruppen des Vortags diskutieren Strategien und Maßnahmen, die perspektivisch umgesetzt werden könnten und stellen die Ergebnisse im abschließenden Plenum vor.

Wir möchten die Veranstaltung offen gestalten und freuen uns über weitere Vorschläge für Kurzvorträge und Projektvorstellungen für den ersten Tag und auch über Themen für die Barcamp-Sessions.

NB: Die Veranstaltung ist dem Jahrestreffen der Föderation deutschsprachiger Architektursammlungen (27.–29. August 2026) vorgeschaltet, die Anmeldung gilt nur für den Cross-NFDI-Workshop.

Das vorläufige Programm und ein Link zur Anmeldung finden sich hier: https://reg.nfdi4objects.net/N4O/Bau-Norm.

Der Veranstaltungsort ist die Technische Informationsbibliothek, Hauptgebäude TechNat, Vortragssaal (Zugang über Haupteingang), Welfengarten 1 B, 30167 Hannover.

Wir freuen uns auf einen intensiven Austausch rund um das Thema Normdaten für Bauwerke.

Einladung zum Clustertreffen des N4O CC Authority Files – Die AG Archäologiethesaurus: Ein Normvokabular für die Archäologie, 12.8.2026, 13:00 Uhr

2026年7月14日 16:12

Hiermit laden wir Euch sehr herzlich zum Clustertreffen am 12. August 2026, 13:00 Uhr, mit dem Thema „Die AG Archäologiethesaurus: Ein Normvokabular für die Archäologie“ mit Victoria Biesterfeld vom LVR-Landesmuseum Bonn ein.

Für die digitale Erfassung archäologischer Bestände sind kontrollierte Vokabulare unerlässlich. Nur Objekte mit einheitlichen Bezeichnungen sind langfristig auffindbar und entsprechen den FAIR-Prinzipien guten Forschungsdatenmanagements. Während in kunst- und kulturhistorischen Disziplinen bereits seit langem anerkannte und standardisierte Thesauri existieren, fehlt in der Archäologie ein vergleichbares Vokabular bislang weitgehend.

Die AG Archäologiethesaurus – eine unabhängige Arbeitsgruppe ohne institutionelle Anbindung, hervorgegangen aus einer Initiative des Archäologischen Museums Hamburg im Jahr 2008 – hat sich zum Ziel gesetzt, ein einheitliches, überregional nutzbares Vokabular archäologischer Objektbezeichnungen zu entwickeln. Dieses soll die Ansprache und Inventarisierung von  umfangreichen Beständen in Landesmuseen und Landesämtern, aber auch von kleineren regionalen Sammlungen erleichtern.

Als Zwischenschritte auf dem Weg zum digitalen Thesaurus erscheinen seit 2012 die „Bestimmungsbücher Archäologie“, in denen sukzessive einzelne Objektgruppen (wie z.B. Fibeln, Gürtel, Pfeil- und Lanzenspitzen) aufgearbeitet werden. Diese haben sich sowohl in der praktischen Sammlungsarbeit als auch bei Grabungsfirmen schnell als nützliche Standardwerke etabliert.

Aktueller Fokus der Arbeitsgruppe ist die digitale Umsetzung des sog. Archäologischen Objektbezeichnungsthesaurus (AOT) in ein interoperables Format, das institutions- und softwareunabhängig nutzbar ist. Geplant ist, das Vokabular in xTree bereitzustellen und dort auch danach weiterhin redaktionell zu betreuen, um seine technische Implementierung in unterschiedliche Sammlungsdatenbanken zu ermöglichen und deren Nutzenden stets ein aktuelles Vokabular anbieten zu können. Parallel dazu werden weitere Objektgruppen nach und nach erschlossen und sowohl in Print veröffentlicht als auch digital integriert; selbstverständlich sind auch Mappings zu anderen Thesauri vorgesehen.

Der Vortrag stellt die AG, ihre Entstehung, Arbeitsweise und Ziele vor und diskutiert, wo sich Anknüpfungspunkte zur Community von NFDI4Objects ergeben –  insbesondere im Hinblick auf technische Lösungen, Interoperabilität und mögliche Kooperationen bei der weiteren Entwicklung des digitalen Archäologiethesaurus.

Hier sind die Zoom-Zugangsdaten:

https://dainst-org.zoom.us/j/94508989488?pwd=zVXisbncIEgOOwEle1NQuG7hA2YNbp.1

Meeting-ID: 945 0898 9488
Kenncode: 357332

Eine Anmeldung ist nicht erforderlich, wir freuen uns auf Eure Teilnahme.


Hands on DANTE am 28. Juli 2026, 13:00 Uhr

2026年7月14日 16:07

Am 28. Juli 2026 von 13:00 bis 14:00 Uhr laden wir Euch zu einem praxisorientierten Community-Cluster-Treffen rund um den Webservice DANTE der Verbundzentrale des GBV für Nutzer:innen mit DANTE-Erfahrung oder komplexen Vokabularen mit Michael Markert (VZG) ein.

DANTE unterstützt die Pflege und Veröffentlichung kontrollierter Vokabulare und wird u. a. im #NFDI4Objects-Kontext genutzt.

Im Hands-on stehen Eure Fragen im Vordergrund, insbesondere zu Sonderfällen, die schwer mit dem DANTE-Datenmodell vereinbar sind oder Importen ganzer Vokabulare.

Bringt daher gern Beispieldaten (Personen, Körperschaften, Orte, Sachbegriffe) mit!

Hier sind die Zoom-Zugangsdaten:

https://dainst-org.zoom.us/j/93160916100?pwd=E4HitdYiOrb2jS4YjLJrx6ore8blet.1

Meeting-ID: 931 6091 6100
Kenncode: 479870

Einladung zum Workshop: Forschungsdaten publizieren in der Filmwissenschaft | 16. Juli 2026, Potsdam

2026年6月30日 15:49

Liebe Interessierte,

das Datenkompetenzzentrum QUADRIGA lädt zu einem eintägigen Workshop rund um die Publikation film- und medienwissenschaftlicher Forschungsdaten ein. Der Workshop steht allen interessierten Wissenschaftler:innen offen. Er richtet sich insbesondere an Film- und Medienwissenschaftler:innen sowie Forschende aus angrenzenden geisteswissenschaftlichen Disziplinen.

Praxisnah und ohne spezielles Vorwissen lernen Sie, wie Forschungsdaten für eine offene, FAIR-konforme Publikation aufbereitet, angereichert und veröffentlicht werden können: von der Dokumentation und Strukturierung über Metadatenstandards bis hin zur Evaluation von Publikationswegen. Der Workshop verbindet Impulsvorträge, Diskussionen und praktische Übungen, dabei kommen Module einer von QUADRIGA entwickelten OER (Open Educational Resource) zum Einsatz. Mehr Informationen gibt es auf der Website:

https://www.quadriga-dk.de/de/ws2026datenpublikation.

Stattfinden wird der Workshop am Donnerstag, dem 16. Juli 2026, von 10:00 bis 18:00 Uhr im Potsdam Lab im Bildungsforum Potsdam (fußläufig vom Potsdamer Hauptbahnhof erreichbar).

Anmeldungen sind bis zum 9. Juli möglich. Zur Anmeldung gelangen Sie hier.

Für Teilnehmende, die außerhalb der Region Berlin-Brandenburg anreisen, steht eine begrenzte Anzahl an Reisekostenunterstützungen zur Verfügung. 

Bei Fragen stehen wir Ihnen gerne zur Verfügung.

Beste Grüße,

Melanie Seltmann für 

Ihr QUADRIGA-Team

—

Berlin-Brandenburgisches Datenkompetenzzentrum für

Digital Humanities, Verwaltungswissenschaft, Informatik und Informationswissenschaft

————————————————————

https://www.quadriga-dk.de

quadriga-management@listserv.dfn.de

https://github.com/quadriga-dk

————————————————————

Data Librarian

2026年6月26日 18:05

Die Klassik Stiftung Weimar (KSW) ist eine gemeinnützige Stiftung des öffentlichen Rechts und zählt zu den herausragenden kulturellen Institutionen in Deutschland. Sammlungs- und Arbeitsschwerpunkte der Stiftung sind die Weimarer Klassik, ihre Nachwirkungen in der Kunst und Kultur des 19. Jahrhunderts und die Moderne mit Friedrich Nietzsche und dem Bauhaus. Die Sammlungen werden in der Herzogin Anna Amalia Bibliothek, dem Goethe- und Schiller-Archiv, den Museen sowie den historischen Bauten und Gärten betreut.

In der Direktion Herzogin Anna Amalia Bibliothek ist in der Abteilung Sammlungen, Sondersammlungen zum nächstmöglichen Zeitpunkt folgende Stelle in Vollzeit, zunächst befristet auf 2 Jahre, zu besetzen:

Data Librarian

E 13 TV-L, Kennziffer: 27/2026

Sie unterstützen die Herzogin Anna Amalia Bibliothek (HAAB) als Datenproduzent*in und Datenlieferant*in für Wissenschaft, Forschung und Öffentlichkeit, in ständigem Austausch mit der Abteilung Digitale Bibliothek, der Abteilung Informationstechnik und Organisation sowie der Querschnittsdirektion Digitale Transformation und Innovationsmanagement.


Das sind Ihre Aufgaben:

  • Mitarbeit bei der Weiterentwicklung des normdatenbasierten Discoverysystems der HAAB (VuFind) und KSW
  • Planen und Umsetzen von Datenintegration und Datenhomogenisierung
  • Realisieren von Datenaustausch (z. B. Schnittstellenkonfiguration)
  • Vornehmen von Datenvisualisierung, u. a. auch im Rahmen von Virtuellen Ausstellungen/Digitale Öffentlichkeitsarbeit
  • Maschinelle Datenverarbeitung und -produktion/automatisierte Sacherschließung/perspektivisch KI und maschinelles Lernen planen und umsetzen
  • Weiterentwickeln und bibliothekarisches Betreuen des Publikationsservers der KSW
  • Mitarbeit in der Normdatenredaktion der KSW
  • Mitwirken an KSW-Initiativen zu Langzeitarchivierung, Datensicherung, elektronischem Datenmanagement (E-Akte) etc. unter fachlicher Steuerung von Querschnittsdirektion Digitale Transformation und Innovationsmanagement sowie Stiftungs-IT


Das erwarten wir:

  • abgeschlossenes Hochschulstudium (Master) vorzugsweise im Bereich der Bibliotheks- und Informationswissenschaften oder Qualifikation für den höheren Bibliotheksdienst (Referendariat oder Master)
  • Kompetenzen in den Bereichen Bibliothekssysteme und bibliothekarisches Metadatenmanagement und Normdaten (PICA, MARC, GND, Wikidata, Linked Open Data)
  • Vertrautheit mit Methoden und Workflows der Digital Humanities von Vorteil
  • Affinität zur Arbeit mit historischen Quellen
  • Hohe Kommunikationskompetenz, ausgeprägte Teamfähigkeit, Verlässlichkeit und Belastbarkeit in zeitkritischen Projektphasen


Wir bieten Ihnen:

  • eine vielseitige und interessante Tätigkeit in einem kollegialen, engagierten Team
  • ein familienfreundliches und attraktives Arbeitsumfeld mit moderner IT-Ausstattung, flexiblen Arbeitszeiten und die Möglichkeit der mobilen Arbeit
  • attraktive Nebenleistungen wie vermögenswirksame Leistungen und betriebliche Altersvorsorge (VBL)
  • individuelle Angebote zur fachlichen und persönlichen Qualifizierung
  • einen zentrumsnahen Arbeitsplatz inmitten der UNESCO-Welterbestätten Klassisches Weimar und Bauhaus Weimar
  • kostenfreien Eintritt in alle Museen der Stiftung


Die Stiftung gewährleistet die Gleichstellung von Frauen und Männern nach dem Thüringer Gleichstellungsgesetz. Bei gleicher Eignung werden Schwerbehinderte und ihnen gleichgestellte Menschen nach Maßgabe des SGB IX besonders berücksichtigt. Ein Nachweis der Schwerbehinderung bzw. Gleichstellung ist den Bewerbungsunterlagen beizufügen.

Wenn Sie diese Stelle interessiert, bewerben Sie sich bitte mit aussagekräftigen Unterlagen, Lebenslauf und Zeugnissen/Beurteilungen, zusammengefasst in einer pdf-Datei, bis zum 26. Juli 2026 über unser Online-Portal unter https://www.klassik-stiftung.de/stellenangebote/. Von postalischen Bewerbungen und Bewerbungen per E-Mail bitten wir abzusehen.

Einladung zum morgigen Online-Vortrag von Zita Baronnet im Rahmen des TCDH-Forschungskolloquiums

2026年5月20日 18:05

Gerne möchten wir Sie zum morgigen Online-Vortrag (16–18 Uhr (c.t.)) im Rahmen des TCDH-Forschungskolloquiums einladen:

Zita Baronnet (Universität Trier / TCDH): „Urheberrechtlich geschützte Texte online veröffentlichen: Ein Versuch, das Paradoxon zu lösen”

Wie kann man urheberrechtlich geschützte Texte online zugänglich machen, ohne gegen das Urheberrecht zu verstoßen? Wenn urheberrechtlich geschützte Texte als Klartext online verbreitet werden, wird das Urheberrecht verletzt. Andererseits sind komplett verschlüsselte Texte nutzlos für Forscher, da keine computergestützten Analysemethoden wie Sentiment Analysis auf ihnen verwendet werden können. Ziel des DFG-Projekts ‚Forschen mit Derivaten‘ – das im Vortrag vorgestellt wird – ist die Entwicklung eines Ansatzes, mit dem urheberrechtlich geschützte Texte online veröffentlicht und trotzdem analysiert werden können, ohne das Urheberrecht zu verletzen. Wir untersuchen verschiedene Methoden, von der Randomisierung bis zur homomorphen Verschlüsselung, um dieses Problem zu lösen.

Im Sommersemester 2026 setzen wir unsere Vortragsreihe im Rahmen des TCDH-Forschungskolloquiums fort. Das Spektrum reicht in diesem Semester von Fragen der digitalen Erschließung und Vernetzung historischer Texte und Wörterbücher über rechtliche und ethische Herausforderungen im Umgang mit Forschungsdaten bis hin zu digitalen Editionen und Plattformlösungen für die geisteswissenschaftliche Forschung. 

Sie sind herzlich eingeladen, teilzunehmen und mitzudiskutieren!

Alle Informationen und Zoom-Link gibt es unter: https://tcdh.uni-trier.de/de/event/vortrag-von-zita-baronnet-universitaet-trier-tcdh-leonard-schild-cosic-ku-leuven

Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy

2026年5月11日 21:38

Autor:innen:


Für Originalbeitrag, siehe https://hdl.hypotheses.org/5097

Abb. 1: Gruppenarbeitsphase: Beschreibung disziplinspezifischer OER (Quelle: NFDI4Memory)

Digitale Werkzeuge und die Arbeit mit Forschungsdaten verändern den wissenschaftlichen Alltag – und erfordern die Entwicklung neuer Kompetenzen. Eine besondere Stellung nehmen dabei Data Literacy (Schüller, Busch und Hindinger, 2019) und Forschungsdatenmanagement (FDM) ein, die über OER (Open Educational Resources) vermittelt werden können (Deimann et al., 2015). Doch OER zu FDM sind bisher über verschiedene Plattformen verstreut und damit schwer auffindbar. Plattformen wie DALIA (Ortmeyer et al., 2024) oder Sammlungen wie NFDI4Memory HISTOCAT und HERMES Resourcebase versuchen, hier Abhilfe durch Registraturen und kuratierte Sammlungen zu schaffen. Ein zentraler Schlüssel für die Auffindbarkeit und Nachnutzbarkeit der OER sind dabei allerdings gute Metadaten – doch bestehende Schemata (z. B. das Schema des Datenkompetenzzentrums HERMES (Urbaum et al., 2026) oder das DALIA Interchange Format (Geiger et al., 2026)) unterscheiden sich hinsichtlich fachspezifischer Angaben wie Disziplinen oder Methoden. Hier fehlen in vielen Fällen standardisierte Vokabulare zu einer Beschreibung von OER, um Such-Find-Prozesse effizienter werden zu lassen.

Vor diesem thematischen Hintergrund organisierten die Projekte HERMES, NFDI4Memory, DALIA und NFDI4Culture auf der 12. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum e.V. (DHd2026), die vom 23. bis 27. Februar 2026 an der Universität Wien stattfand, einen Workshop. Die Konferenz in Wien stand unter dem Motto „Nicht nur Text, nicht nur Daten“ und erweiterte damit ihren Fokus von den traditionellen text-basierten Analysen zu einer umfassenden, objekt-übergreifenden Perspektive. Neben Textkorpora standen nun auch Personen, Orte, materielle Kultur, Bild- und Klangobjekte, Klimadaten, genetische sowie neurophysiologische Messungen im Fokus.

Abb. 2: Organisationsteam Workshop Kontext und Klarheit (Quelle: Jonathan D. Geiger)

Insbesondere das technische Interesse der Konferenz-Teilnehmenden und die Breite des geisteswissenschaftlichen Disziplinen-Panoramas machten die DHd zu einer geeigneten Konferenz für den Workshop “Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy”. Unser Ziel war es, Metadatenschemata und disziplinspezifische Metadaten von OER unter die Lupe zu nehmen und so eine Grundlage für die Verbesserung der Schemata zu entwickeln. Der halbtägige Workshop konzentrierte sich daher auf die Untersuchung und Strukturierung von OER-Metadaten – insbesondere den Einsatz fachspezifischer, kontrollierter Vokabulare, Picklists und Metadatenschemata für geisteswissenschaftliche Lehr- und Lernmaterialien. Nach einer kurzen Vorstellung der Referent*innen und ihrer Projekte folgte ein Ice-Breaker, der die Unschärfe von Klassifikationen thematisierte. Die daran anschließende kompakte Einführung vermittelte einen Überblick über unseren Untersuchungsbereich wie OER-Metadatenstandards, Metadatenschemata, Vokabularien und deren disziplinäre Herausforderungen und Potenziale. In der Gruppenphase wurde die Think-Pair-Share-Methode nach Bönsch (2002) eingesetzt. Im Hauptteil durchliefen die Teilnehmenden in Kleingruppen einen klassischen Erschließungsprozess. Anhand ausgewählter OER aus verschiedenen geisteswissenschaftlichen Disziplinen untersuchten die Teilnehmenden, inwiefern die beiden OER-Metadatenschemata von HERMES und DALIA für die Ressourcen geeignet waren und inwiefern disziplinen-spezifische Angaben zu den Werten der einzelnen Attributen gemacht werden können. Das Moderationsteam unterstützte dabei. Abschließend wurden die Ergebnisse im Plenum präsentiert, Bedarfe diskutiert und nächste Schritte für die Weiterentwicklung von Picklists skizziert. Eine Reflexionsrunde fasste zentrale Erkenntnisse zusammen und eröffnete Anknüpfungspunkte.

Abb. 3: Beschreibung von OER anhand ausgewählter Metadatenschemata (Quelle: NFDI4Memory)

Unter den Eindrücken der Kleingruppen gab es interessante Überschneidungen: Demnach waren Autor*innen- und Lizenzinformationen der Ressourcen häufig unklar oder fehlten ganz; Zielgruppen und Kompetenzstufen wurden uneinheitlich beschrieben oder nicht klar voneinander abgegrenzt. Beide Metadatenschemata wiesen Redundanzen bzw. zu viele Pflichtfelder auf, und Metadatenfelder wie Titel, Untertitel oder Versionsangaben konnten nicht konsistent angegeben werden. Die Teilnehmenden merkten zudem an, dass die  Anpassbarkeit an fachspezifische Begriffe derzeit noch begrenzt ist.

Aus diesen  Überschneidungen  ergaben sich gemeinsame Empfehlungen: Vorgeschlagen wurde ein modularer Kern-/Erweiterungs-Ansatz, bei dem grundlegende Metadaten obligatorisch und fachspezifische Felder optional über kontrollierte Vokabulare (Picklists) ergänzt werden können. Darüber hinaus wurde angeregt,  Lizenz- und Autor*innen-Angaben für OER klar auszuweisen; die  Disziplinen-Taxonomie um digitale Geisteswissenschaften bzw. Digital Humanities zu erweitern sowie Metametadaten (Version, Datum, Provenienz, Autor*innen etc.) systematisch zu integrieren. Für komplexere Fälle wurde außerdem die Möglichkeit freier Ergänzungen als sinnvoll erachtet. Einheitliche Definitionen für OER, klare Rollenbezeichnungen und ein abgestuftes Kompetenzmodell wurden ebenfalls als  wünschenswert erachtet. In der Gruppendiskussion wurde insbesondere die Bedeutung  von Metametadaten für Versionierung und Nachvollziehbarkeit von Entwicklungen betont.

Die Organisator*innen danken allen Teilnehmenden herzlich für die rege und produktive Teilnahme und der DHd für die Ausrichtung der Konferenz in Wien. Auch uns hat der Workshop viele Impulse erbracht, die in die weitere Entwicklung der Arbeit an den Metadaten und Plattformen einfließen werden. Die inhaltliche Arbeit an OER und -Metadaten soll im Rahmen einer DHd-Arbeitsgruppe Data Literacy weitergeführt werden – Interessierte sind sehr herzlich zur Mitarbeit eingeladen und können sich in die Mailingliste eintragen und/oder unserem RocketChat-Channel (OER.Net) beitreten.

Referenzen

Bönsch, Manfred. 2002. Unterrichtsmethoden – kreativ und vielfältig. Schneider-Verlag Hohengehren.

Deimann, Markus, Jan Neumann und Jöran Muuß-Merholz. 2015. Whitepaper Open Educational Resources (OER) an Hochschulen in Deutschland – Bestandsaufnahme und Potenziale 2015. Transferstelle für OER. Hamburg. https://open-educational-resources.de/wp-content/uploads/Whitepaper-OER-Hochschule-2015.pdf (zugegriffen: 26.03.2026).

Geiger, Jonathan, Petra Steiner, Abdelmoneim Amer Desouki, Henrika Maria Hüppe und Frank Lange. 2026. DALIA Interchange Format (1.4). DOI: 10.5281/zenodo.17871138

Ortmeyer, Jochen, Jan-Michael Haugwitz, Petra Steiner, Thomas Stäcker, Torsten Schrade, Ulrich Sax, Gábor Kismihók, Matthias Müller, Peter F. Pelz und Sonja Herres-Pawlis. 2024. A Platform for the Provision of Teaching and Training Contents in Data Literacy: DALIA4NFDI. BASE4NFDI User Conference. Berlin, 20-21 November 2024. DOI: 10.5281/zenodo.14183168

Schüller, Katharina, Paulina Busch und Carina Hindinger. 2019. Future Skills: Ein Framework für Data Literacy. Hochschulforum Digitalisierung, 47. DOI: 10.5281/zenodo.3349865

Urbaum, Dorothee und Grigori Chlesberg. 2026. Metadatenschema und Picklisten für Open Educational Resources des Datenkompetenzzentrums HERMES – Humanities Education in Research, Data, and Methods (v1-1). DOI: 10.5281/zenodo.18679758

Urbaum, Dorothee, Laura Döring, Grigori Chlesberg, Jonathan D. Geiger und Petra Steiner. 2026. Kontext und Klarheit: Fachspezifische Metadaten für offene Bildungsressourcen (OER) zu Data Literacy. In: Silke Schwandt, Gabriel Viehhauser, Tara Andrews und Thomas Wallnig (Hg). 2026. Book of Abstracts – DHd 2026: Nicht nur Text, nicht nur Daten. 12. Jahrestagung des Verbands Digital Humanities im deutschsprachigen Raum e.V. DHd2026, Universität Wien, 23.–27. Februar 2026. Wien. DOI: 10.5281/zenodo.18702757

8. WissKI Anwender*innentreffen 20./21. Oktober 2026 in Nürnberg

2026年5月4日 18:49

Liebe WissKI-Community und alle die sich für Linked Open Data Management interessieren,

auch in diesem Jahr laden wir alle WissKI-Anwender*innen und -Entwickler*innen herzlich ein, um gemeinsam über Projekte und Themen zu diskutieren, sich über aktuelle Entwicklungen zu informieren und gemeinsam Lösungen für Herausforderungen zu entwickeln.
Das 8. WissKI Anwender*innentreffen findet statt:

Bis zum 31. August 2026 können Beiträge in Form von Präsentationen und Workshops eingereicht werden. Eure Einreichungen werden dieses Jahr in einem Book of Abstracts veröffentlicht! Mehr dazu in unserem „Call for Abstracts“.

Einen vorläufigen Programmablauf könnt ihr schon jetzt online einsehen!

Eine Anmeldung zur Teilnahme am WissKI Anwender*innentreffen ist bis einschließlich 30. September 2026 möglich.
Bei Fragen rund um das WissKI Anwender*innentreffen schreibt ihr an info@wiss-ki.eu oder in unseren Mattermost WAT Channel.

Herzliche Grüße

Die Organisator*innen des #WAT26

Neues Whitepaper zum Thema Fuzzyness & Wobbliness im NFDI4Objects Community Hub

2026年5月4日 15:33

Die NFDI4Objects TWG Community-Standards for modelling fuzziness & wobbliness in research data using Semantic Web technologies and formalisms (FuzzyWobblySW) hat ein neues Whitepaper veröffentlicht, das die Begriffe Unsicherheit, Vagheit und „Fuzzyness & Wobbliness” aus Sicht der Arbeitsgruppe definiert.

Das Dokument vergleicht und fasst gemeinschaftlich entwickelte Arbeitsdefinitionen der TWG  zusammen. Ziel ist ein gemeinsamer begrifflicher und modellierungstechnischer Rahmen. Durch Klärung der Konzepte und Darstellung von Modellierungsstrategien (z. B. probabilistische Ansätze, graduelle semantische Abbildungen, Wikibase-Implementierungen) trägt die Arbeit zu transparenteren, interoperableren und FAIR-konformen Lösungen für unsichere, unpräzise oder mehrdeutige Informationen in Kulturerbe-Wissensgraphen bei.

Das Whitepaper kann im Rahmen des NFDI4Objects-Commons-Prozess bis 28. Mai 2026 kommentiert werden! Wir freuen uns auf Euer Feedback!

correspSearch knackt 400.000-Marke – mit Helmina von Chézy

2026年4月30日 19:49

Der Webservice correspSearch, der historische Briefe durchsuchbar macht und vernetzt, hat einen wichtigen Meilenstein erreicht. Mit der jüngsten Integration der Briefe an Helmina von Chézy, die durch ein Explorationsprojekt an der Berlin-Brandenburgischen Akademie der Wissenschaften (BBAW) ermöglicht wurde, weist die Plattform nun mehr als 400.000 Metadatensätze von edierten oder wissenschaftlich erschlossenen Briefen nach.  

Initiiert von der BBAW-Arbeitsgruppe „Gender & Data“ und mit institutioneller Unterstützung der Akademie wird seit 2025 an der Erschließung der Korrespondenzen in Helmina von Chézys Nachlass im Akademiearchiv gearbeitet (Mitwirkende s. u.). Innerhalb von acht Monaten wurde die umfangreiche Korrespondenz von rund 3.500 Briefen mit Unterstützung von TELOTA und unter Nutzung des CMIF Creators erfasst und für die Aufnahme in correspSearch vorbereitet. Etwa 2.000 Briefe wurden an Chézy gerichtet und knapp 1.400 von ihr verfasst. Erstere sind nun freigeschaltet, die Briefe von Chézy selbst werden in Kürze ebenfalls integriert. Zukünftig sollen die Informationen auch zurück in das Findbuch des BBAW-Archivs fließen, um die Nutzung der Bestände vor Ort zu verbessern.

Die Aufnahme der Briefe in correspSearch stellt sicher, dass die Daten standardisiert und langfristig recherchierbar und für die Forschung nutzbar sind. Auch weitere Datenlieferungen trugen dazu bei, die Marke von 400.000 Briefversionen zu erreichen, u.a. der Briefwechsel zwischen Heinrich Mann und Inés Schmied, die Korrespondenz Wilhelm Wieprechts, Frank Wedekinds Korrespondenz digital, der Briefwechsel von Alice und Ludwig Klein, die Historisch-Kritische Ausgabe der Briefe von Goethe oder die Korrespondenz von Else Lasker-Schüler.

Helmina von Chézys Korrespondenznetzwerk

Helmina von Chézy (1783–1856) war als Schriftstellerin, Journalistin und Intellektuelle in vielfältige Netzwerke eingebunden. Mit rund 20 Jahren ging sie nach Paris und verbrachte dort ein prägendes Jahrzehnt, in dem sie Kontakte zu den Romantikern Dorothea und Friedrich Schlegel knüpfte und journalistisch für französische und deutsche Zeitschriften arbeitete. Ein besonderes Kapitel stellte ihr humanitäres Engagement 1815/16 dar, als sie in Lazaretten in Köln und Namur verwundete Soldaten pflegte. Ihr kritischer Bericht über deren schlechte Behandlung führte zu einer Gefängnisstrafe, vor der sie nach Berlin floh, wo E. T. A. Hoffmann erfolgreich ihre Verteidigung übernahm. Ihre Dresdner Jahre (1817–1823) markierten einen Höhepunkt ihres Schaffens durch die Mitgliedschaft im Dresdner Liederkreis und die Zusammenarbeit mit Carl Maria von Weber am Libretto zur Oper „Euryanthe“.

Helmina von Chézys Korrespondenz bildet den zentralen Bestandteil ihres Nachlasses. Rund 3.500 Briefe dokumentieren ein weitreichendes Netzwerk aus Personen aus Literatur, Kunst, Politik und Verlagswesen. Die Briefe geben Einblick in literarische Arbeitszusammenhänge und soziale Beziehungen und zeigen zugleich die Lebensbedingungen einer Frau, die sich im frühen 19. Jahrhundert in einem überwiegend männlich geprägten kulturellen Umfeld behauptete. Ein nicht unerheblicher Teil der Korrespondenz entfällt auf den Austausch mit Frauen und verweist auf die Bedeutung weiblicher Netzwerke in dieser Zeit.

Helmina von Chézys internationales Briefnetzwerk im Jahr 1822 während ihres Aufenthalts in Dresden. [Screenshot der Visualisierung in correspSearch]

Netzwerk der an Helmina von Chézy gerichteten Briefe mit farblicher Kennzeichnung des Geschlechts der Briefpartner. Graue Punkte markieren Personen ohne Normdaten, für die bislang keine Geschlechtsinformation vorliegt. [Screenshot der Visualisierung in correspSearch]

Aktiv gegen den Gender-Data-Gap

Wie in vielen anderen digitalen Diensten und Sammlungen besteht auch in correspSearch ein deutlicher Gender-Data-Gap. Dieser geht zum Teil auf historisch bedingte Ungleichheiten zurück, wird jedoch durch Überlieferungsbrüche und -lücken sowie eine häufig unzureichende Erschließung vorhandener Bestände weiter verstärkt.

Die systematische Aufarbeitung von Nachlässen wie dem Helmina von Chézys trägt dazu bei, Frauen als historische Akteurinnen im digitalen Raum sichtbarer zu machen und eröffnet neue, auch geschlechtergeschichtliche Perspektiven für die Forschung. Dieses Anliegen wird an der BBAW seit April 2026 von einer auf zwei Jahre geförderten Initiative „Gender & Data“ weitergeführt, die sich unter anderem mit der Rolle der Digital Humanities für eine inklusivere geisteswissenschaftliche Forschung befasst.

***

Mitwirkende an der Erschließung des Chézy-Nachlasses: Michael Rölcke (Bearbeiter), Bénédicte Savoy und Frederike Neuber (Leitung, Herausgeberschaft), Stefan Dumont und Steven Sobkowski (correspSearch), Sandra Miehlbradt (BBAW-Archiv).

GND-Forum Humanities@NFDI: 23./24.06.26 in Göttingen

2026年4月17日 16:03

Mitwirkende der vier geisteswissenschaftlichen Konsortien der Nationalen Forschungsdateninfrastruktur (NFDI) treffen sich zum GND-Forum Humanities@NFDI am 23./24. Juni in Göttingen. Zentrales Thema des Arbeitstreffens ist die Gemeinsame Normdatei (GND) aus unterschiedlichen Blickwinkeln.

Die Veranstalter:innen

Wir organisieren das GND-Forum Humanities@NFDI als Team: Barbara Fischer (Deutsche Nationalbibliothek, GND-Community), Stefan Buddenbohm & Alex Steckel (SUB Göttingen als Gastgeberin sowie Text+). Melanie Gruss & Desiree Mayer (NFDI4Culture), Anja Gerber & Frank von Hagel (NFDI4Objects), Katrin Moeller und Anne Purschwitz (NFDI4Memory), Domenic Schäfer & Michael Markert (VZG des GBV).

Die GND-Foren

Mit dem Veranstaltungsformat FORUM verfolgen wir, d.h. die GND-Community, das Ziel, mit euch gemeinsam – den Nutzenden, den Forschenden, den Infrastrukturbetreibenden – über konkrete Anwendungsszenarien der GND nachzudenken. 

GND-Forum Humanities@NFDI

Das Selbstverständnis der GND ist es Brücken zu schlagen zwischen unterschiedlichen Ressourcen und Communities. Wie kann ihre Doppelrolle als Datenbank und Organisation beim Ausbau der Zusammenarbeit der vier geisteswissenschaftlichen Konsortien NFDI4Culture, NFDI4Memory, NFDI4Objects und Text+ helfen, ist die zentrale Frage in Göttingen. Hintergrund der Frage sind zum einen die für 2028 erwartete Neuausrichtung des NFDI-Förderprogramms, und zum anderen wie das Synergienpotenzial der bisherigen Entwicklungen in den jeweiligen Konsortien rund um die GND für die anderen Partner genutzt werden kann. Beides soll aus drei Blickwinkeln diskutiert werden:

  • Die Rolle der GND in Tools und Services der Konsortien
  • Unterschiedliche Perspektiven auf vier Entitätstypen der GND 
  • Zukunftspotenzial der vertieften Zusammenarbeit der Konsortien mittels der GND

Themen

Wir wollen Euch die Möglichkeit geben, euch aktiv einzubringen und schlagen den folgenden programmatischen Dreiklang vor:

  1. Tools: Welche Werkzeuge für welche Zwecke?
  2. Die GND im Schulterblick: Tandems aus GND- und NFDI-Kolleg:innen stellen die Entitätentypen der GND im Anwendungskontext vor
  3. Strategie: Pfade für die GND in der NFDI

Anmeldung

Bitte meldet Euch sich bis zum 16.06. über die Anmeldefunktion dieser Veranstaltungsseite an. Wir haben 80 Plätze für Teilnehmende reserviert. Die Teilnahme am GND-Forum ist kostenfrei.


Forschungsdaten im Zentrum: Ewig währt am längsten

2026年4月15日 21:38

Ein partizipativer Workshop der Initiative „Datenzentrum – wissenschaftliche Konzeption und Ausgestaltung“ der Berlin-Brandenburgischen Akademie der Wissenschaften (BBAW)

Berlin, 25. und 26. Juni 2026; Akademiegebäude am Gendarmenmarkt; Einstein-Saal


Der Wert geisteswissenschaftlicher Forschungsdaten für Wissenschaft und Gesellschaft ist nicht zuletzt durch den laufenden Aufbau der Nationalen Forschungsdateninfrastruktur (NFDI) offensichtlich geworden. Zentrale Fragen nach dem dauerhaften Betrieb vertrauenswürdiger Datenrepositorien und der langfristigen Verfügbarkeit der aggregierten Inhalte sind jedoch weiterhin offen.

Vor diesem Hintergrund lädt die Initiative „Datenzentrum – wissenschaftliche Konzeption und Ausgestaltung“ der BBAW zu einem zweitägigen Lunch-to-Lunch-Workshop ein. Diese 2025 eingerichtete Initiative erarbeitet ein Konzept für die organisatorischen und technischen Grundlagen für ein leistungsfähiges, zertifiziertes Repositorium und dessen infrastrukturelle Einbindung innerhalb der BBAW. Darauf aufbauend wird die Akademie ab 2028 ein eigenes Datenzentrum betreiben. Dessen Hauptaufgaben werden die Aggregation, Verfügbarhaltung und Archivierung von Forschungsdaten, Software und Diensten aus den Vorhaben und Projekten der Akademie sein. Darüber hinaus ist eine Öffnung des Repositoriums für externe Datengeber:innen vorgesehen.

Im Workshop werden anhand von Impulsvorträgen die unterschiedlichen Perspektiven aus Sicht von Forschung, Bibliothek, Archiv und IT reflektiert. Anschließend bieten verschiedene Thementische die Möglichkeit zu einer intensiven Auseinandersetzung mit spezifischen Fragen, von der technischen Einrichtung nachhaltiger Infrastrukturen zwischen quelloffenen und kommerziellen Lösungen bis hin zum Einsatz sog. Künstlicher Intelligenz samt deren ethischen Herausforderungen.


Um Anmeldung wird gebeten unter: www.bbaw.de/veranstaltungen/veranstaltung-workshop-datenzentrum-2026

Nähere Informationen zum Programm: https://datenzentrum.bbaw.de/veranstaltungen/workshop-2026. Die Seite befindet sich im Aufbau und wird fortlaufend aktualisiert.

Save the Date: 12. Juni 2026 – 4. Community Meeting von NFDI4Objects

2026年4月9日 14:31

Das vierte Community Meeting 2026 von NFDI4Objects findet virtuell statt! Die Veranstaltung richtet sich an Einsteiger:innen und Interessierte und bietet spannende Einblicke in die Arbeit des Konsortiums. Freut euch auf interaktive Formate, Austauschmöglichkeiten und dezentrale Online-Workshops.

Programm und Workshop-Termine folgen in Kürze – merken Sie sich den Termin schon jetzt vor!

❌