❌

普通视图

Received yesterday — 2026年10月10日

Mapping Diamond Open Access in Belgium: Exploring the Differences Between Bibliometric and Manually Verified Approaches

2026年10月9日 20:10

In June 2026, we published the first version of the Belgian Diamond Open Access Landscape dataset, an openly available dataset documenting Belgian Diamond Open Access (OA) and delayed OA journals.[1] As the mapping exercise is conceived as an ongoing effort, we continue to identify, verify, and document additional journals. These efforts have already resulted in the publication of a second version of the dataset.[2] The most important changes concern two targeted review exercises. First, we systematically compared our dataset with the ALMASI Diamond OA dataset, a large-scale bibliometric dataset of Diamond OA journals in Africa, Europe, and Latin America.[3] This comparison allowed us to identify a number of Belgian journals that met our inclusion criteria but had been missed in the first version of our dataset. At the same time, the comparison provided valuable insights into the different outcomes that are produced by bibliometric and manually verified approaches. The results of this comparison, together with a detailed discussion of the observed differences between both datasets, are presented later in this article. Second, we conducted a systematic review of the Diamond OA publishing activities of Belgian university presses, as well as two Belgian-based scholarly publishers, Brepols and Peeters Publishers. Both exercises further strengthened the coverage of the Belgian scholarly publishing landscape.

While the comparison with the ALMASI dataset initially served a practical purpose, namely identifying additional journals for inclusion in version 2 of the Belgian Diamond OA Landscape dataset, it also generated a number of broader insights, which may be of interest to others working on Diamond OA monitoring and mapping. Before turning to the results, however, it is useful to give a brief overview of the methodologies used by both datasets. The ALMASI Diamond OA dataset was constructed by combining metadata from ROAD[4] and OpenAlex[5] to create a base list of OA journals. Journals that charge Article Processing Charges (APCs) were subsequently identified and excluded through cross-referencing with OpenAPC,[6] DOAJ,[7] and OpenAlex metadata. The resulting dataset was further validated and enriched through the integration of established Diamond OA datasets, national journal portals, and targeted manual verification in a small number of individual countries. Where information on publication fees was not explicitly available, journals were assumed to be Diamond OA and retained in the dataset. The final dataset contains 20.355 Diamond OA journals from Africa, Europe, and Latin America.[8]

In contrast, the Belgian Diamond OA Landscape dataset was built through a process of systematic manual verification and contextual interpretation at the level of individual journals. Journals were identified through a broad range of sources, including DOAJ, DDH,[9] OpenEdition Journals,[10] institutional publishing platforms, national funding programs, and existing Diamond OA inventories.[11] Each journal was subsequently reviewed individually, with the journal’s own website serving as the primary source for assessing journal characteristics and publication models. Candidate journals were then evaluated against a number of explicit inclusion criteria: (1) only active journals are included, meaning that the journal has published at least one issue within the previous five years,[12] (2) a journal is considered Belgian only when the publisher or publishing entity is legally based in Belgium, and (3) journals are classified as Diamond OA when no publication fees are charged to authors for unconditional open publishing.[13] In addition, the dataset separately documents Belgian delayed OA journals, allowing both publication models to be studied alongside one another while maintaining a clear distinction between them.[14]

The comparison between both datasets provides an opportunity to examine not only the completeness of both datasets but also the kinds of journals that tend to remain invisible under different methodological approaches. In particular, it allows us to assess the extent to which national, manually verified mapping exercises can complement international bibliometric initiatives, especially in a context where many Diamond OA journals remain only partially represented in major international indexes and databases. The relevance of such verification is also acknowledged by the authors of the ALMASI dataset, who note that bibliometric metadata are not always up to date and may contain inaccuracies regarding journals’ OA policies.[15] Similar concerns have been raised in studies of national Diamond OA landscapes outside Belgium, where it has been shown that the journals identified can vary depending on the criteria and data sources used.[16]

As said above, the first outcome of this comparison was the identification of additional journals for inclusion in the Belgian Diamond OA Landscape dataset. As a result, 63 journals are shared by both datasets, whereas 92 journals are unique to the ALMASI dataset and 99 are unique to the Belgian Diamond OA Landscape dataset. We also identified one duplicate record in the ALMASI dataset. The analysis therefore uses 155 unique journals rather than the 156 records reported in the original dataset.[17] These figures indicate that, despite a substantial overlap, both datasets also contain a considerable number of unique titles, which calls for a closer examination of the reasons for this divergence.

Figure 1. Comparison of journal coverage in the ALMASI dataset and the Belgian Diamond OA Landscape dataset.

Of the 92 journals that were not included in the Belgian Diamond OA Landscape dataset, the largest group consists of Hybrid OA journals (n = 49). Another substantial group comprises discontinued journals (n = 16), indicating that they are no longer active at the time of verification. Furthermore, 13 journals were excluded because they operate under a Gold OA model with Article Processing Charges (APCs), while for 9 journals no explicit evidence could be identified that all content would become openly accessible after an embargo period. A smaller number of journals were excluded due to the absence of a (current) Belgian connection (n = 5), because they provided paywalled access to their content (n = 3), or because they followed a Subscribe to Open model (n = 1).[18]

Figure 2. Number of journals excluded from the Belgian Diamond OA Landscape dataset by exclusion criterion.

Several explanations may account for the discrepancies between both datasets. One possibility is that journal information changed between the creation of both datasets. However, given that the ALMASI dataset was published on 11 December 2025 and the first version of the Belgian Diamond OA Landscape dataset was completed on 23 June 2026, this appears relatively unlikely, as the interval between both datasets is limited. A more plausible explanation is that some journals were incorrectly classified in the bibliometric sources on which the ALMASI methodology relies. Inaccurate, incomplete, or outdated metadata concerning publication models, APC policies, journal activity status, and publisher information most likely explains why a number of journals identified as Diamond OA by ALMASI did not meet the inclusion criteria applied in the Belgian Diamond OA Landscape study.

If we zoom in on the Hybrid OA journals, an interesting observation is that more than one-third of the journals identified in the ALMASI dataset (57 out of 155) are published by Brepols and Peeters Publishers, two publishers based in the Flemish region of Belgium and focused on the humanities. The strong presence of these two commercial academic publishers largely explains the high number of journals that were ultimately classified as Hybrid OA rather than Diamond OA. A likely explanation is that the publication models of these journals are difficult to identify through bibliographic metadata alone. These journals contain a mixture of open and restricted content, while bibliographic databases do not always capture the distinction between access conditions and publication models in a sufficiently granular manner.[19] What is also striking is that several journals published by Brepols and Peeters Publishers that were identified as Diamond OA in the Belgian Diamond OA Landscape study were absent from the ALMASI dataset. This suggests that bibliographic metadata not only leads to the inclusion of journals that do not meet the Diamond OA criteria, but also results in the omission of journals that do.

Not all differences between the two datasets can be attributed solely to inaccuracies or limitations in bibliographic metadata. The category “Embargo not explicitly stated” reflects a methodological difference in how delayed OA journals are identified and classified, rather than a disagreement about the OA status of these journals. No information could be identified regarding how delayed OA journals were handled when compiling the ALMASI dataset. In our study, delayed OA journals were explicitly included as a separate category, provided that the journal clearly stated that all content would become openly accessible after a defined embargo period. This requirement was adopted as a deliberate inclusion criterion in order to establish a clear and consistently applicable boundary between journals that could be verified as delayed OA and those for which insufficient evidence was available. Although delayed OA journals were also present in the ALMASI dataset, they were not identified as a distinct category. This suggests that delayed OA journals were captured by their methodology, but without the additional verification criteria that we applied.

Although this concerns only a single journal in the present comparison, it is worth briefly explaining why journals operating under a Subscribe-to-Open (S2O) model are not included in our dataset. While S2O enables content to become openly accessible without direct author-facing publication fees, the continuation of OA remains contingent upon the willingness of subscribers to renew their subscriptions. As a result, OA is not guaranteed as a permanent feature of the journal and may be reversed if sufficient subscription revenue is not maintained. In contrast, our definition of Diamond OA requires that OA is provided independently of subscription income. For this reason, S2O journals are not considered Diamond OA within the scope of the Belgian Diamond OA Landscape dataset.[20]

The reverse perspective is equally informative. Looking at the journals that are unique to the Belgian Diamond OA Landscape dataset reveals a number of patterns that might help explain the differences between both datasets. A first observation is that a substantial number of journals hosted on institutional and community-based publishing platforms such as OpenEdition Journals, Openjournals.nl, Open Journals UGent, OJS UCLouvain, and PoPuPS (ULiège) were absent from the ALMASI dataset. This suggests that, as expected, the bibliometric approach is less effective at identifying journals published through smaller institutional and community-based Diamond OA infrastructures, and is more suited for identifying journals and publishers that are well represented in international metadata sources.

PlatformShared by both datasetsOnly in Belgian Landscape dataset
Openjournals.nl04
OJS UCLouvain511
PoPuPS (ULiège)518
OpenEdition Journals1010
Open Journals UGent1012

Tabel 1. Shared and unique journals by publishing platform.

A further explanation for the observed differences between the two datasets can be found in disciplinary orientation.[21] Only 36% of HSS journals are found in both datasets, compared with 46% of SET journals and 53% of BMS journals.[22] This pattern partly reflects the strong presence of HSS journals on institutional and community-based publishing platforms, which themselves are underrepresented in the ALMASI dataset as shown above. This observation is also consistent with broader scholarly communication patterns, as SET and BMS journals tend to be better represented in large international indexing and metadata databases, making them easier to identify through bibliometric approaches.

DisciplinesShared by both datasetsOnly in Belgian Landscape datasetTotal
HSS46 (36%)83 (64%)129
SET12 (46%)14 (54%)26
BMS8 (53%)7 (47%)15

Tabel 2. Shared and unique journals by discipline.[23]

Publication language, on the other hand, does not appear to provide a convincing explanation for the differences between the two datasets. To classify the journals by publication language, we applied the same broad categories as used in the ALMASI scoping report:[24]

  • English: journals publishing exclusively in English;
  • Multilingual: journals publishing in English and at least one additional language;
  • Other languages: journals publishing exclusively in non-English languages.

The proportion of journals identified by both datasets is remarkably similar across English-language, multilingual, and other-language journals, suggesting that the bibliometric approach does not systematically favor or overlook journals based on publication language.

Publication languagesShared by both datasetsOnly in Belgian Landscape datasetTotal
English17 (37%)29 (63%)46
Multilingual34 (39,5%)52 (60,5%)86
Other languages12 (40%)18 (60%)30

Tabel 3. Shared and unique journals by publication language.

Comparing the Belgian Diamond OA Landscape dataset with the ALMASI dataset provided valuable insights into how methodological choices, including data sources, inclusion criteria, and validation procedures, shape the representation of national publishing landscapes. While large-scale datasets make cross-national analyses possible, national studies can provide contextual knowledge and journal-level verification that are difficult to achieve at scale. The comparison revealed discrepancies related to journal activity status, national affiliation, and, most importantly, the classification of OA models. It also showed that journals published through institutional and community-based publishing infrastructures, as well as Humanities and Social Sciences journals, were less consistently represented across both datasets. The Belgian case therefore highlights the need for further reflection on how Diamond OA journals are identified and classified, particularly when the aim is to capture diverse and locally embedded publishing initiatives.


[1] Laura Mesotten and Demmy Verbeke, The Belgian Diamond Open Access Landscape, June 23, 2026, https://doi.org/10.5281/zenodo.20760254.

[2] Version 2 of the dataset was published on October 9, 2026 and is available via https://doi.org/10.5281/zenodo.20760253. 

[3] Zehra Taskin and Mikael Laakso, ALMASI Dataset of Diamond Open Access Journals, December 11, 2025, https://doi.org/10.5281/zenodo.17897299.

[4] ROAD (Directory of Open Access Scholarly Resources) is an ISSN-based international database maintained by the ISSN International Centre that provides metadata on Open Access scholarly resources. See: https://www.issn.org/services/online-services/road-the-directory-of-open-access-scholarly-resources/.

[5] OpenAlex is an open bibliographic database containing metadata on scientific publications, authors, institutions, and funders.

[6] OpenAPC is an open initiative that aggregates data on Article Processing Charges (APCs), Book Processing Charges (BPCs) and data on articles published under transformative agreements.

[7] DOAJ (Directory of Open Access Journals) is a community-curated index of peer-reviewed Open Access journals. Although DOAJ metadata were used during the construction and validation of the ALMASI dataset, DOAJ inclusion alone does not appear to determine whether a journal is captured by the ALMASI methodology. In the Belgian Diamond OA Landscape dataset, 18 of the 49 journals (37%) indexed in DOAJ are absent from the ALMASI dataset.

[8] Mikael Laakso and Zehra Taskin, D1.1 Scoping Report on Non-for-Profit Publishing Ecosystems, December 29, 2025, https://doi.org/10.5281/zenodo.18257718.

[9] DDH (Directory of Diamond Journals) is a community-maintained directory of Diamond Open Access journals.

[10] OpenEdition Journals is a publishing platform and infrastructure for Open Access journals in the humanities and social sciences, operated by OpenEdition.

[11] All consulted data sources are described in the dataset’s About section.

[12] Journals that explicitly state that publication has ceased, that have not published any content within the previous five years, or that have been launched but have not yet published any content are considered inactive and are excluded from the dataset.

[13] These inclusion criteria are described in more detail in the dataset’s About section.

[14] All tables and figures presented in this article are based on the combined set of Belgian Diamond OA and Belgian delayed OA journals.

[15] Laakso and Taskin, D1.1 Scoping Report on Non-for-Profit Publishing Ecosystems, 132.

[16] Simone Angioni et al., “Charting the Landscape of Italian Diamond Open Access Publishing,” Quantitative Science Studies 7 (June 2026): 564–84, https://doi.org/10.1162/QSS.a.466.

[17] The duplicate record concerns Revue Quetelet / Quetelet Journal, which is listed in the ALMASI dataset under two separate records: Revue Quetelet + Quetelet Journal (ISSN 2593-9149, eISSN 2593-9157) and Revue Quetelet / Quetelet Journal (ISSN 2034-9378, eISSN 2034-9386). The latter record is also registered in the ISSN Portal, albeit under the title Chaire Quetelet. It presumably refers to an earlier registration of the same journal and was therefore treated as a duplicate.

[18] Some journals met more than one exclusion criterion and were therefore counted in more than one category. In particular, the category No Belgian affiliation overlaps with Gold Open Access with APC (n = 3) and Paywalled access (n = 1). As a result, the counts for the individual exclusion criteria should not be added together, as this would exceed the total number of excluded journals (n = 92).

[19] Recent recommendations of the OpenAlex Colors Working Group highlight important limitations of current Open Access classification systems. In particular, the report argues that widely used OA classifications often conflate access conditions with publishing and funding models, making it difficult to consistently represent more complex OA arrangements and to distinguish between different publication models on the basis of bibliographic metadata alone. See Juan Pablo Alperin et al., Recommendations for Revising the Open Access Classification System in OpenAlex, August 14, 2026, https://doi.org/10.5281/zenodo.21934115.

[20] Some studies and mapping exercises adopt a broader definition of Diamond OA and do include S2O journals, e.g. Niels Taubert et al., “Mapping the German Diamond Open Access Journal Landscape,” Minerva 62, no. 2 (2024): 193–227, https://doi.org/10.1007/s11024-023-09519-7.

[21] The disciplinary categories were assigned by the authors as part of the Belgian Diamond OA Landscape study, based on the primary focus of each journal. As a result, some classification decisions may be open to interpretation.

[22] The totals by discipline exceed the number of journals because some journals were assigned to more than one disciplinary category and are therefore counted more than once.

[23] For Tables 2 and 3, percentages are calculated relative to the total number of journals in the respective category.

[24] Laakso and Taskin, D1.1 Scoping Report on Non-for-Profit Publishing Ecosystems, 135.

Received before yesterday

El verdadero poder del Open Source

2026年8月29日 04:25

Por Erick Mendoza Lara

Entender qué significa que algo sea de código abierto (open-source) va mucho más allá de saber que su programación es pública o que su uso es gratuito. En realidad, significa comprender la enorme oportunidad que estas herramientas representan y la capacidad que tienen para democratizar el acceso a la tecnología.

Una herramienta de código abierto puede llegar a muchas más personas al eliminar algunas de las barreras económicas y técnicas que suelen acompañar al software propietario.

Continue reading El verdadero poder del Open Source at Red de Humanidades Digitales.

Open Access journals published in Belgium without author fees

2026年6月24日 05:09

This blog post was written by Demmy Verbeke and Laura Mesotten.

A first version of the dataset dedicated to the landscape of Belgian Open Access (OA) journals which do not charge author fees has been published with DOI 10.5281/zenodo.20760254.

This overview, compiled by Laura Mesotten and Demmy Verbeke, provides a comprehensive list of Belgian Diamond OA journals – defined as journals that are published in OA without charging author fees and that are governed by the academic community. The dataset includes a range of bibliographical, editorial, and technical details, such as ISSNs, publishing software used, funding sources, and peer review status. In addition, the dataset documents the operational Diamond OA criteria for journals as developed in the context of the DIAMAS and CRAFT-OA projects. As such, it serves as a practical tool for identifying journals that are eligible for inclusion in the Diamond Discovery Hub maintained by the European Diamond Capacity Hub.

The “About” section of the dataset outlines the methodological choices and scope. For instance, it specifies the criteria used to determine whether a journal qualifies as Belgian. For the purposes of this dataset, a journal is considered Belgian if its publisher or publishing entity (i.e., the institution or society responsible for the journal) is legally based in Belgium. In cases of co-publishing, a journal is also considered Belgian if at least one co-publisher or publishing entity is legally based in Belgium, even if the registered publisher is located elsewhere. By contrast, indicators such as the nationality or institutional affiliations of editors, funding from Belgian institutions, or distribution via Belgian platforms are not considered as sufficient grounds for classifying a journal as Belgian.

The dataset further includes a “Belgian delayed OA journals” tab, which provides information on journals whose content is made openly available after an embargo period. Inclusion in this category is restricted to journals where OA applies to the issue as a whole (rather than to individual articles) and where such access is unconditional – that is, authors can be assured that their publication will become openly accessible after a defined embargo period. No restrictions are imposed on the length of the embargo, and, where identifiable, the duration of embargo period is explicitly recorded in the dataset. Journals are excluded from this category if it is not clearly stated that they provide delayed OA, or if it remains uncertain whether the availability of open content reflects an established embargo policy or merely the opening up of the journal’s archive, without reassurance that newly published material will become openly accessible over time. This section should be viewed as an initial exploratory effort to map delayed OA journals in the Belgian context. While distinct from Diamond OA, delayed OA regularly shares certain features with it, notably the absence of author-facing fees. Further research will be required to validate and refine the identification of such journals. Including them at this stage enables their separate documentation and supports the monitoring of changes in access conditions over time.

As a first release, the dataset should be regarded as a living resource rather than a definitive inventory. It is intended to support research and analysis on scholarly communication and Diamond Open Access publishing in Belgium, while also facilitating the visibility and monitoring of community-led journals. The dataset will be periodically updated to reflect changes in journal policies, platforms, and indexing statuses. Users are encouraged to consult the most recent version and to share additions, corrections, or comments with the authors.

Bericht vom Hands-On Lab “Digital Footprint – Choose your own adventure” – Datentracking in der Wissenschaft spielerisch verstehen” bei der 114. BiblioCon in Berlin

2026年7月24日 22:22

Autor*innen: Ulrike Wuttke (Fachhochschule Potsdam), Timo Steyer (UB Braunschweig), Yuliya Fadeeva (Helmholtz Open Science Office)

Raschelnde Karten, laut angeregte Gespräche, sind wir hier während der BiblioCon in einer Skatrunde gelandet? Nein, im Workshop “Digital Footprint – Choose your own adventure” – Datentracking in der Wissenschaft spielerisch verstehen”! 

Dieser wurde von Yuliya Fadeeva, Timo Steyer und Ulrike Wuttke als Hands-on Lab bei der 114. BiblioCon “Analog trifft Algorithmus” 2026 in Berlin angeboten. Zu dieser fanden zwischen 19. – 22.05.2026 im ESTREL Berlin wieder Bibliotheksmenschen aus dem DACH-Raum und darüber hinaus zusammen, um die neuesten Entwicklungen und Erkenntnisse aus Praxis, Forschung und Transfer zu diskutieren. 

Nach zwei Hands-On Labs zum Datentracking bei der BiblioCon 2023 und der BiblioCon 2024 gab es nun wieder auf vielfachen Wunsch der Community eine weitere Auflage. Diese stand ganz im Zeichen eines analogen Spiels  dessen Prototyp von Studierenden der FH Potsdam unter der Leitung von Prof. Dr. Ulrike Wuttke entwickelt und dann zusammen mit einem Graphikdesigner und einer Comiczeichnerin sowie Ulrike Wuttke weiterentwickelt wurde. 

Im Fokus des Spiels steht als tierischer Protagonist ein ‘Wissensschaf’ auf dem Weg zum PhD, dem ein ‘Forensiker-Flamingo’ im Kampf gegen den fiesen ‘Datentracker-Vampir’ zur Seite steht. Das Spiel wurde für die Zielgruppe internationale Early Career Researcher (ECR) als Teil eines Workshops entwickelt. Es ist deswegen auf Englisch gehalten. Es lädt zur Diskussion zum Hinterlassen und der kommerziellen Verwendung von Datenspuren beim Erstellen einer wissenschaftlichen Publikation ein. Es beleuchtet dieses Phänomen vor dem Hintergrund des radikalen Wandels der globalen Verlagshäuser zum Geschäftsmodell Data Analytics (siehe DFG 2021 https://doi.org/10.5281/zenodo.5900759). Einige dieser Global Player bieten inzwischen alle Phasen des wissenschaftlichen Forschungsprozesses umfassende Workbenches an, tracken aktiv das Verhalten der User auf diesen Plattformen  und verwerten die Daten kommerziell weiter (engl. data tracking, science tracking).

Nach Impulsen zu den Hintergründen des Datentrackings in der Wissenschaft von Yuliya Fadeeva und der Motivation zur Spielentwicklung von Ulrike Wuttke und Timo Steyer wurde das Spiel in mehreren Gruppen gespielt und der Workshop mit einer Feedbackrunde abgeschlossen. 

Positiv wurde das Potenzial des Spiels hervorgehoben, verschiedene Zielgruppen auf das Thema aufmerksam zu machen sowie seine visuelle Gestaltung und dass es sich um ein kollektives Spiel handelt (es gibt keinen Einzelgewinner). Verbesserungspotenzial wurde bezüglich der didaktischen Aufgleisung des begleitenden Workshops diskutiert und der präziseren Kommunikation des Spielziels. Auch wurde angeregt, über eine digitale Umsetzung nachzudenken.

Die Workshop-Folien stehen auf dem BIB-OPUS Volltextserver zur Verfügung: urn:nbn:de:0290-opus4-200683

Der Austausch war für die Hands-On-Gebenden sehr wertvoll und wir danken den Teilnehmenden sehr. Leider konnten die Studierenden selbst nicht an dem Hands-On teilnehmen, sie bekamen aber von Ulrike Wuttke persönlich die fertigen Spieleboxen überreicht. 

Danai und Suong

Die Studierenden mit der fertigen Spielebox.

Neugierig geworden? Das Spiel steht unter einer freien Lizenz als Open Education Resource (OER) zum Download zur Verfügung: 

  • Ioanna Danai Katsougiannopoulou, Nadja Hartwich, Ha Thao Suong Vu, Ulrike Wuttke, Katja Diederichs, Niko Ripka (2026): “Digital Footprint – Choose Your Own Adventure“: Data Tracking in Scientific Journals – Game and Workshop. CC BY-NC 4.0. DOI https://doi.org/10.5281/zenodo.17912053

Zusätzlich gibt es gleich zwei Episoden des Podcasts Die Wissensarchitekt*innen zum Spiel, eine Kurzepisode direkt vom Workshop auf der BiblioCon mit Manuel Bärwald und eine lange Episode zum Spieletest mit Claudia Frick.   

Das Spiel wurde von Ulrike Wuttke im Rahmen ihrer Transferprofessur mit dem Projekt T.R.A.C.K.S. – Training on Analytics, Compliance, Knowledge, and Security, dem Movetia-Projekt „Datenkompetenzen vermitteln an Hochschulen im D-A-CH Raum“ (Fördernummer 2024-1-CH01-IP-0018) und im Kontext der Task Force der Allianz der Wissenschaftsorganisationen “Datentracking und Digitale Nutzungsspuren: Schritte zur Transparenzschaffung” entwickelt und soll kontinuierlich mit der Praxis Community weiterentwickelt werden.

Last but not least, ein großer Dank an Movetia und den Fachbereich Informationswissenschaften der Fachhochschule Potsdam für die Unterstützung der Spielentwicklung. 

Weitere Ressourcen: 


KI als Belastungsprobe für das offene Internet? Bericht vom Panel bei der DHd 2026 in Wien

2026年7月16日 23:58

Autor*innen (in alphabetischer Reihenfolge): David Maus, Staats- und Universitätsbibliothek Hamburg, https://orcid.org/0000-0001-9292-5673; Sarah Oberbichler, Luxembourg Centre for Contemporary and Digital History (C²DH), https://orcid.org/0000-0002-1031-2759 ; Grischka Petri, FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur ,https://orcid.org/0000-0002-2548-449X; Cindarella Petz, Leibniz-Institut für Europäische Geschichte (IEG) Mainz, https://orcid.org/0000-0002-6178-7332 ; Klaus Rettinghaus, Sächsische Landesbibliothek — Staats- und Universitätsbibliothek Dresden (SLUB), https://orcid.org/0000-0003-1898-2543; Ulrike Wuttke, Fachhochschule Potsdam. Fachbereich Informationswissenschaften, SeDOA, https://orcid.org/0000-0002-8217-4025 

Hintergrund des Panels auf der DHd 2026

Am 25. Februar 2026 fand bei der DHd 2026 in Wien das Panel “KI als Belastungsprobe für das offene Internet” (Link zum Abstract auf Zenodo: https://doi.org/10.5281/zenodo.18696199) statt. Organisiert wurde das Panel von Ulrike Wuttke (Fachhochschule Potsdam, Fachbereich Informationswissenschaften, SeDOA), David Maus (Staats- und Universitätsbibliothek Hamburg), Fabian Rack (FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur, NFDI4Culture), Klaus Rettinghaus (Sächsische Landesbibliothek – Staats- und Universitätsbibliothek Dresden), Sarah Oberbichler (Luxembourg Centre for Contemporary and Digital History (C²DH), und Cindarella Petz (Digital Historical Research | DH Lab, Leibniz-Institute of European History (IEG)). Moderiert wurde das Panel von Ulrike Wuttke, Klaus Rettinghaus und Cindarella Petz. Da Fabian Rack zum Termin leider verhindert war, nahm an seiner Stelle für die NFDI4Culture Grischka Petri (FIZ Karlsruhe – Leibniz-Institut für Informationsinfrastruktur) neben David Maus und Sarah Oberbichler einen Sitz als Panelist*in ein. 

Im Mittelpunkt des Panels stand der Umgang mit den durch die momentanen KI-Entwicklungen verursachten Herausforderungen für offene Informationsinfrastrukturen, wie z. B. KI-Bot-Aktivitäten, sowie der Umgang mit aktuellen rechtlichen Herausforderungen und methodische Implikationen, insbesondere für die Digital Humanities (Shearer und Walk 2025 (COAR-Umfrage), Berg-Weiß 2025, COAR 2026). Die Paneldiskussion adressierte neben technischen und rechtlichen Lösungsansätzen Chancen und Herausforderungen des aktuellen Paradigmenwechsels im Umgang mit offenen Informationsinfrastrukturen und hinterfragte, wie sich der aktuelle KI-Trend mit den Prinzipien offenen Wissens und ethischen Prinzipien in den Digital Humanities und darüber hinaus vereinbaren lässt. Dabei wurden von den Panelist*innen technische, ethische und rechtliche Aspekte beleuchtet.

Einleitung KI und offenes Internet

Eingeleitet wurde das Panel durch Klaus Rettinghaus mit einer thematischen Einführung zum Thema KI und offenes Internet. Er führte aus, dass als OpenAI im November 2022 ChatGPT vorstellte, einerseits das Interesse an dieser neuen Technologie auf Benutzerseite groß war; andererseits die Sorgen bei den Tech-Giganten viel größer waren, nun unter Zugzwang gesetzt zu sein, um schnell zu handeln. Dies führte dazu, dass viele eifrig mit dem Training eigener Modelle begannen, um nicht den Anschluss zu verlieren (Hao 2026).

Ein Problem bei dieser Entwicklung ist, dass die KI-Modelle immer mehr Trainingsdaten benötigen, die sie sich ungefragt und oftmals ohne Erlaubnis überall besorgen und damit den Internet-Traffic in ungeahnte Höhen treiben (Heise 2025a). Das führt dazu, dass inzwischen zahllose KI-Bots das gesamte World Wide Web “abgrasen” und sich dabei als „normale“ Benutzer tarnen (Heise 2025b). Viele „Hüter“ des freien Wissens (wie z.B. Bibliotheken, Wikipedia) werden von Stiftungen oder der öffentlichen Hand finanziert und sind technisch weder für diesen gigantischen Anstieg des Verkehrs ausgelegt noch vorbereitet (Bsp. Thread Fitzpatrick 2026). Sie versuchen, dem Treiben Herr zu werden, indem sie Schranken aufbauen und sich immer mehr abschotten. Klaus Rettinghaus stellte diese Punkte dem Plenum und den Panelist*innen zur Diskussion, denn noch ist kein Ende dieses “Spuks” vorhersehbar und wirft diese neue Realität viele Fragen auf.

Paneldiskussion

Ziel der Paneldiskussion war es, grundlegende Aspekte der aktuellen KI-Entwicklungen in Bezug auf das offene Internet zu diskutieren. Mit Sarah Oberbichler, David Maus und Grischka Petri waren drei Expert*innen der Einladung auf das Panel gefolgt, um die verschiedenen Perspektiven der Akteursgruppen Forschung, Infrastruktur/Bibliothek, Rechtswissenschaft, zu vertreten. 

Mit kurzen Referaten von jeweils 5 Minuten und den jeweils anschließenden Gelegenheiten zur direkten Nachfragen und Kommentaren stellten die drei Panelist*innen ihre Sichtweisen vor. 

Sarah Oberbichler (C²DH, Luxemburg) näherte sich der Problematik aus der Perspektive der Forschungsdatenpraxis in den Digital Humanities und stellte dabei eine grundlegende begriffliche Unterscheidung in den Mittelpunkt: Was bedeutet „offen“ überhaupt? Und für wen? Offene Daten umfassen mindestens zwei Dimensionen, die in der Praxis nicht immer klar unterschieden werden: öffentliche Verfügbarkeit (technische Offenheit) im Sinne des freien Internetzugangs und rechtliche Offenheit durch Lizenzen, die Weiterverwendung für Forschung und Lehre erlauben, auch wenn Inhalte hinter einem Login liegen. Eine wesentliche Frage für Forschende lautet deshalb nicht: Sind die Daten zugänglich? Sondern: Sind sie auffindbar, nutzbar und nachnutzbar?

Am Beispiel des Internet Archive lässt sich zeigen, wie das massenhafte Scraping das offene Internet selbst verändert, und damit die Archivierung historisch bedeutsamer Quellen gefährdet. Da KI-Unternehmen das Internet Archiv als kostenlose Datenquelle nutzen, hatten im April 2026 241 Medienhäuser den Zugang für das Archiv blockiert, gleichzeitig schließen dieselben Häuser aber Lizenzdeals mit KI-Firmen ab (Muno 2026). Das Ergebnis ist eine strukturelle Verzerrung des digitalen Gedächtnisses: Qualitätsjournalismus verschwindet aus dem Archiv, während Blogs, Verschwörungsseiten und Content Farms übrig bleiben. Und da Medienhäuser nicht immer selbst archivieren und das Internet Archive blockiert wird, archiviert am Ende niemand.

In diesem Kontext gibt es keine klare Lösungen, jedoch mögliche Neuausrichtungen: (1) ethische KI-Implementierung statt Massenscraping; (2) öffentliche Dokumentation von Datensätzen statt unbegrenztem Datenzugang, etwa durch sogenannte Data Envelopes (Luthra & Eskevich, 2024), die Auffindbarkeit gewährleisten, ohne unkontrollierten Zugriff zu erzwingen; und (3) gemeinsame KI-Entwicklung, bei der Kultureinrichtungen, Forschende und KI-Entwickler:innen zusammenarbeiten und einen Paradigmenwechsel von Quantität zu Qualität vollziehen. 

David Maus nahm eine Einschätzung aus der Perspektive eines Infrastrukturanbieters vor. Aus der praktischen Arbeit an forschungsnaher Infrastruktur, den Bibliothekskatalogen und den daran angeschlossenen Informationssystemen, stellen sich die massenhaften Zugriffe auch als Angriff auf die Infrastruktur dar. Weil die Bots die etablierten Steuerungsmechanismen (Robots Exclusion Protocol, aka robots.txt) schlicht ignorieren und gnadenlos aus allen Richtungen die verfügbare Bandbreite verbrauchen, legen sie regelmäßig Teile der Infrastruktur lahm. Sei es, dass die Systeme unter der Last zusammenbrechen oder sei es, dass die Betreibenden ihre Dienste einstellen oder nur noch restriktiv zugänglich machen.

Als Konsequenz drückte er seine Erwartung einer stärkeren Zentralisierung und Homogenisierung der online verfügbaren Angebote aus. Der Schutz vor aggressiven Bots erfordert eine Infrastruktur, die Angebote von engagierten Einzelpersonen oder kleinen Facharbeitsgruppen nicht aufbringen können. Infrastrukturanbieter wiederum skalieren ihre Dienste darüber, dass sie Plattformen mit einer einheitlichen Grundstruktur anbieten. Angebote, die selbst keine Ressourcen für einen Bot-Schutz haben, verschwinden aus dem Netz oder müssen sich den Plattformen der Infrastrukturanbieter anpassen.

Grischka Petri führte aus, dass es aus rechtlicher Perspektive ernüchternd ist, nach Maßnahmen zu suchen, mit denen man gegen die Verursacher der Server-Sonderbelastung juristisch vorgehen könnte. Die Auswirkungen gleichen einem DoS-Angriff, dafür ist eigentlich das Computerstrafrecht zuständig. Allerdings ist es in den Bot-Downloads nicht vorgesehen, dass die besuchten Server in die Knie gehen sollen – im Gegenteil, man will sie ja nutzen. Der Ansatz scheitert also schon am Vorsatz. Das Urheberrecht bietet attraktive Kategorien an, um Nutzungen zu regeln – allerdings besteht das Problem ganz unabhängig vom urheberrechtlichen Status der Daten. Womöglich ist es für Anbieter gemeinfreier Inhalte sogar noch größer. Das Prinzip Lkw-Maut erscheint erfolgversprechender. Das ist eine Infrastrukturabgabe für eine Sondernutzung. Abseits einer staatlichen Regulierung hat die Wikimedia Foundation mit Wikimedia Enterprise einen solchen Weg eingeschlagen und bietet entsprechende Sondernutzungsverträge an.

Letztlich zeigt sich aber, dass mit rechtlichen Instrumenten keine Betriebssicherheit zu erlangen ist, weshalb am Ende die Empfehlung für technische Maßnahmen übrig bleibt. Initiativen wie die CC Signals, die sich selbst als “a technical and legal tool and a social proposition” beschreiben, sind vom guten Willen der beteiligten Akteure abhängig.

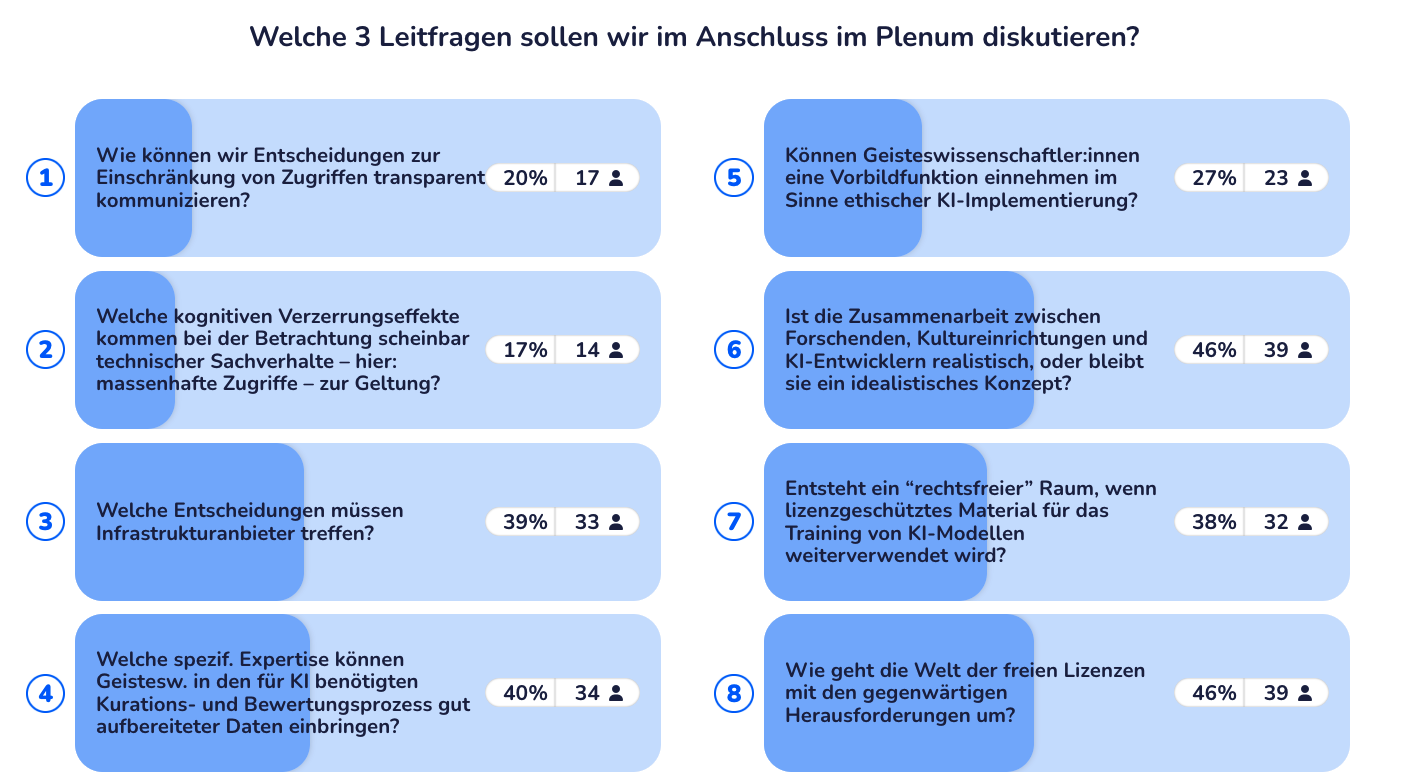
Nach dem Austausch auf dem Podium zwischen den Panelist*innen wurde die mit allen Teilnehmenden im Plenum von Cindarella Petz mit einer digitalen Intervention eingeleitet, in welcher die zu diskutierenden Fragen mithilfe von Wooclap zur Abstimmung gebracht wurden. 

Umfrageergebnisse mit Wooclap.

Mithilfe eines webbasierten Etherpads hatte das Publikum die Möglichkeit, anonym Fragen zu stellen und interessante Aspekte zu kommentieren. Im Pad wurden konkrete Standards und unterschiedliche Granularitäten von Nutzungslizenzen diskutiert, Ansätze zur Umleitung von Webcrawlern durch beispielsweise “LLMs.txt” oder “MCP” aufgeworfen, partizipatorische Elemente der Organisation von Wissenschaften, Forschung und GLAM-Institutionen angeregt und die ethische Nutzung von gecrawlten Datensätzen wie “Common Crawl” hinterfragt und welche rechtliche Rahmenbedingung geschaffen werden müssten, um eine Haftbarmachung von Massencrawlern und Stör-Bots zu erreichen.

Fazit und Ausblick

Die Diskussion zeigte deutlich, das wissenschaftsadäquate Lösungsszenarien für die komplexe Herausforderung durch die aktuellen KI-Entwicklungen nur mittels einer diversen Perspektive – unter Einbeziehung verschiedener Akteure und der Einbeziehung fachlicher, rechtlicher, technologischer und ethischer Aspekte herausgearbeitet werden können. Es wurde deutlich, dass es notwendig ist, dass die kritischen Stimmen lauter werden müssen. Letztendlich “befüttert” der KI-Einsatz in der Forschung in vielen Fällen (zumindest implizit) genau die gleichen Akteure, die für den im Panel kritisch betrachteten “ruchlosen” Umgang mit den digitalen Commons und Infrastrukturen insbesondere aus dem Kulturerbebereich (CHI) verantwortlich sind. 

Zusätzlich stellt sich die Frage, welche Expertise und Kompetenzen Digital Humanist(a)s in die Herausarbeitung von “Leitplanken” (Werten, Richtlinien, Forschungsethik) für den KI-Einsatz einbringen könnten bzw. sollten. In dieser neuen Phase des offenen Internets gibt es keine einfachen Lösungen. Alles “wegzuschließen” (d.h. technologische oder rechtliche Sperren) würde vor allem auch der Forschung selbst schaden. Was nützt es, wenn mensch alles finden kann, aber nicht mehr damit arbeiten kann. Wichtiger scheint es, den großen kommerziellen KI-Akteuren (Tech-Giganten) Einhalt zu gebieten bzw. ihr Handeln und die Nutzung ihrer Tools kritisch zu hinterfragen. Das Feedback im Saal bestärkte auf jeden Fall das große Potenzial von Digital Humanist(a)s und der LIS-Community (Library and Information Science) in der Politikberatung und der Herausarbeitung kritischer Punkte. Die Zeit ist reif, den Finger in die Wunde zu legen.

Quellen 

Berg-Weiß, Alexander. “Offen für manche Menschen oder doch für alle(s)? KI-Bots und ihre Auswirkungen auf den Betrieb von Repositorien.” BuB 77 Nr. 7(2025), S. 372-75. 

COAR, Navigating the Uneasy Interdependence of AI and Open Science, A COAR Statement, 3.3.2026

https://coar-repositories.org/news-updates/navigating-the-uneasy-interdependence-of-ai-and-open-science/ 

Fitzpatrick 2026, “Just FYI: this is part of the damage being done by extractive AI companies. Their scraper bots routinely DDOS us, and they multiply to take up as much bandwidth as is available. We are having to put a huge percentage of our developers’ time into just keeping the site alive rather than building its future. They are actively destroying everything worthwhile about the internet.” https://hcommons.social/@kfitz/115854657278743117, Mastodon, 7.1.2026, 17:02.  

Hao, Karen. 2026. Empire of AI: dreams and nightmares in Sam Altman’s OpenAI. New York: Penguin Books.

Heise (2025a), „Besorgniserregender Trend“: KI verursacht immer mehr Traffic, 21.08.2025 https://www.heise.de/news/Analyse-KI-Crawler-koennen-Server-ueberlasten-10560038.html (Achtung ohne Pur-Abo: Tracking)

Heise (2025b), Wikipedia: Bot-Traffic tarnt sich zunehmend als menschlich, 19.10.2025 https://www.heise.de/news/Wikipedia-Bot-Traffic-tarnt-sich-zunehmend-als-menschlich-10778492.html (Achtung ohne Pur-Abo: Tracking)

Luthra, Mrinalini und Maria Eskevich. „Data-Envelopes for Cultural Heritage: Going beyond Datasheets.“ Proceedings of the Workshop on Legal and Ethical Issues in Human Language Technologies @ LREC-COLING 2024, S. 52–65. Torino, Italia: ELRA and ICCL, 2024. https://aclanthology.org/2024.legal-1.9/  

Muno, Martin. „Internet-Archive: Unser digitales Gedächtnis ist bedroht.“ Deutsche Welle, 21. April 2026. https://p.dw.com/p/5CKXK

Shearer, Kathleen und Paul Walk. „The impact of AI bots and crawlers on open repositories: Results of a COAR survey.” April 2025, aufgerufen am 30.07.2025, https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf.

Wuttke, U., Maus, D., Rack, F., Rettinghaus, K., Oberbichler, S., & Petz, C. (2026, Februar 20). KI als Belastungsprobe für das offene Internet?. DHd 2026 Nicht nur Text, nicht nur Daten (DHd2026) (DHd2026), Wien, Österreich. https://doi.org/10.5281/zenodo.18696199

Einladung zum morgigen Online-Vortrag von Zita Baronnet im Rahmen des TCDH-Forschungskolloquiums

2026年5月20日 18:05

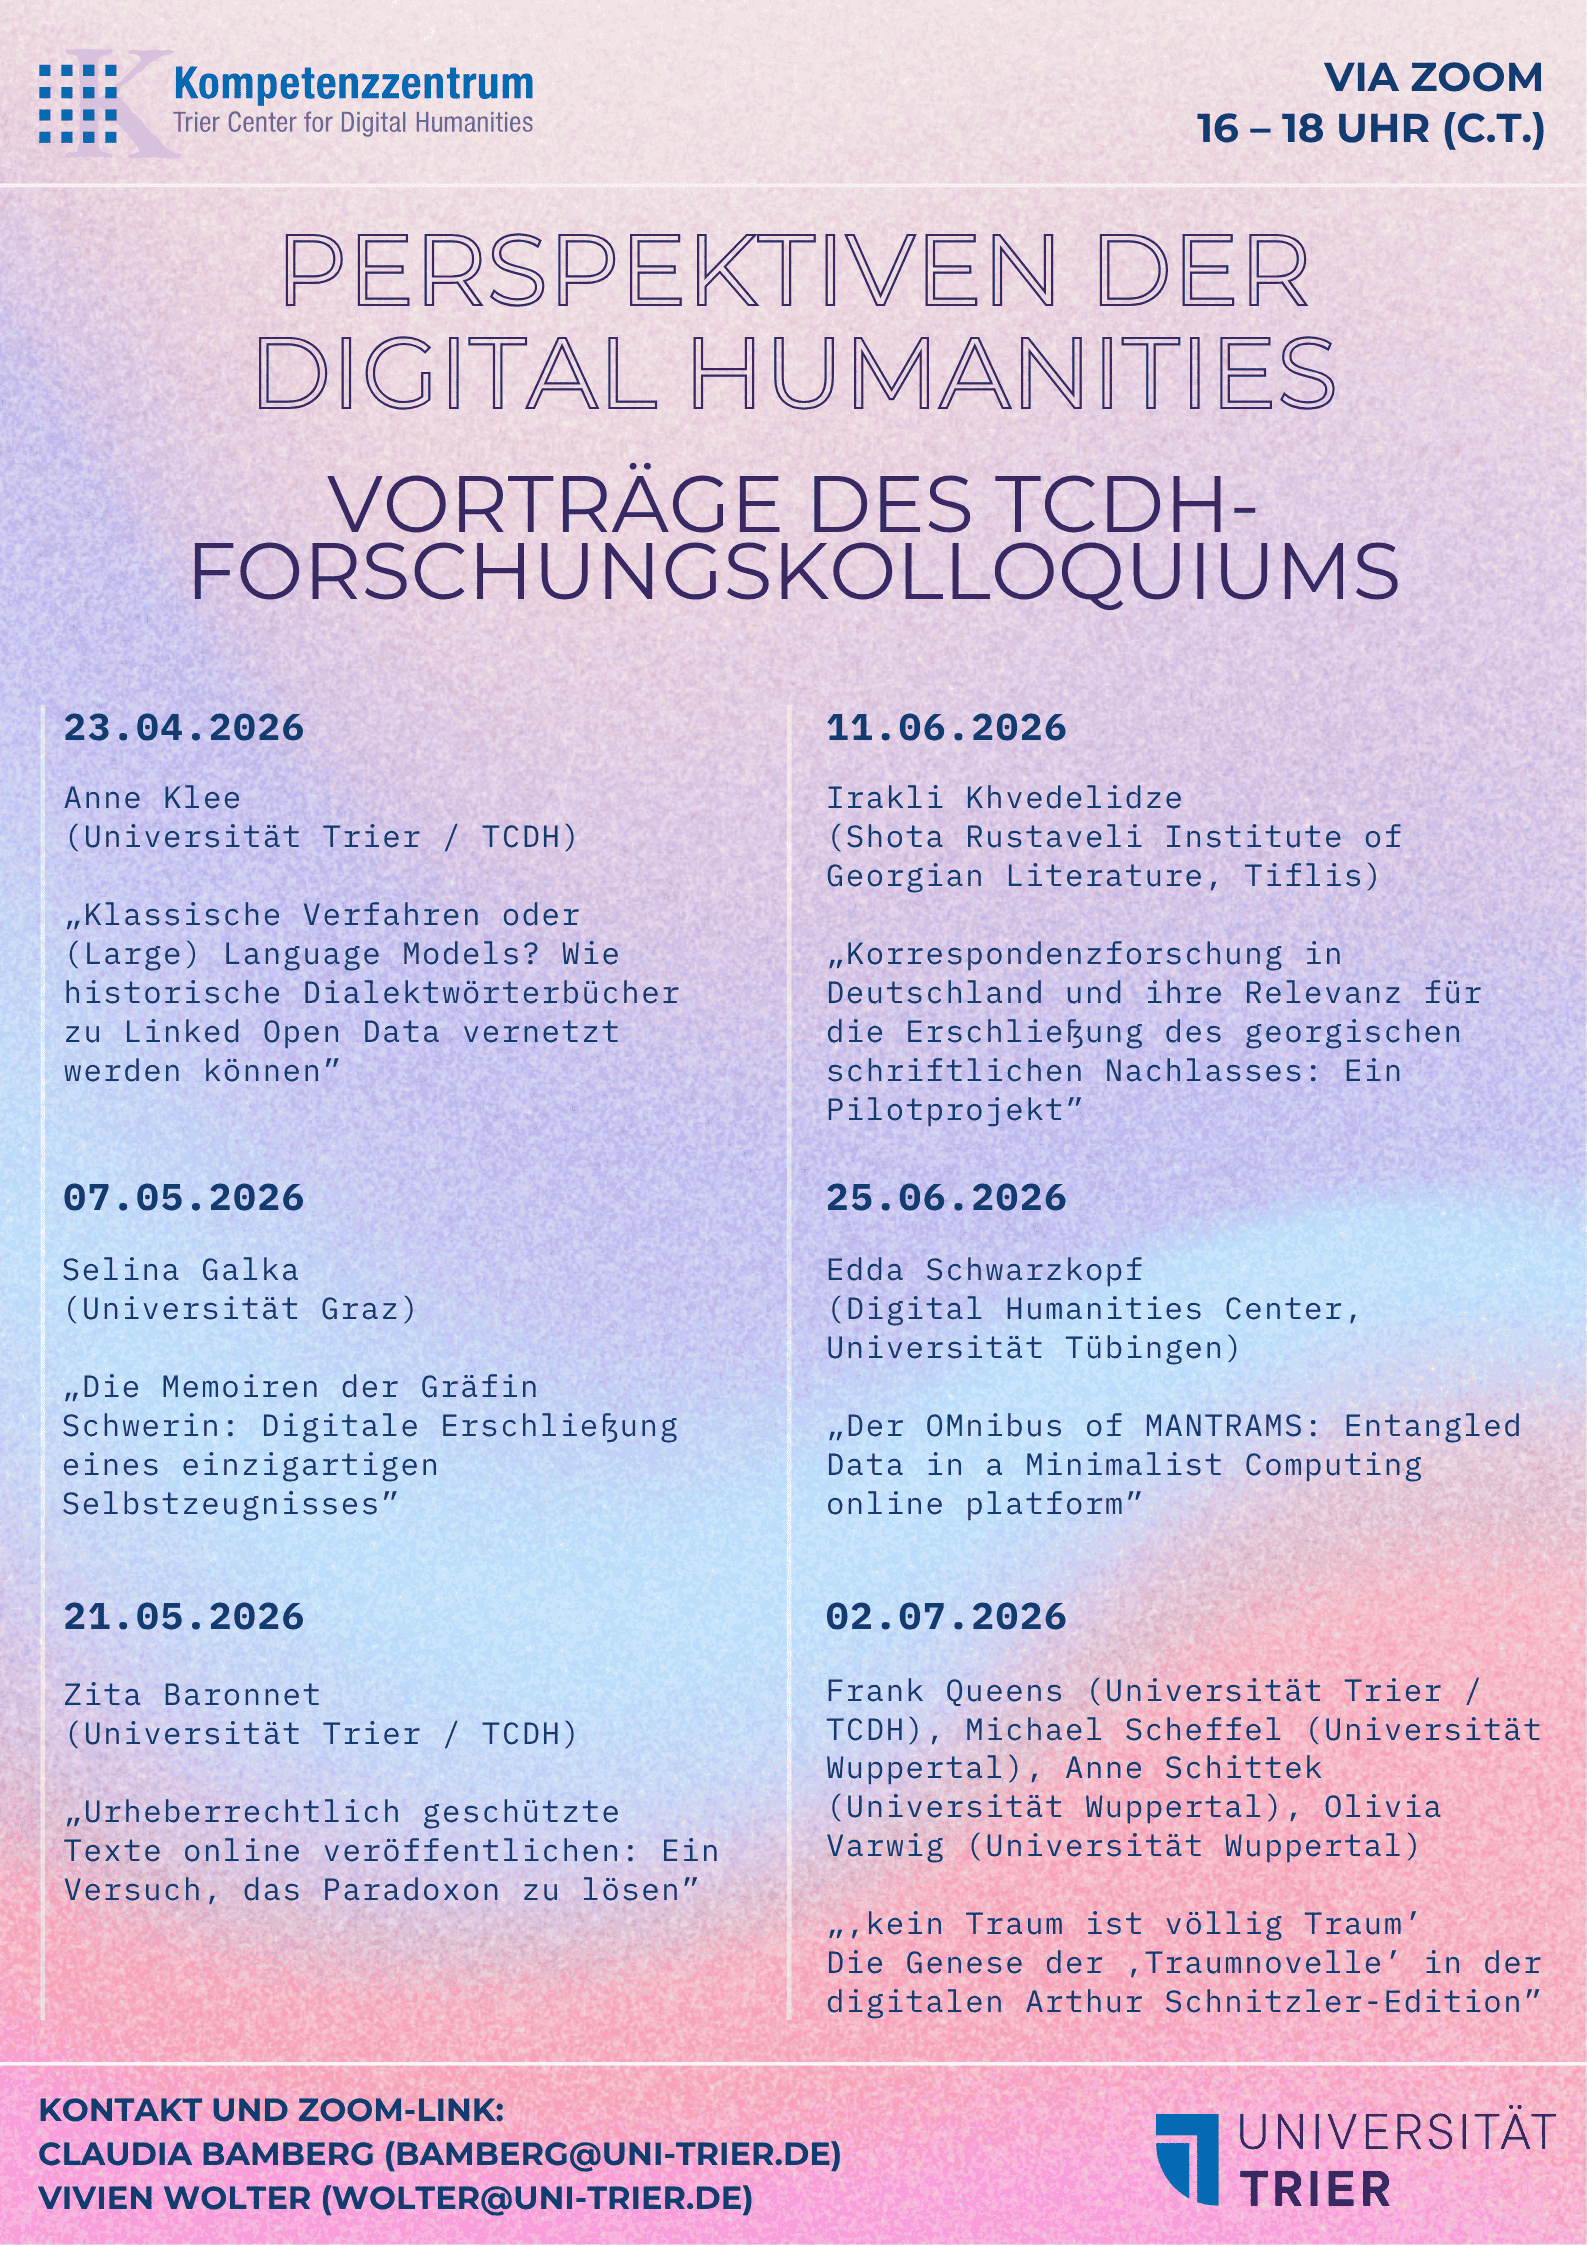
Gerne möchten wir Sie zum morgigen Online-Vortrag (16–18 Uhr (c.t.)) im Rahmen des TCDH-Forschungskolloquiums einladen:

Zita Baronnet (Universität Trier / TCDH): „Urheberrechtlich geschützte Texte online veröffentlichen: Ein Versuch, das Paradoxon zu lösen”

Wie kann man urheberrechtlich geschützte Texte online zugänglich machen, ohne gegen das Urheberrecht zu verstoßen? Wenn urheberrechtlich geschützte Texte als Klartext online verbreitet werden, wird das Urheberrecht verletzt. Andererseits sind komplett verschlüsselte Texte nutzlos für Forscher, da keine computergestützten Analysemethoden wie Sentiment Analysis auf ihnen verwendet werden können. Ziel des DFG-Projekts ‚Forschen mit Derivaten‘ – das im Vortrag vorgestellt wird – ist die Entwicklung eines Ansatzes, mit dem urheberrechtlich geschützte Texte online veröffentlicht und trotzdem analysiert werden können, ohne das Urheberrecht zu verletzen. Wir untersuchen verschiedene Methoden, von der Randomisierung bis zur homomorphen Verschlüsselung, um dieses Problem zu lösen.

Im Sommersemester 2026 setzen wir unsere Vortragsreihe im Rahmen des TCDH-Forschungskolloquiums fort. Das Spektrum reicht in diesem Semester von Fragen der digitalen Erschließung und Vernetzung historischer Texte und Wörterbücher über rechtliche und ethische Herausforderungen im Umgang mit Forschungsdaten bis hin zu digitalen Editionen und Plattformlösungen für die geisteswissenschaftliche Forschung. 

Sie sind herzlich eingeladen, teilzunehmen und mitzudiskutieren!

Alle Informationen und Zoom-Link gibt es unter: https://tcdh.uni-trier.de/de/event/vortrag-von-zita-baronnet-universitaet-trier-tcdh-leonard-schild-cosic-ku-leuven

Jetzt bewerben für den DHd-Publikationsfonds (Open Access, Deadline 1. Mai 2026)

2026年3月31日 16:23

Liebe DH-Community,

wir weisen Sie gerne darauf hin, dass der DHd-Verband einen Publikationsfonds eingerichtet hat, aus dem auf Antrag aus dem Kreis der Mitglieder des Verbands die Veröffentlichung fachwissenschaftlicher Publikationen finanziell unterstützt werden kann. Pro Antrag stehen maximal 1.000 EUR zur Verfügung.
Weitere wichtige Details zu den Kriterien, Antragsfristen und der Antragstellung entnehmen Sie bitte der Verbandswebseite: Open Access Publikationsfonds.

Rückfragen richten Sie bitte an: info@digitalhumanities.de

Wir freuen uns auf Ihre Anträge.

Prof. Dr. Ulrike Wuttke
1. Vorsitzende des DHd-Verbands und Beauftragte für den DHd-OA-Publikationsfonds

2. Folge Podcast “Die Wissensarchitekt*innen” mit PD Dr. Nicola Mößner “Business as usual Philosophische Reflexionen zum Datentracking” erschienen!

2026年3月7日 20:22

Ich freue mich Ihnen mitzuteilen, dass zum 3. Digital Independence Day die 2. Folge meines neuen Podcasts „Die Wissensarchitekt*innen“ online gegangen ist.

Der Wissenschaftspodcast “Die Wissensarchitekt*innen” erkundet die Welt hinter den Daten und was Bibliotheken, Forschung und Algorithmen miteinander verbindet. In Gesprächen über das Wissen von morgen werden kritische Aspekte der Informationsgesellschaft und ihre politischen und gesellschaftlichen Folgen diskutiert. 

In jeder Folge sind Gäst*innen aus unterschiedlichen Bereichen der Informations- und Wissenslandschaft zu Gast, um über ihre Arbeit und Themen zu sprechen. In der ersten Staffel von “Die Wissensarchitekt*innen” steht das Thema Datentracking mit Fokus Science Tracking (d.h. das nicht datenschutzgerechte Erheben und Nachnutzen von Nutzungsdaten auf kommerziellen wissenschaftlichen Webseiten) zentral.

Mehr zur 2. Folge mit PD Dr. Nicola Mößner unter dem Titel “Business as usual? Philosophische Reflexionen zum Datentracking” lesen Sie hier: https://ulrikewuttke.wordpress.com/2026/03/01/2-folge-podcast-die-wissensarchitektinnen-mit-nicola-mosner-erschienen/. [Link] zur Folge vom 1. März 2026.

Mehr zur Auftaktfolge mit Dr. Renke Siems und Dr. Yuliya Fadeeva unter dem Titel „Was ihr schon immer über Datentracking in der Wissenschaft wissen wolltet“ lesen Sie hier:  https://ulrikewuttke.wordpress.com/2026/02/01/auftaktfolge-meines-podcasts-die-wissensarchitektinnen-mit-renke-siems-und-yuliya-fadeeva-was-ihr-schon-immer-uber-datentracking-in-der-wissenschaft-wissen-wolltet-live/. [Link] zur Folge vom 01. Februar 2026. 

[Link] zur Episodenübersichtsseite des Podcasts auf Podcasts-Homes.

[Link] zum RSS-Feed des Podcasts “Die Wissensarchitekt*innen”.

Auf meinem Blog kann mensch auch [hier] vollständige Transkriptionen der Folgen mit Fußnoten und weiten Verweisen finden.

Die Folgen der ersten Staffel werden monatlich am ersten Sonntag jeden Monats, parallel zur Initiative Digital Independence Day mit freundlicher Unterstützung von Podcasts.homes erscheinen. Den Podcast kann mensch auch ohne Spotify abonnieren, hier gehts zum Wechselrezept: https://ulrikewuttke.wordpress.com/2026/01/27/wechselrezept-podcasts-horen-ohne-spotify/

Der Podcast wird von mir, Ulrike Wuttke, im Rahmen meiner Transferprofessur an der FH Potsdam mit dem Projekt T.R.A.C.K.S. “Training on Analytics, Compliance, Knowledge, and Security” produziert.

Mit freundlichen Grüßen und viel Spaß beim Reinhören!

Ulrike Wuttke

Prof. Dr. Ulrike Wuttke

Bibliothekswissenschaft – Strategien, Serviceentwicklung und Wissenschaftskommunikation  | Library Science – Strategies, Service Development and Scholarly Communication

Veröffentlichung des Sammelbandes „From Global to Local? Digitale Methoden in den Geisteswissenschaften im deutschsprachigen Raum: Ein Triptychon“

2026年2月19日 01:12

Wir freuen uns, die erfolgte Veröffentlichung des Bandes From Global to Local? Digitale Methoden in den Geisteswissenschaften im deutschsprachigen Raum: Ein Triptychon bei Melusina Press in Diamond Open Access bekanntgeben zu können. 

Aus dem Klappentext:  

“Der Sammelband “From Global to Local? Digitale Methoden in den Geisteswissenschaften im deutschsprachigen Raum: Ein Triptychon” lädt dazu ein, lokale und globale Geschichte(n) des Einsatzes von digitalen Methoden in den Geisteswissenschaften im deutschsprachigen Raum zu entdecken und über ihre Zukunft nachzudenken. Er bietet Standortbestimmung genauso wie Experimente in der Gegenwart und Gedankenspiele für die Zukunft. Er ergründet Entwicklungslinien und stößt kritische Diskussionen an.

Der Teilband „Be-Forschen“ sammelt diskursive Aufsätze und eine Vielfalt der Themen, der Teilband „In eigenen Worten“ Audio-Essays mit einer Vielfalt der Stimmen und der Teilband „Artefaktbiographien“ Portraits (digitaler) Objekte und eine Vielfalt der Medialität. Der Aufbau als Triptychon führt die (neuen) Formate fruchtbar zusammen, spiegelt den Medienwandel und zeigt dabei überraschende Perspektiven auf. Dies spiegelt die Vielfalt der methodischen Ansätze der Digital Humanities, ganz unabhängig davon, ob man sie als Big Tent oder als globales (Zelt-)Dorf begreift.” 

Sie finden die Publikation unter https://doi.org/10.26298/1981-5722. Wenn Sie eine Druckoption wünschen, so finden Sie dort ebenfalls die Möglichkeit der direkten Bestellung. 

Zur Zitation des Bandes orientieren Sie sich gerne an folgendem Beispiel (Chicago 18. Edition): Wuttke, Ulrike, Christopher Nunn, Christian Schröter, Melanie Seltmann und Christian Wachter. From Global to Local: Digitale Methoden in den Geisteswissenschaften im deutschsprachigen Raum: Ein Triptychon. Melusina Press, 2026. https://doi.org/10.26298/1981-5722. 

Nähere Informationen zur Publikation finden Sie im Fußbereich der Publikationswebsite oder im Impressum der Publikation. 

Wir wünschen Ihnen viel Vergnügen und Lese- und Hörgenuss bei der Lektüre aller Beiträge! 

Herzliche Grüße

Ulrike Wuttke

Christopher Nunn

Melanie Seltmann

Christian Schröter

Christian Wachter 


10 Jahre ZfdG – Der Slam!

2025年10月24日 20:28

Die Zeitschrift für digitale Geisteswissenschaften (ZfdG) wird 10 Jahre alt – und das feiern wir mit einem Science Slam der besonderen Art!

Diverse Perspektiven und geballte Digital-Power: Unterhaltsam, verständlich und mit einer Prise Selbstironie präsentieren Forscher*innen und Redakteur*innen ihre Themen rund um digitale Methoden, offenes Publizieren und die visionäre Kraft der Digital Humanities.

Ob algorithmisierte Kunstgeschichte, digitale Traumdeutung oder metareflektierende Open-Access-Gesangseinlage – der Jubiläums-Slam wird zeigen, dass Digital Humanities alles andere als langweilig sind.

Die ZfdG blickt in diesem Jahr auf ein Jahrzehnt voller Innovation, Vernetzung und Open-Science-Pionierarbeit zurück. Seit 2015 ist sie die zentrale Plattform für digitale geisteswissenschaftliche Forschung im deutschsprachigen Raum – Diamond Open Access, interdisziplinär, experimentierfreudig und immer offen für neue Ideen.

Lasst uns gemeinsam feiern, reflektieren und einen Blick in die Zukunft der digitalen Geisteswissenschaften werfen!

Wo: Herzog August Bibliothek Wolfenbüttel, Gartensaal des Lessinghauses
Wann: 28.11.2025, 19 Uhr
https://www.hab.de/event/10-jahre-zfdg-der-slam/

Webinar Series: Open Access Week Belgium

2025年10月9日 17:00

3 days- 3 Webinars

This edition of Open Access Week is dedicated to researchers and their need for guidance through open access publication models and projects.

Join together, take action, and raise awareness about the importance of open knowledge sharing

Program

Monday October 20|12:30-13:30: 

This session will explore the Horizon Europe Open Access rules and provide practical insights into their implementation. We will discuss how project officers are trained, which units are responsible, common questions from stakeholders, relevant statistics, lessons learned, and key takeaways for the next program cycle. We also anticipate questions and feedback from researchers who are applying these rules in practice. Their experiences will help enrich the discussion, and we hope the webinar will serve as a platform for sharing advice, best practices, and challenges.

Wednesday October 22|12:30-13:30: 

  • Theme: HOW TO RETAIN CONTROL OVER YOUR PUBLICATIONS IN THE AGE OF AI ?
  • Speaker: Mr. Joris Deene, Everest Advocaten, legal advisor SA&S
  • Registration

As an academic author, navigating copyright in the era of Open Access can be challenging. In this session, you will learn how to strategically manage and retain your rights before, during, and after publication. We provide you with concrete tools and legal insights to maximize the impact of your work.

After this session, you will be able to:

  • Choose and apply the right Creative Commons license for your specific goals.
  • Understand and exercise your statutory right of secondary publication under Belgian law.
  • Implement a rights retention strategy to secure your author’s rights before signing a publishing agreement.
  • Navigate the challenges of Artificial Intelligence (AI) in academic publishing, focusing on copyright implications and publisher policies.

Friday October 24|12:30-14:00: 

  • Theme: DIAMOND OPEN ACCESS
  • Speakers : Clément Dessy (FNRS Research Associate- ULB, co-editor of the journal COnTEXTES ), Geoffrey Compère (FNRS Research Director- ULB, senior editor of Scipost Physics), Jonathan Dumont (PhD – Project Manager – ULiège Library)
  • Registration

In response to growing concerns about equity and accessibility in scholarly publishing, an increasing number of researchers are advocating for the establishment of Diamond Open Access journals, which provide unrestricted access to research outputs for readers and enable authors to publish without incurring Article Processing Charges (APCs), thereby fostering inclusivity and the democratization of knowledge.

The webinar speakers will present complementary perspectives on Diamond Open Access publishing, including founding a new journal, converting an existing one, and serving as a senior editor on a Diamond Open Access platform.

Practicalities

  • When: October 20-26, 2025 with webinars on 20, 22 and 24 October
  • Where: Online
  • For who: Anyone who needs guidance through open access publication models and projects.
  • Price and registration: Free but mandatory.
  • More info: Click here

Workshop/Abendvortrag: Digitales Edieren in Gedächtnisinstitutionen, 8.7.2025, Zentralbibliothek Zürich

2025年6月20日 20:58

Seit der ‚Digitalen Wende‘ sind Gedächtnisinstitutionen mit neuen Aufgaben befasst: Neben der traditionellen Erschließung von Materialien und Beständen sowie der digitalen Präsentation von Quellen und Dokumenten übernehmen sie in zunehmendem Masse auch weitreichende Aufgaben im Bereich der digitalen Editorik. Sie verfolgen eigene digitale Editionsprojekte, in denen sie ausgewählte Bestände nach philologischen Kriterien öffentlich zugänglich machen, oder arbeiten mit Forschungsteams in Projekten zusammen.
Der Workshop möchte sich näher mit dem digitalen Edieren in Gedächtnisinstitutionen befassen und die gemachten Erfahrungen zusammentragen. Aus der spezifischen Perspektive dieser Institutionen soll der editorische Prozess von der Projektidee über die Umsetzungen bis hin zum Projektabschluss in den Blick genommen werden. Es geht dabei um einen Austausch, der dos und dont’s thematisiert und möglicherweise auch dazu beitragen kann, zukünftige Projekte effizienter zu gestalten und durchzuführen.

Der Abendvortrag von Dr. Johannes Mangei (Stv. Direktor HAB Wolfenbüttel) bietet Einblicke in die institutionellen Erfahrungen von mehr als zwanzig Jahren digitalem Edieren an der Herzog August Bibliothek in Wolfenbüttel. Ein Live-Stream wird angeboten.

Weitere Informationen finden Sie hier: 

https://www.zb.uzh.ch/de/events/workshop-digitales-edieren-in-gedaechtnisinstitutionen?date=945

https://www.zb.uzh.ch/de/events/vortrag-digitales-edieren-an-gedaechtnisinstitutionen-am-beispiel-der-herzog-august-bibliothek-wolfenbuettel?date=946

Werkstattreihe Standardisierung: edition humboldt digital

2025年6月4日 15:05


Christian Thomas und Stefan Dumont von der Berlin-Brandenburgischen Akademie der Wissenschaften stellten am 22. Mai 2025 die edition humboldt digital im Rahmen der „Werkstattreihe Standardisierung“ des NFDI-Konsortiums Text+ vor und gaben einen Einblick in ihre Arbeit. Sie reflektierten ihren Umgang mit Standards und deren Bedeutung für die Entwicklung der Edition. Der Werkstattbericht des Editionsprojekts kann nun hier nachgeschaut werden: https://youtu.be/ZydyHbQ_6Uo

Die Abbildung visualisiert graphisch die Vernetzung der edition humboldt digital mit internen und externen Ressourcen
Übersicht der Vernetzung der edition humboldt digital (Poster, Detail)
CC-BY-4.0 / https://zenodo.org/records/8228540

Text+ IO-Lecture: OAPEN & Directory of Open Access Books

2025年1月22日 01:06

Featured Image for Event Text+ IO-Lecture: OAPEN & Directory Access Book

OAPEN offers a wide range of expertise, services and well-curated academic content aimed at librarians, publishers, researchers, and funders. OAPEN promotes and supports the transition to open access for academic books by providing open infrastructure services to stakeholders in scholarly communication. OAPEN works with publishers to build a quality-controlled collection of open access books and provide services for publishers, libraries, and research funders in the areas of hosting, deposit, quality assurance, dissemination, and digital preservation.

The DOAB (Directory of Open Access Books) is a community-driven discovery service that indexes and provides access to scholarly, peer-reviewed open access books and helps users to find trusted open access book publishers. All DOAB services are free of charge and all data is freely available.

Both initiatives are of relevance for the communities around the NFDI consortia of the MoU group: NFDI4Culture, Text+, NFDI4Memory, and NFDI4Objects.

Silke Davison and Sebastiano Sali, Community Managers at OAPEN & DOAB, will introduce the audience into both services, highlight benefits four our communities, and speak about some of the many already existing working relations with institutions of the German academia.

At the end of this lecture, the participants shall feel intrigued to explore the services of OAPEN and DOAB and open access publishing for their own research projects.  

This lecture will be held in English.

Topics

  • Introduction to OAPEN & DOAB as foundations
  • Services of OAPEN
  • Services of DOAB
  • Questions from the audience
  • Explanation and demonstration of the OAPEN OA Books Toolkit
  • Questions from the audience
  • OAPEN & DOAB engagement in the community (with focus on Germany)
  • Final questions

Intended Audience

The event is aimed at individuals conducting research in the social sciences and humanities, working at an infrastructure facility in the field, or simply interested in the topic. Furthermore, we especially welcome participants from other NFDI consortia.

Please use the registration link to sign up.


OAPEN bietet ein breites Spektrum an Fachwissen, Dienstleistungen und gut kuratierten wissenschaftlichen Inhalten für Bibliothekare, Verleger, Forscher und Geldgeber. OAPEN fördert und unterstützt den Übergang zu Open Access für akademische Bücher durch die Bereitstellung offener Infrastrukturdienste für die Akteure der wissenschaftlichen Kommunikation. Wir arbeiten mit Verlagen zusammen, um eine qualitätsgeprüfte Sammlung von Open-Access-Büchern aufzubauen, und bieten Dienstleistungen für Verlage, Bibliotheken und Forschungsförderer in den Bereichen Hosting, Hinterlegung, Qualitätssicherung, Verbreitung und digitale Bewahrung.

Das DOAB (Directory of Open Access Books) ist ein von der Community betriebener Suchdienst, der wissenschaftliche, von Experten begutachtete Open-Access-Bücher indexiert und zugänglich macht und Nutzern hilft, vertrauenswürdige Open-Access-Buchverlage zu finden. Alle DOAB-Dienste sind kostenlos und alle Daten sind frei verfügbar.

Beide Initiativen sind für die Gemeinschaften rund um die NFDI-Konsortien der MoU-Gruppe von Bedeutung: NFDI4Culture, Text+, NFDI4Memory, und NFDI4Objects.

Silke Davison und Sebastiano Sali, Community Manager bei OAPEN & DOAB, werden die Zuhörer in beide Dienste einführen, die Vorteile für unsere Communities aufzeigen und über einige der vielen bereits bestehenden Arbeitsbeziehungen mit Institutionen der deutschen Wissenschaft sprechen.

Am Ende des Vortrags sollen die Teilnehmer Lust bekommen, sich mit den Diensten von OAPEN und DOAB sowie mit Open-Access-Publikationen zu beschäftigen.

Dieser Vortrag wird in Englisch gehalten.

Zielpublikum

Die Veranstaltung richtet sich an Personen, die in den Sozial- und Geisteswissenschaften forschen, an einer Infrastruktureinrichtung in diesem Bereich arbeiten oder sich einfach für das Thema interessieren. Darüber hinaus sind auch Teilnehmer aus anderen NFDI-Konsortien besonders willkommen.

Anmeldung

Link

Text+ IO-Lecture: OAPEN & Directory Access Book (10.02.2025, virtuell, 11:00-12:30 MEZ)

2024年12月18日 23:31

OAPEN (Open Access Publishing in European Networks) bietet ein breites Spektrum an Fachwissen, Dienstleistungen und gut kuratierten wissenschaftlichen Inhalten für Bibliothekare, Verleger, Forscher und Geldgeber. OAPEN fördert und unterstützt den Übergang zu Open Access für akademische Bücher durch die Bereitstellung offener Infrastrukturdienste für die Akteure der wissenschaftlichen Kommunikation. Wir arbeiten mit Verlagen zusammen, um eine qualitätsgeprüfte Sammlung von Open-Access-Büchern aufzubauen, und bieten Dienstleistungen für Verlage, Bibliotheken und  Forschungsförderer in den Bereichen Hosting, Hinterlegung, Qualitätssicherung, Verbreitung und digitale Bewahrung.


Das DOAB (Directory of Open Access Books) ist ein von der Community betriebener Suchdienst, der wissenschaftliche, von Experten begutachtete Open-Access-Bücher indexiert und zugänglich macht und Nutzern hilft, vertrauenswürdige Open-Access-Buchverlage zu finden. Alle DOAB-Dienste sind kostenlos und alle Daten sind frei verfügbar.


Beide Initiativen sind für die Gemeinschaften rund um die NFDI-Konsortien der MoU-Gruppe von Bedeutung: NFDI4Culture, Text+, NFDI4Memory, und NFDI4Objects.

Silke Davison und Sebastiano Sali, Community Manager bei OAPEN & DOAB, werden die Zuhörer in beide Dienste einführen, die Vorteile für unsere Communities aufzeigen und über einige der vielen bereits bestehenden Arbeitsbeziehungen mit Institutionen der deutschen Wissenschaft sprechen.

Am Ende des Vortrags sollen die Teilnehmer Lust bekommen, sich mit den Diensten von OAPEN und DOAB sowie mit Open-Access-Publikationen zu beschäftigen. Dieser Vortrag wird in Englisch gehalten.

Zielpublikum 

Die Veranstaltung richtet sich an Personen, die in den Sozial- und Geisteswissenschaften forschen, an einer Infrastruktureinrichtung in diesem Bereich arbeiten oder sich einfach für das Thema interessieren. Darüber hinaus sind auch Teilnehmer aus anderen NFDI-Konsortien besonders willkommen.

Für weitere Informationen zur Veranstaltung und zur Anmeldung bitte hier entlang.

Durch den DHd-Publikationsfonds gefördert: »halb und halb« – Hybride Edition als Kompromiss?

2024年12月11日 23:26

In diesem Jahr ist meine Dissertationsschrift mit dem Titel »halb und halb« – Hybride Edition als Kompromiss? Eine Studie zu Methodik, Möglichkeiten und Grenzen in der hybriden Musikedition am Beispiel der Edition von Ludwig Baumanns »Kantate. Den Gefallenen zum Gedächtnis, den Trauernden zum Trost« beim Logos-Verlag Berlin erschienen. Die Publikation ist sowohl im Druck (teilw. in Farbe) erhältlich als auch im Open Access (PDF, Vollfarbe) und das ganz ohne Moving- oder Paywall (DOI: 10.30819/5730 und auf Zenodo).

Es freut und ehrt mich sehr, dass der Vorstand der DHd den Antrag auf Unterstützung genehmigt hat und diese Dissertationsschrift durch den DHd-Publikationsfonds gefördert werden konnte.

Was ist eigentlich eine hybride Edition? Eine Frage, die wir uns noch öfter stellen sollten. Es gibt eine große Zahl traditioneller und digitaler Editionen und auch Forschungsliteratur hierzu. Was ist aber mit den Editionen, die eine Brücke zwischen traditioneller und digitaler Edition bilden? Die Forschungsliteratur hierzu ist ziemlich ›dünn‹. Im Bereich der Musikedition werden seit etwa 20 Jahren hybride Editionen angestrengt, die nahe zu alle in Langzeit-Akademieprojekten produziert werden. Umfassende Erörterungen, was eine hybride Musikedition ist, gab es bisher allerdings nicht.

Die Schrift »halb und halb« – Hybride Edition als Kompromiss? begegnet diesem Desiderat auf eigene Weise. In der zweiteiligen Anlage wird zunächst eine scheinbar traditionelle Musikedition präsentiert, die spätestens im Kritischen Bericht die Grenzen des Medium Buch aufzeigt. Die Kritischen Anmerkungen sind nicht nur wegen ihres Umfangs digital erfasst, sondern weil es nach knapp 20 Jahren nötig erschien, diese »medienadäquater zu gestalten« (S. 330). Schließlich sind kritische Berichte von Natur aus streng schematisch und müssten sich geradezu einfach in XML modellieren lassen (vgl. Kap. I.6.3 & II.4.2.2).

Den zweiten Teil der Arbeit bildet eine theoretische Abhandlung zur hybriden (Musik-)Edition. Schwerpunkte liegen auf der Forschungssoftware Edirom (Kap. II.2) und auf dem Phänomen Online-Portal (Kap. II.3), das bei hybriden und digitalen Editionen immer stärker in Erscheinung tritt. Die Edition im ersten Teil der Arbeit wird aktiv in die Theoriebildung einbezogen, um methodische Fragen gezielt erörtern zu können. Ergänzt wird diese Dissertationsschrift durch eine umfangreiche und ebenfalls im Open Access publizierte Datensammlung (DOI: 10.5281/zenodo.10072484).

Teilnehmende gesucht für Umfrage zu Herausforderungen und Hindernissen beim Open-Access-Publizieren

2024年11月30日 00:01

via Christian Hauschke, TIB – Leibniz Information Centre For Science And Technology

Das IDAHO-Projekt der TIB – Leibniz-Informationszentrum Technik und Naturwissenschaften lädt Forschende ein, an einer weltweiten Umfrage des IDAHO-Projekts zur Identifizierung von Hindernissen für das Open-Access-Publizieren teilzunehmen. 

IDAHO steht für „Identifikation von Barrieren für Open-Access-Veröffentlichungen für Forschende mit schwachen institutionellen Anbindungen – epistemische Ungerechtigkeit im wissenschaftlichen Publikationswesen“. Das Projekt möchte zu einer inklusiven, fairen und vielfältigen Open-Access-Publikationskultur beizutragen. Dazu gehört die Identifikation spezifischer Barrieren, denen Autor*innen mit schwacher institutioneller Anbindung gegenüberstehen, worauf evidenzbasierte Empfehlungen entwickelt, um diese Barrieren zu beseitigen oder zumindest abzumildern. 

Eingeladen sind unter anderem Bürgerwissenschaftler:innen (Citizen Scientists), Forschende aus der Zivilgesellschaft und gemeinnützigen Organisationen, Forschende im Ruhestand sowie solche, die in kleinen und mittleren Unternehmen, Kliniken, Krankenhäusern und anderen Organisationen mit unabhängiger Forschung weltweit tätig sind.

Die Umfrage ist anonym, erfordert keine persönlichen oder identifizierenden Informationen und kann in etwa 15 Minuten ausgefüllt werden. Sie ist ist bis zum 6. Januar 2025 geöffnet.

Um an der Umfrage teilzunehmen, klicken Sie bitte https://tib.eu/umfragen/index.php/895232?lang=en

Kontakt: Nataliia Kaliuzhna nataliia.kaliuzhna@tib.eu und Zeynep Aydin Zeynep.Aydin@tib.eu

Weitere Informationen über das Projekt IDAHO: https://projects.tib.eu/idaho/ueber-idaho/

Online-Workshop: Forschung gestalten und Publikationsfreiheit nutzen – Open-Access-Publizieren in den Geschichtswissenschaften (6.12.2024)

2024年11月26日 02:15

Linda Martin (Open-Access-Büro Berlin), Jesko Rücknagel (TIB Hannover)

Termin: 6.12.2024, 10:00-12:00 Uhr, online (Anmeldung siehe unten)

Beschreibung:

Im Rahmen der Veranstaltungsreihe „Praxislabor“ der AG Digitale Geschichtswissenschaft im Verband der Historiker und Historikerinnen Deutschlands findet am 6. Dezember ein offener Workshop zum Thema Open Access statt. Wissenschaftliche Publikationen, ob in Form einer Monographie, eines Sammelbandbeitrages oder eines Artikels, dienen der Präsentation von Forschungsergebnissen und sind häufig eng mit dem Wunsch nach Erhöhung der eigenen Reputation verknüpft. Welche Rolle nimmt das Publizieren im Open Access – der Schaffung von freiem Zugang zu wissenschaftlicher Information im Internet – hierbei ein?

Im Online-Workshop stehen die Erst- und Zweitveröffentlichung (häufig als Self Archiving betitelt) von konventionellen Publikationen im Fokus. Warum lohnt es sich für Forschende, ihre Werke zur offenen, selbst bestimmten Nachnutzung (über die Wahl einer offenen Lizenz) freizugeben? Unter welchen rechtlichen Bedingungen können die eigenen Texte zugänglich gemacht werden? Welche Positionen nehmen Förderorganisationen ein und welche Unterstützung bieten Bibliotheken und Open-Access-Expert*innen?

Neben einer Einführung haben Teilnehmende die Möglichkeit in einer Q&A-Session offene Fragen zu platzieren. Das Angebot wird im Rahmen des BMBF-geförderten Projekts open-access.network umgesetzt.

Adressat:innen: wissenschaftlich Publizierende aller Karrierestufen, mit und ohne Vorkenntnisse

Registrierung: bis zum 2.12.2024 via https://open-access.network/fortbilden/workshops/workshops-disziplinaere-angebote-in-kooperation-mit-fachgesellschaften/geschichtswissenschaften

Kontakt: Linda Martin, linda.martin@open-access-berlin.de

Weitere Informationen:

https://open-access.network/informieren/open-access-in-fachdisziplinen/geschichtswissenschaften

https://open-access.network/fortbilden/workshops/workshops-disziplinaere-angebote-in-kooperation-mit-fachgesellschaften

Event: Open Access Belgium 2024

2024年10月15日 22:51

Open Access Belgium would like to invite you to join the Open Access Network Event on the 12th of December to share best practices, foster community, and encourage knowledge-sharing on Open Access. By focusing on practical cases regarding predatory practices and copyright and rights retention, the participants get the chance to discover best practices, concrete advice and a deeper insight into those topics.

Anyone interested in Open Access is welcome, though the main focus will be on research support staff. Registration is free, though mandatory.

Programme

Morning – Predatory practices

  • Introduction to predatory practices 
  • Panel discussion: 3 cases tackled by the panel
  • Case market: Interactively contribute to assigned cases to design solutions

Afternoon – Copyright and rights retention

  • Introduction to copyright and rights retention
  • Panel discussion: 3 cases tackled by the panel
  • Case market: Interactively contribute to assigned cases to design solutions

Networking opportunities during the breaks and lunch to get to know your colleagues in research support

Practicalities

  • When: 12th of December 2024
  • Where: the event will take place at HOEK 38 (38 Leuvenseweg 1000 Brussels), in the Auditorium
  • Who: for researchsupport staff, by researchsupporstaff
  • Learn more: click here to learn more
  • Registration: Registration is free but mandatory. Click here to register before the 21st of November!
visual of the Open Access Belgium Event

Stellenausschreibung: FU Berlin sucht Mitarbeiter*in für den Community-Aufbau „Open Encyclopedia System“

2024年8月8日 22:53

Der Bereich „Digitale Forschungsinfrastrukturen“ der FUB-IT an der Freien Universität Berlin stellt mit dem Open Encyclopedia System eine webbasierte Plattform zur Erstellung und Publikation von wissenschaftlichen Online-Referenzwerken im Open Access bereit. Im Rahmen der auf zwei Jahre befristeten Stelle (70% E13 TV-L) sollen tragfähige Strukturen für den Austausch zwischen OES-Anwender*innen und für die systematische Bedarfserhebung aufgebaut, Informations- und Lernangebote für den niedrigschwelligen Einstieg in die OES-Nutzung entwickelt sowie Prozesse der Selbstorganisation bei Pflege und Erweiterung von Code und Materialien etabliert werden.

In enger Abstimmung mit dem OES-Team an der FUB-IT und in Zusammenarbeit mit aktiven OES-Nutzer*innen bearbeiten Sie folgende Aufgaben:

– Konzeption und Durchführung einer Umfeldanalyse zu geisteswissenschaftlichen Forschungsinfrastrukturen mit „verteilter Verantwortung“ zur Identifikation von Modellen und Erfolgsfaktoren
– strukturierte Erhebung der Bedarfe der OES-Anwender*innen sowie bedarfsorientierte koordinierte Planung neuer OES-Funktionalitäten
– Konzeption und Aufbau von Informations- und Vermittlungsangeboten zu OES inkl. Maßnahmen zum „Onboarding“ neuer OES-Nutzer*innen
– Aus- und Aufbau von Kommunikationsstrukturen innerhalb der Community sowie von Konzepten für die kollaborative standortübergreifende Weiterentwicklung von OES
– Ausarbeitung und Umsetzung von Maßnahmen zur Etablierung einer Community of Practice
– Organisation und Durchführung von Workshops und Community-Treffen
– Öffentlichkeitsarbeit (u. a. Webseite, Social Media, Präsentation auf Tagungen)

Weitere Informationen erteilt Frau Dr. Brigitte Grote (brigitte.grote@fu-berlin.de / 030 838 55031).

Deadline: 23.09.2024

Stellenausschreibung und weitere Informationen: https://www.fu-berlin.de/universitaet/beruf-karriere/jobs/nichtwiss/57_ze-fub-it/FUB-IT-FUB-IT-LSF-COMOES-01.html

❌