Wo treffen Daten, Methoden und Infrastrukturen auf Werte, Kreativität und kritisches Denken? Unter dem Motto „Linking Europe: Digital Humanities Without Borders“ stellte die EADH-Konferenz 2026 in Krakau diese Frage ins Zentrum. Dabei ging es darum, was digitale Methoden und Infrastrukturen möglich machen, wie wir diese Möglichkeiten nutzen wollen und welche Verantwortung damit verbunden ist.
Dieser Beitrag entstand im Rahmen eines Early-Career-Reisekostenstipendiums des DHd-Verbands für DH-nahe Tagungen. Vielen Dank, dass ich dadurch an der EADH-Konferenz teilnehmen konnte.
Was bleibt, wenn das Projekt endet?
Was passiert mit einer digitalen Edition, wenn die Förderung ausläuft? Diese zunächst recht praktische Frage stand im Zentrum des Workshops „Is Everything Already Lost?! Participative Workshop on Strategies for Ensuring the long-term Hosting of Digital Scholarly Editions”. Dabei wurde schnell deutlich, dass langfristige Verfügbarkeit mehr bedeutet, als Forschungsdaten irgendwo dauerhaft abzulegen. Auch Software muss gewartet werden, technische Abhängigkeiten verändern sich und Interfaces können selbst Teil des wissenschaftlichen Arguments einer Edition sein. Für statische Formate, Repositorien oder Verlagsmodelle sprechen jeweils unterschiedliche Gründe, doch keine Lösung nimmt einem die Frage ab, wer die nötigen Ressourcen langfristig bereitstellt. Für mich blieb deshalb vor allem ein Gedanke hängen: Das Ende des Projekts sollte schon an seinem Anfang mitgedacht werden. Was soll in fünf, zehn oder zwanzig Jahren von einer digitalen Edition noch zugänglich sein und, ebenso wichtig, wie soll sie dann noch genutzt werden können?
Welche DH wollen wir eigentlich?
Den größeren Rahmen für solche Fragen eröffnete Melissa Terras in ihrer Eröffnungskeynote „Dreaming of Different DH Futures: Engaging with Speculative Design Approaches“. Ihre Stimmung angesichts der aktuellen Entwicklungen und ihre Hoffnungen für die Zukunft der DH beschrieb sie mit dem Bild eines Metronoms: ein ständiges Pendeln zwischen dem Gefühl, dass ohnehin alles verloren sei, und der Überzeugung: „a better world is possible“.
Ausgangspunkt ihrer Überlegungen war die Frage, wie sich die DH verändern, wenn Bedingungen, unter denen sich das Fach entwickelt hat, nicht mehr selbstverständlich sind. Dabei rückte Terras vor allem die Werte in den Mittelpunkt, auf denen viele Praktiken der DH beruhen. Open Source und FAIR-Prinzipien gehören für viele zum Selbstverständnis des Fachs. Doch was bedeutet Offenheit in einer Situation, in der frei zugängliche Forschungs- und Kulturdaten zunehmend auch für kommerzielle KI-Systeme interessant werden? Und wie gehen die DH damit um, wenn um Cultural-Heritage- und Forschungsdaten neue Märkte entstehen?
Terras ging es dabei weniger um fertige Antworten als darum, mögliche Entwicklungen konsequent weiterzudenken. Anhand spekulativer Szenarien zeigte sie, welche Entscheidungen auf das Fach zukommen können: Welche Praktiken wollen wir offenhalten? Wo könnte es Gründe geben, Zugänge zu beschränken? Und welche Werte sollen dabei handlungsleitend sein?
Besonders hängen geblieben ist mir schließlich ihr Gedanke, digitale Langzeitarchivierung als einen hoffnungsvollen Akt zu verstehen. Wer Daten für künftige Generationen bewahrt, geht schließlich davon aus, dass es diese Generationen auch geben wird.
Wer wird in den Daten sichtbar?
Wenig überraschend spielte generative KI in vielen Beiträgen der Konferenz eine Rolle, etwa um komplexe Suchsysteme leichter zugänglich zu machen oder lexikografische Arbeit zu unterstützen. Am meisten beschäftigt haben mich aber die Beiträge, die einen Schritt zurück gingen und fragten, auf welchen Daten all diese Möglichkeiten eigentlich beruhen und wer darin sichtbar wird.
Besonders deutlich wurde diese Frage bei Beiträgen zu kleineren und weniger gut digital erschlossenen Sprachen. Ob Masurisch, Altserbisch, Rumänisch oder Mittelpersisch: Aus ganz unterschiedlichen Perspektiven ging es darum, Daten, Annotationen und digitale Infrastrukturen für Sprachen aufzubauen, die in der Sprachtechnologie bislang weniger stark vertreten sind. Sprachliche Vielfalt ist damit auch eine Frage digitaler Infrastruktur. Fehlen Daten, Modelle oder Ressourcen für eine Sprache, bleibt sie auch in Suchsystemen, NLP und generativer KI weniger sichtbar. Das Konferenzmotto „Without Borders“ bekam hier für mich noch einmal eine andere Bedeutung: Mehr Technologie lässt solche Grenzen nicht automatisch verschwinden. Mitunter wird dadurch erst besonders deutlich, wo Daten und Ressourcen fehlen.
Zugleich ging es nicht nur darum, ob Daten vorhanden sind, sondern auch darum, wer über sie verfügen kann. Beiträge zu Data Colonialism und Indigenous Data Sovereignty im Kontext generativer KI und bedrohter Sprachen rückten Fragen nach Kontrolle und Nutzung in den Vordergrund: Wer erhebt Daten, wer kann auf sie zugreifen und unter welchen Bedingungen dürfen sie weiterverwendet werden?
Linking Europe heißt auch: Infrastrukturen verbinden
Auch das „Linking“ im Konferenzmotto wurde ganz konkret: Beiträge zu gemeinsamen Taxonomien, verknüpften Forschungsdaten und wiederverwendeten technischen Komponenten zeigten, wie viel Arbeit hinter interoperablen Forschungsinfrastrukturen steckt. Denn Interoperabilität klingt zunächst technisch, ist im Kern aber eine Voraussetzung dafür, dass Forschung über einzelne Projekte, Sprachen und Länder hinweg anschlussfähig wird.
Was nehme ich mit?
So unterschiedlich die Eindrücke in Krakau waren, liefen viele von ihnen auf eine gemeinsame Frage hinaus: Wie wollen wir die Digital Humanities gestalten? Welche Werte schreiben wir in unsere Methoden und Infrastrukturen, wer wird durch sie sichtbar und wie sorgen wir dafür, dass das, was wir heute entwickeln, auch in Zukunft zugänglich und nutzbar bleibt?
Als Nachwuchswissenschaftlerin fand ich es besonders spannend zu sehen, wie unterschiedlich diese Fragen innerhalb der europäischen DH-Community diskutiert und beantwortet werden. Neben vielen methodischen Anregungen nehme ich vor allem eins mit nach Hause: Digitale Infrastrukturen und Methoden sind nicht nur technische Lösungen, wir treffen mit ihnen auch immer Entscheidungen, wie Forschung künftig möglich sein soll.
Nach der DHd2026 in Wien war die EADH2026 in Krakau meine zweite große DH-Konferenz. Das Reisekostenstipendium des DHd-Verbands hat mir ermöglicht, über die eigene Universität und die deutschsprachige DH-Community hinauszuschauen. Dafür und für viele Gespräche und Ideen: Dziękuję, Kraków!
Sophia Babl, Masterstudium Digital Humanities, Universität Regensburg
Die Vorträge finden im hybriden Format statt. Eine vorherige Anmeldung für die einzelnen Termine ist nicht erforderlich.
Programm für das Wintersemester 2026/27
02.11.2026 Dr. Katja Politt (Rostock / Bielefeld) HDGDL dein ALLER größter Fan JoSiE – Korpuslinguistische Zugänge zu Intensivierung in YouTube-Kommentaren
16.11.2026 Sören Barkey (Potsdam) Verwobene Welten? Digital und Environmental Humanities
23.11.2026 Fernanda Wolff und Johannes Ioannu (beide Berlin) Von der Briefedition zum Themenbrowser: Ein modularer Topic-Modeling-Workflow am Beispiel Jean Pauls
Die Computational Literary Studies (CLS) haben sich in den letzten Jahren als wichtige Teildisziplin im Umfeld der Digital Humanities (DH) etabliert. Die Relevanz der CLS wird nicht zuletzt auf den DH-Konferenzen sichtbar, die von der Alliance of Digital Humanities Organizations (ADHO) ausgerichtet werden, alljährlich stattfinden und die DH-Community in ihrer ganzen Breite und Vielfalt zusammenbringen. Auch auf der DH-Konferenz 2026, die in Daejeon (Südkorea) unter dem Motto „Engagement“ vom 27. bis 31. Juli stattfand, waren die CLS präsent. Ziel dieses Blogposts ist, einen Überblick über CLS-Beiträge und -Trends auf der DH2026 zu geben (für einen ähnlichen Blogpost zu den DHd-Konferenzen siehe Guhr 2025). Ein Schwerpunkt meines Beitrags liegt auf einer besonders wichtigen DH- und CLS-Tendenz der letzten Jahre: der zunehmenden Auseinandersetzung mit Large Language Models (LLMs).
Quantitatives
Das Book of Abstracts zur DH2026 umfasst 513 Beiträge: Short und Long Paper, Poster, Workshops und Mini-Konferenzen (vgl. https://doi.org/10.5281/zenodo.21495909). Davon verorteten sich 137 (27%) im Feld der ‚Literary Studies‘.1 Somit zählten die Literaturwissenschaften zu den prominentesten Disziplinen auf der DH-Konferenz (zum Vergleich: ‚History‘ = 155 Beiträge; ‚Library & Information Science‘ = 110 Beiträge; ‚Computer Science‘ = 99 Beiträge; ‚Linguistics‘ = 83 Beiträge; ‚Art History‘ = 53 Beiträge).
Die 137 ‚Literary Studies‘-Beiträge auf der DH2026-Konferenz stammen von 386 Autor:innen. Tab. 1 zeigt, mit welchen Ländern die Autor:innen affiliiert sind. Sofort wird die große Zahl von CLS-Forscher:innen aus Deutschland deutlich: Es gab kein anderes Land, mit dessen Forschungsinstitutionen mehr Autor:innen affiliiert waren.2 Am zweitmeisten Forscher:innen kamen, wenig überraschend, aus den USA. Auffällig, und gegebenenfalls durch den Konferenzort bedingt, war daneben die große Zahl von Autor:innen aus asiatischen Ländern (Südkorea, Japan, China, Hong Kong).
Land
Anzahl Autor:innen
Anteil
Deutschland
78
0.2
USA
63
0.16
Südkorea
56
0.15
Japan
33
0.09
China
27
0.07
Frankreich
17
0.04
Kanada
16
0.04
Hong Kong
13
0.03
Rumänien
12
0.03
United Kingdom
10
0.03
Tab. 1: Affiliationen der 386 Autor:innen von ‚Literary Studies‘-Beiträgen auf der DH2026
Blickt man auf die ‚Keywords‘, die den 137 ‚Literary Studies‘-Beiträgen der DH2026-Konferenz zugeordnet waren (Tab. 2), zeigt sich vor allem die große Relevanz von LLMs. Würde man Keywords wie ‚Artificial Intelligence‘ (5 Beiträge) oder ‚Generative AI‘ (4 Beiträge) ebenfalls den LLMs zurechnen, wäre ihr Anteil sogar noch größer. Die Daten weisen darauf hin, dass sich auch auf der DH2026 der Trend zur Auseinandersetzung mit LLMs niederschlug, der die DH und die CLS in den letzten Jahren insgesamt kennzeichnet. Daneben weisen die Keywords darauf hin, dass weiterhin grundlegende Ressourcen- und Datenfragen eine Rolle spielen (TEI, Metadata, Linked Open Data). Zudem finden sich auf etwas niedrigeren, in Tab. 2 nicht mehr repräsentierten Rängen etablierte Methoden bzw. Ansätze wie ‚Topic Modeling‘ oder ‚Stylometry‘ (jeweils vier Beiträge) sowie ‚Knowledge Graph‘, ‚Sentiment Analysis‘ und ‚Annotation‘ (jeweils drei Beiträge), die nach wie vor zum Einsatz kommen.
Keyword
Anzahl Beiträge
Anteil
Large Language Models
22
0.16
Computational Literary Studies
14
0.1
Digital Humanities
11
0.08
Natural Language Processing
9
0.07
TEI
7
0.05
Metadata
6
0.04
Cultural Analytics
6
0.04
Artificial Intelligence
5
0.04
Linked Open Data
5
0.04
Intertextuality
10
0.04
Tab. 2: Keywords der 137 ‚Literary Studies‘-Beiträge auf der DH2026
Einzelne Veranstaltungen und Beiträge
Die ersten zwei Tage der DH-Konferenz waren wie üblich für Workshops und Minikonferenzen reserviert. Aus CLS-Perspektive war das Treffen der Special Interest Group ‚Digital Literary Studies‘ (SIG-DLS) am Dienstagnachmittag von besonderem Interesse (https://dls.hypotheses.org/2318). Die SIG-DLS ist eine von elf Special Interest Groups der ADHO und „brings together researchers from different perspectives to discuss theoretical, methodological and technical issues of doing digital literary studies, share resources, and organize events and initiatives“ (https://dls.hypotheses.org/). Das Treffen bestand aus einer Serie von Lightning Talks und einer anschließenden Postersession. Deutlich wurde die große Vielfalt der untersuchten Gegenstände und genutzten Methoden. Das Spektrum reichte von der Analyse formaler Merkmale galicischer Lyrik (Pablo Ruiz Fabo) über die Auswertung von Korrespondenzbeziehungen zwischen DDR-Autor:innen mittels Netzwerkanalyse (Marco Lorenz) oder die Differenzierung verschiedener Kanonizitätsindikatoren für englischsprachige Literatur (Haruka Tsutsui) bis hin zum Vergleich von Word Embeddings je nachdem, ob sie auf Texten von Charles Dickens oder anderen englischsprachigen Autor:innen beruhen (Tomoji Tabata). Auch LLMs spielten eine Rolle: Silvia Lilli untersuchte, inwiefern GPT 5.2 plausible Analysen literarischer Texte generieren kann und wie sich die LLM-Outputs verbessern lassen, indem man dem Modell Annotationen bereitstellt; Jenny Kwok ging darauf ein, inwieweit LLMs relevante Kontexte für literarische Texte identifizieren können, die dann wiederum das manuelle Close Reading bereichern; Kohei Furuya widmete sich der Autorschaftsattribution durch LLMs im Kontext englisch-japanischer Übersetzungen.
Unter den Keynotes war besonders diejenige von Maciej Eder einschlägig für die CLS. Eder sprach stellvertretend für die Computational Stylistics Group bzw. das Team hinter dem Stilometrie-Tool stylo, die den Zampolli-Preis 2026 erhalten hatten (https://adho.org/2025/07/16/2026-antonio-zampolli-prize/). Er stellte unter anderem die Arbeit der Gruppe sowie das Tool stylo vor, präsentierte eine exemplarische Analyse zu Stilunterschieden in der Rede von Dramenfiguren (Šeļa et al. 2024) und betonte vor allem, dass Projekte und Initiativen nicht unbedingt mit einer umfassenden finanziellen Förderung, einer formalisierten Organisationsstruktur und/oder einer ‚großen Idee‘ starten müssen, sondern sich auch oder sogar am ehesten ‚bottom up‘, in kleinen Schritten entwickeln können.
Die einzelnen Konferenzsessions waren nicht spezifischen Methoden oder Disziplinen zugeordnet, sodass reine CLS-Sessions die Ausnahme blieben. Die erhebliche methodische und thematische Heterogenität der Sessions könnte man in einem positiven Sinn als Beitrag zum Austausch und zur Verknüpfung innerhalb der mittlerweile stark ausdifferenzierten DH-Community begreifen; andererseits erschwerte die Uneinheitlichkeit der Sessions, kohärente Diskussionszusammenhänge entstehen zu lassen. Trotz allem lassen sich einige übergreifende Tendenzen der CLS-Beiträge ausmachen. Dabei gilt, wie bereits im Fall des SIG-DLS-Treffens, dass dieser Blogpost exemplarisch bleiben muss. Ich beschränke mich auf drei Punkte:
(1) Mehrere Beiträge haben sich neuen, überarbeiteten und/oder erweiterten Tools, Korpora und Infrastrukturen und damit den Grundlagen der CLS-Analyse gewidmet. Henny Sluyter-Gäthje hat beispielsweise eine Sammlung von Ecocriticism-Korpora vorgestellt (https://ecocor.org/), die technologisch an DraCor anknüpft (Trilcke et al. 2026). DraCor selbst, eine besonders wichtige Plattform für Dramenkorpora in verschiedenen Sprachen (https://dracor.org/), war ebenfalls auf der Konferenz vertreten (Giovannini et al. 2026) und wurde auch von Eder in seiner Keynote als hilfreiche Ressource hervorgehoben. Zu nennen ist des Weiteren das GOLEM-Korpus, das aktuell erarbeitet wird und Fanfiction in sieben Sprachen (allerdings nicht Deutsch) sowie diverse Annotationen (z. B. Koreferenzen, Figuren, Events) enthält (Pianzola 2026; Yang/Pianzola 2026).
(2) Auffallend viele Vorträge haben sich mit der manuellen und automatisierten Emotions- und Sentimentanalyse befasst. Untersucht wurden unterschiedlichste Textsorten und Sprachen: von koreanischer Gegenwartslyrik (Lim/Kim 2026) über russische Kurzprosa des 20. Jahrhunderts (Kirina 2026) bis zu – jenseits der Literatur – historischen Zeitschriften (Brozic 2026) und persönlichen Holocaust-Zeugnissen (Neovesky et al. 2026). Insgesamt zeigten sich die Sentiment- und Emotionsanalyse als etablierte Ansätze der CLS und DH, wobei ein hohes Bewusstsein für konzeptuelle Unterscheidungen wie der zwischen Sentiment und Emotion oder diskreter versus dimensionaler Emotionsmodelle bestand.
(3) Diverse Beiträge haben sich, wie bereits angedeutet, mit LLMs auseinandergesetzt. Der Einsatz von LLMs zur automatisierten Annotation kann mittlerweile als etabliert gelten und spielte für zahlreiche Vorträge und Poster eine Rolle. Daneben war auffällig, dass sich viele Beiträge auch mit den generativen Aspekten von LLMs befasst haben, insbesondere mit der Frage, wie sich LLM-generierte literarische Texte von menschlichen unterscheiden. Durchgespielt wurde dies etwa anhand von englischsprachigen K-Pop Lyrics (Florescu/Dinu 2026) sowie der Literatur Han Kangs (Lee et al. 2026), Xin Qijis (Liao et al. 2026) und Leopold Trymands (Rykowska 2026). Betont wurde in allen Fällen, dass LLMs die menschlichen Texte nicht exakt nachahmen können, sondern Unterschiede bestehen bleiben. Auf einer allgemeineren, die eigene Forschung betreffenden Ebene haben mehrere Beiträge zudem betont, dass die Arbeit mit LLMs nicht dazu führen dürfe, relevante Entscheidungen auf eine Weise zu delegieren, die Forscher:innen in zentralen konzeptionellen und interpretativen Fragen von den Modellen abhängig werden lasse. Stattdessen sei wichtig, als Mensch die ‚epistemic agency‘ zu bewahren (vgl. jenseits reiner CLS-Kontexte etwa den Workshop von Hiltmann/Kim-Baumann 2026 sowie die Keynote von Kim Hyeon).
Insgesamt hat sich auf der DH-Konferenz 2026 abermals gezeigt, wie vielfältig und lebendig die CLS im Rahmen der DH sind. Vertreten waren Forscher:innen aus diversen Ländern, die sich mit unterschiedlichsten Texten und Sprachen befasst und dabei unterschiedlichste Methoden angewandt haben. Trotz aller Heterogenität lässt sich festhalten, dass ein anhaltender Schwerpunkt die Auseinandersetzung mit LLMs darstellt, die mittlerweile regelmäßig für Annotationsaufgaben verwendet, aber auch in ihrer textgenerativen Funktion untersucht werden.
Dank
Ich danke dem DHd-Verband, der mir durch ein Reisekostenstipendium die Teilnahme an der DH2026-Konferenz in Daejeon (Südkorea) ermöglicht hat.
Literaturverzeichnis
Brozić, Lucija (2026): „Sentiments toward Migrants and Minorities: Fine-Tuning Transformer Models for Sentiment Analysis of Historical Newspapers.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Florescu, Andra-Maria/Dinu, Anca Daniela (2026): „The ‘K’ Factor: Comparing Human and LLM-Generated English Lyrics in K-Pop.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Giovannini, Luca/Sluyter-Gäthje, Henny/Skorinkin, Daniil/Trilcke, Peer/Börner, Ingo/Fischer, Frank/Khilji, Tabeer (2026): „A Decade in Drama Research. Data Mining the DraCor Bibliography (2015–2025).“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Guhr, Svenja (2025): „Trends in den Computational Literary Studies bei den DHd-Jahrestagungen.“ DHd-Blog, 13.05.2025. https://dhd-blog.org/?p=22316.
Hiltmann, Torsten/Kim-Baumann, Noah Jefferson (2026): „Bringing Humanist Practices into AI – Establishing and Maintaining Sovereignty when Working with LLMs.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Kirina, Margarita (2026): „Annotating Data, Exploring Emotions: A Case of Russian Short Prose of the 20th Century.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Lee, Jae-Yon/Jang, MinHyeok/Jeon, Minguk/Moon, Ji-Seong/Kang, MinJin/Bae, Byung-Chull (2026): „From Poetic Prose to Science Fiction: Classifying and Generating Han Kang’s Literary Style via Computational Methods.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Liao, Zhewei/Xiao, Shuang/Sui, Shengnan/Han, Yafei/Lu, Quanyu (2026): „Large Language Models’ Capability Boundaries in Generating Xin Qiji’s Ci Poetry: A Humanistic Evaluation Study.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Lim, Iro/Kim, Byungjun (2026): „KPoEM: Visualizing Emotion Data in Modern Korean Poetry through a Web-Based Interface Prototype.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Neovesky, Anna/Brolich, Nina/Romeis, Finn/Menny, Anna/Geibel, Helena/Giesecke, Marc (2026): „Insight or Misrepresentation? A case study on sentiment analysis of personal accounts of the Holocaust.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Pianzola, Federico (2026): „The GOLEM Annotated Corpus for Computational Literary Studies.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Rykowska, Aleksandra (2026): „Can LLMs Imitate an Author’s Style? Comparative Stylometric Study of ChatGPT, Gemini, and Claude.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Šeļa, Artjoms/Nagy, Benedek/Byszuk, Joanna/Hernández-Lorenzo, Laura/Szemes, Botond/Eder, Maciej (2024): „From Stage to Page: Language Independent Bootstrap Measures of Distinctiveness in Fictional Speech.“ In: M. Andersen/N. Reiter (Hg.), Computational Drama Analysis. Reflecting on Methods and Interpretations, S. 149–166. Berlin: De Gruyter.
Trilcke, Peer/Barkey, Sören/Schumacher, Mareike/Börner, Ingo/Milling, Carsten/Skorinkin, Daniil/Sluyter-Gäthje, Henny/Haider, Thomas/Schwindt, Mark/Busch, Anna/Fischer, Frank/Funk, Clara/Giovannini, Luca/Helmig, Clara/Viebke, Gesine/Khilji, Tabeer/Käb, Corinna/Ottenberg, Bianca Linnea/Daniel, Rebecca (2026): „Introducing EcoCor: An Open Infrastructure for Digital Ecocriticism.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Yang, Xiaoyan/Pianzola, Federico (2026): „Engaged Annotators: Developing a Multilingual Character Annotation Framework for Fiction.“ In: Digital Humanities 2026: Book of Abstracts. https://doi.org/10.5281/zenodo.21495909.
Der Anteil entspricht in etwa dem Niveau der vergangenen Jahre: 2022 (https://github.com/ADHO/dh2022) = 25%; 2023 (https://doi.org/10.5281/zenodo.7961822) = 25%. Die Book of Abstracts der DH-Konferenzen 2024 und 2025 sind nur als PDFs zugänglich und wurden daher nicht ausgewertet. ︎
Auch wenn man die Beiträge betrachtet, die nicht den ‚Literary Studies‘ zugeordnet waren, kamen am meisten Autor:innen aus Deutschland, gefolgt von den USA. ︎
Literary historians maintain that women have never contributed significantly to the German drama. Facts, however, point clearly to the opposite. Indeed, the first known German dramatist (10th century) was a woman! Two major causes for the lack of historic recognition are: (a) prejudice that women are incapable of good dramatic production, (b) underrating of plays because professional critics—traditionally men—have used male psychology as the criterion for judging female characters in plays by women. A revaluation of women’s contributions to drama is imperative. (Scholtz Novak 1972, 47)
When the German-born American scholar of German literature Sigrid Scholtz Novak issued her call for greater recognition of women playwrights in the early 1970s, she was responding to a literary historiography that had either largely overlooked women’s extensive dramatic production or fundamentally questioned its aesthetic and historical significance. More than five decades later, scholarly engagement with women playwrights has expanded considerably. Nevertheless, the problem of accessibility identified by Scholtz Novak remains unresolved. Many plays by women are still available only in historical print editions, are dispersed across libraries and archives, or are absent from the digital text collections that increasingly underpin literary-historical scholarship and computational research.
Within the Digital Humanities, accessibility entails more than the provision of a digital surrogate. For literary works to be discoverable, systematically analysable, and reusable across different research contexts, they must be represented in structured and interoperable formats, documented with reliable metadata, and integrated into sustainable research infrastructures. Digital corpora therefore are not neutral representations of literary history. Their composition reflects historical processes of publication, preservation, canon formation, scholarly reception, selection, and digitisation. As a result, works by women remain substantially underrepresented in many digital collections.
Against this background, the University of Rostock will host the hackathon Women Playwrights in Digital Corpora from 7 to 9 September 2026. The event will address both the digital representation and computational analysis of plays by women, with particular attention to their integration into the DraCor research infrastructure.
DraCor (short for Drama Corpora) is an open and multilingual research infrastructure for the computational study of drama from antiquity to the twentieth century. Its corpora are encoded according to the guidelines of the Text Encoding Initiative (TEI) and made available through a web interface and an application programming interface (API). DraCor currently comprises 33 drama corpora containing more than 4,000 annotated full-text plays in 24 languages. As a community-driven project committed to open-science principles, it supports a broad international research landscape in computational drama analysis and theatre history.
About the Hackathon
The hackathon will take place in Rostock from 7 to 9 September 2026. Hosted by the Professorship for Digital Humanities at the University of Rostock, the three-day event will bring together researchers from computational literary studies, cultural analytics, digital scholarly editing, theatre studies, and related fields.
The program will combine introductory training sessions on encoding dramatic texts in TEI and working with DraCor data with scholarly presentations, collaborative working sessions, and discussion formats. During the working sessions, participants may either pursue projects of their own or contribute to prepared thematic work packages.
Program
Monday, 7 September 2026
13:00–13:15
Welcome and Introduction
13:15–14:45
Beginners’ Training Session I: From Dramatic Text to DraCor TEI
The hackathon is conceived as an open and collaborative environment for exploring methodological and practical questions relating to digital drama analysis, text encoding, corpus development, metadata modelling, and data enrichment. Rather than focusing exclusively on completed research results, the event invites participants to develop and test new approaches, exchange expertise, and collaborate on concrete textual and data-based materials. Possible topics may include:
the encoding, documentation, and enrichment of plays by women;
the integration of new plays into existing or newly established DraCor corpora;
the digital modelling and analysis of characters and gendered patterns of representation;
the computational analysis of character networks, speech distribution, scene structures, and stage directions;
comparative analyses across languages, historical periods, dramatic genres, and theatrical traditions;
the reconstruction of reception and transmission networks through authority data and linked open data;
the development of methods for linking plays, authors, characters, performances, translations, adaptations, and other forms of reception.
The event is open both to participants with previous experience of DraCor or TEI and to interested newcomers. No prior technical knowledge is required.
Registration
The event will take place on site at the University of Rostock. Participation is free of charge and limited to 35 participants. To register, please send an email to phf.dh@uni-rostock.de. When registering, please indicate whether you would also like to attend either or both of the following accompanying events:
Monday, 7 September 2026, from 7:30 p.m.: Informal dinner at L’Osteria Rostock. Participants are responsible for covering their own expenses.
While the event will generally take place on site, the Opening Keynote on Monday, 7 September, and the session “State of the Art: Women Playwrights in Digital Corpora” on Tuesday, 8 September, will be held in a hybrid format. Interested participants may attend either program item in person or online. No registration is required for either program point.
The event is organised with the support of the team of the Professorship for Digital Humanities at the University of Rostock. It forms part of the activities of the Rostock Working Group for Digital Humanities (RosDH) and is funded by the Department “Wissen – Kultur – Transformation” of the Interdisciplinary Faculty and by the Faculty of Humanities at the University of Rostock.
Digitale Methoden haben die Geisteswissenschaften in den letzten Jahren grundlegend verändert. Sie eröffnen neue Wege der Analyse, ermöglichen große Datenmengen zu erschließen und stellen etablierte Forschungsfragen in ein neues Licht. Doch mit diesen Möglichkeiten entstehen auch neue Herausforderungen: Welche Narrative prägen unser wissenschaftliches Denken? Welche Perspektiven werden sichtbar – und welche bleiben unsichtbar?
Die Vortragsreihe „Produktive Ambivalenz – Digitale Methoden und Meistererzählungen“ setzt genau hier an. Sie versteht Digitalisierung nicht nur als technischen Fortschritt, sondern als epistemologische Herausforderung. Digitale Werkzeuge können dazu beitragen, lange etablierte Meistererzählungen und Korpora zu hinterfragen. Gleichzeitig können sie selbst neue Normen, Standards und Narrative erzeugen – etwa durch algorithmische Auswahlprozesse, Datenstrukturen oder softwarebasierte Voreinstellungen.
Im Zentrum der Vortragsreihe stehen daher Fragen wie:
Wie verändern digitale Methoden die Art und Weise, wie Wissen entsteht?
Welche Rolle spielen Prozesse von Auswahl, Kanonbildung und Datenstrukturierung?
Inwiefern schaffen digitale Technologien neue wissenschaftliche Selbstverständnisse?
Und wie lässt sich diese Ambivalenz produktiv für Forschung und Lehre nutzen?
Die Vortragsreihe bringt Expert:innen aus unterschiedlichen Disziplinen zusammen und lädt dazu ein, die Zukunft der Geisteswissenschaften kritisch und konstruktiv zu diskutieren. Sie richtet sich an Forschende, Studierende und alle Interessierten, die sich mit den Auswirkungen digitaler Technologien auf Wissenschaft und Gesellschaft auseinandersetzen möchten. Veranstaltet wird sie im Rahmen des Projekts SHareDH, einem gemeinsamen Projekt von UB Kiel und Europa Universität Flensburg zur Förderung der Digital Humanities in Forschung und Lehre an den beiden Universitäten in Kiel und Flensburg.
Termine
28.04.2026, digital: Wahlverwandtschaften 2.0? Statistische Narrative in den Digital Humanities Jun.-Prof. Dr. Rabea Kleymann (TU Chemnitz)
05.05.2026, digital: Edition als Mnemotechnik – Multimodale Quellen jenseits linearer Wissensordnungen Jun.-Prof. Dr. Elisa Cugliana (Universität zu Köln)
19.05.2026, Kiel, OS75 – Hörsaal 1 und digital: Unsere breite Gegenwart und ihre algorithmische Zukunft: LLM-Epistemik beim Aktualisieren historischer Narrative Dr. Christopher Nunn (Universität Heidelberg)
26.05.2026, Flensburg, Gebäude Helsinki, Raum HEL 067 und digital: Digitale Praktiken und digital-analoge Daten zwischen Ausprobieren, Explorieren und Infrastrukturieren in den Digital Humanities Prof. Dr. Lina Franken (Universität Vechta)
09.06.2026, Kiel, OS75/S3 – R.177 und digital: Erzählforschung als Messverfahren? Zu den methodologischen Chancen und Herausforderungen computationeller Zugänge Prof. Dr. Evelyn Gius (TU Darmstadt)
23.06.2026, digital: Kanonkritik durch Distant Reading, Zoom und Close Reading oder De arte venandi per algorithmum Prof. Dr. Peter Bell (Philipps-Universität Marburg)
07.07.2026, tba.: Über die epistemische Gewalt der Digitalität: Plädoyer für eine grundlegende Datenkultur in den Geisteswissenschaften Dr. Till Grallert (Humboldt Universität zu Berlin)
27.04.2026 Prof. Dr. Franz Fischer (Università Ca’ Foscari di Venezia) Unreadable, Unstable, Uneditable – Critical, Genetic, and Constellational Editions of Difficult Texts and Their Transmission
18.05.2026 Dr. Bart Holterman und Dr. Angela Huang (beide FGHO) Ein NER-Schema für die Hanseforschung: Überlegungen und Herausforderungen
01.06.2026 Hellmut Braun (Universität Rostock), Dr. Anne Gessing (Universität Bonn), Karsten Labahn und Robert Stephan (beide UB Rostock) Künstlike Werltspröke und Eyn schön rimbökelin. Digitale Edition mittelniederdeutscher Spruchsammlungen des 16. Jahrhunderts
06.07.2026 Dr. Frederike Neuber und Tim Westphal (beide BBAW) Wer hat hier ediert? Autorschaft, Transparenz und Dokumentation in maschinell unterstützten Editionsprozessen
Veranstaltungszeit
Immer montags an den ausgewiesenen Terminen, ab 17:15 Uhr.
Kontakt
Bei Fragen zur Ringvorlesung wenden Sie sich gerne an das Team der DH-Juniorprofessur: phf.dh@uni-rostock.de.
Vom 24. bis zum 26. September 2025 fand in Rostock die Konferenz FORGE25 (Forschungsdaten in den Geisteswissenschaften) statt, die unter dem Motto „Daten neu denken“ stand. Dieser Blogpost gibt einen kurzen Rückblick auf die Tagung, die alle zwei Jahre von der AG gwFDM des DHd-Verbands an wechselnden Standorten organisiert wird.
Insgesamt 126 Teilnehmende besuchten die dreitägige Veranstaltung, die im Hauptgebäude der Universität Rostock ausgerichtet wurde. Das Programm umfasste sechs Workshops, 26 Vorträge und 22 Posterbeiträge.
Den Auftakt bildeten am Mittwoch, den 24. September die sechs Workshops, die einen vielfältigen thematischen Bogen spannten: von der FDM-Servicekatalogisierung über inklusive Formen der Data Literacy bis hin zur Datennutzung als Gemeinschaftsaufgabe.
Anschließend wurde die Konferenz offiziell eröffnet. Zunächst leitete Jun.-Prof. Dr. Ulrike Henny-Krahmer die Veranstaltung ein, bevor Antje Theise, Direktorin der Universitätsbibliothek Rostock, und Marina Lemaire, Co-Convenorin der AG gwFDM und Referentin für Projektmanagement im Bereich digitale Forschungsinfrastrukturen in den Geistes- und Sozialwissenschaften am Servicezentrum eSciences der Universität Trier, Grußworte an das Publikum richteten. Anschließend hieß auch der Prorektor für Studium und Lehre der Universität Rostock, Prof. Dr. Karsten Wolf, alle Teilnehmenden feierlich willkommen.
Gespannte Zuhörer*innen: Jun.-Prof. Ulrike Henny-Krahmer, Erik Renz und Antje Theise (v.l.n.r.).
Offizieller Auftakt: Grußwort des Prorektors Prof. Dr. Karsten Wolf.
Es folgte eine Keynote von Jun.-Prof. Dr. Elisa Cugliana (Universität zu Köln) mit dem Titel „Editiones vitreae sunt: tum cum splendent, franguntur. Daten, Software und Theorie zwischen Zufall, Schicksal und Magie“. Cugliana stellte in ihrer Keynote das Genre der Losbücher vor und wie dieses durch seine nicht-lineare und nicht hierarchische Struktur standardisierte Prinzipien der Textcodierung herausfordert. Sie verwies auf die Spannung zwischen methodischer Innovation, die nötig ist, um auch ein Genre wie die Losbücher digital edieren zu können, und der Frage der Nachhaltigkeit von digitalen Editionen, die neue methodische Wege beschreiten.
Ganz in ihrem Element: Jun.-Prof. Dr. Elisa Cugliana bei der Keynote.
Am Donnerstag und Freitag gaben alsdann 26 Vorträge Einblicke in unterschiedlichste Bereiche der geisteswissenschaftlichen Forschungspraxis. Diskutiert wurden hierbei unter anderem Chancen und Grenzen von LLMs, der verantwortungsvolle Umgang mit sensiblen Forschungsdaten sowie aktuelle Entwicklungen rund um digitale Editionen und Textkorpora.
Eine Zäsur bildete am Donnerstagnachmittag die Postersession, in der 22 Beiträge präsentiert wurden. Die Teilnehmenden der Konferenz kürten anschließend ihre Favoriten. Den ersten Platz erhielt das Poster „Von alten Daten und neuen Apps. Aufbereitung regionalsprachlicher Daten am Forschungszentrum Deutscher Sprachatlas“ von Lisa Dücker, Robert Engsterhold und Georg Oberdorfer (Universität Marburg). Drei zweite Plätze wurden ebenfalls vergeben, an „Analoge Forschungsdaten neu aufbereitet: Die Digitalisierung und Erschließung einer lexikografischen Belegsammlung im Projekt DEMel“, an „Von Träumen zu realistischen Anwendungsfällen: Zum Einsatz von KI in der Museumsdokumentation“ sowie an „Digitale Edition neu denken – Eine Plattform zur Konstellationsforschung in der Philosophie“.
Alle Abstracts der Workshops, Vorträge und Poster sind gesammelt im Book of Abstracts auf Zenodo zu finden.
Mit Vorfreude darf bereits jetzt auf die nächste FORGE geblickt werden: 2027 wird sie in Mainz stattfinden, initiiert von Marina Lemaire und organisiert mit Partnern aus Trier, Mainz und Darmstadt. Weitere Informationen werden über den FORGE-Fedihum-Account folgen.
Die FORGE25 wurde organisiert von der Arbeitsgruppe Geisteswissenschaftliches Forschungsdatenmanagement (AG gwFDM) des Verbands Digital Humanities im deutschsprachigen Raum (DHd), der Juniorprofessur für Digital Humanities, der Universitätsbibliothek Rostock, dem Department „Wissen – Kultur – Transformation“ (WKT) der Interdisziplinären Fakultät der Universität Rostock sowie dem Rostocker Arbeitskreis Digital Humanities (RosDH).
Besonderer Dank gilt den Hauptorganisator*innen und Förderern, den Teams der Juniorprofessur Digital Humanities und der Universitätsbibliothek Rostock, dem Programmkomitee, den Gutachtenden und allen Teilnehmenden, die diese Tage des Austauschs mit großem Engagement vorbereitet und ermöglicht haben.
Fleißige Helfer im Hintergrund: Josephin Lange-Kröger und Nicole Edlich (v.l.n.r.) als Teil des Orgateams vor Ort.
Interessierte aus allen Fachgebieten sind herzlich eingeladen, sowohl in Präsenz als auch online an der Veranstaltung teilzunehmen. Eine vorherige Anmeldung für die einzelnen Termine ist nicht erforderlich.
Programm für das Wintersemester 2025/2026
20.10.2025 Jun.-Prof. Dr. Rabea Kleymann (Universität Chemnitz) Theoriearbeit in den Digital Humanities: Begriffe, Methoden, Kritik
27.10.2025 Dr. Sarah Lang (Max-Planck-Institut für Wissenschaftsgeschichte) Making the Digital Humanities More Diverse and Inclusive: Theories and Practices
03.11.2025 Jun.-Prof. Dr. Anastasia Glawion (Friedrich-Alexander-Universität Erlangen-Nürnberg) Netzwerkbasierte Zugänge zu postpandemischen Harry-Potter-Interpretationen auf Fanfiktion.de
10.11.2025 Jun.-Prof. Dr. Dennis Ried (Martin-Luther-Universität Halle-Wittenberg) Mit wenig viel erreichen: Kreative Infrastruktur-Lösungen für große und kleine DH-Projekte
17.11.2025 Veronica Wassermayr (Universität Trier) Moselwein, LLMs und LOD – Kulturerbe mit KI analysieren
24.11.2025 Dr. Elias Zimmermann (Universität Zürich / Universität Genf) Ambivalenzen Edieren. Mediale und postkoloniale Herausforderungen in der digitalen Edition Annemarie Schwarzenbach
01.12.2025 Deborah Ehlers (Universität zu Lübeck) Unsicherheit als Erkenntnisquelle: Virtuelle Rekonstruktionen historischer Ausstellungen
08.12.2025 Prof. Dr. Aline Deicke (Philipps-Universität Marburg) Disiecta Membra als disiecta data? Herausforderungen in einem archäologischen Langzeitvorhaben
15.12.2025 Dr. Dîlan Canan Çakir und Viktor J. Illmer (beide Freie Universität Berlin) Metadaten lesbar machen: Genre, Inferenzstatistik und Replizierbarkeit in der Digitalen Einakter-Datenbank
12.01.2026 Sebastian Flick und Peter Dängeli (beide Universität Bern) Kein Backend, kein Problem! Wie bringen wir Inhalte lange ins Netz?
19.01.2026 Laura Vawter (Universität Rostock) Authority, Hierarchies and Games. An overview of multilingual language practices in Final Fantasy, Minecraft and PUBG in Twitch and live gaming scenarios
Veranstaltungszeit
Immer montags an den ausgewiesenen Terminen, jeweils von 17:15 bis 18:45 Uhr.
Kontakt
Bei Fragen zur Ringvorlesung wenden Sie sich gerne an das Team der DH-Juniorprofessur unter: phf.dh@uni-rostock.de.
Auch in diesem Semester haben wir wieder drei tolle Vorträge rund um Wissenschaftskommunikation in den (Digital) Humanities für euch. Jede Coffee Lecture besteht aus etwa 30 Minuten Vortrag und 30 Minuten anschließender Diskussion.
Im ersten Vortrag, am 5.5.2025 um 15 Uhr wird ein Einblick in die Produktion von TikTok-Videos gegeben. Im Zentrum steht dabei der Account @glima.tuebingen, auf dem sowohl sprachwissenschaftliche Inhalte (LinguisTikTok) vermittelt werden als auch Werbung für ein Germanistikstudium in Tübingen gemacht wird. Beschrieben werden Arbeitsweise und Erfahrungen mit TikTok als multimodalem Medium mit einem breiten Spektrum an Möglichkeiten für die Wissenschaftskommunikation.
Interessierte aus allen Fachgebieten sind herzlich eingeladen, sowohl in Präsenz als auch online an der Veranstaltung teilzunehmen. Eine vorherige Anmeldung für die einzelnen Termine ist nicht erforderlich.
Programm für das Sommersemester 2025:
07.04.2025 Prof. Dr. Deb Verhoeven (University of Alberta) Where data goes to DEI/EDI/DIE: Information Infrastructure and the Protracted Collapse of Institutional Courage
14.04.2025 Prof. Dr. Hanna Fischer (Universität Rostock) Niederdeutsch in Raum und Zeit – der „Digitale Niederdeutsch-Atlas für Mecklenburg-Vorpommern“
28.04.2025 Luca Giovannini (Universität Potsdam) Investigating the Evolution of Early Modern European Drama with Digital Methods
05.05.2025 Jun.-Prof. Dr. Ulrike Henny-Krahmer (Universität Rostock) Im Haus und unter dem Himmel: Artefakte und natürliche Räume im spanischsprachigen Roman des 19. Jahrhunderts
12.05.2025 Cordula Greinert und Fabian Kaßner (beide Universität Rostock) „Aber es gibt doch schon zwei Bücher über Achim!“ Die Edition von Uwe Johnsons Das dritte Buch über Achim als gedruckte und digitale Ausgabe
19.05.2025 Prof. Dr. Lina Franken (Universität Vechta) Kulturelles Erbe digital erschließen. Inwertsetzungen und notwendige Kontextualisierungen aus Perspektive der kulturwissenschaftlichen Digital Humanities
26.05.2025 Prof. Dr. Marijana Tomić (Universität Zadar) The Transformative Impact of Digital Humanities on the Study of Historical Manuscripts
02.06.2025 Prof. Dr. Aline Deicke (Philipps-Universität Marburg) Disiecta Membra als disiecta data? Herausforderungen in einem archäologischen Langzeitvorhaben
16.06.2025 Dr. Gimena del Rio Riande (CONICET, Buenos Aires) Open Minimal Digital Editions: a Latin American Perspective
23.06.2025 Dr. Pedro Nilsson-Fernàndez (University College Cork) Geoparsing Catalan Crime Fiction at the Turn of the Millenium
30.06.2025 Dr. Martina Scholger (Universität Graz) Auf explorativen Pfaden durch digitale Briefeditionen
07.07.2025 Dr. Antonio Rojas Castro (Universität Tübingen) und Allison Keith (Universität Stuttgart) Exploring Characters in Calderón Drama Corpus (CalDraCor) with Computational Methods
Veranstaltungszeit
Immer montags an den ausgewiesenen Terminen, jeweils von 17:15 bis 18:45 Uhr.
Kontakt
Bei Fragen zur Ringvorlesung wenden Sie sich gerne an das Team der DH-Juniorprofessur unter: phf.dh@uni-rostock.de.
Erneut lädt die Universität Rostock im Wintersemester 2024/25 zur Hybrid-Ringvorlesung „Digital Humanities im Fokus: Methoden, Anwendungen und Perspektiven“ ein. Die Veranstaltungsreihe wird zum vierten Mal vom Rostocker Arbeitskreis Digital Humanities (RosDH) und der hiesigen DH-Juniorprofessur organisiert. Daneben wird sie in diesem Semester bereits zum zweiten Mal durch den Wissenschaftsverbund IuK unterstützt.
Interessierte aus allen Fachgebieten sind herzlich eingeladen, sowohl in Präsenz als auch online an der Veranstaltung teilzunehmen. Eine vorherige Anmeldung für die einzelnen Termine ist nicht erforderlich.
Programm für das Wintersemester 2024/25:
21.10.2024 Prof. Dr. Julian Schröter (München) Gattung – Medium – Politik: Eine quantitative Geschichte der Novelle im 19. Jahrhundert
28.10.2024 Alexander Vandewalle (Antwerpen/Gent, BEL) Characterization of Greek Mythological Characters in Video Games
04.11.2024 Fernanda Alvares Freire(Rostock/Darmstadt) Keeping Up with Current Practices: The Infrastructural Update of Pessoa Digital in Collaboration with Text+
18.11.2024 Torsten Veit (Greifswald) Herrenhausforschung in Gegenwart und Zukunft. Ein Lagebericht des Projekts „Herrenhauszentrum des Ostseeraums“
25.11.2024 Prof. Dr. Anna Neovesky (Erfurt) Wie finden Historiker*innen relevante Informationen? Informationssuche im Kontext von wissenschaftlichem Arbeitsprozess, Transparenz und digitalen Kompetenzen
06.01.2025 Prof. Dr. Evelyn Gius (Darmstadt) Textannotation als wissenschaftliche Praxis der DH
13.01.2025 Dr. Jana-Katharina Mende(Halle (Saale)) Von der Textanalyse zur Datenanalyse: Neue Wege der Komparatistik in den Digital Humanities
20.01.2025 PD Dr. Katrin Dennerlein (Würzburg) Literarische Emotionen mit künstlicher Intelligenz finden? Von Wörtern, Wordembeddings und Large Language Modellen
Veranstaltungszeit
Immer montags an den ausgewiesenen Terminen, jeweils von 17:15 bis 18:45 Uhr
Kontakt
Bei Fragen zur Ringvorlesung wenden Sie sich gerne an das Team der DH-Juniorprofessur unter: phf.dh@uni-rostock.de.
Im März haben wir als Herausgeber*innenkollektiv bereits einen “Call for Abstracts” für den Sammelband “From Global to Local? Digitale Methoden in den Geisteswissenschaften im deutschsprachigen Raum: Ein Triptychon“ veröffentlicht. Link: https://dhd-blog.org/?p=20783
Wir freuen uns, nun als Community Aktion diesen “Call for Contributions” für die Kategorie IN EIGENEN WORTEN zu veröffentlichen!
Im geplanten Sammelband “From Global to Local?” soll kritisch hinterfragt werden, welche Implikationen die wechselvollen Entwicklungsgänge der Digital und Computational Humanities im deutschsprachigen Raum für das disziplinäre Selbstverständnis der Geistes- und Kulturwissenschaften mit sich gebracht haben und welche epistemischen Versprechen digitale Methoden zeitigen. Ebenfalls wird gefragt, inwieweit die transformativen Potenziale des Computereinsatzes in den Geisteswissenschaften für die aktuelle Forschungslandschaft, aber auch die breite Öffentlichkeit, bereits ausgeschöpft werden. Über allem schwebt die Frage nach der Zukunft und Einheit der DH, die eng verwoben ist mit Herausforderungen der Curriculargestaltung und der akademischen Selbstorganisation.
Der Fokus der Betrachtung soll auf dem deutschsprachigen Raum liegen und der Nachzeichnung lokal verorteter wie internationaler Geschichte(n) und Ausprägungen der digitalen Geisteswissenschaften im deutschsprachigen Raum multiperspektivisch und multimodal Raum geben.
Die Herausgeber*innen des Sammelbandes verfolgen dabei einen offenen und inklusiven Ansatz: Die lineare, chronologische Geschichte (grand narrative) soll durch die Anlage als Triptychon “aufgebrochen” werden, um einer Vielzahl von Perspektiven und Stimmen Raum zu geben.
Die Herausgeber*innen planen in Teilkoordination folgende Bestandteile des Triptychons:
Melanie Seltmann + Christopher Nunn: BE-FORSCHEN: “klassische” Artikel
Ulrike Wuttke + Anne Baillot IN EIGENEN WORTEN: audio(visuelle) Formate
Christian Schröter (geb. Vater) + Christian Wachter: ARTEFAKTE: Artefaktbiografien zu Fallbeispielen des Computereinsatzes in den Geisteswissenschaften
Wir laden nun die Community dazu ein, kurze Audiobeiträge (deutsch oder englisch) unter dem Motto “5 Fragen – 1 Antwort” einzureichen, die EINE der folgenden Fragen beantworten:
Wo verorten Sie DH für das disziplinäre Verständnis der geistes- und kulturwissenschaftlichen Fächer? | What is the contribution of DH to the self-understanding of Humanities disciplines?
Sind die transformativen Potenziale des Computereinsatzes bereits ausgeschöpft? | Are the transformative potentials of computer use for the Humanities already exhausted?
Welche nationalen Eigenheiten prägen die DH im deutschsprachigen Raum und gibt es eine eigenständige “kontinentale” Traditionslinie? | Which national specificities characterize DH in the German-speaking area and is there something like a continental tradition of DH?
Welche Stimmen sind im big tent der DH unterrepräsentiert? | What voices are underrepresented under the DH big tent?
Wo sollen die DH in 10 Jahren stehen? | Where do you see DH 10 years from now?
Die Beiträge werden bei Eignung von uns für Audio-Features verwendet, die voraussichtlich im Rahmen des Sammelbands sowie im Medien-Repositorium der Universität Luxemburg und in Form eines Podcasts über die üblichen Verbreitungswege unter der Lizenz CC BY-SA 4.0 und einer PID veröffentlicht werden.
Wichtige Hinweise:
Umfang: max. ca. 1-3 Minuten (Bitte nur EINE der 5 Fragen beantworten!)
Aufnahme bitte folgendermaßen gliedern: Kurze Vorstellung (Vorname, Name, ggf. Institution) z. B. “Guten Tag, mein Name ist XY…”/Hello, my name is XY…”, Frage, die beantwortet wird, vorlesen, z. B. “Ich möchte die Frage beantworten: (hier Frage vorlesen)….” / “I will answer the following question: (read question)”
Aufnahmetipps:
Am besten eine deutliche Pause machen, bevor die Frage beantwortet wird, das erleichtert die Verarbeitung
Bitte deutlich sprechen, ohne zu vorgelesen zu klingen
Ein (gutes) Headset oder, wenn nicht vorhanden, Computer-Mikrofon verwenden
In einem ruhigen Raum mit möglichst wenig Hall aufnehmen (ja, am besten im Schrank!).
Gerne einen Tontest machen.
Einreichung und Format:
Die Aufnahme kann von uns in dem geplanten Feature nur verwendet werden, wenn Sie uns zusammen mit der Aufnahme eine Einwilligungserklärungserklärung für eine Publikation unter der Lizenz CC BY-SA einreichen (Link zum Download der Vorlage: https://fhpcloud.fh-potsdam.de/s/gJ5Aj8monYdsFs9)
Wir ermutigen Sie explizit, uns zusätzliche Informationen zu Ihrer Antwort zukommen zu lassen. Reichen Sie diese Informationen (z. B. in der Form einer Bibliografie/Links für die Shownotes) zusammen mit Ihrer Tonaufnahme mit eindeutigem Dateiname (NAME_VORNAME) ein.
Bitte reichen Sie Ihre Dateien bis zum 30.09.2024 ein. Sie werden darüber informiert, ob die Datei zur Veröffentlichung angenommen wird, auch hierfür sind Ihre Kontaktdaten in der Einwilligungserklärung (siehe oben) unbedingt notwendig.
Wenn Sie gerne bereit sind mitzumachen, aber unschlüssig sind, Fragen haben oder die Technik fehlt, nehmen Sie gerne Kontakt mit der korrespondierenden Hauptherausgeberin Ulrike Wuttke bzw. dem Herausgeber*innenteam unter der E-Mail-Adresse global-local-dh@listserv.dfn.de auf, dann finden wir eine andere Lösung.
Wir freuen uns auf Ihre Einreichungen!
Mit freundlichen Grüßen
Ulrike Wuttke und Anne Baillot für das Herausgeber*innenteam
Global-Local-DH-Herausgeber*innenteam:
Ulrike Wuttke, Melanie Seltmann, Christian Schröter (geb. Vater), Anne Baillot, Christian Wachter und Christopher Nunn
Verlagspartner: Melusina Press
Erscheinungsdatum des Sammelbandes: voraussichtlich Ende 2025
Nach ihrem Beitrag zum DHCC Toolkit sowie Workshops auf den DHd-Jahrestagungen 2023 und 2024 stellt nun die DHd-AG Greening DH ihre Empfehlungen zum ressourcenschonenden Umgang mit Forschungsdaten vor – diesmal in deutscher Sprache.
Mit dieser Handreichung möchten wir allen geisteswissenschaftlichen Forschenden Hilfestellung im Umgang mit Forschungsdatenmanagementplänen an die Hand geben. Der Fokus auf FDM-Pläne hat sich aus der Feststellung ergeben, dass es sich dabei um eines der wenigen Tools handelt, das die Frage nach dem Umgang mit Ressourcen und damit unseren ökologischen Fussabdruck im Umgang mit Daten, Tools und Softwares thematisiert. Dies erfolgt aber meist implizit. Uns geht es mit den Empfehlungen darum, das Implizite explizit zu machen, für ökologische Fragen unseres Tuns zu sensibilisieren und zugleich darin zu unterstützen.
Die Empfehlungen sind in die sechs Bereiche Formate/Interoperabilität, Versionierung, Metadaten, Nutzungsszenarien und Speicherplatz/Langzeitarchivierung aufgeteilt. Diese haben sich aus dem Workshop „Der Weg zum grünen Forschungsdatenmanagementplan“ auf der DHd 2024 ergeben. In jedem dieser Bereiche werden klassische FDM-Pläne-Fragen in Hinsicht auf ihre Bedeutung für einen schonenden Umgang mit Ressourcen beleuchtet. Auf einige best practices wird ebenfalls hingewiesen.
Die DHd-Community besitzt wie keine andere das Know-How, um diese Empfehlungen soweit zu verbessern, dass sie auch für weniger digital affine Geisteswissenschaftlerinnen und Geisteswissenschaftler hilfreich sein können. So laden wir alle ein, jetzt mitzuwirken. Die aktuelle Version, ist durch das hypothes.is-Interface kommentierbar. Bis zum 31. August ist die Open Peer Review-Phase offen. Wir freuen uns auf zahlreiche, kritisch-konstruktive Kommentare unter diesem Link.
Die DHd Jahreskonferenz 2024 trug den Titel “#Quo vadis DH?”, fand vom 26. Februar 2024 bis zum 1. März 2024 statt und wurde an der Universität Passau ausgerichtet.[1] Die Software ConfTool,[2] welche zur Konferenzverwaltung genutzt wurde, wurde am 12. Juni 2023 freigeschaltet. Über dieses Tool konnten Autor:innen sich zur Konferenz anmelden und Beiträge einreichen. Autor:innen gaben hierzu Metadaten wie bspw. den Beitragstitel, Autor:innennamen mit Affiliation und ORCID-ID und Keywords zu einer Einreichung über das ConfTool ein. Die Metadaten wurden schließlich aus dem ConfTool über eine Schnittstelle an den DHConvalidator[3] übertragen, in dem ein Template für jede Einreichung inklusive aller zugehörigen Metadaten erzeugt und von den Autor:innen zur Erstellung ihrer Einreichung genutzt wurde. Nachdem die Autor:innen ihren Beitrag im Template geschrieben hatten, wurde dieses über den DHConvalidator prozessiert, sodass eine .dhc-Datei mit einer HTML-, einer Template- und einer TEI-XML-Version der Einreichung sowie eingebetteter Abbildungen erzeugt wurde. Diese wurde schließlich durch die Autor:innen als Beitrag im ConfTool hochgeladen und eingereicht. Mit Hilfe der eingetragenen Metadaten wurden schließlich aus den TEI-XML-Versionen der eingereichten und akzeptierten Beiträge das Book of Abstracts sowie Einzelpublikationen der Beiträge über automatisierte Workflows[4] generiert (Helling et al. 2022a).
Für diese automatisierte Erstellung des Book of Abstracts sowie der Einzelpublikationen wurden die eingereichten TEI-XML-Versionen der Beiträge verwendet. In der Regel sind die TEI-XML-Versionen der Beiträge unsauber und können Fehler aufweisen, die händisch korrigiert werden müssen. Diese Fehler sind prinzipiell auf falsche Formatierungen sowie die Übernahme von Formatierungsinformationen beim Kopieren eines Beitrags aus einem anderen Textverarbeitungsprogramm in das Template durch die Autor:innen zurückzuführen (Helling et al. 2022b). Mit diesem Beitrag sollen jene Fehler exemplarisch für die DHd Jahreskonferenz 2024 dokumentiert werden.
Einführung
Zur Jahreskonferenz 2024 wurden insgesamt 144 Beiträge angenommen: 64 Poster, 7 Panels, 19 Workshops, 43 Vorträge und 11 Beiträge des Doctoral Consortiums. Von vorherigen Jahreskonferenzen waren folgende Fehler aus der Bereinigung der Beiträge bereits bekannt:
Sonderzeichen im Text (oft auch bei Autor:innenamen in der Bibliographie) werden als # dargestellt
Autor:innennamen sind in der Bibliographie nicht fett gedruckt
Abbildungen fehlen im Beitrag oder werden fehlerhaft dargestellt
Tabellen fehlen im Beitrag oder werden fehlerhaft dargestellt
Bildunterschriften fehlen oder werden fehlerhaft dargestellt
Zusätzlich zu den schon bekannten Fehlern wurden auch weitere Fehler aufgezeichnet, die seltener vorkommen, aber ebenfalls korrigiert werden mussten. Diese wurden im Folgenden unter der Kategorie “sonstige Fehler” zusammengefasst. Dabei handelte sich unter anderen um folgende Fehler:
Abstände zwischen Fließtext, Tabellen oder Bildern sind nicht einheitlich
Überschriften sind nicht als solche hierarchisch formatiert
fehlende bzw. nicht einheitliche Informationen bei Autor:innen (bspw. Affiliation)
fehlende Bibliografie
fehlende Titel
Zeilenabstand ist aufgrund von Fußnotenreferenzierungen nicht einheitlich
zu große Abstände im Text, wenn Textteile eingeklammert waren
Probleme bei URLs (automatische Silbentrennung führt zu ungewollten Bindestrichen in Links und somit zu nicht funktionalen Links)
fehlende Satzzeichen
Übersicht über alle Beiträge
Die folgende Tabelle 1 enthält eine Zusammenfassung aller Formatierungsfehler der Beiträge zur DHd 2024 vor der Prozessierung zum Book of Abstracts bzw. zu den Einzelpublikationen. Hierbei ist zu beachten, dass nicht alle, aber die Mehrzahl der Beiträge, fehlerhaft waren. Die unterschiedlichen Fehler der Kategorie “sonstige Fehler” wurden aus Gründen der Übersichtlichkeit nicht einzeln aufgeführt. Auch hier gibt es Beiträge, die nicht fehlerhaft waren und solche, die mehr als einen Fehler hatten. Daher wird jeder Beitrag, der mindestens einen Fehler der Kategorie “sonstige Fehler” aufwies, nur einmal in dieser Spalte gezählt.
Tabelle 1: Übersicht der Fehlertypen aller Beiträge.
Anzahl Beiträge
Sonderzeichen
Autor:innen nicht fett
Abbildung fehlt
Tabelle fehlt
Fehler bei Bildunterschriften
sonstige Fehler
Fehler gesamt
Poster
64
10
36
1
1
29
44
121
Panels
7
3
5
0
0
0
7
15
Workshops
19
3
12
1
1
5
12
34
Doctoral Consortium
11
2
7
1
0
1
11
22
Vorträge
43
12
1
0
0
2
6
21
Gesamt
144
30
61
3
2
37
80
213
Bei den 144 Beiträgen, die angenommen wurden, traten in 30 Beiträgen Sonderzeichenfehler auf, bei denen Sonderzeichen als # angezeigt wurden, bei 61 Beiträgen waren die Autor:innennamen in der Bibliographie nicht fett gedruckt, bei drei Beiträgen fehlten die Abbildungen, bei zwei die Tabellen, 37 Beiträge hatten fehlerhafte Bildunterschriften und 80 hatten Fehler der Kategorie “sonstige Fehler”. Insgesamt wurden mindestens 213 Fehler behoben. Diese Zahl ist hier nicht akkurat abgebildet und muss höher angenommen werden, da jeder Beitrag nur einmal in jeder Kategorie aufgeführt wurde, auch wenn mehr als ein Fehler der jeweiligen Kategorien in einem Beitrag auftrat.
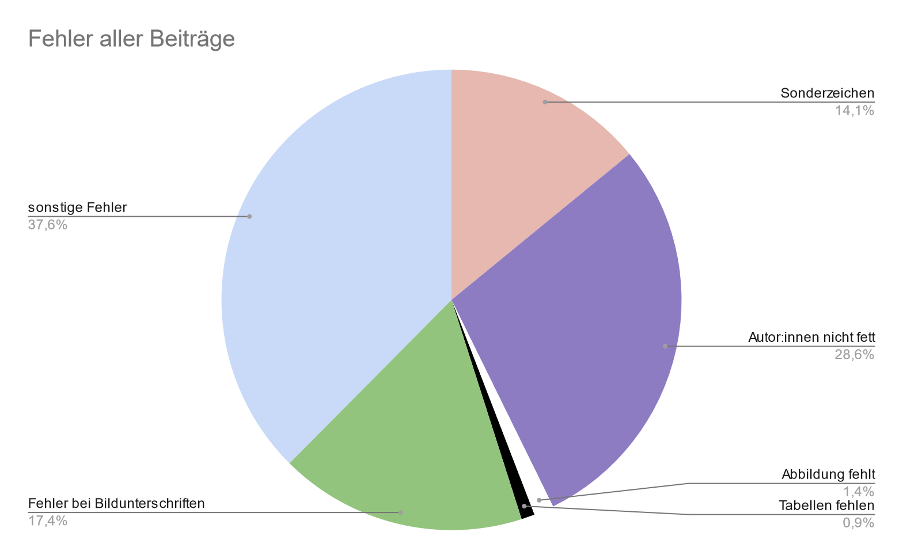
Abbildung 1: Fehleraufteilung aller Beiträge.
In Abbildung 1 wird deutlich, dass die Kategorie “sonstige Fehler” mit 37,6% am häufigsten vorkommt. Dies liegt daran, dass in dieser Kategorie mehr als eine Fehlerart festgehalten wurde. Darauf folgt die Kategorie “Autor:innennamen nicht fett” mit 28,6%. Fehlerhafte Bildunterschriften sind mit 17,4% die dritthäufigste Fehlerkategorie und Sonderzeichenfehler ergeben 14,1% der Fehler. Fehlende Tabellen und Abbildungen liegen gemeinsam bei 2,3%.
Wenn man die Anzahl der Beiträge beachtet, die Abbildungen und Tabellen haben, zeigt sich, dass die Quote der fehlenden Abbildungen und Tabellen vergleichsweise gut ausfällt.
Tabelle 2: Anzahl der Beiträge, die Abbildungen und / oder Tabellen enthalten.
Anzahl der Beiträge
Beiträge mit Abbildungen
Beiträge mit Tabellen
Poster
64
37
3
Panels
7
0
0
Workshops
19
8
2
Doctoral Consortium
11
2
2
Vorträge
43
30
9
Gesamt
144
77
16
Im Vergleich zu Abbildungen kommen Tabellen seltener vor. Von 144 Beiträgen haben nur 16 Beiträge Tabellen, von denen nur zwei nach der automatisierten Generierung fehlten (12,5%). Abbildungen kommen hingegen bei über der Hälfte der Beiträge vor. Von 144 Beiträgen haben 77 Abbildungen, von denen nach der automatisierten Generierung nur drei fehlten (3,8%).
Darüber hinaus sind Fehler in der Formatierung der Bildunterschriften relevant, die aus Gründen der Barrierefreiheit benötigt werden, da sie Lesenden mit eingeschränkter Sehkraft helfen, nachzuvollziehen, was Abbildungen in einem Beitrag zeigen, beispielsweise. wenn ein Screenreader verwendet wird.
Insgesamt hatten 37 Beiträge Fehler bei den Bildunterschriften, wovon die Posterbeiträge den größten Anteil mit 29 fehlerhaften Beiträgen stellen. Das heißt, dass fast die Hälfte (48,1%) der Beiträge mit Bildern falsch formatierte Bildunterschriften hatten.
Die nächsten Kapitel gehen auf die Verteilung der Fehler innerhalb der einzelnen Beitragskategorien ein.
Poster
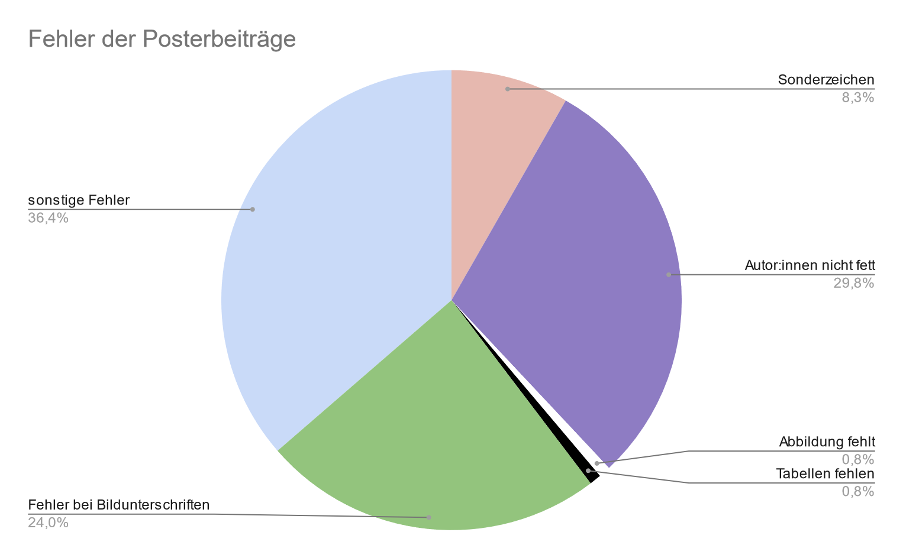
Es wurden insgesamt 64 Posterbeiträge angenommen. Nach der automatisierten Generierung der Beiträge im PDF-Format hatten zehn der Beiträge Sonderzeichenfehler, bei 36 Beiträge waren die Autor:innennamen in der Bibliographie nicht fettgedruckt, in einem Beitrag fehlten Abbildungen und einem weiteren fehlten Tabellen, bei 29 Beiträgen gab es Fehler bezüglich der Formatierung der Bildunterschriften und 44 der Beiträge hatten Fehler der Kategorie “sonstige Fehler” (siehe Abbildung 2). Insgesamt wurden mindestens 121 Fehler behoben.
Abbildung 2: Fehleraufteilung der Posterbeiträge.
Panels
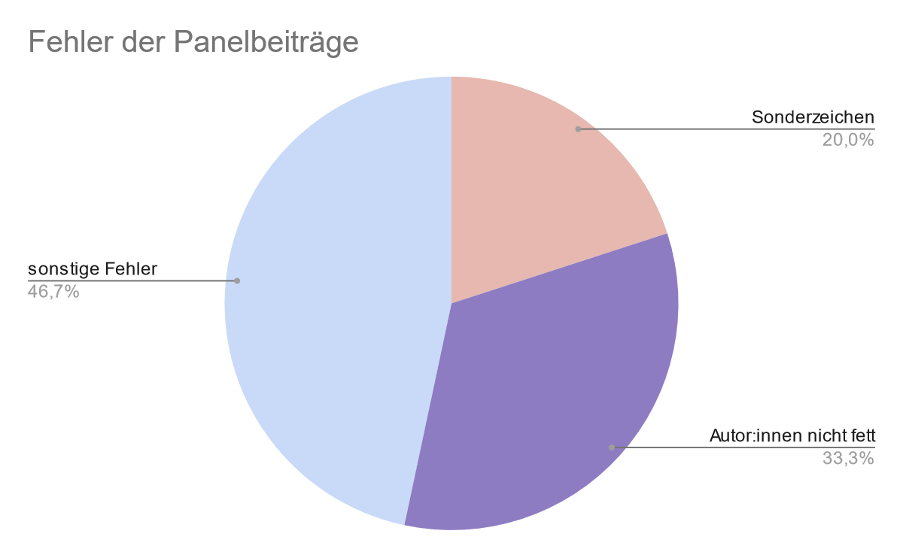
Bei den 7 Panelbeiträgen, die angenommen wurden, wurden nur drei Fehlerkategorien identifiziert. Drei Beiträge hatten Sonderzeichenfehler, bei fünf Beiträgen waren die Autor:innennamen in der Bibliographie nicht fett gedruckt und alle Beiträge hatten einen Fehler der Kategorie “sonstige Fehler” (siehe Abbildung 3). Insgesamt wurden hier mindestens 15 Fehler behoben.
Abbildung 3: Fehleraufteilung der Panelbeiträge.
Workshops
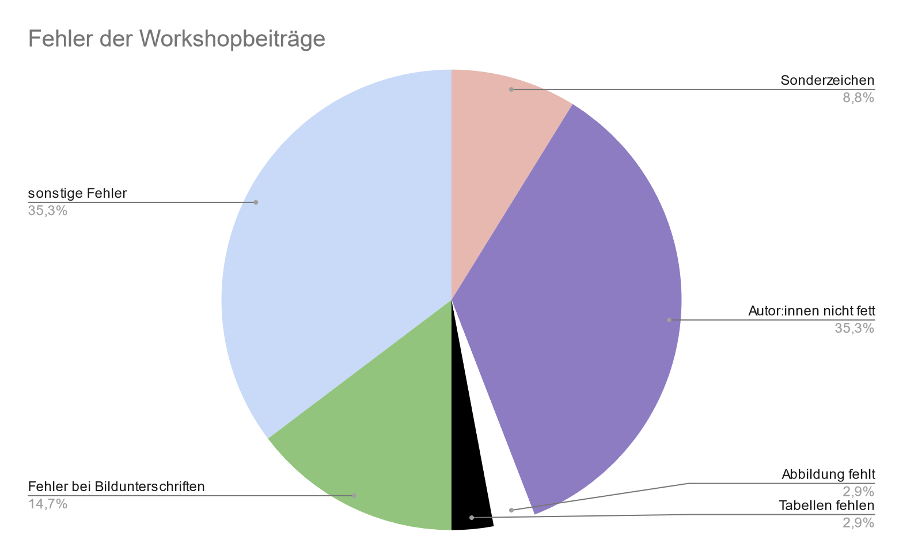
Es wurden 19 Workshopbeiträge angenommen. Von diesen hatten drei Beiträge Sonderzeichenfehler, bei zwölf Beiträgen waren die Autor:innennamen nicht fett gedruckt, in einem Beitrag fehlten Abbildungen, in einem anderen Tabellen, fünf Beiträge hatten fehlerhafte Bildunterschriften und zwölf Beiträge hatten Fehler der Kategorie “sonstige Fehler” (siehe Abbildung 4). Hier wurden insgesamt mindestens 34 Fehler behoben.
Abbildung 4: Fehleraufteilung der Workshopbeiträge.
Vorträge
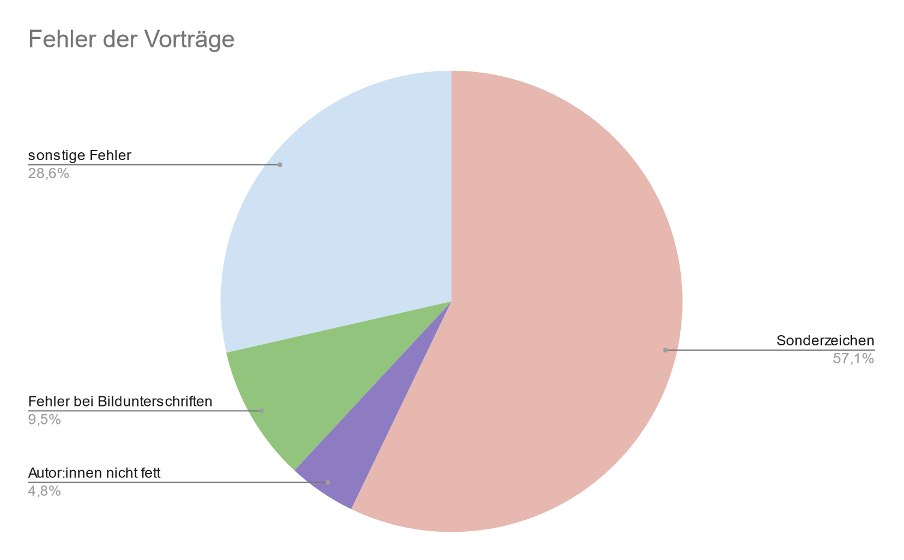
Insgesamt wurden 43 Vorträge angenommen. Von diesen hatten zwölf Beiträge Sonderzeichenfehler, sechs Beiträge hatten Fehler der Kategorie “sonstige Fehler”, zwei Beiträge hatten fehlerhafte Bildunterschriften und in einem Beitrag waren die Namen der Autor:innen in der Bibliographie nicht fettgedruckt. In keinem der Beiträge fehlten nach der automatischen Generierung der PDFs die Abbildungen oder Tabellen (siehe Abbildung 5).
Abbildung 5: Fehleraufteilung der Vorträge.
Doctoral Consortium
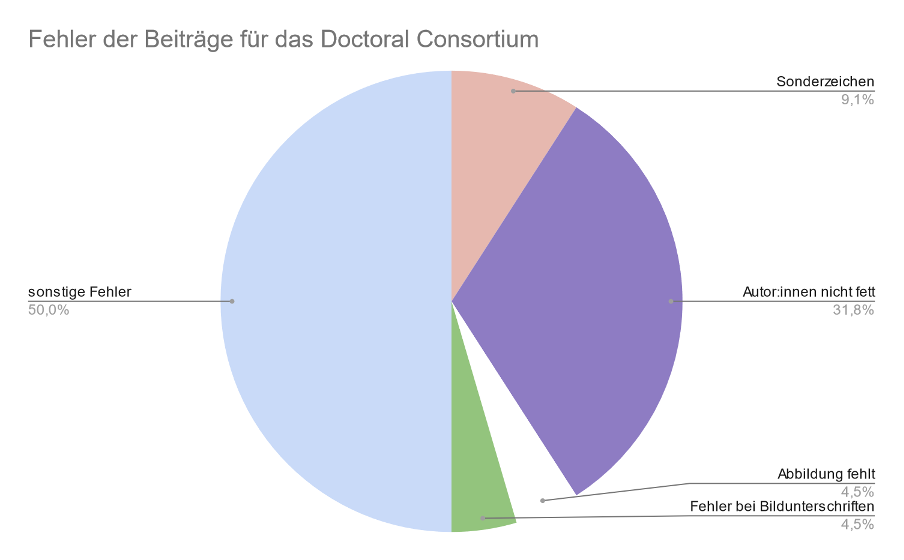
Für das Doctoral Consortium wurden elf Beiträge angenommen. Zwei von diesen Beiträgen hatten fehlerhafte Sonderzeichen, bei sieben Beiträgen waren die Autor:innennamen in der Bibliographie nicht fettgedruckt, bei einem Beitrag fehlten Abbildungen und bei einem Beitrag gab es einen Fehler in der Bildunterschrift. Fehlende Tabellen traten bei dieser Beitragskategorie nicht auf, wohingegen jeder Beitrag einen Fehler der Kategorie “sonstige Fehler” hatte (siehe Abbildung 6).
Abbildung 6: Fehlerverteilung bei den Beiträgen des Doctoral Consortiums.
Korrektur der Fehler
Bei der Korrektur der Fehler waren sowohl Mitarbeiter:innen und Hilfskräfte der Universität Passau als auch des DHd Data Stewards involviert. Nach einer Unterweisung, worauf bei der Korrektur zu achten ist, die auf den Erfahrungen der Vorjahre basierte, wurden die Beitragskategorien auf verschiedene Personen aufgeteilt und die Beiträge wurden mehrmals auf Fehler untersucht und korrigiert.
Bereits bekannte Fehler, wie die der Sonderzeichen, falsch formatierten Autor:innennamen, fehlenden Abbildungen und Tabellen sowie Fehler in der Formatierung der Bildunterschriften konnten schnell erkannt und korrigiert werden.
Weil die Kategorie “sonstige Fehler” eine offene Kategorie ist, in der bisher noch nicht bekannte Fehler verzeichnet wurden, wurde dort alles aufgenommen, was ungewöhnlich erschien. Da unterschiedliche Personen unterschiedliche Beiträge bearbeiteten, wurde individuell entschieden, was als Fehler aufgenommen wurde und was nicht. Diese Fehler wurden gemeinsam besprochen und manche dieser Fehler wurden als korrekturwürdig eingeordnet, andere wiederum nicht. Dies führte bei manchen Fällen zu doppelter Arbeit, da schon korrigierte Beiträge nochmals bearbeitet werden mussten, je nachdem ob ein Fehler bereits als solcher gewertet wurde, bevor er offiziell im Plenum als solcher deklariert wurde. Als Beispiel hierfür kann der vergrößerte Zeilenabstand genannt werden, der bei manchen Beiträgen entstand, wenn Fußnoten in der Zeile vorhanden waren. Dieser Fehler wurde bspw. automatisiert korrigiert, weshalb hierzu keine Statistik existiert.
Alle Beiträge wurden dreimal auf Fehler überprüft, bevor sie auf Zenodo hochgeladen und veröffentlicht wurden.
Fazit
Bei der DHd Jahreskonferenz 2024, die von der Universität Passau ausgerichtet wurde, wurden 144 Beiträge in den Kategorien Poster, Panels, Workshops, Vorträge und Doctoral Consortium angenommen. Diese Beiträge wurden mehrmals auf Fehler überprüft, bevor sie auf Zenodo hochgeladen und publiziert wurden. Insgesamt wurden mindestens 213 Fehler korrigiert, wobei diese Zahl höher angenommen werden muss, da jeder Beitrag, der einen oder mehrere Fehler einer Kategorie beinhaltete, nur einmal in der jeweiligen Kategorie gezählt wurde.
Bereits bekannte Fehler wurden effizient erkannt und behoben. Fehler der Gruppe “sonstige Fehler” wurden nach Auffinden gemeinsam evaluiert und je nach Häufigkeit und Auswirkungen auf die PDF-Datei individuell als zu korrigierender Fehler gewertet.
Grundsätzlich verlief der Prozess gut, kann aber dennoch verbessert werden. Eine regelmäßige Auswertung der Kategorie “sonstige Fehler” und die Erweiterung der Liste schon bekannter Fehler kann zu einem gezielteren Korrekturansatz führen, wenn die Korrigierenden wissen, worauf geachtet werden muss.
Zudem wäre eine standardisierte und detailliertere Art der Fehlerdokumentation während der Korrektur hilfreich, um genauere Auswertungen zu erstellen.
Eine mögliche Option, um Fehler in den TEI-XML-Versionen der Beiträge zu vermeiden, ist die Einschränkung von Formatierungsmöglichkeiten für die Autor:innen. Dies könnte beispielsweise durch die Etablierung eines alternativen Tools zur Erstellung von Beiträgen zu DHd Jahreskonferenzen erreicht werden. Ein potenzieller Kandidat hierfür stellt der FidusWriter[5] da, der sich diesbezüglich aktuell in der Evaluierungs- und Anpassungsphase befindet.
Referenzen
Helling, Patrick, Anke Debeller und Rebekka Borges: „Konferenzbeiträge strategisch publizieren. Automatisierte Workflows zur individuellen Veröffentlichung von Konferenzbeiträgen am Beispiel des Verbands Digital Humanities im deutschsprachigen Raum e.V.“ in O-Bib. 2022a. Das Offene Bibliotheksjournal / Herausgeber VDB 9(3), 1-17. DOI:https://doi.org/10.5282/o-bib/5835.
Helling, Patrick, Rebekka Borges, Ingo Börner, Anna Busch, Fabian Cremer, Anke Debbeler, Henning Gebhard, Harald Lordick und Timo Steyer: “Der DHd-Verband und seine Abstracts – Betrachtungen des Einreichungsprozesses zu DHd-Jahrestagungen”, DHd-Blog. 2022b. Online: https://dhd-blog.org/?p=18599 (letzter Zugriff 21.05.2024).
Bereits zum dritten Mal findet im Sommersemester 2024 die Ringvorlesung ‚Digital Humanities im Fokus: Methoden, Anwendungen und Perspektiven’ an der Universität Rostock sowohl vor Ort als auch online via Zoom statt. Die Organisatoren sind, wie schon bei den ersten beiden Ausgaben, der Rostocker Arbeitskreis Digital Humanities (RosDH) und die hiesige DH-Juniorprofessur – in diesem Semester vertreten durch Herrn Dr. Torsten Roeder vom Zentrum für Philologie und Digitalität der Universität Würzburg.
Sie sind herzlich eingeladen, in Präsenz oder online an der Veranstaltung teilzunehmen. Eine vorausgehende Anmeldung für die einzelnen Termine ist nicht erforderlich.
Programm für das Sommersemester 2024:
18.04.2024 Dr. Mark Hall (The Open University) Algorithmenkritik 2024
25.04.2024 Dr. Milan Kostrešević (Universität Rostock) Von Schriften zu Zahlen: Die Evolution der Methodologien der Data Literacy in der Bibelwissenschaft
02.05.2024 Prof. Dr. Frank Fischer (Freie Universität Berlin) Von DRAMALYS.EXE zu DraCor – Eine Geschichte der digitalen Dramenanalyse von 1984 bis heute
30.05.2024 Jun.-Prof. Dr. Elisa Cugliana (Universität zu Köln) „Ob man gewynne oder verlier“: Methodologische Überlegungen zur computationalen Edition eines Losbuchs
06.06.2024 Dr. Angila Vetter (UB Kiel / Universität Augsburg) Coding, Codices, and the Quest for Longevity – Anforderungen und Herausforderungen bei der digitalen Edition mittelalterlicher Texte
13.06.2024 Dr. Philipp Pilhofer (Universität Rostock) Digitales Martyrium: Einblick in die digitale Edition eines griechisch-altkirchenslawischen Märtyrertexts
20.06.2024 Dr. Martin Wagner (Universität Rostock) 2,5 Jahre Digitalisierung Lehrkräftebildung – Probleme und Potentiale
27.06.2024 Prof. Dr. Dr. Stefan Höltgen (SRH Hochschule Heidelberg / Universität Bonn) „Literatur für Compiler“ – Was können Computer lesen, was Menschen gelesen haben, was eigentlich nur Computer lesen sollten?
04.07.2024 Prof. Dr. Anne Baillot (Le Mans Université) Digital Methods Porn, oder: Warum die Welt ohne nachnutzbare Workflowsnicht zu retten ist
11.07.2024 Prof. Dr. Berenike Herrmann (Universität Bielefeld) Literaturwissenschaft – eine historische Datenwissenschaft? Zu Data Literacy und anderen Literacies
Veranstaltungszeit
Immer donnerstags an den ausgewiesenen Terminen, jeweils von 17:15 bis 18:45 Uhr (s.t.)

 登录


 ︎