
 登录

Workshopbericht „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ (29.05.26 in Leipzig)
Von Lukas Hohendorf, Kai Matuszkiewicz, Lydia Riedl und Paula Rinke
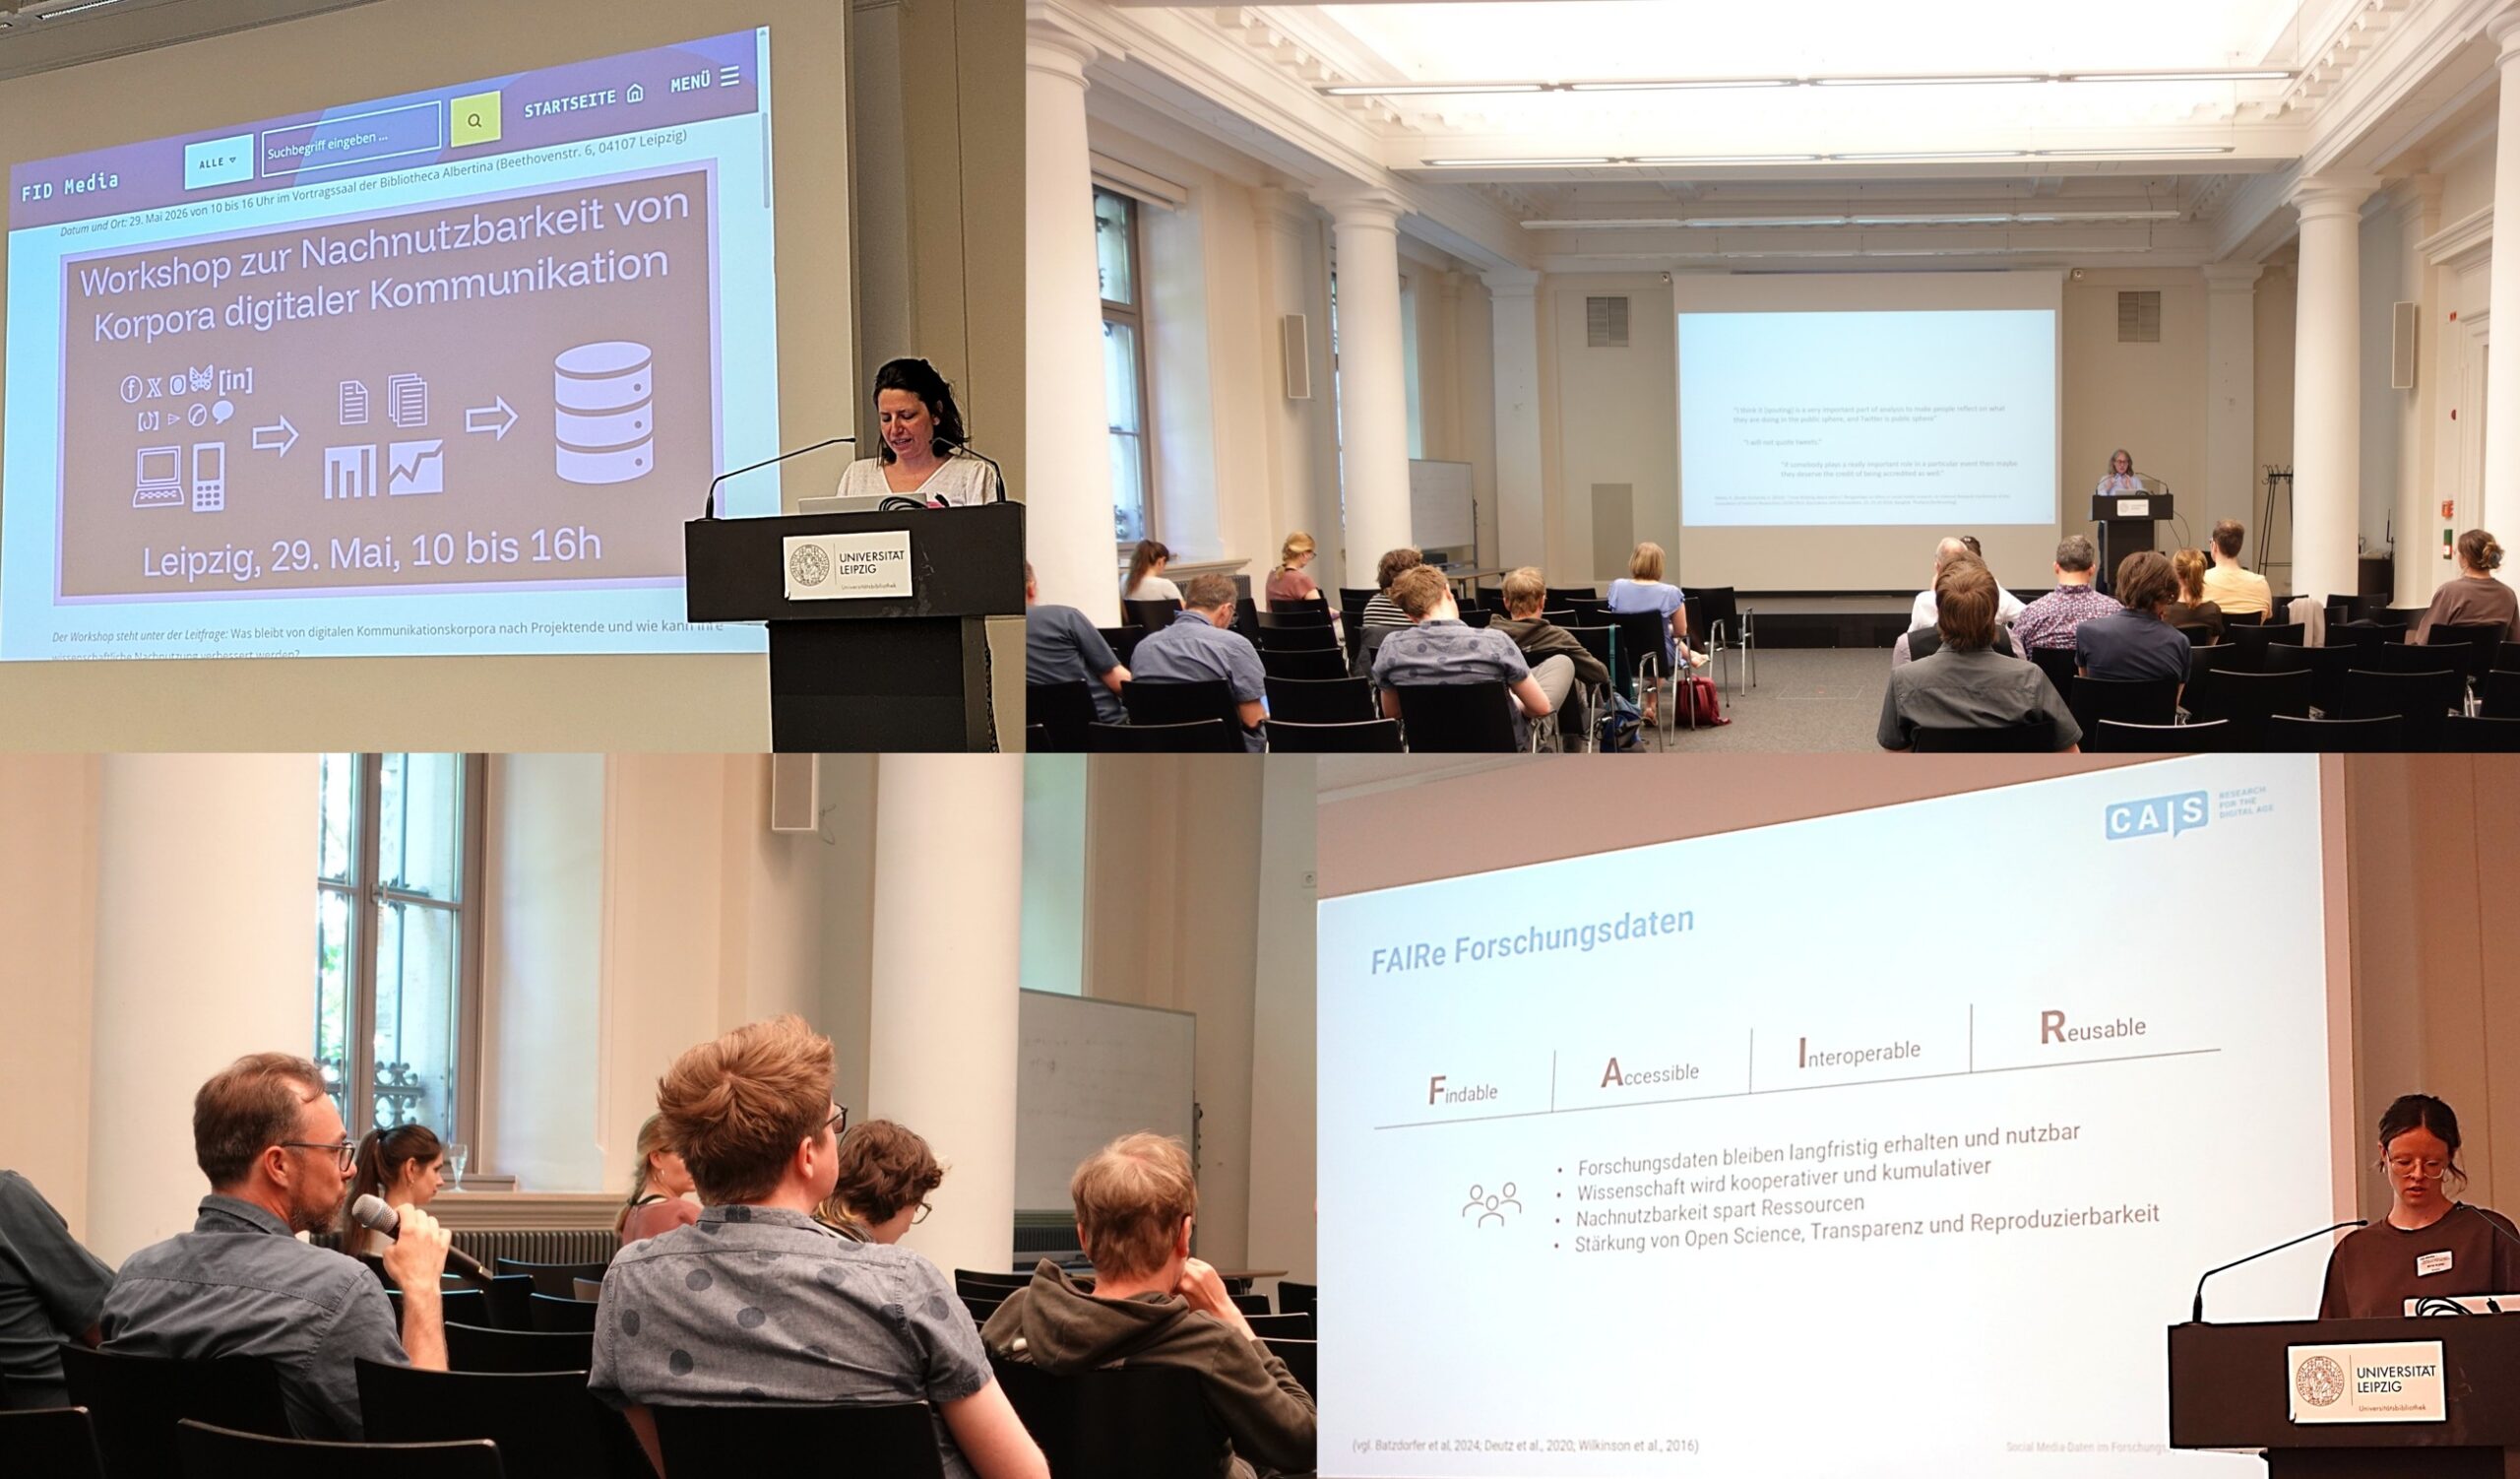
Fotos: FID Media
Ausgangspunkt
In digitalen Räumen werden fortlaufend Daten produziert, die für die Kommunikations- und Medienwissenschaft von hoher Relevanz sind, darunter Beiträge und Kommentare in sozialen Medien, Kommunikationsverläufe in Messenger-Diensten, audiovisuelle und auditive Inhalte, digitale Zeitungsarchive und digitalisierte historische Quellen oder journalistische Online-Angebote. In Forschungsprojekten entstehen daraus häufig umfangreiche Korpora. Viele Forschende wissen aus eigener Erfahrung, dass diese nach Projektende jedoch oft schwer auffindbar, nur eingeschränkt dokumentiert oder aufgrund rechtlicher, ethischer und technischer Rahmenbedingungen nicht ohne Weiteres nachnutzbar bleiben.
An dieser Ausgangsproblematik setzte der Workshop „Von digitalen Korpora zu Forschungsdaten in der Kommunikations- und Medienwissenschaft: Verantwortung, Methoden, Infrastrukturen“ an, den der FID Media am 29. Mai 2026 an der Universitätsbibliothek Leipzig veranstaltete. In ihrer Begrüßung führte Patricia Blume in diese Ausgangsproblematik ein und benannte als übergeordnete Fragen des Workshops, wie digitale Kommunikationskorpora entstehen, unter welchen Bedingungen sie wissenschaftlich analysiert werden können und welche Rolle fachnahe wissenschaftliche Infrastrukturen künftig bei ihrer Dokumentation und Vernetzung spielen können, um sie niedrigschwellig nachnutzbar zu machen.
Wie durch Lukas Hohendorf in seiner anschließenden Einführung erläutert, strukturierte sich der Workshop dabei entlang wichtiger Stationen des üblichen Forschungsprozesses. Im ersten Panel ging es um die Entstehung digitaler Kommunikationsdaten und die methodischen, epistemischen und ethischen Entscheidungen, die bereits die Datenerhebung beeinflussen. Das zweite Panel rückte die Frage in den Vordergrund, wie aus projektgebundenen Datensammlungen längerfristig nachnutzbare Forschungsressourcen werden können. Das dritte Panel diskutierte schließlich die Potenziale und Grenzen vernetzter Kommunikationskorpora für Analyseformen, insbesondere in der Computational Communication Science (CCS).
Von digitaler Kommunikation zu Korpora für die Forschung
Das erste Panel, moderiert von Patricia Blume, widmete sich der grundlegenden Frage, wie digitale Kommunikationsspuren überhaupt zu Forschungsdaten werden. Die Beiträge veranschaulichten, dass digitale Daten nicht einfach „vorliegen“, sondern in komplexen technischen, sozialen und institutionellen Prozessen hergestellt werden. Welche Daten verfügbar sind, welche Lücken entstehen und welche Kommunikationsformen überhaupt beobachtbar werden, hängt von Plattformarchitekturen, Zugangsmöglichkeiten, Erhebungspraktiken, ethischen Entscheidungen und rechtlichen Rahmenbedingungen ab.
Katharina Kinder-Kurlanda (Universität Klagenfurt) nahm in ihrem Beitrag „Epistemische Herausforderungen von Big Social Media Data für die Sozialwissenschaft“ die Entstehungsbedingungen digitaler Daten in den Blick. Sie zeigte, dass Forschung mit großen Datenbeständen aus sozialen Medien immer auch mit asymmetrischen Datenökonomien verbunden ist. Während plattformbetreibende Unternehmen umfangreiche Datenbestände kontrollieren, sind Forschende häufig auf instabile oder nachträglich eingeschränkte Zugänge angewiesen. Diese Abhängigkeit schlägt sich nicht nur in der Datenerhebung selbst nieder, sondern beschränkt auch den Möglichkeitsraum der Forschungsfragen, die wissenschaftlich überhaupt bearbeitbar sind.
Ein zentrales Thema ihres Beitrags war die Sichtbarkeit von Datenarbeit. Viele Entscheidungen, die für wissenschaftliche Ergebnisse maßgeblich sind, bleiben in Publikationen oft unterbelichtet: Wie wurden Daten erhoben, bereinigt, ausgeschlossen, anonymisiert oder transformiert? Welche Plattformbedingungen haben den Zugang strukturiert? Welche ethischen Abwägungen waren im Forschungsprozess erforderlich? Kinder-Kurlanda betonte, dass Datenpraktiken situiert, iterativ und plattformgebunden sind. Transparenz über diese Praktiken ist daher eine Voraussetzung für die Überprüfbarkeit und Einordnung wissenschaftlicher Ergebnisse.
Auch die Archivierung digitaler Plattformdaten wurde als besondere Herausforderung sichtbar. Am Beispiel früherer Twitter-Forschung wurde aufgezeigt, dass die Archivierung von IDs zwar eine Zeit lang als praktikabler Kompromiss galt, langfristig aber keine verlässliche Perspektive bietet, wenn die Rehydrierung, d.h. die Wiederherstellung der Inhalte, weiterhin von der Plattform abhängig bleibt. Dagegen kann die Archivierung von Code, Erhebungsprotokollen, Dokumentationen und Verarbeitungsroutinen auch dann wissenschaftlichen Mehrwert erzeugen, wenn die vollständigen Rohdaten nicht dauerhaft geteilt werden können. In der Diskussion wurde zudem herausgestellt, dass Forschungsethik nicht vollständig an formale Verfahren oder Infrastrukturen delegiert werden kann. Ethikkommissionen, institutionelle Leitlinien und Beratungsangebote können unterstützen, die Verantwortung für konkrete Forschungsentscheidungen bleibt jedoch Teil der wissenschaftlichen Praxis.
Erik Koenen (Universität Bremen) weitete den Blick auf digitale Zeitungsportale und die epistemischen Folgen der Digitalisierung journalistischer Quellen. Im Zentrum des Beitrags stand, dass digitalisierte Zeitungen nicht einfach analoge Objekte in digitaler Form sind. Sie liegen zugleich als Bild, Layout, Volltext, Metadatenstruktur und Suchumgebung vor. Damit verändern sich nicht nur die Zugriffswege, sondern auch der epistemische Status der Quelle selbst. Digitale Zeitungsportale fungieren nicht allein als Archive, sondern auch als methodische und epistemische Forschungsumgebungen.
Koenen argumentierte, dass digitale Zeitungsportale als medientechnische Assemblagen verstanden werden müssen. Sie sind digitale Archive, Sammlungen, Lesesäle, Suchmaschinen und Experimentalsysteme zugleich. Anknüpfend an wissenschaftstheoretische Perspektiven, unter anderem an Ludwik Flecks Konzept wissenschaftlicher Denkstile und Hans-Jörg Rheinbergers Begriff des Experimentalsystems, zeigte er, dass digitale Technologien neue Formen wissenschaftlicher Beobachtung und Interpretation hervorbringen. Distant Reading und Distant Viewing eröffnen neue Perspektiven auf Medienwandel, Layoutgeschichte und öffentliche Kommunikation, setzen aber zugleich eine digitale Quellenkritik voraus, die sich mit Datenformaten, Auszeichnungspraktiken, OCR-Qualität, Portallogiken und Suchinfrastrukturen auseinandersetzt.
Vanessa Angenendt (Universität Duisburg-Essen) brachte mit ihrem Projekt zu Misogynie in Chat-Kommunikation eine weitere Perspektive auf die Entstehung digitaler Kommunikationsdaten ein. Ihr Beitrag befasste sich nicht mit öffentlicher Plattformkommunikation, sondern mit privater oder halböffentlicher Chat-Kommunikation, die der Forschung bislang nur schwer zugänglich ist. Die Datengrundlage bilden Datenspenden, um Chatverläufe zu erfassen, in denen frauenfeindliche oder misogyne Kommunikation sichtbar wird.
Der Beitrag verdeutlichte die gesellschaftliche Relevanz innovativer Wege der Datengewinnung, weil sozial unerwünschte Phänomene wie digitale Misogynie strukturell bedingt häufig in Kommunikationsräumen stattfinden, die sich klassischen Erhebungsverfahren entziehen. Datenspenden eröffnen hier die Möglichkeit, alltägliche und oft verdeckte benachteiligende Praktiken, die in ungleichen Geschlechterverhältnissen verankert sind, empirisch sichtbar zu machen. So zeigten präsentierte Analysen beispielsweise, dass Misogynie in Chat-Kommunikation nicht nur in einzelnen abwertenden Aussagen sichtbar wird, sondern häufig im Verlauf der Interaktion ähnliche Dynamiken erzeugt. Veranschaulicht wurde dies anhand typischer Sequenzen von Kontaktaufnahme, Ablehnung oder Beendigungsversuch, anschließendem Nachsetzen und Herabwürdigen als Machtdemonstration. Konzepte wie „Unwanted Pursuit Behavior“, „Misogynistic Backlash“ oder „Freezing“ systematisierten, wie Kontrolle, Abwertung und Einschüchterung kommunikativ hergestellt werden.
Zugleich zeigte der Beitrag, welche methodischen und ethischen Herausforderungen mit der Analyse privater Kommunikationsräume verbunden sein können. So muss die Datenspende niedrigschwellig organisiert sein, gleichzeitig aber die Datensouveränität der spendenden Personen respektieren. Nach der Einreichung erfolgt eine irreversible Anonymisierung; die Daten werden für die Analyse aufbereitet, enthalten jedoch keine vollständigen Metadaten. Gerade weil es sich um sensible Daten handelt, stellen sich Fragen der Zugänglichkeit, Nachnutzung und Dokumentation besonders nachdrücklich.1 Auch methodische Leerstellen wurden benannt: Chats, die gelöscht wurden, können nicht untersucht werden, und die Zusammensetzung der Datenspendenden ist durch Rekrutierungswege, Bildungshintergründe und mediale Kooperationspartner:innen geprägt.
Insgesamt zeigte das erste Panel, dass Digitale Kommunikationskorpora keine neutralen Abbilder digitaler Kommunikation sind. Vielmehr sind sie Ergebnisse von Entscheidungen, Infrastrukturen, Machtverhältnissen und Praktiken. Für ihre spätere Nachnutzung reicht es daher nicht aus, Daten lediglich abzulegen. Dokumentiert werden muss auch, wie sie entstanden sind, welche Zugänge möglich waren, welche Ausschlüsse vorgenommen wurden, welche Unsicherheiten bestehen und welche rechtlichen oder ethischen Einschränkungen gelten.
Vom Korpus-Silo zur nachnutzbaren Forschungsdatenlandschaft
Das zweite Panel verschob den Fokus von der Entstehung digitaler Korpora auf ihre langfristige Nachnutzung und wurde von Lydia Riedl moderiert. Ausgangspunkt war die Beobachtung, dass viele Korpora in einzelnen Projekten entstehen und nach Projektabschluss in Datensilos verbleiben. Sie sind dann zwar für das ursprüngliche Projekt nutzbar, werden aber für andere Forschende kaum auffindbar, sind unzureichend dokumentiert oder können aus rechtlichen, ethischen oder technischen Gründen nicht geteilt oder mit anderen Daten verknüpft werden. Alle Beiträge griffen dabei einzelne oder mehrere der FAIR-Prinzipien2 (findable, accessible, interoperable, reusable) auf und übertrugen sie auf die besonderen Bedingungen digitaler Kommunikationskorpora.
Vincent Fröhlich (Universität Erlangen-Nürnberg) eröffnete das Panel mit einem Beitrag zu infrastrukturellen Bedarfen der Forschung mit Daten aus sozialen Medien im Bereich Demokratie- und Rechtsextremismusforschung. Er betonte, dass die Volatilität von Plattformdaten eine zentrale Herausforderung darstellt. Inhalte werden gelöscht, Accounts verschwinden, Schnittstellen ändern sich, Zugänge werden eingeschränkt. Was heute erhoben werden kann, ist morgen möglicherweise nicht mehr verfügbar. Für die Forschung bedeutet dies, dass Fragen der Sicherung, Dokumentation und Nachvollziehbarkeit frühzeitig mitgedacht werden müssen.
Besonders betonte Fröhlichs Beitrag, dass Sicherheit in diesem Forschungsfeld mehrdimensional ist. Es geht nicht nur um die Sicherheit der Daten selbst, sondern auch um die Sicherheit der Forschenden und der beforschten Personen. Wer zu Rechtsextremismus, Desinformation oder demokratiegefährdender Kommunikation forscht, kann selbst zur Zielscheibe werden. Forschungsinfrastrukturen müssen neben der Auffindbarkeit und Nachnutzung von Daten auch Schutzräume, Zugriffskontrollen und gut reflektierte Formen der Sichtbarkeit mitdenken. In der Diskussion wurde die Spannung zwischen wissenschaftlicher Sichtbarkeit, die insbesondere für Qualifikations- und Karrierewege wichtig ist, und dem Schutz von Forschenden thematisiert. Hier zeigte sich, dass Infrastrukturen auch institutionelle Sensibilisierung und Schutzmechanismen unterstützen können.
Birte Kuhle (Center for Advanced Internet Studies) griff die Frage nach nachnutzbaren Daten aus der Perspektive des Forschungsdatenlebenszyklus auf. Ihr Beitrag zu praktischen Herausforderungen im Umgang mit Daten aus sozialen Medien zeigte, dass Forschungsdatenmanagement nicht erst am Ende eines Projekts beginnt. Bereits in der Phase „Discover, Plan & Design“ stellen sich Fragen des Samplings, der Plattformauswahl sowie zu ihren jeweiligen Beschränkungen, der Datenzugänge und der rechtlichen Rahmenbedingungen. In der Phase der Datenerhebung können geplante Zugänge, etwa über Plattform-APIs, kurzfristig wegfallen. Forschende müssen dann alternative Wege wie Datenspenden oder Webscraping prüfen, die wiederum eigene ethische und rechtliche Fragen aufwerfen.
Auch die Verarbeitung und Analyse von Daten aus sozialen Medien ist mit erheblicher Datenarbeit verbunden. Daten müssen bereinigt, strukturiert, mit IDs versehen, versioniert und dokumentiert werden. Multimodale Daten erhöhen den Aufwand zusätzlich, weil Text, Bild, Audio und Video unterschiedliche Formate, Werkzeuge und Dokumentationslogiken erfordern. Für die Phase „Publish, Archive & Share“ stellte Kuhle die Frage, was überhaupt veröffentlicht werden darf, welche Teile eines Datensatzes zugänglich gemacht werden können und wie FAIR-Prinzipien unter Bedingungen eingeschränkter Teilbarkeit umgesetzt werden können.
Als zentrale take-aways formulierte Kuhle, dass die Arbeit mit Social-Media-Daten technische, methodische sowie rechtlich-ethische Kompetenzen verlangt und häufig mit hohem Ressourcenaufwand bei zugleich fehlenden Unterstützungs- und Anreizstrukturen verbunden ist. FAIR-Prinzipien, Community-Standards und Forschungsdateninfrastrukturen erscheinen vor diesem Hintergrund nicht als nachgelagerte Formalia, sondern als Voraussetzung dafür, Social-Media-Daten transparenter, nachvollziehbarer und nachnutzbarer zu machen. Die Diskussion zeigte darüber hinaus, dass Metadatenstandards, Codeveröffentlichung und Dokumentationspraktiken bislang noch nicht einheitlich etabliert sind.
Philipp Knöpfle (LMU München) widmete sich mit Blick auf das Projekt „Meta-Rep“ der Reproduzierbarkeit und Replizierbarkeit computationaler Kommunikationsforschung. Anhand eines Literaturreviews zu mehreren hundert Studien zeigte er, dass Daten und Code in der CCS bislang nur selten systematisch geteilt werden. Besonders problematisch ist dies bei Plattformdaten, da sie sich oft nur schwer oder gar nicht replizieren lassen. Wenn Datenzugänge eingeschränkt sind, Plattformen Inhalte löschen oder Schnittstellen verändern, kann eine spätere Replikation schnell unmöglich werden.
Knöpfle unterschied dabei zwischen Reproduzierbarkeit und Replizierbarkeit und zeigte, dass beide Ziele unterschiedliche Anforderungen an Daten, Code und Dokumentation stellen. Selbst wenn Rohdaten aus rechtlichen oder praktischen Gründen nicht geteilt werden können, können Begleitmaterialien oder Metadaten durchaus hilfreich dabei sein, Studienergebnisse besser einzuordnen. Hierzu zählen die Veröffentlichung von Code, die Dokumentation der Datenerhebung, die Beschreibung von Samplingentscheidungen, die Offenlegung von Preprocessing-Schritten und die Angabe von Tools inklusive Parametern und Versionierung. In der Diskussion kam auf, dass die Wahl geeigneter Ablageorte ebenfalls eine praktische Frage ist. Während Plattformen wie The Open Science Framework (OSF) zum Zeitpunkt des Workshops vielen Forschenden niedrigschwelliger erschienen3, bieten institutionelle Git-Infrastrukturen andere Vorteile, setzen aber höhere technische Kompetenzen voraus.
Eine verbindende Klammer über die Beiträge im zweiten Panel hinweg war, dass Nachnutzbarkeit nicht zwingend vollständige Offenlegung aller Daten bedeutet. Gerade digitale Kommunikationsdaten sind häufig sensibel, rechtlich geschützt oder plattformabhängig. Umso wichtiger sind gestufte Zugangsmodelle, umfängliche und verständliche Dokumentation, sowie die Sicherung von Kontextinformationen. Auch nicht vollständig teilbare Korpora können wertvoll für die Forschung bleiben, wenn nachvollziehbar ist, wie sie entstanden sind, welche Analysen mit ihnen durchgeführt wurden und unter welchen Bedingungen andere Forschende daran anschließen können.
Vernetzte Kommunikationskorpora analysieren: Potenziale und Fallstricke
Das dritte Panel wurde von Kai Matuszkiewicz moderiert und richtete den Blick auf die Analyse vernetzter Kommunikationskorpora. Welche neuen Forschungsperspektiven entstehen, wenn digitale Kommunikationsdaten gut dokumentiert, referenzierbar und miteinander verknüpfbar sind? Und welche methodischen Voraussetzungen müssen erfüllt sein, damit großskalige, plattformübergreifende und KI-gestützte Analysen valide Ergebnisse liefern?
Marko Bachl (FU Berlin) eröffnete das Panel mit einem Beitrag zu Bias und epistemischen Konsequenzen für die CCS. Ausgangspunkt war ein statistisches Verständnis von Bias als systematischem Fehler, der von zufälliger Varianz zu unterscheiden ist. Der Bias-Variance-Tradeoff diente dabei als analytisches Raster, um Chancen und Risiken automatisierter Verfahren in der Kommunikationsforschung einzuordnen.
Am Beispiel von Large Language Models (LLMs) in der Inhaltsanalyse zeigte Bachl, dass automatisierte Verfahren neue Möglichkeiten eröffnen. So können sie beispielsweise nicht-textuelle Kommunikationsinhalte transkribieren, Inhalte extrahieren, große Stichproben klassifizieren und damit Analysen ermöglichen, die hand-codiert kaum durchführbar wären. Zugleich können sie die Reproduzierbarkeit erhöhen, weil dieselben Verfahren auf große Datenmengen konsistent angewendet werden können. Diese Reduktion von Varianz geht jedoch nicht automatisch mit einer Reduktion von Bias einher. Im Gegenteil: Automatisierte Verfahren können systematische Verzerrungen erzeugen oder verstärken, wenn Trainingsdaten, Modellarchitekturen, Prompts oder Validierungsmaßstäbe bestimmte Perspektiven privilegieren.
In der anschließenden Diskussion wurde dafür plädiert, dass die Bewertung von KI-gestützten Verfahren nicht abstrakt erfolgen kann. Entscheidend ist, welches Forschungsziel verfolgt wird, welcher Referenzmaßstab angesetzt wird und welche Formen von Fehlern in Kauf genommen werden wollen. Menschliche Codierungen sind dabei nicht automatisch ein unverzerrter Goldstandard, sondern selbst Ergebnis sozialer Umstände sowie methodischer und interpretativer Entscheidungen. Gerade deshalb braucht die CCS eine explizite Auseinandersetzung mit Validierung, Bias, De-Biasing und den epistemischen Annahmen automatisierter Analyseverfahren.
Felix Victor Münch (GESIS/HBI) knüpfte mit seinem Beitrag an die forschungspraktischen Potenziale von LLMs an. Im Zentrum stand die Frage, wie diese zur plattform-, medien- und sprachübergreifenden Verknüpfung von Kommunikationsdaten eingesetzt werden können. Münch zeigte anhand mehrerer Anwendungsbeispiele, dass LLMs nicht nur als dialogische Systeme verstanden werden sollten, sondern als Werkzeuge zur Strukturierung, Transformation, Klassifikation und Verknüpfung großer, heterogener Datenbestände.
Ein Beispiel bezog sich auf die plattformübergreifende Analyse von Kommunikation zu Klimawandel, Desinformation und rechtsextremen Diskursen. Hier wurden große Datenmengen über längere Zeiträume hinweg erhoben und mit Verfahren wie Embeddings, Clustering und Netzwerkanalysen ausgewertet. Ein weiteres Beispiel stellte die Analyse von politischer Kommunikation in TikTok-Videos dar. Semantische Ähnlichkeitsmodelle wurden genutzt, um Themenprofile, Nähebeziehungen und Kommunikationsstrukturen zwischen unterschiedlichen Akteur:innen sichtbar zu machen.
Die Beispiele zeigten anschaulich, welche analytischen Möglichkeiten entstehen können, wenn Daten aus unterschiedlichen Plattformen, medialen Formen und Sprachen in gemeinsame Repräsentationsräume überführt werden können. Dadurch werden Vergleiche möglich, die zuvor nur mit erheblichem manuellem Aufwand oder überhaupt nicht realisierbar waren. Zugleich zeigte Münch, dass solche Pipelines technisch und organisatorisch voraussetzungsreich sind. Sie erfordern Rechenressourcen, methodisches Know-how, sorgfältige Datenaufbereitung und Verfahren zur Qualitätskontrolle. LLMs können solche Prozesse perspektivisch vereinfachen, ersetzen aber nicht die Notwendigkeit, Datenkontexte, Modellentscheidungen und Bewertungskriterien transparent zu dokumentieren.
Jakob Jünger (Universität Münster) schloss das Panel mit einem Beitrag zu Normdaten und Knowledge Graphs als Grundlage für Sekundäranalysen. Sein Ausgangspunkt war die Frage, wie geistes- und sozialwissenschaftliche Arbeitspraktiken stärker miteinander verbunden werden können. Während klassische Nachweis- und Katalogsysteme Literatur, Daten oder Projekte auffindbar machen, erlauben sie meist keine strukturierte Abfrage wissenschaftlicher Aussagen, Beziehungen und Kontexte. Normdaten, kontrollierte Vokabulare, Ontologien und Knowledge Graphs können hier neue Formen der Vernetzung ermöglichen.
Jünger erläuterte Normdaten als Identifier, Vokabulare und Ontologien, die Entitäten eindeutig beschreibbar und miteinander verknüpfbar machen. Knowledge Graphs bilden solche Entitäten und ihre Beziehungen als Netzwerk ab. Als bekanntes Beispiel wurde Wikidata herangezogen. Für die Kommunikationswissenschaft skizzierte Jünger drei mögliche Beteiligungsformen: bestehende Datensätze können mit Normdaten angereichert werden, bestehende Wissensbestände können um neue fachlich relevante Entitäten erweitert werden, und fachnahe Infrastrukturen können eigene Knowledge Graphs aufbauen und betreiben.
Besonders relevant wurde diese Perspektive im Hinblick auf Interoperabilität. Daten werden nicht allein dadurch FAIR, dass sie irgendwo abgelegt werden. Sie müssen auffindbar, zugänglich, interoperabel und nachnutzbar beschrieben sein. Für die Kommunikations- und Medienwissenschaft eröffnet dies erhebliche Potenziale. Forschungsprojekte, Datensätze, Publikationen, Tagungsbeiträge, Personen, Institutionen, Quellen, Methoden und Untersuchungsgegenstände könnten miteinander verknüpft werden. Damit würde nicht nur die Recherche verbessert, sondern auch die Grundlage für Sekundäranalysen, fachgeschichtliche Auswertungen und neue Formen der Wissensrepräsentation geschaffen.
Das dritte Panel zeigte insgesamt, dass vernetzte Kommunikationskorpora große Analysepotenziale eröffnen können. LLMs, computationale Methoden, Normdaten und Knowledge Graphs ermöglichen neue Perspektiven auf Kommunikationsdynamiken über Plattform-, Medien-, Sprach- und Zeitgrenzen hinweg. Zugleich wurde sichtbar, dass diese Potenziale sich nur dann in wissenschaftlich belastbare Ergebnisse verwirklichen lassen, wenn Datenqualität, Validierung, Interoperabilität, Dokumentation und Bias systematisch reflektiert werden.
Fünf zentrale Erkenntnisse des Workshops
Über alle drei Panels hinweg zog sich der Befund, dass digitale Kommunikationskorpora keine bloßen Sammlungen neutraler Daten sind. Sie entstehen durch soziale, rechtliche, wissenschaftliche, technische und ethische Entscheidungen sowie durch die Bedingungen ihrer Erhebung, Verarbeitung und Aufbereitung. Ihre Qualität bemisst sich daher nicht allein an Umfang oder technischer Verfügbarkeit, sondern an der Nachvollziehbarkeit ihrer Entstehung, Prozessierung und Kontextualisierung.
Eine zweite zentrale Erkenntnis war, dass diese Bedingungen der Datenentstehung systematischer dokumentiert werden müssen. Dazu gehören Plattformbedingungen, Zugangspfade, Samplingentscheidungen, Löschungen und Ausschlüsse, fehlende Daten, Anonymisierungsschritte, Metadatenverluste und ethische Abwägungen. Gerade bei Daten aus sozialen Medien, Datenspenden oder digitalisierten Quellen ist entscheidend, welche Teile der Kommunikation sichtbar werden, welche unsichtbar bleiben und wie diese Einschränkungen der Datenbasis nachvollziehbar gemacht werden können.
Drittens zeigte sich, dass Nachnutzung nicht mit vollständiger Offenheit gleichgesetzt werden darf. Viele digitale Kommunikationsdaten können aus guten Gründen nicht frei zugänglich gemacht werden. Trotzdem können sie durch beschreibende Metadaten, Code, Dokumentationen, Analyseprotokolle, kontrollierte Zugangsmodelle oder Verweise auf geeignete Kontaktstellen wissenschaftlich anschlussfähig bleiben.
Viertens wurde die Bedeutung von Interoperabilität sichtbar. Wenn Forschungsdaten, Publikationen, Projekte, Personen, Institutionen, Quellen und Methoden isoliert voneinander dokumentiert werden, bleiben viele Anschlussmöglichkeiten ungenutzt. Entitätenbasierte Modelle, Normdaten und Knowledge Graphs können dazu beitragen, Forschungsergebnisse nicht nur abzulegen, sondern in fachliche Zusammenhänge durch die Nutzung von Semantic-Web-Anwendungen einzubetten.
Eine fünfte zentrale Erkenntnis liegt darin, dass Infrastrukturen nicht erst am Ende des Forschungsprozesses relevant werden. Sie können bereits in der Planungsphase helfen, Datenerhebungen besser zu koordinieren, rechtliche und ethische Fragen frühzeitig zu klären, Dokumentationsstandards mitzudenken und spätere Nachnutzung vorzubereiten.
Perspektiven für die Arbeit des FID Media
Für den FID Media ergaben sich aus dem Workshop mehrere konkrete Handlungsfelder, die bereits in der von Lukas Hohendorf moderierten Abschlussdiskussion aufgegriffen wurden und in der weiteren strategischen Entwicklung geprüft und mit der Fachcommunity vertieft werden sollen.
Ein erstes mögliches Handlungsfeld liegt in der Entwicklung fachspezifischer Dokumentationsvorlagen für digitale Kommunikationskorpora. Diese sollten gemeinsam mit Forschenden erarbeitet werden und unterschiedliche Datentypen berücksichtigen: Plattformdaten, Chatdaten, journalistische Inhalte, audiovisuelle Materialien, digitalisierte Quellen und multimodale Korpora. Solche Vorlagen könnten Mindestangaben zu Datenherkunft, Erhebungswegen, Sampling, Plattformbedingungen, Preprocessing, Versionierung, Anonymisierung, rechtlichen Grundlagen und Nutzungsrechten, Zugangsbedingungen und möglichen Verzerrungen enthalten. Ziel wäre keine zusätzliche Bürokratie, sondern eine praxistaugliche Unterstützung für Forschende, die ihre Daten nachvollziehbar und nachnutzbar dokumentieren möchten. In der Entwicklung derartiger Vorlagen liegt eine Zusammenarbeit mit NFDI-Konsortien nahe, wie sie bereits in der Vergangenheit gepflegt wurde, insbesondere mit dem von NFDI4Culture, Text+, BERD@NFDI und KonsortSWD getragenen Arbeitskreis Social Media-Daten in der Forschungspraxis.
Ein zweites Handlungsfeld betrifft den Aufbau einer fachnahen Nachweis-, Register- und Vermittlungsinfrastruktur für digitale Kommunikationskorpora. Ein solches Angebot könnte geplante, laufende und abgeschlossene Korpusvorhaben in der Kommunikations- und Medienwissenschaft sichtbar machen: Welche Projekte erheben oder nutzen Daten zu welchen Plattformen, Quellen, Zeiträumen und Themen, mit welchen Methoden und unter welchen Zugangsbedingungen? Besonders vielversprechend wäre dabei eine Funktion für geplante Datenerhebungen. Forschende könnten Vorhaben frühzeitig eintragen, wodurch sich Kooperationsmöglichkeiten erkennen lassen, bevor Daten mehrfach, inkompatibel oder unter hohem Aufwand parallel erhoben werden. Zugleich könnte der FID Media abgeschlossene Projekte, Datensätze, Publikationen, Codebooks, Präsentationen, Personen, Einrichtungen, Methoden und Einträge in externen Repositorien fachlich erschließen und miteinander verknüpfen. Der FID Media müsste dafür nicht alle Daten selbst speichern, sondern Daten könnten dort öffentlich publiziert, archiviert oder kontrolliert zugänglich gemacht werden, wo die jeweils geeigneten technischen und rechtlichen Voraussetzungen bestehen. Der FID Media könnte durch ein zentrales Forschungsregister ergänzend dafür sorgen, dass diese Ressourcen für die Kommunikations- und Medienwissenschaft sichtbar, verständlich kategorisiert und mit weiteren fachlichen Informationen verknüpft werden. Das entitätenbasierte Modell des Repositoriums des FID Media bietet hierfür eine vielversprechende Grundlage und könnte perspektivisch einen Beitrag zu potenziellen fachlichen Wissensgraphen der Kommunikations- und Medienwissenschaft leisten.
Ein drittes Handlungsfeld besteht in der Weiterentwicklung von Beratung und Vernetzung von Forschenden mit Infrastrukturen. Der Workshop zeigte, dass Forschende bei digitalen Kommunikationskorpora regelmäßig mit rechtlichen, ethischen und technischen Fragen konfrontiert sind: Was darf erhoben werden? Was darf gespeichert, geteilt oder veröffentlicht werden? Welche Teile eines Datensatzes können offen zugänglich sein, welche nur kontrolliert, welche gar nicht? Welche Dokumentation ist sinnvoll, wenn Daten nicht geteilt werden können? Hier prüft der FID Media, in seinen bestehenden Beratungsangeboten, etwa zu Urheberrecht, Open Access, Open Science und Forschungsdatenmanagement, noch stärker die spezifischen Bedarfe digitaler Kommunikationsforschung zu berücksichtigen.
Fazit
Der Workshop hat gezeigt, dass die Frage „Was bleibt von digitalen Kommunikationskorpora?“ nicht erst nach Projektende gestellt werden sollte. Sie beginnt bereits bei der Auswahl von Quellen, Plattformen und Zugängen, setzt sich in Sampling, Datenerhebung, Datenbereinigung und Analyse fort und reicht bis zur Publikation, Archivierung und späteren Nachnutzung. Digitale Kommunikationskorpora sind nur dann langfristig wissenschaftlich wertvoll, wenn ihre Entstehungsbedingungen, ihre Einschränkungen und ihre Nutzungskontexte nachvollziehbar bleiben.
Für die Kommunikations- und Medienwissenschaft ergibt sich daraus eine doppelte Herausforderung. Einerseits eröffnen digitale Korpora neue Forschungsperspektiven, etwa auf schwer zugängliche Kommunikationsräume, langfristige Medienentwicklungen, plattformübergreifende Diskurse oder multimodale Kommunikationsdynamiken. Andererseits entstehen neue Anforderungen an Quellenkritik, Datenethik, Dokumentation, Reproduzierbarkeit, Interoperabilität und Infrastrukturen.
Der FID Media nimmt aus dem Workshop den Auftrag mit, diese Fragen gemeinsam mit der Fachcommunity weiterzuverfolgen. Ziel ist es, digitale Kommunikationskorpora nicht nur als projektgebundene Datensammlungen zu betrachten, sondern als potenziell vernetzte Forschungsressourcen, die zukünftige Forschung vorbereiten, erleichtern und sichtbar machen können. Entscheidend wird sein, hierfür niedrigschwellige, fachnahe und zugleich methodisch passende Angebote zu entwickeln. Diese reichen von der Beratung in der Planungsphase über Standards in der Dokumentation und der Registrierung laufender Vorhaben bis hin zur Unterstützung bei der Publikation, Verzeichnung und Vernetzung abgeschlossener Projekte.
Der Workshop hat damit den Blick weg vom einzelnen Korpus hin auf die Voraussetzungen seiner wissenschaftlichen Anschlussfähigkeit gelenkt. Für Open Science in der Kommunikations- und Medienwissenschaft folgt daraus, dass nicht allein entscheidend ist, ob Daten veröffentlicht werden können, sondern ob ihre Herkunft, Reichweite, Einschränkungen und Beziehungen so beschrieben sind, dass sie in der Forschungscommunity weitergedacht, geprüft und kombiniert werden können. Hierin liegt die künftige Infrastrukturaufgabe, die Kommunikations- und Medienwissenschaft darin zu unterstützen, aus verstreuten Projektspuren einen übersichtlichen und möglichst vollständigen Orientierungsraum zu schaffen, in dem neue Forschung nicht immer wieder bei null beginnen muss, sondern auf bereits geleistete Aufwände und vorhandene Erkenntnisse aufbauen und bestehende Ergebnisse produktiv nachnutzen kann.
1 In der Diskussion wurde außerdem die öffentliche Verfügbarkeit der Daten unter ethischen Gesichtspunkten zur Debatte gestellt, da sie sich als Trainingsmaterial für böswillige Chatbotbetreibende eignen würden.
2 Wilkinson, M., Dumontier, M., Aalbersberg, I. et al. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data 3, 160018. https://doi.org/10.1038/sdata.2016.18
3 Anmerkung: Nach dem Workshop kündigte das Center for Open Science an, den Bereich OSF Projects wegen fehlender Finanzierung auslaufen zu lassen, so dass ab November 2026 keine neuen Projekte mehr angelegt werden können. Diese Entwicklung zeigt, dass Open Science nicht allein niedrigschwellige Werkzeuge, sondern wissenschaftsgeleitete, institutionell fest verankerte und dauerhaft finanzierte Infrastrukturen benötigt, um die langfristige Verfügbarkeit von Forschungsinhalten sicherstellen und die FAIR-Prinzipien umzusetzen.
Der Text dieses Beitrags steht unter der Lizenz Creative Commons Namensnennung 4.0 International (CC BY 4.0). Die Abbildungen sind von dieser Lizenz ausgenommen; alle Rechte vorbehalten.